NVMe изнутри: очереди команд, контроллер, прерывания и реальная задержка SSD
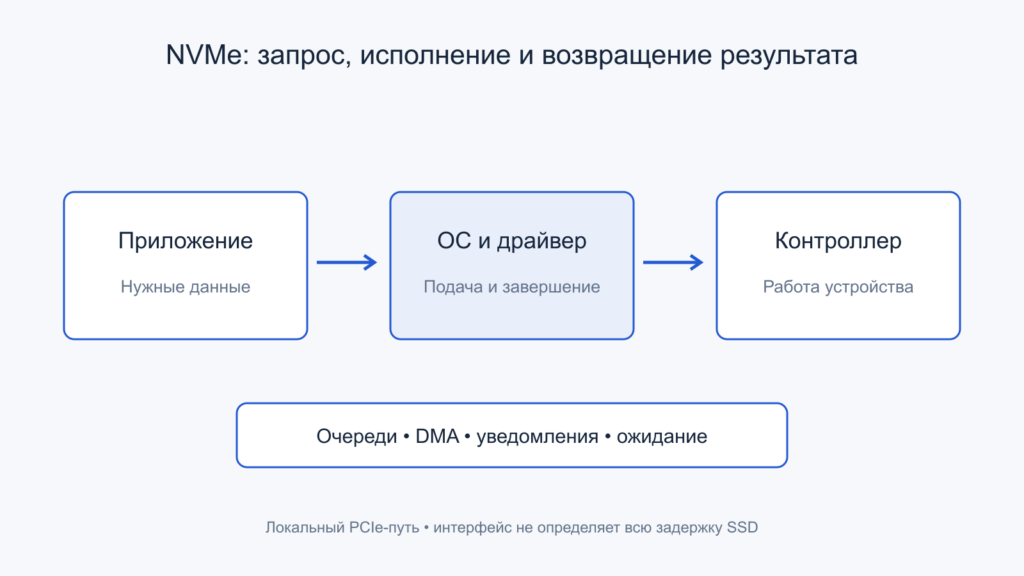
Подача, обслуживание устройства и возврат результата занимают разные участки пользовательского интервала. Открыть иллюстрацию в полном размере.
Накопитель поддерживает NVMe и быстрый PCI Express, но небольшое чтение всё равно занимает десятки или сотни микросекунд. В другом тесте увеличение очереди почти не меняет гигабайты в секунду, зато заметно увеличивает время ответа. Противоречия нет: протокол организует выполнение команд, а не отменяет работу программного стека и устройства. Запрос должен попасть в очередь, быть замечен контроллером, получить ресурсы, передать данные и вернуться приложению. Разберём этот путь, чтобы отличать аппаратный предел SSD от цены подачи команд, уведомления и ожидания.
Содержание статьи
- NVMe, PCIe и M.2 описывают разные вещи
- Контроллер и namespace: кто исполняет команду и что адресуется
- До NVMe может вообще не дойти
- Submission Queue: описание работы вместо передачи файла
- DMA: где движутся пользовательские байты
- Completion Queue: результат, статус и связь с запросом
- Число очередей и глубина: два разных измерения
- Little’s Law: связываем операции, секунды и очередь
- Почему рост QD сначала помогает, а затем мешает
- Прерывания: устройство сообщает, что стоит проверить CQ
- Polling: задержку уведомления меняют на работу CPU
- Размер блока меняет баланс протокола и полезной нагрузки
- Как читать задержку в готовом отчёте
- Первичные источники
- Читайте также
NVMe, PCIe и M.2 описывают разные вещи
NVMe — семейство спецификаций взаимодействия с энергонезависимым хранением. PCI Express служит транспортом для обычного локального NVMe SSD, а M.2 описывает форм-фактор и варианты соединения. Накопитель другого размера также может использовать NVMe через PCIe. И наоборот, одно наличие посадочного места M.2 не доказывает поддержку любого протокола и режима. Для совместимости и производительности нужно знать весь путь: устройство, порт, линии, прошивку и драйвер.
У NVMe существуют и транспорты over Fabrics, где контроллер доступен через сетевую инфраструктуру. Общая модель команд сохраняет смысл, но конкретные очереди и передача имеют особенности транспорта. Ниже основной пример — локальный PCIe SSD с очередями в памяти хоста. Нельзя автоматически переносить каждую стрелку такой схемы на TCP или RDMA. Уточнение границы позволяет рассматривать механику подробно, не объявляя один распространённый вариант всей спецификацией.
Сам NVMe не определяет время программирования NAND, размер быстрого кэша или число одновременно работающих кристаллов. Он создаёт средства подачи работы и получения результата. Два устройства с одинаковой версией протокола могут иметь разный контроллер, внутренний параллелизм и задержки. Поэтому надпись NVMe не является обещанием определённого времени каждой операции и не заменяет описание нагрузки, при которой измерен результат.
Контроллер и namespace: кто исполняет команду и что адресуется
Контроллер предоставляет интерфейс управления и исполнения команд. Namespace представляет логическое пространство блоков с определёнными свойствами и идентификатором. Команда чтения указывает, к какому пространству и диапазону логических адресов она относится. Это не имя отдельного кристалла NAND. Внутреннее размещение может быть распределено по ресурсам, а его управление остаётся задачей устройства и предусмотренной модели хранения.
Один контроллер способен предоставлять несколько пространств, а архитектуры хранения могут связывать доступ к namespace с несколькими контроллерами. Конкретные возможности зависят от реализации. Для обычного пользователя один видимый диск часто соответствует одному используемому namespace, но это удобный частный случай, а не определение протокола. Создание второго пространства само по себе не удваивает физическую полосу и не гарантирует изоляцию времени исполнения.
Полезно разделять идентичность объекта, формат логического блока и ресурсы. Два namespace могут иметь разные допустимые форматы или настройки, но всё ещё конкурировать за общий контроллер и носитель. Из количества логических объектов нельзя получить число независимых аппаратных путей. Это особенно важно в виртуализации и совместном использовании, где изолированный адресный диапазон иногда ошибочно воспринимают как изолированную производительность.
До NVMe может вообще не дойти
Приложение обычно вызывает файловый интерфейс, а не заполняет команду контроллера. Чтение проходит через файловую систему, управление памятью и блочный слой. Если данные уже находятся в кэше ОС, физического обращения может не быть. Замер такого повторного чтения полезен для поведения приложения, но не измеряет задержку SSD. Одинаковая функция чтения в программе может обслуживаться разными физическими путями в зависимости от состояния системы.
При промахе кэша нужно сформировать один или несколько запросов. Размер чтения программы не обязан совпадать с размером каждой команды устройства: стек может объединять, разбивать или дополнять операции. Метаданные файловой системы и зависимые чтения также добавляют работу. Поэтому число вызовов программы, число операций блочного слоя и число NVMe-команд иногда различаются. Сравнение IOPS требует сначала выбрать, на каком уровне они посчитаны.
В Linux механизм blk-mq разделяет программные контексты подачи и аппаратные контексты передачи драйверу. Документация показывает, что запрос может пройти коротким путём или ожидать объединения, планирования и доступных ресурсов. Другие ОС имеют свою реализацию, но общий инженерный вопрос тот же: сколько времени прошло до передачи команды устройству и сколько — после неё? Общий интервал приложения содержит оба участка.
Учебный бюджет ста микросекунд
Представим полностью условный интервал приложения 100 мкс: подготовка и подача занимают 20 мкс, обслуживание в устройстве вместе с его ожиданием — 60 мкс, уведомление и обработка завершения — 15 мкс, возвращение результата — ещё 5 мкс. Если уменьшить только последний участок вдвое, получится 97,5 мкс, а не 50. Такое разложение не является измерением ОС или модели SSD. Оно показывает, почему ускорение одного узкого программного действия не обязано менять весь пользовательский интервал пропорционально.
У разных запросов состав меняется. Один попадает в уже готовый буфер, другой ждёт внутреннюю работу, третий задерживается при пробуждении исполнителя. Поэтому общий график полезно сопоставлять с временными отметками выбранных уровней. Если доступна только конечная длительность, вывод о распределении времени остаётся гипотезой. Не следует дорисовывать отсутствующие измерения исходя из средней задержки, указанной производителем для совершенно другой нагрузки и другой точки отсчёта.
Submission Queue: описание работы вместо передачи файла
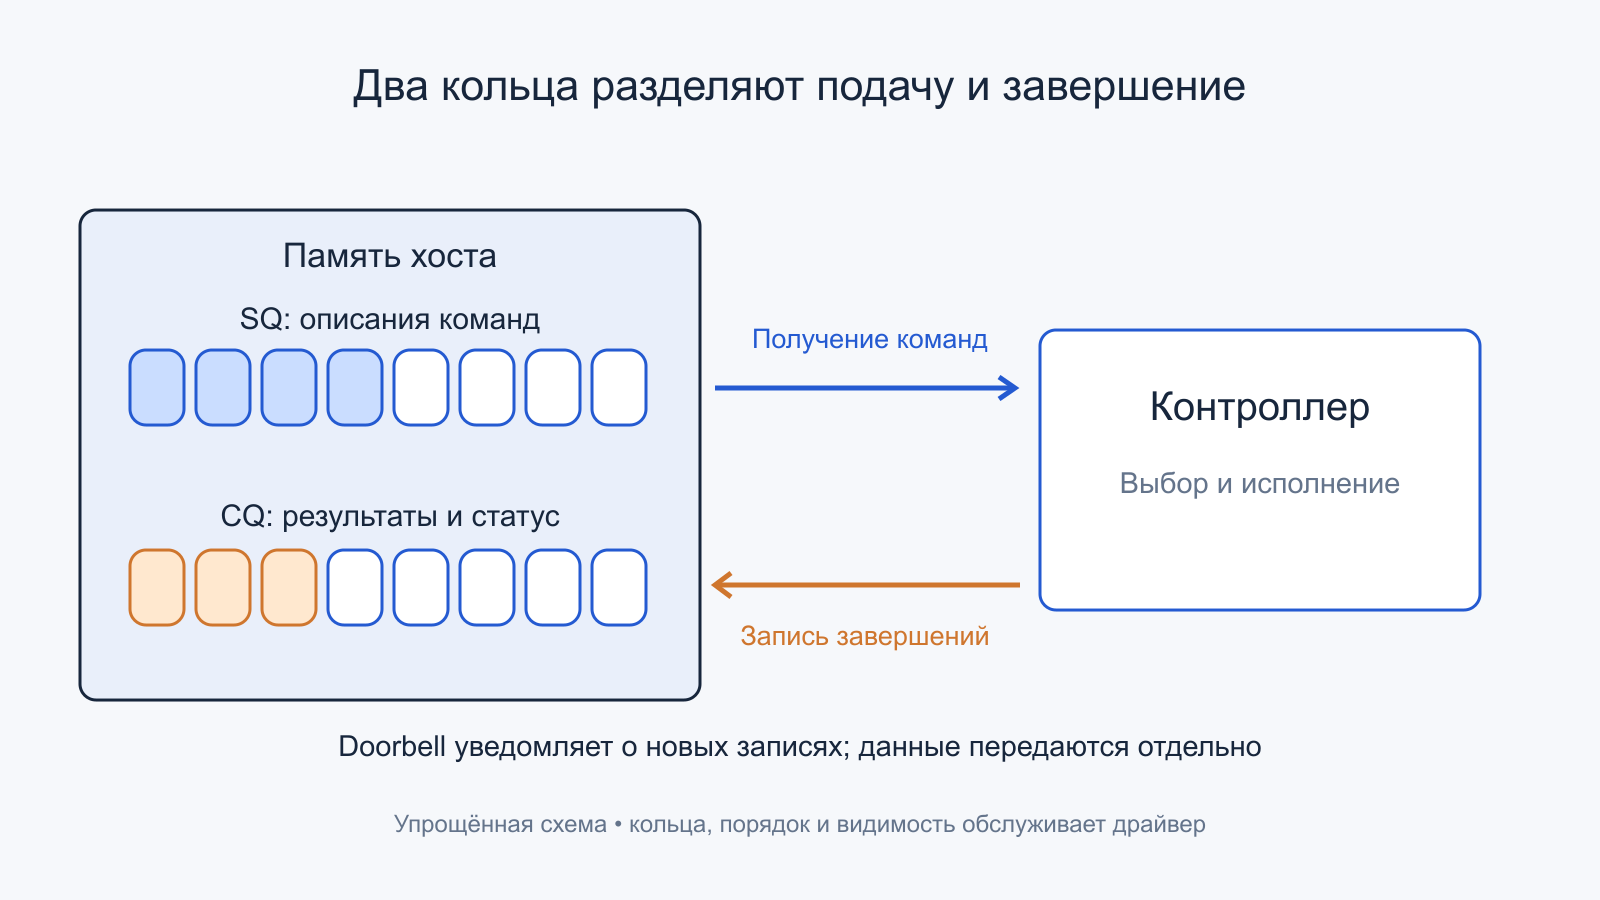
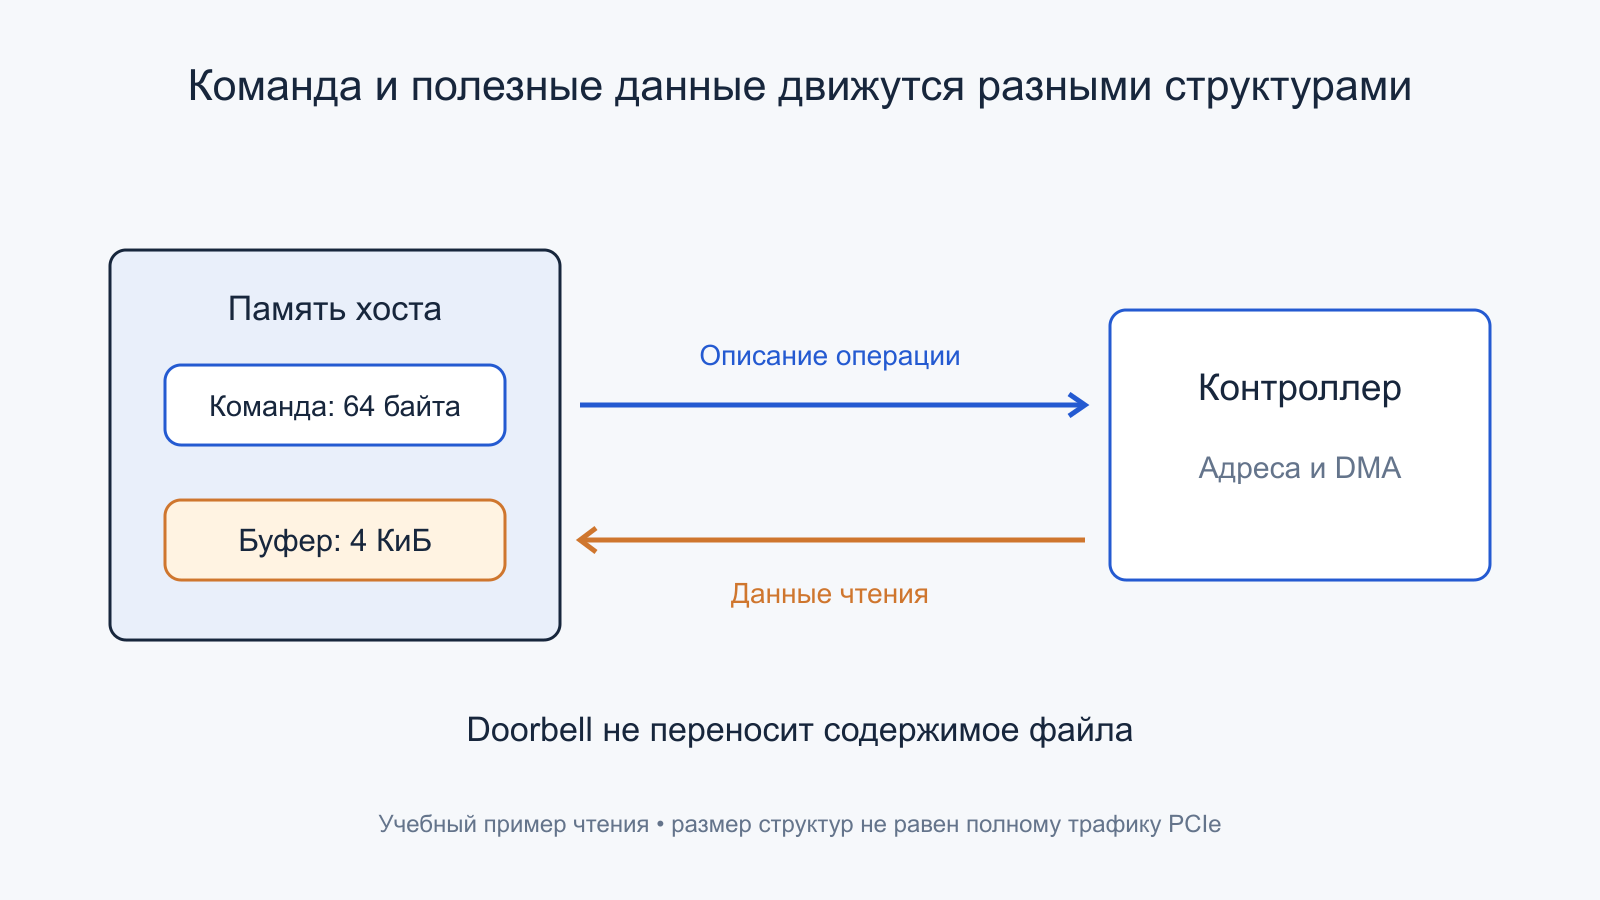
Для локального PCIe-контроллера хост подготавливает записи в Submission Queue, SQ. Это кольцевая структура с ограниченным числом позиций. Запись описывает команду: операцию, идентификаторы, логический диапазон, сведения о буферах и параметры. Обычная базовая команда NVMe имеет 64-байтную запись. Такой размер не означает, что в неё помещается пользовательский блок 4 КиБ: данные хранятся отдельно, а команда ссылается на место их передачи.
Когда запись готова и видима устройству по правилам платформы, драйвер обновляет соответствующий doorbell — уведомление о новом положении хвоста очереди. Для обычного MMIO-пути это запись в предусмотренный регистр контроллера. Doorbell не является каналом копирования всего содержимого файла. Контроллер получает возможность выбрать команды из очереди и начать обслуживание. Некоторые предусмотренные оптимизации меняют стоимость уведомления, но не отменяют различие между командой и её полезной нагрузкой.
Кольцевая организация требует аккуратно различать занятые и свободные позиции и переиспользовать их по правилам протокола. Сам факт, что драйвер положил описание в память, не доказывает завершения чтения или записи. Даже продвижение головы SQ означает потребление записей, а не обязательно окончание всех соответствующих операций. Для результата существует отдельная очередь завершений. Смешение этих событий приводит к неверному измерению задержки.
DMA: где движутся пользовательские байты
Команда содержит или использует описатели доступа к данным. В NVMe применяются механизмы вроде PRP и SGL с определёнными правилами описания буферов. Они позволяют контроллеру обращаться к подходящим областям памяти через DMA. CPU не обязан выполнять отдельную инструкцию копирования для каждого переданного байта. Но подготовка отображений, проверка доступности, согласование памяти и обслуживание завершения всё равно стоят времени и ресурсов.
Адрес DMA не следует понимать как случайный указатель пользовательской программы, который достаточно отправить устройству. Драйвер и ОС обеспечивают необходимые свойства страниц, отображения и срок жизни буфера; при наличии IOMMU участвует её адресная модель. Детали зависят от платформы и программного пути. Zero-copy означает отсутствие определённой промежуточной копии, а не исчезновение всей передачи, всех проверок или обращений к памяти.
При чтении устройство помещает данные в предусмотренный буфер хоста; при записи получает данные из него. Между командой, данными и завершением должны выполняться правила порядка и видимости. Пользовательскому приложению эти детали обычно скрывает API. Поэтому сравнение обычного файлового ввода-вывода с прямым пользовательским драйвером должно учитывать, какие гарантии и слои обошли, а не только уменьшившееся число микросекунд.
Completion Queue: результат, статус и связь с запросом
После выполнения контроллер формирует запись в Completion Queue, CQ. Базовая запись завершения занимает 16 байт и содержит сведения, позволяющие связать результат с запросом и прочитать статус. Порядок завершения не обязан совпадать с порядком подачи. Если одна команда обслужилась быстрее, её результат может появиться раньше, а другая продолжит ждать внутренние ресурсы. Для сопоставления используются идентификаторы и контекст соответствующей очереди.
Кольцо CQ переиспользуется, поэтому драйвер должен отличать новую запись от старого содержимого на той же позиции. Для этого в модели NVMe используется phase tag с правилами изменения при обходе кольца. Драйвер обрабатывает доступные завершения и сообщает контроллеру освобождённое место предусмотренным способом. Завершение существует как запись в памяти; прерывание лишь помогает хосту своевременно обратить на него внимание.
Несколько SQ могут быть связаны с одной CQ, если конфигурация это предусматривает. Распространённое выражение «пара очередей» удобно для программной модели, но не означает, что каждый допустимый вариант обязан быть строго один к одному. Отдельная административная очередь служит настройке и управляющим командам, а очереди ввода-вывода создаются и согласуются в рамках доступных возможностей контроллера и драйвера.
Число очередей и глубина: два разных измерения
Число очередей описывает количество путей подачи, глубина — сколько позиций или незавершённой работы допускается в выбранном пути. Спецификация предусматривает большое пространство идентификаторов и предельных размеров, но это не число очередей, реально созданных в компьютере. Контроллер сообщает ограничения, хост запрашивает конфигурацию, а драйвер учитывает свои ресурсы и топологию. Рекламный максимум нельзя выдавать за активную конфигурацию конкретного SSD.
Несколько очередей помогают уменьшить конкуренцию программных потоков за общую структуру и распределить подачу между CPU. Это не означает, что за каждой находится отдельный набор NAND с гарантированной полосой. Четыре очереди по 32 незавершённые команды могут описывать до 128 команд общей работы; одна очередь глубиной 128 — другое распределение тех же потенциальных ресурсов. Но фактическое заполнение, планирование и итоговый темп могут различаться.
Глубина, заданная тестовой программе, также не всегда равна среднему числу команд внутри контроллера. Часть запросов может ждать в ОС, а часть времени программа не успевает поддерживать выбранный уровень. При нескольких потоках глубина иногда задаётся на каждый поток, иногда — суммарно. Поэтому подпись QD32 без определения границы и числа исполнителей оставляет слишком много неизвестного для строгого сравнения.
Асинхронность не создаёт независимость данных
Асинхронный API позволяет отправить работу и продолжить выполнение до получения результата. Если следующие адреса известны заранее, приложение может подготовить несколько запросов и позднее обработать завершения. Но если адрес следующего блока хранится в результате предыдущего, зависимость остаётся: большой лимит очереди не заполняется автоматически. Разработчик должен либо изменить алгоритм, либо принять последовательное ожидание. В характеристиках накопителя нет средства превратить неизвестный будущий адрес в готовую независимую команду.
Пакетная подача уменьшает долю некоторых общих расходов, но может добавить время до отправки первого запроса, пока пакет собирается. Аналогично пакетная обработка завершений улучшает использование CPU, не обязательно сокращая ожидание каждого участника. Для потоковой обработки это бывает разумным обменом. Для редкого интерактивного обращения накопление пакета иногда противоречит цели. Поэтому полезно измерять и установившийся темп, и время от появления отдельной задачи до получения именно её результата.
Little’s Law: связываем операции, секунды и очередь
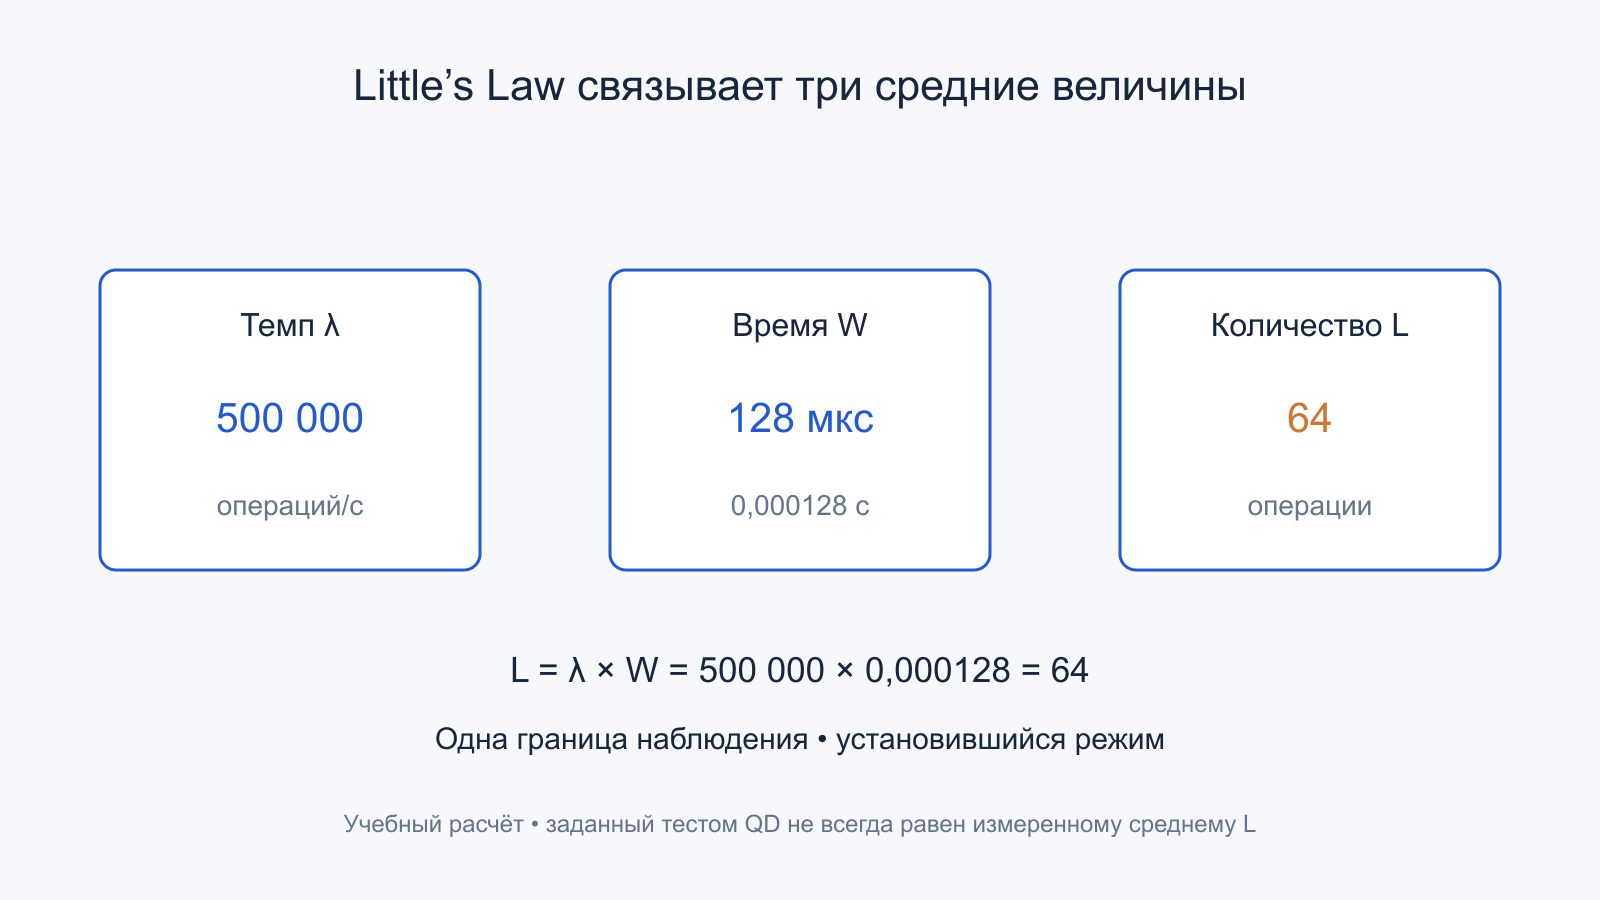
В установившейся системе среднее число незавершённых запросов L связано с темпом завершений λ и средним временем W: L = λW. Все величины должны относиться к одной границе наблюдения, а W выражаться в секундах, если λ задано в операциях за секунду. Это соотношение средних, а не формула времени самого медленного запроса и не обещание конкретного поведения устройства после изменения настройки.
Учебный пример: 500 000 операций/с и среднее время 128 мкс. Переводим время: 128 × 10⁻⁶ с. Получаем L = 500 000 × 128 × 10⁻⁶ = 64 операции. Если по ошибке подставить 128 как секунды или миллисекунды, результат потеряет физический смысл. Обратная оценка W = L / λ допустима для тех же средних и той же устойчивой системы; глубина из названия режима теста не всегда является нужным L.
Для темпа 1 000 000 операций/с при среднем времени 100 мкс нужно в среднем 100 незавершённых операций в выбранной границе. Это не требование универсально выставлять QD100: число лишь проверяет согласованность заданных средних. Если приложение делает зависимые запросы строго по одному, оно не создаёт такой параллелизм. Максимум IOPS накопителя при другой нагрузке тогда не является достижимой целью этого приложения.
Почему рост QD сначала помогает, а затем мешает
При малом числе независимых команд часть внутренних ресурсов может простаивать. Дополнительная работа позволяет контроллеру перекрывать ожидания и использовать доступный параллелизм. Затем достигается ограничение канала, контроллера или носителя. Новые команды всё ещё принимаются, но в основном увеличивают ожидание. Это обычный переход от недостатка работы к насыщению, а не обязательная неисправность SSD.
Условные режимы можно связать так: среднее L = 1 при 12 тысячах операций/с даёт 83,3 мкс; L = 16 при 160 тысячах — 100 мкс; L = 64 при 250 тысячах — 256 мкс; L = 128 при 260 тысячах — около 492 мкс. Последнее удвоение очереди почти не подняло темп, зато существенно увеличило среднее ожидание. Эти числа придуманы для согласованной модели и не являются тестом коммерческого накопителя.
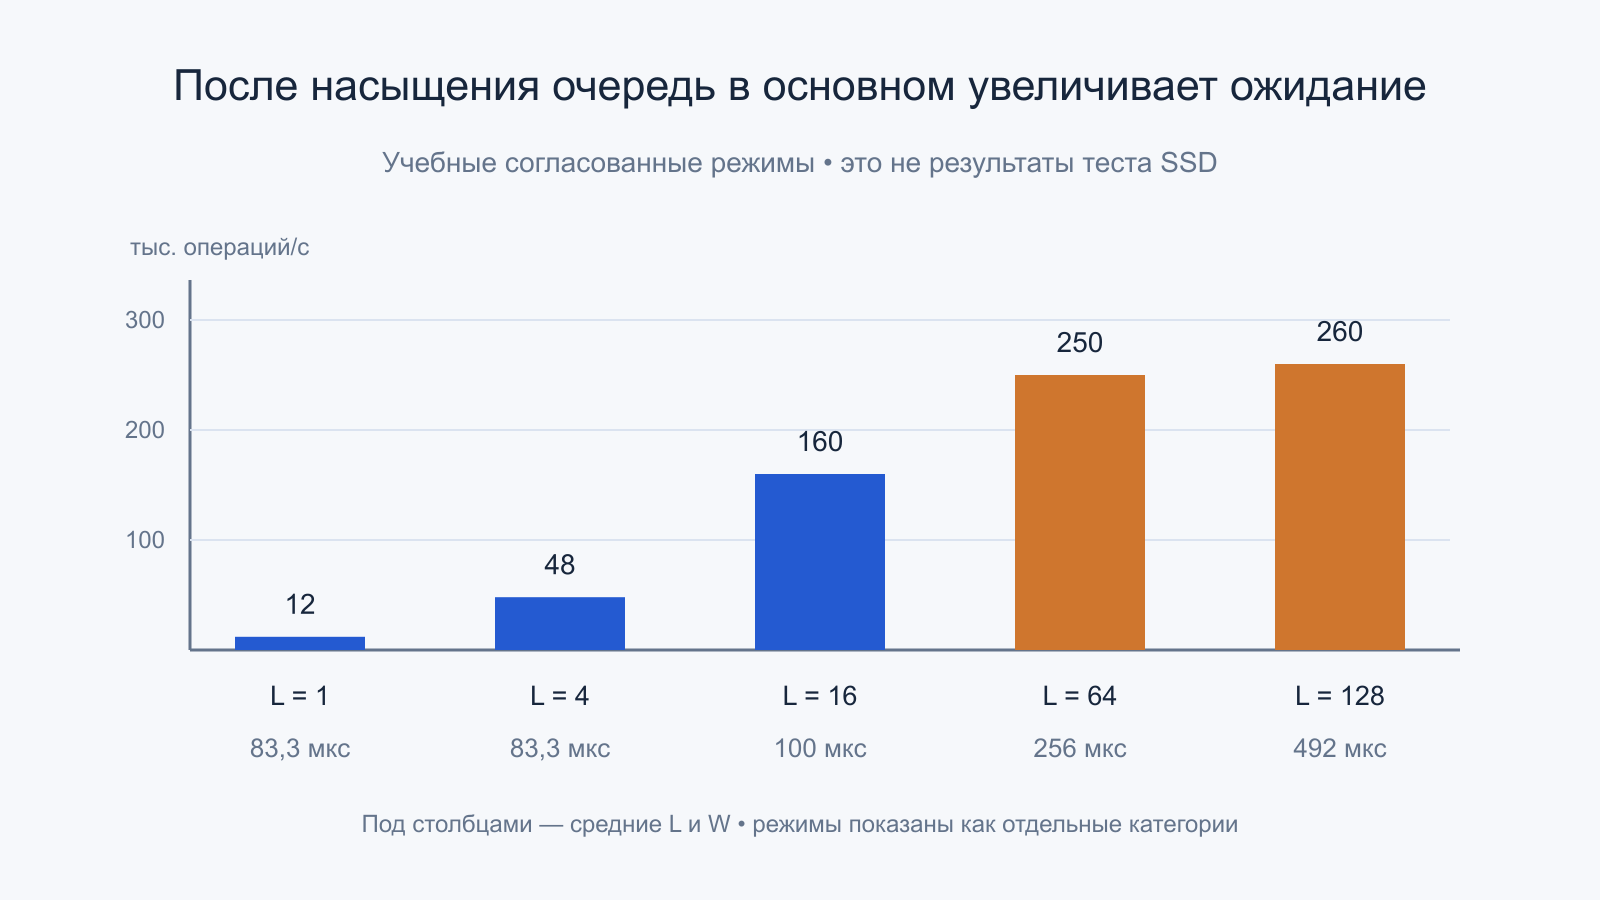
Для серверного потока с большим числом независимых задач может быть разумен режим высокой пропускной способности. Для интерактивной цепочки важнее задержка и её хвост. Один режим не является «самым правильным» для любых программ. Проверка должна отвечать, сколько полезных операций завершается к нужному сроку, а не только сколько команд удалось держать незавершёнными.
Прерывания: устройство сообщает, что стоит проверить CQ
При прерываниях CPU не обязан непрерывно смотреть на очередь завершений. Контроллер уведомляет хост предусмотренным механизмом, обработчик проверяет результаты, а стек продолжает обслуживание запросов. Для PCIe обычно используются возможности вроде MSI-X и распределения обработчиков. При этом число векторов и их связь с очередями относятся к реализации и конфигурации. Нельзя считать, что каждая команда всегда создаёт отдельное прерывание на отдельном ядре.
Объединение уведомлений способно уменьшить нагрузку на CPU ценой дополнительного ожидания части команд. Если несколько завершений обслуживаются вместе, накладные расходы распределяются на пакет. Конкретные пороги, таймеры и доступность настройки зависят от устройства и драйвера. Более редкие прерывания могут улучшить общий темп, но не обязательно время одного короткого запроса. Даже уже готовая в памяти CQ запись может ждать момента, когда хост её обработает.
После обработчика возможны ещё планирование задачи, работа файловой системы и копирование в пользовательский буфер. Поэтому время физического завершения устройства и время возврата API приложению различаются. Показатель, измеренный только между отправкой и обработкой CQ, не включает все эти этапы. Для строгого сравнения нужно явно назвать точки старта и конца.
Polling: задержку уведомления меняют на работу CPU
В режиме опроса программный исполнитель регулярно проверяет доступность завершений. Это может сократить отдельные расходы и нестабильность уведомления, особенно в специализированном пути. Но активный цикл расходует процессорное время и энергию, которые могли бы использоваться другой задачей. Малое время ответа накопителя при полностью занятом ядре не является бесплатным улучшением эффективности компьютера в целом.
SPDK предоставляет пользовательский путь NVMe с асинхронной подачей и обработкой завершений, а также документирует режимы опроса и прерываний. Это пример конкретной архитектуры, а не утверждение, что все программы должны обходить ядро. Доступность памяти, владение очередью и совместное использование ресурсов остаются важны. В частности, требования к тому, какие потоки одновременно обслуживают очередь, задаются API и должны соблюдаться.
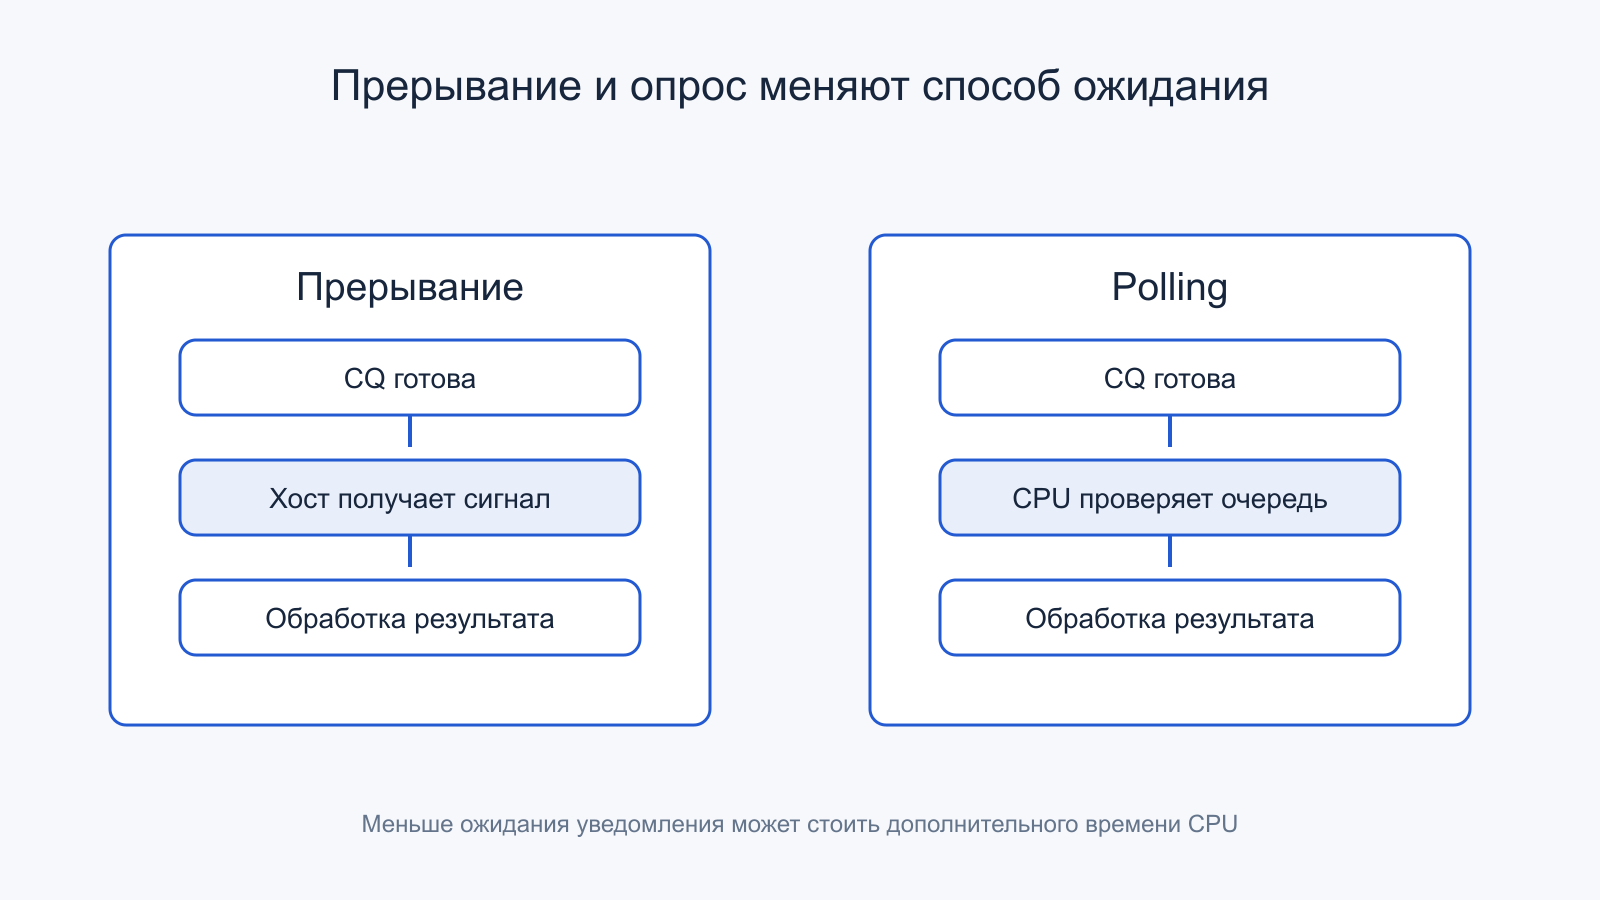
Практический выбор зависит от нагрузки. Постоянно занятый серверный исполнитель может выгодно сочетать опрос нескольких источников работы. На компьютере, который большую часть времени ждёт действий пользователя, та же стратегия способна просто расходовать ресурсы. Существуют смешанные подходы; название polling не описывает единственный алгоритм. Результат оценивают одновременно по задержке, пропускной способности и цене для CPU.
Где размещены память и исполнитель
В многопроцессорной системе путь между ядром, памятью и PCIe-контроллером может проходить через разные внутренние соединения. Буфер, выделенный возле одного процессорного узла, не обязательно одинаково доступен другому. Распределение обработчиков и работающего приложения также способно менять обмен служебными данными между ядрами. Это не отменяет NVMe-команд, но добавляет системные расходы вокруг них. Поэтому результаты специализированного сервера с закреплёнными исполнителями не следует без оговорок переносить на обычную меняющуюся рабочую нагрузку.
Даже внутри одной машины перенос потока между ядрами может изменить состояние кэшей и стоимость обращения к общим структурам. Несколько аппаратных очередей помогают распределять подачу, но сами по себе не выбирают идеальное размещение всех буферов. Полезно указывать топологию при измерении малых различий. При этом ручное закрепление потоков не является обязательной рекомендацией каждому пользователю: смысл примера в том, что локальность и планирование относятся к измеренному пути и могут объяснить расхождение двух внешне похожих опытов.
Размер блока меняет баланс протокола и полезной нагрузки
При 500 000 чтений по 4 КиБ полезный поток составляет 500 000 × 4096 = 2 048 000 000 байт/с, то есть 2,048 ГБ/с. Одни только базовые записи команд и завершений дают 500 000 × (64 + 16) = 40 000 000 байт/с описательной информации. Это расчёт размеров структур, а не полный физический трафик PCIe: транзакции, doorbell, выравнивание, метаданные и другие операции в него не включены.
Для крупных блоков доля описания относительно данных меньше, но отдельная команда дольше занимает каналы и память. Для небольших операций сильнее проявляется стоимость подачи и завершения. Поэтому один и тот же предел ГБ/с не должен сочетаться с любыми IOPS без проверки размера блока. Различие десятичных ГБ и двоичных ГиБ также нужно сохранять: красивые округления не заменяют согласованного расчёта.
Завершённая команда может завершиться ошибкой
CQ сообщает результат исполнения, а не только отметку «готово». Проверка статуса существенна: высокая частота быстро отвергнутых команд не является полезной производительностью чтения. Повторная попытка на другом уровне способна скрыть отдельное событие от приложения и увеличить полную задержку. Таймаут также относится к выбранному слою: отсутствие ответа до его истечения не равно доказанной поломке конкретной ячейки памяти. Для объяснения нужны статус, история запроса и граница, на которой возникло наблюдение.
После сброса контроллера или изменения соединения программный путь может восстанавливать очереди и состояние. Эти действия отличаются от обычного обращения в устойчивом режиме. Если тест включает такой переход, его следует выделить отдельно, а не усреднять с миллионами штатных запросов как однородную выборку. Для прикладной системы важны оба случая, но они отвечают на разные вопросы: сколько занимает нормальный обмен и как долго восстанавливается работоспособность после определённого события.
Как читать задержку в готовом отчёте
Сначала выясняют, измерена ли операция приложения, интервал в драйвере или внутренний показатель устройства. Затем смотрят чтение или запись, размер блока, очередь, число потоков и рабочую область. Для записи важны условия подтверждения и фиксации, а не только факт приёма буфера. Кэш ОС, энергосбережение и фоновые операции могут менять путь запроса даже на одном компьютере.
Среднее не описывает редкие долгие ответы. Процентили требуют достаточного числа наблюдений и понятной методики; короткий запуск не даёт устойчивого основания судить о далёком хвосте распределения. Если сравнивают два программных пути, нужно учитывать одинаковость гарантий и фактической работы. Уменьшение накладных расходов в тесте полезно, но не означает такого же ускорения программы, которая ждёт файловую систему, распаковку или вычисления.
Для практического разбора достаточно наблюдать свою обычную задачу и доступные счётчики, сохранив отдельную копию важных данных. Разрушительная подготовка носителя или многократная запись теста на единственные файлы для понимания очередей не требуется. Содержательный вывод связывает результат с участком пути: подача, ресурсы устройства, передача или уведомление. Такая модель объясняет NVMe значительно точнее, чем попытка приписать всей системе одну минимальную задержку.
В сравниваемых результатах отдельно проверяют, одинаково ли учитывается системный кэш и соблюдены ли требования выбранного прямого ввода-вывода к буферам и выравниванию. Режим, который обходит одну копию, может всё ещё проходить другие программные этапы. Важно перечислить фактически выполненную работу, а не назначать всем путям с похожим названием одинаковую цену. Это помогает отличить ускорение протокольного обмена от изменения самого предмета измерения.
Первичные источники
Кольца и размеры базовых записей рассматриваются по открытой редакции NVMe 2.0a. Она используется как опора для описания механики и не объявляется последней редакцией стандарта. Все численные режимы производительности в статье учебные.
- NVM Express — Base Specification 2.0a: контроллеры, пространства, очереди и завершения.
- Linux Kernel — Multi-Queue Block I/O Queueing Mechanism.
- SPDK — Submitting I/O to an NVMe Device: кольца и путь команды.
- SPDK — NVMe Driver: асинхронная подача и работа с очередями.
- SPDK — Interrupt Mode: опрос, уведомления и работа исполнителя.
Комментарии