DMA и IOMMU: как устройства обмениваются данными с памятью компьютера
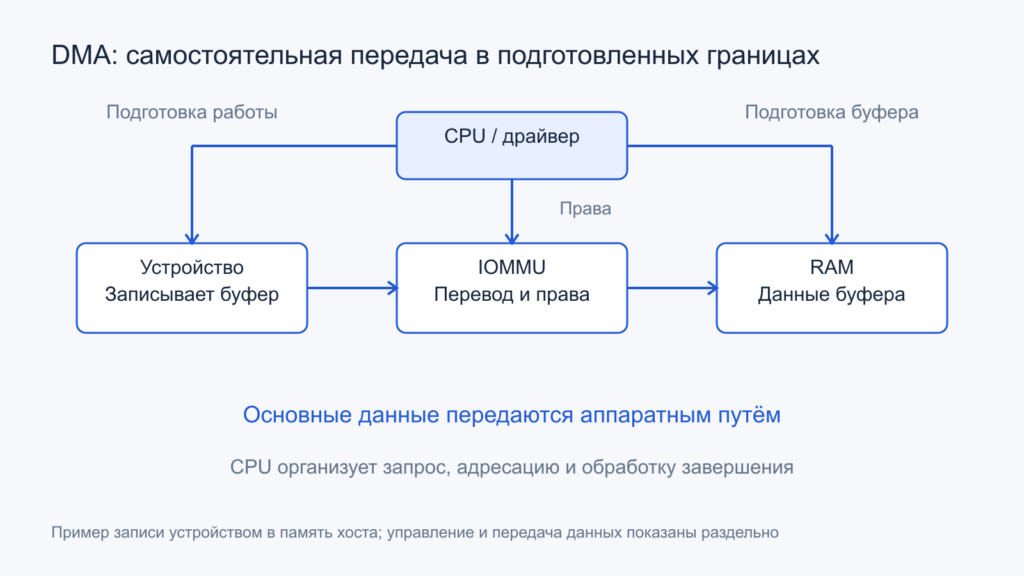
Условный путь приёма данных: самостоятельность DMA сочетается с программной подготовкой, адресными правилами и обработкой завершения. Открыть иллюстрацию в полном размере.
Сетевая карта записывает пакет в оперативную память, а процессор узнаёт о нём позже. SSD переносит большой блок без команды CPU на каждый байт. Видеокарта получает адрес буфера, который не совпадает с указателем программы. За этими действиями стоят DMA, драйвер, правила владения памятью и, на многих платформах, IOMMU. Слова «прямой доступ» описывают способ обмена, но не означают отсутствие управления или ограничений.
DMA помогает устройству самостоятельно выполнять подготовленную передачу. IOMMU преобразует и ограничивает обращения устройств в соответствии с настроенными отображениями. При этом остаются физический транспорт, кэши, очереди, уведомления и время жизни буфера. Для понимания системы полезнее проследить один такой буфер, чем считать DMA волшебным копированием, которое не расходует ресурсы компьютера.
Содержание статьи
- Что делает процессор, если данные переносит устройство
- Один буфер имеет несколько видов адреса
- Как IOMMU выбирает разрешённую память
- Изоляция требует всей цепочки
- Когерентность: кто видит последнюю версию
- Дескрипторное кольцо описывает работу, а не сами данные
- Scatter-gather и непрерывность адресов
- Время жизни буфера важнее существования указателя
- Zero-copy уменьшает конкретную копию
- Переводы и очереди тоже расходуют время
- Виртуализация: разделяют устройства и отображения
- Peer-to-peer требует поддержки маршрута
- Ошибка перевода сообщает о границе доступа
- Как рассуждать о DMA на готовой системе
- Официальные источники
- Читайте также
Что делает процессор, если данные переносит устройство
Без DMA программа могла бы многократно читать регистр устройства и записывать полученное значение в RAM либо выполнять обратную последовательность. Для большого потока это создаёт много управляющих операций. DMA позволяет описать область памяти, направление и размер, после чего аппаратная сторона выполняет основную передачу через предусмотренный системный интерфейс.
У PCIe-устройства необходимая логика обычно находится в самом контроллере: он формирует обращения к памяти как участник шины. В других системах встречается отдельный контроллер DMA, обслуживающий периферийные блоки. Это разные аппаратные реализации одной общей идеи. Нельзя требовать от любой периферии одинакового набора регистров или единого маршрута.
CPU всё равно подготавливает запрос, а драйвер проверяет возможности устройства, выделяет или отображает память, формирует описание работы и обрабатывает результат. Операционная система обеспечивает правила доступа и учёт ресурсов. Для множества маленьких операций эти действия способны занимать существенную долю времени, даже когда сами байты переносит аппаратная логика.
Прямой доступ не означает отдельную бесплатную память. DMA конкурирует за контроллер RAM, межсоединения, PCIe и иногда за кэшовые ресурсы. Снижение загрузки CPU полезно, но само по себе не доказывает уменьшение общего трафика или задержки. Нужно различать стоимость управляющей работы и стоимость перемещения данных.
Направление DMA отсчитывают от конкретного участника
Когда приложение читает файл с SSD, контроллер обычно доставляет полученные данные записью в память хоста. Для пользователя это чтение, для соответствующей DMA-транзакции устройства — запись в RAM. При отправке сетевого пакета карта, наоборот, читает подготовленные байты из памяти. Названия операций на разных уровнях не обязаны совпадать.
Сама полезная передача сопровождается управляющими чтениями и записями: устройство получает дескрипторы, обновляет состояния, а CPU уведомляет очередь. Поэтому поток данных одного направления не означает отсутствие всех обращений в обратном. Для расчёта бюджета отдельно учитывают основные байты и служебные структуры, указывая точку наблюдения.
Это особенно важно для обозначений DMA API: направление обычно определяется относительно устройства и памяти, а не относительно файлового менеджера. Неверная трактовка способна привести к неправильной синхронизации на платформе, где она действительно необходима. При анализе безопаснее сначала написать фразу «устройство читает этот буфер» или «устройство его записывает», а затем сопоставлять её с термином документации.
Один буфер имеет несколько видов адреса
Программа работает с виртуальным адресом CPU. Через процессорные таблицы страниц он связан с физической памятью. Устройство использует DMA-адрес из своего доступного адресного пространства. На простой платформе он может численно совпадать с физическим, но в общем случае между ними существуют преобразования системного моста или IOMMU.
Руководство DMA API ядра Linux прямо разделяет виртуальные адреса CPU, физические адреса и адреса шины. Это объясняет, почему указатель, пригодный для процессора, нельзя безусловно передать устройству. Число в дескрипторе должно иметь смысл для аппаратного пути DMA, а не только для текущего процесса.
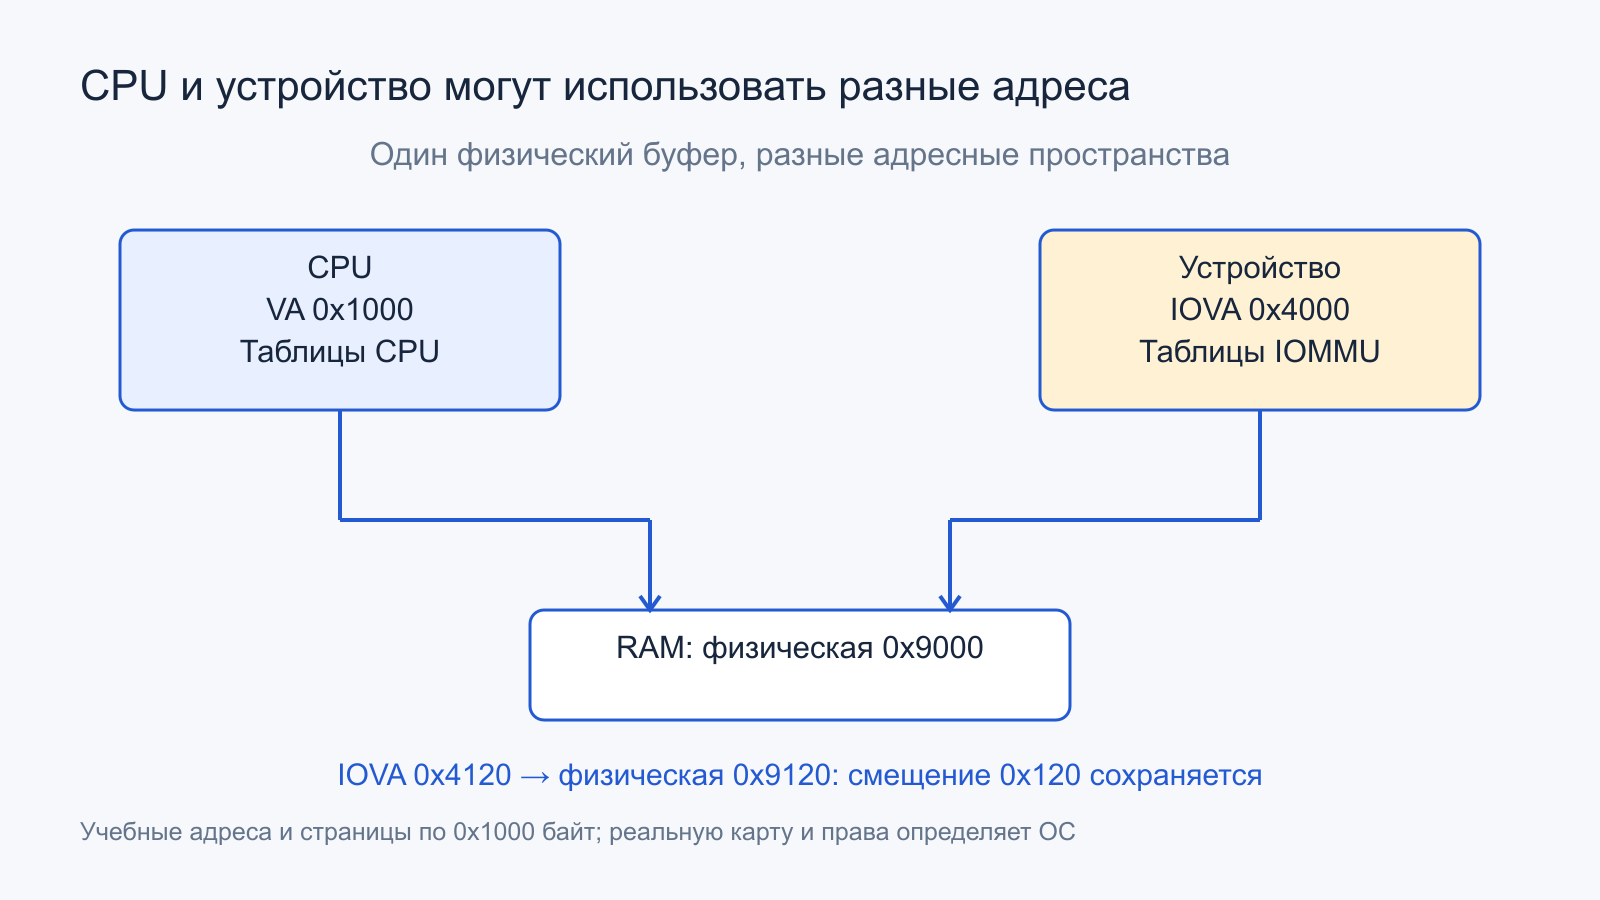
IOVA, I/O virtual address, — адрес, который IOMMU переводит для обращения устройства. Он не обязан совпадать с виртуальным адресом приложения. Некоторые современные режимы допускают более тесное совместное адресное пространство, но для этого нужны специальные аппаратные и программные механизмы. Это возможность определённых конфигураций, а не исходное свойство любого DMA.
Учебное отображение: устройство обращается к IOVA 0x4000, а таблица направляет эту страницу на физическую 0x9000. При размере страницы 0x1000 обращение к 0x4120 попадёт в 0x9120. Смещение 0x120 сохраняется, база меняется. Пример иллюстрирует перевод адреса; он не задаёт действительную карту памяти компьютера или способ обращения к ней.
Адресуемость устройства и размер RAM
Контроллер с 32-битными DMA-адресами способен представить диапазон размером 2³² байт, то есть 4 ГиБ. Это не обязательно означает, что всему компьютеру разрешено иметь только 4 ГиБ RAM. При подходящей IOMMU устройство может видеть допустимый низкий IOVA, который соответствует физической памяти за пределами этого диапазона.
Без такого подходящего преобразования системе иногда нужен промежуточный буфер в доступной области, bounce buffer. Данные дополнительно копируются между ним и исходной памятью. Реальные ограничения включают не только длину адреса, но и выравнивание, размеры сегментов и запрет пересечения определённых границ. Поэтому драйвер согласует доступную DMA-маску и проверяет результат отображения.
Описание DMA API Linux различает адрес, возвращаемый для устройства, и обычный CPU-указатель. Конкретные функции здесь не предлагаются как пользовательская настройка: они показывают, что корректная адресация является работой программного стека, а не следствием совпадения чисел на одной машине.
Как IOMMU выбирает разрешённую память
IOMMU получает обращение устройства и связывает его с настроенным контекстом. В PCIe важна идентификация источника запроса; дополнительные механизмы могут различать более тонкие контексты. По таблицам определяются физическое назначение и права доступа. Адрес вне разрешённого отображения не должен становиться произвольным доступом к другой памяти.
Домен IOMMU объединяет правила отображения для соответствующих участников. Один адрес IOVA в разных доменах может указывать на разные физические страницы. Это полезно при разделении устройств и виртуализации, но само наличие доменов не доказывает, что каждое устройство уже изолировано отдельно. Итог задаётся настройкой платформы и ОС.
Гранулярность защиты тоже имеет значение. Если условное отображение разрешает целую страницу 4 КиБ, наличие внутри неё буфера длиной 128 байт не превращает границу буфера в отдельную аппаратную границу IOMMU. Стек должен правильно размещать и ограничивать доступные области с учётом возможностей перевода. Адресная изоляция на уровне страниц и проверка длины конкретной операции дополняют друг друга.
Результаты переводов кэшируются, чтобы не читать таблицы для каждого байта. Обычно такую структуру называют IOTLB. После изменения отображения необходимо согласованно обновить или инвалидировать связанные сохранённые состояния. Освободить страницу в программе и предположить, что все аппаратные участники уже забыли прежний адрес, нельзя.
Документация IOMMUFD описывает управление I/O-адресными пространствами и аппаратными таблицами в Linux. Она показывает несколько уровней объектов и отображений. Это подтверждает важную границу: IOMMU — управляемая подсистема, а не один глобальный переключатель «адреса теперь безопасны».
Изоляция требует всей цепочки
Чтобы защита работала, аппаратные обращения должны проходить через подходящую IOMMU, переводы и разрешения должны быть настроены, а драйверы — использовать корректные буферы. Широкое разрешённое отображение оставляет широкую область доступной. IOMMU не проверяет смысл пакета внутри разрешённого буфера и не превращает ошибочный драйвер в корректный.
Нужны также правильные правила на этапах загрузки и изменения состояния устройства. Устройство может быть доступно до полного запуска ОС, после возобновления или при подключении. Microsoft перечисляет аппаратные, прошивочные и программные условия Kernel DMA Protection. Указание VT-d или AMD-Vi в характеристиках ещё не подтверждает выполнение всей этой цепочки.
DMA-remapping и переназначение прерываний относятся к связанным, но различным механизмам. Ограничение адресов данных не следует считать универсальным доказательством правильной маршрутизации уведомлений. Также IOMMU не шифрует содержимое буфера автоматически и не защищает его от CPU, которому ОС уже предоставила доступ.
Для безопасной эксплуатации используют документированную конфигурацию платформы и штатную политику ОС. Отключение защиты или искусственное дробление аппаратных границ ради удобства не является объяснением работы DMA и здесь не рассматривается. Инженерная задача состоит в проверке действующих границ, а не в предположении об их наличии по названию технологии.
Когерентность: кто видит последнюю версию
CPU способен хранить изменённую строку в собственном кэше. Устройство может читать или менять память через другой путь. На DMA-когерентной платформе аппаратные механизмы обеспечивают согласованность соответствующих представлений в предусмотренных условиях. На некогерентной системе программному стеку нужны дополнительные действия с кэшем при передаче владения.
Когерентность не следует выводить из наличия PCIe или IOMMU. Эти понятия решают другие задачи. Даже разные области памяти или устройства одной платформы могут требовать особых правил. Корректный драйвер использует интерфейсы ОС, учитывающие архитектуру, а не полагается на удачный результат на одной x86-машине.
Если CPU продолжает менять область, которую устройство уже считает входными данными, проблема не сводится к устаревшему кэшу. Участники могут логически работать с разными версиями. Требуются правила владения: когда буфер готов, кто имеет право его менять и каким событием подтверждается завершение. Когерентность не заменяет протокол взаимодействия.
Отдельно важна гранулярность строки кэша. Две логически независимые области, попавшие в одну строку, могут мешать корректному обслуживанию на некогерентной платформе. Результат зависит от выравнивания и DMA API. Здесь недостаточно рассуждения «устройство пишет только свои байты»: операции поддержания кэша могут затрагивать больший участок.
Порядок действий не возникает автоматически
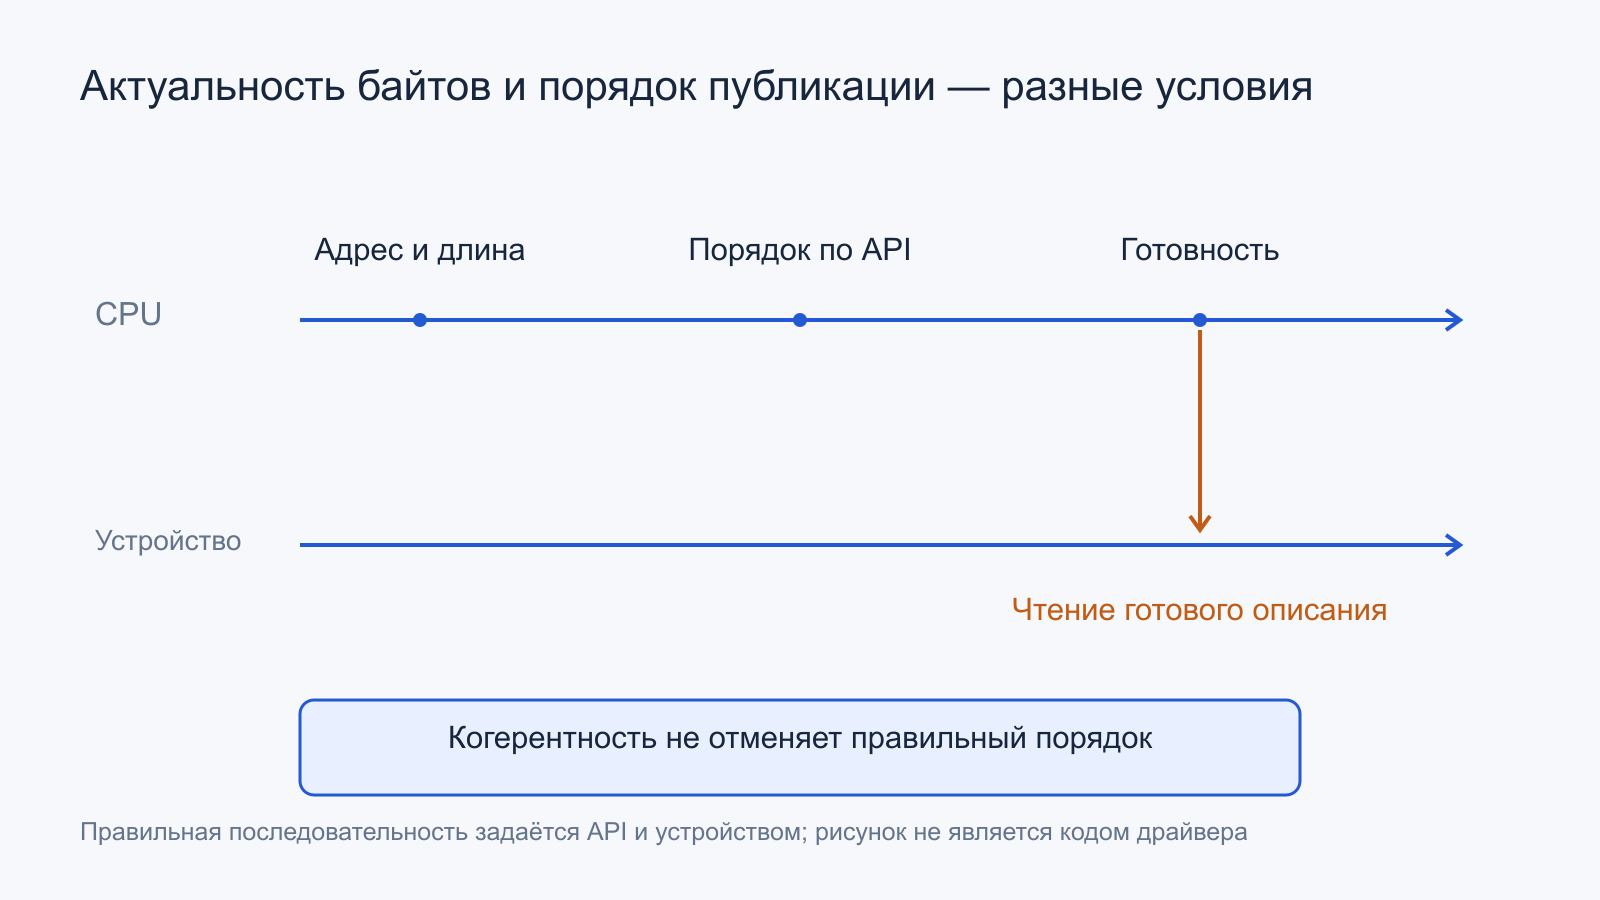
Предположим, драйвер сначала записывает адрес и длину дескриптора, затем помечает его готовым. Устройство должно увидеть поля до того, как начнёт исполнять готовый дескриптор. Когерентная память обеспечивает согласованность данных, но не разрешает забыть про необходимые барьеры и правила записи в MMIO. Видимость и порядок — разные требования.
Поэтому руководство DMA API отдельно предупреждает, что coherent-буфер всё равно требует корректного упорядочивания. Это не означает, что каждой операции нужен один и тот же ручной барьер. Последовательность задаётся API, архитектурой и документацией устройства. Перенос произвольной пары записей из учебного примера в реальный драйвер не является готовым решением.
Дескрипторное кольцо описывает работу, а не сами данные
Устройство часто получает список небольших описателей: адрес, длина, флаги и состояние. Драйвер помещает их в кольцо или очередь, а контроллер забирает готовые задания. Полезные данные находятся в отдельных областях памяти. Адрес кольца и адрес каждого пакета имеют собственные отображения и сроки жизни.
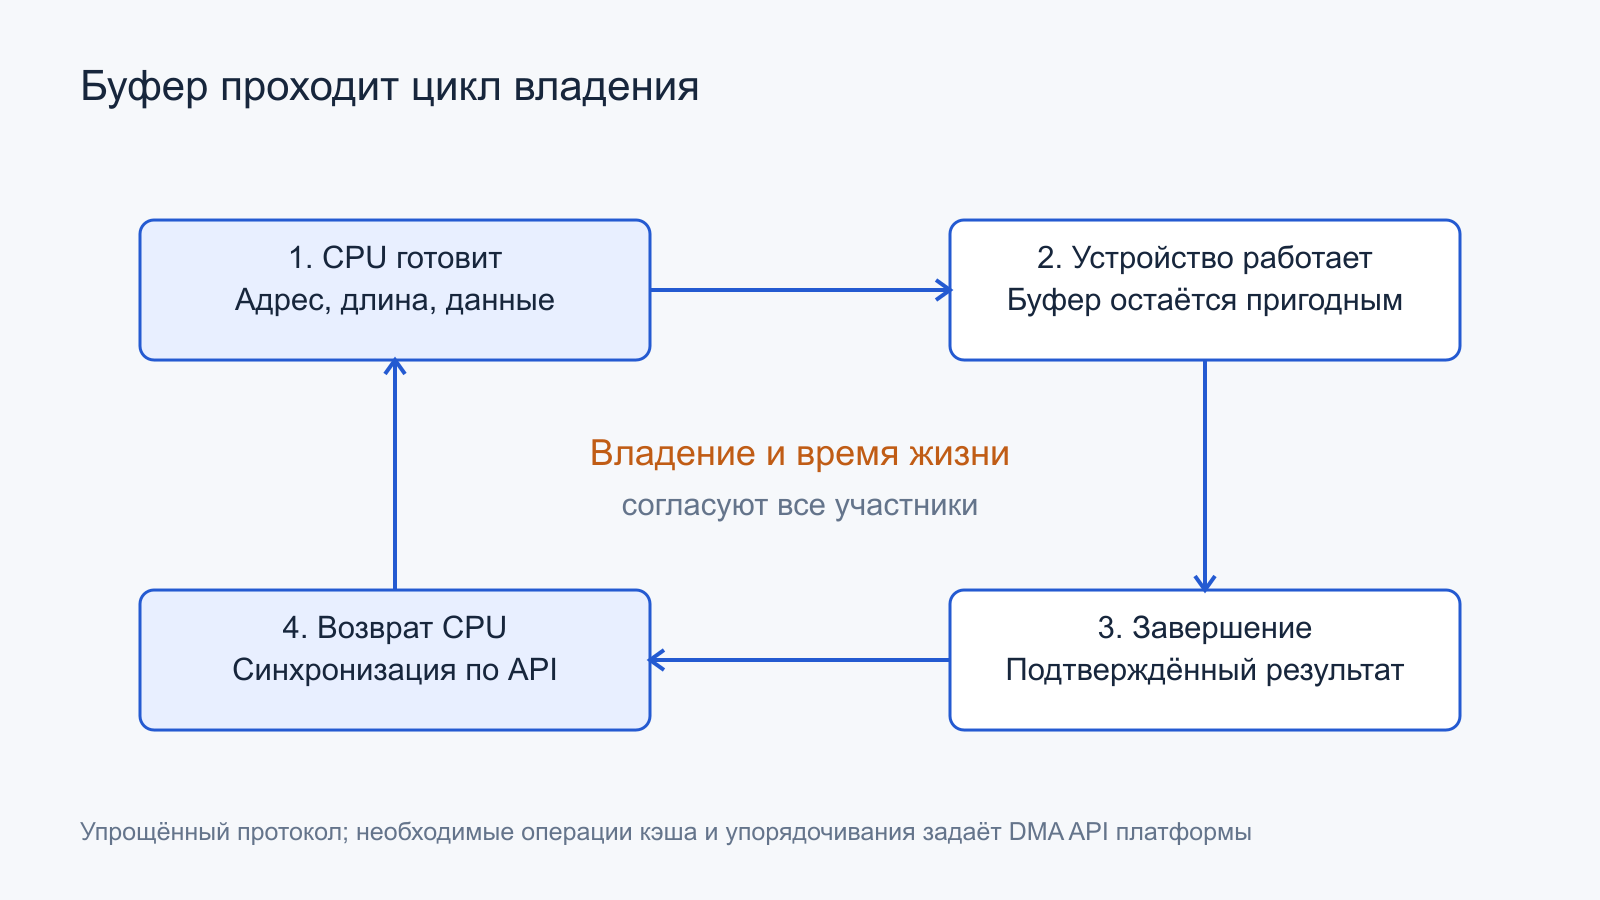
Для приёма сетевого пакета драйвер заранее предоставляет свободный буфер. Карта записывает содержимое, отмечает результат и уведомляет систему предусмотренным способом. CPU затем обрабатывает пакет и возвращает или заменяет буфер. Реальные устройства могут разделять очереди, метаданные и полезные данные сложнее, но переход владения остаётся центральным понятием.
Завершение может сообщаться прерыванием, проверкой очереди или сочетанием механизмов. Не каждый пакет требует отдельного немедленного прерывания. Но отсутствие прерывания не означает отсутствие обработки: polling переносит стоимость в другой режим работы CPU. Выбор связан с задержкой, интенсивностью потока и энергией.
Учебное кольцо из 256 описателей по 32 байта занимает 8192 байта, или 8 КиБ, без полезных буферов. Если каждому соответствует отдельный буфер 2 КиБ, общий подготовленный объём данных составляет ещё 512 КиБ. Эти числа нельзя складывать в «размер одного пакета»: они относятся к запасу очереди, а не к текущему содержимому каждой записи.
Размер кольца задаёт запас, а не готовую задержку
Если в учебной приёмной очереди есть 256 свободных буферов и приходит миллион пакетов в секунду, при полной остановке обработки этот запас закончится примерно за 256 мкс. Предполагаются один пакет на буфер и отсутствие возврата записей. Увеличение кольца даст больше времени пережить такую паузу, но не повысит само по себе скорость обработки CPU.
После паузы нужно обслужить накопившуюся работу. Если средний темп обработки равен темпу поступления, очередь не сможет быстро вернуться к пустому состоянию без дополнительных пауз во входном потоке или запаса производительности. Большой буфер способен скрыть короткий перерыв, одновременно позволив большему числу пакетов ждать. Ёмкость очереди, устойчивая пропускная способность и время ответа поэтому оценивают раздельно.
Scatter-gather и непрерывность адресов
Виртуально непрерывный массив CPU не обязан лежать подряд в физической RAM. Устройство может поддерживать scatter-gather: передача описывается несколькими сегментами. IOMMU в некоторых конфигурациях позволяет представить физически разрозненные страницы как непрерывный диапазон IOVA. Это меняет вид карты для устройства, но не перемещает физические страницы рядом.
Учебный буфер 1 МиБ содержит 256 страниц по 4 КиБ. Без объединения каждая может потребовать отдельного описания. Если условный описатель занимает 32 байта, список потребует 8 КиБ. Поддерживаемое объединение и ограничения границ могут уменьшить число сегментов; точное количество определяет результат отображения, а не только исходное число страниц.
Большой сегмент тоже не равен одной физической операции. PCIe разбивает обмен на транзакции, контроллер памяти обслуживает строки и банки, а устройство имеет ограничения длины. Адресная непрерывность помогает управлять работой, но не отменяет нижние уровни передачи. С другой стороны, множество сегментов добавляет управляющие данные и может ограничивать число одновременно описанных запросов.
Время жизни буфера важнее существования указателя
Память должна оставаться пригодной для DMA, пока устройство имеет право к ней обращаться. ОС и драйвер удерживают необходимые страницы и отображения в соответствии со своим API. Удаление объекта приложения не является доказательством, что аппаратная очередь уже перестала использовать связанный диапазон. Возможны незавершённые операции и отложенные обращения.
Возврат владения включает согласованное завершение работы, необходимые действия с кэшами, снятие отображения и только затем освобождение или повторное использование. Ошибка здесь может проявиться далеко от исходного запроса: устройство запишет в память, которая уже принадлежит другому объекту. IOMMU помогает ограничивать доступ, но корректный жизненный цикл всё равно обязателен.
Постоянно удерживаемые буферы уменьшают часть повторных накладных расходов, однако занимают RAM и ресурсы отображения. Слишком большое число таких областей тоже имеет цену. Поэтому «никогда не снимать mapping» не является универсальной оптимизацией. Решение зависит от очереди, доверенной границы и возможностей ОС.
Zero-copy уменьшает конкретную копию
В обычной цепочке данные могут попасть из устройства в DMA-буфер, затем быть скопированы в буфер приложения. Подход zero-copy пытается устранить одну или несколько таких программных копий. Это способ организации пути, а не обещание отсутствия всякого движения байтов. Устройство всё равно передаёт данные, память обслуживает доступ, а участники согласуют владение.
Условная модель для 1 ГБ: устройство записало его в RAM, приложение один раз прочитало — минимум 2 ГБ обращений к этой памяти. Если между ними CPU дополнительно читает исходный буфер и записывает отдельную копию, получается ещё 2 ГБ. Итого 4 ГБ вместо 2 без учёта метаданных, кэшей и иных перемещений.
Потенциальная экономия относится к заданной границе учёта. Реальные кэши, совмещение операций и организация сетевого стека меняют внешний трафик. Дополнительные отображения, уведомления или удержание страниц могут сделать zero-copy невыгодным для коротких сообщений. Нужно сравнивать завершённую работу, загрузку CPU и задержку при одинаковых условиях.
Bounce buffer показывает обратный случай. Для передачи из RAM устройству CPU читает исходные данные и пишет промежуточные, а затем DMA читает промежуточную область. В простой модели это три объёма обращений к RAM вместо одного чтения DMA. Такой путь может быть необходим для совместимости, хотя внешне операция всё ещё называется DMA.
Переводы и очереди тоже расходуют время
IOTLB скрывает часть стоимости преобразования, но его ёмкость конечна. При доступе к большой разрозненной области могут понадобиться новые обращения к таблицам. Затраты включают также создание и удаление mapping, учёт страниц и синхронизацию. Вывод «IOMMU всегда заметно замедляет» столь же неверен, как утверждение о нулевой цене в любой нагрузке.
Учебные 64 записи переводов по 4 КиБ покрывают 256 КиБ. Если та же условная структура поддерживает 64 записи для страниц по 2 МиБ, покрытие составляет 128 МиБ. Это не спецификация реальной IOMMU: структуры для разных страниц могут различаться, действуют выравнивание и ограничения отображения. Большие страницы не являются универсальным способом ускорения или усиления изоляции.
Уведомления создают другой компромисс. Для миллиона событий в секунду отдельное уведомление на каждое даёт миллион уведомлений. Объединение по 64 события снижает количество до 15 625 полных групп за секунду. Но первый участник группы ждёт остальных. При равномерном интервале 1 мкс до заполнения группы пройдёт до 63 мкс; при редком потоке нужен отдельный механизм ограничения ожидания.
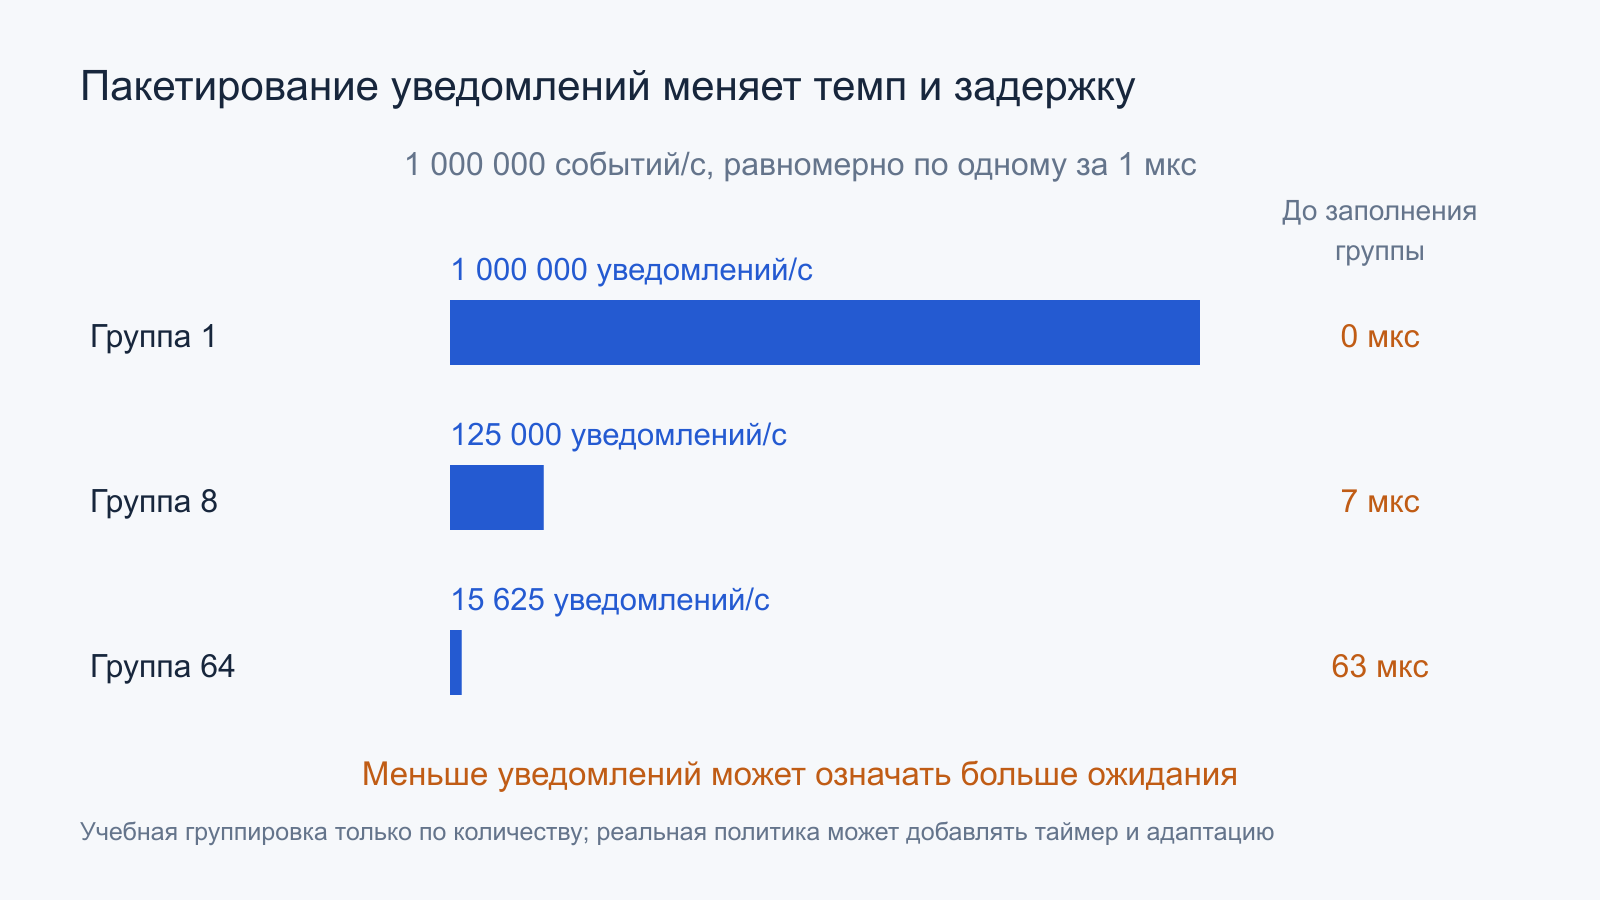
Такая арифметика не предсказывает задержку определённой сетевой карты. Прерывания могут объединяться по таймеру, порогу и адаптивной политике, а CPU продолжает выполнять другую работу. Пример показывает, почему меньше уведомлений не всегда лучше для интерактивного ответа, даже если суммарный темп и загрузка CPU улучшились.
Виртуализация: разделяют устройства и отображения
При назначении устройства виртуальной машине нужно ограничить, какую память оно видит и как доставляются уведомления. Адрес гостя и физическая память хоста находятся на разных уровнях. Некоторые архитектуры поддерживают вложенный перевод; конкретная схема зависит от IOMMU и гипервизора. Наличие виртуальной машины не означает обязательной программной копии каждого байта.
Аппаратная граница изоляции может охватывать несколько функций или устройств. В документации VFIO группа IOMMU отражает минимальную границу, которую стек способен считать изолированной с учётом топологии и возможностей оборудования. Одна функция PCIe в списке не гарантирует полностью независимого поведения от соседней функции.
Ресурсы самого устройства тоже могут быть общими: буферы, процессор контроллера, локальная память и общий восходящий link. Изолированная адресация не обещает независимую пропускную способность или задержку. Виртуализация отделяет права и представления, но не создаёт дополнительную физическую полосу.
Peer-to-peer требует поддержки маршрута
Иногда данные можно передать между устройствами без промежуточного пользовательского буфера в системной RAM. Такой P2P-путь зависит от топологии, возможности адресовать ресурс соседа, правил маршрутизации и согласованной работы драйверов. Два устройства на одной плате не получают его автоматически.
Документация PCI P2PDMA Linux отдельно рассматривает допустимые пути через иерархию PCIe и взаимодействие драйверов. Общий коммутатор может помочь маршруту, но наличие коммутатора не заменяет проверку всей конфигурации. Также остаются правила времени жизни ресурса, если одно устройство прекращает работу раньше другого.
Ошибка перевода сообщает о границе доступа
Если обращение не соответствует отображению или правам, платформа может заблокировать его и сообщить о fault. Для объяснения важны устройство-источник, адресное пространство, направление, состояние очереди и время события. Сам факт сообщения не говорит, какая именно часть программы ошиблась: возможны неверный адрес, преждевременное освобождение, неправильный контекст или аппаратный сбой.
Такое событие нельзя автоматически приравнять к обычному page fault процесса. CPU и устройства используют разные пути, а возможность аппаратно запросить отсутствующую страницу предусмотрена лишь в определённых поддерживаемых режимах. Нельзя предполагать, что ОС просто выделит новую память и незаметно продолжит любой запрещённый DMA.
Корректная реакция сохраняет защитную границу и исследует жизненный цикл обращения. Если ошибка исчезла после расширения доступной области, это ещё не доказывает правильность исходного запроса. Аналогично отсутствие сообщений о fault не подтверждает логическую целостность содержимого: запись в разрешённый, но уже не тот буфер может нарушить работу без выхода за адресные права.
Как рассуждать о DMA на готовой системе
Сначала рисуют путь полезных данных и путь управления. Кто выделяет буфер, какой адрес получает устройство, кто пишет и читает содержимое, когда приходит завершение? Затем уточняют когерентность, отображения и аппаратную топологию. Эта последовательность отделяет «устройство умеет DMA» от работоспособной и изолированной подсистемы.
Для производительности определяют объём полезного результата, количество копий, очередь и границу измерения. Для изоляции проверяют документированный статус защиты и поддержку прошивки, ОС и драйвера. Отдельный график загрузки CPU не отвечает одновременно на вопросы полосы, задержки, энергопотребления и безопасности.
- Виртуальный адрес CPU, физический адрес и DMA-адрес различены.
- Устройство получает адрес из корректного отображения своего контекста.
- Когерентность отделена от порядка операций и логического владения.
- Буфер и mapping живут до подтверждённого завершения аппаратной работы.
- Очереди, уведомления и дополнительные копии включены в модель стоимости.
- IOMMU оценивается вместе с реальной конфигурацией и границами изоляции.
- Zero-copy и P2P описывают конкретный маршрут, а не исчезновение затрат.
DMA даёт устройству самостоятельность внутри подготовленной задачи. IOMMU делает эту самостоятельность адресуемой и ограничиваемой. Надёжность и скорость появляются, когда аппаратная передача, управление памятью и протокол владения работают согласованно; ни одно название технологии не заменяет остальные части этой цепочки.
Официальные источники
- Linux Kernel Documentation — Dynamic DMA Mapping Guide: адреса, DMA-маски, когерентность и владение.
- Linux Kernel Documentation — Dynamic DMA Mapping Using the Generic Device: правила отображения и синхронизации.
- Linux Kernel Documentation — VFIO: группы и аппаратная граница изоляции.
- Linux Kernel Documentation — IOMMUFD: I/O-адресные пространства и аппаратные таблицы.
- Microsoft — Kernel DMA Protection for OEMs: требования к аппаратуре, прошивке и ОС.
- Linux Kernel Documentation — PCI Peer-to-Peer DMA Support: топология и жизненный цикл P2P-ресурсов.
Комментарии