RAID изнутри: зеркала, чётность, запись и восстановление массива
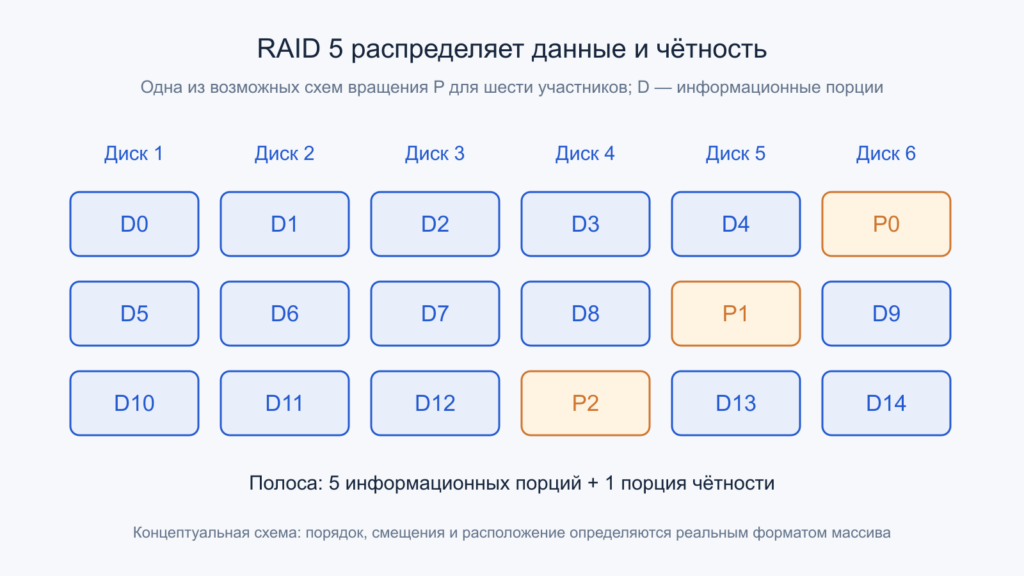
Один из возможных порядков размещения для учебного RAID 5. В каждой полосе пять порций D и одна P; точный формат задаёт действительное отображение массива. Открыть иллюстрацию в полном размере.
Массив из нескольких накопителей выглядит для программы одним устройством, но каждый запрос внутри превращается в несколько действий. Чтение может обслуживаться одной копией, маленькая запись — требовать старых данных и обновления чётности, а замена неисправного диска — занять значительно больше времени, чем простое копирование пользовательских файлов. Поэтому надпись RAID 5 или RAID 10 описывает лишь часть системы: нужны ещё схема размещения, правила подтверждения записи, состояние участников и процедура восстановления.
Разберём устройство распространённых уровней на явно заданных моделях. Все численные примеры учебные, с равными накопителями и указанными допущениями; это не испытания оборудования владельца сайта. RAID предназначен для организации хранения и определённой устойчивости к отказам, но не заменяет независимые резервные копии. Ошибочное удаление, шифрование файлов и логическое повреждение могут правильно и быстро распространиться на все предусмотренные копии.
Содержание статьи
- Логический адрес превращается в положение на участниках
- RAID 0 объединяет полосу, но не создаёт запасной информации
- Зеркало RAID 1 дублирует данные, а не обязательно ускоряет каждую запись
- RAID 10: предел устойчивости зависит от расположения копий
- Как чётность позволяет восстановить один неизвестный блок
- Чем RAID 5 отличается от RAID 6
- Почему полезная ёмкость и число терабайт на этикетках различаются
- Маленькая запись и полная полоса выполняют разную работу
- Кэш записи меняет момент подтверждения, но требует понятной защиты
- Write hole возникает из-за незавершённого согласования полосы
- Деградированное чтение зависит от того, какой блок понадобился
- Восстановление массива ограничивается объёмом и общими ресурсами
- Горячий резерв сокращает ожидание замены, а не создаёт готовую копию
- Проверка избыточности, контрольные суммы и резервная копия решают разные задачи
- Выбор уровня начинается с нагрузки и сценария отказа
- Первичные источники
- Читайте также
Логический адрес превращается в положение на участниках
Верхний уровень отправляет чтение или запись по логическому адресу массива. Реализация RAID определяет, какой участник содержит соответствующий блок, где расположены его копии или избыточная информация и какие операции необходимы. Этим занимается программный модуль ОС, контроллер или другая система хранения. Название уровня само по себе не сообщает, какой процессор выполняет вычисления и где находится кэш.
Для чередования данных используют порции, часто называемые chunk. Несколько таких порций образуют полосу, stripe. Терминология интерфейсов различается: «stripe size» иногда означает порцию одного диска, иногда ширину всей группы. Поэтому число без определения опасно. Если в учебном RAID 5 пять информационных порций по 256 КиБ, полная полезная полоса составляет 1280 КиБ, то есть 1,25 МиБ; порция чётности считается отдельно.
Отображение зависит также от порядка участников, смещения начала данных и схемы вращения чётности. Поэтому одинаковые диски, переставленные местами без учёта метаданных, не становятся автоматически тем же массивом. Стандартизованные описания, например SNIA DDF, фиксируют параметры конфигурации, но не обещают универсальную переносимость любого массива на любой контроллер. Совместимость формата и поддержка конкретного расположения проверяются отдельно.
RAID 0 объединяет полосу, но не создаёт запасной информации
В RAID 0 соседние порции логического потока распределяются по участникам. При равных ёмкостях C и количестве N идеальная доступная ёмкость равна N × C до служебных расходов. Длинная последовательная операция способна задействовать несколько устройств параллельно, если запросы, очередь и интерфейсы позволяют раскрыть эту возможность. Однако короткое обращение, целиком попавшее в одну порцию, обслуживается одним соответствующим участником.
Сумма паспортных скоростей не является гарантированной скоростью программы. Общий канал контроллера, соединение с процессором, обработка запросов и сама нагрузка способны ограничить результат раньше накопителей. Случайный поток с достаточной параллельностью и последовательное чтение одного небольшого файла предъявляют разные требования. Увеличение количества устройств меняет и число возможных одновременных работ, и число компонентов, от которых зависит доступность общего пространства.
RAID 0 не хранит сведения, позволяющие восстановить отсутствующие порции после отказа участника. Это не означает, что каждый сохранившийся сектор физически исчезает, но нормальное целостное логическое устройство больше не обеспечивается. Анализ отдельных остатков не равен восстановлению массива в штатном режиме. Такой уровень оценивают по допустимому времени повторного получения данных и существованию проверенной внешней копии, а не по одной красивой цифре пропускной способности.
Зеркало RAID 1 дублирует данные, а не обязательно ускоряет каждую запись
В простейшем двухстороннем зеркале одни логические данные записываются на два участника. Идеальная полезная ёмкость равна ёмкости меньшей стороны, а не сумме устройств. При потере одной исправной прежде копии работа может продолжиться по другой, если она актуальна и остальные компоненты доступны. Два диска ещё не создают независимые пути питания, контроллеры и файловые истории: это разные уровни защиты.
Параллельное чтение нескольких независимых запросов реализация способна распределять между копиями. Но один последовательный запрос не обязан читаться вдвое быстрее: политика выбора источника, состояние устройств и характер обращений различаются. Запись требуется довести до предусмотренных актуальных копий согласно политике подтверждения. Часто именно более медленная сторона влияет на её завершение, хотя кэширование и специально разрешённые отложенные режимы усложняют картину.
Важно различать наличие двух физических участников и наличие двух полностью синхронизированных копий. Новый диск во время восстановления ещё не содержит всего объёма актуальных данных. Участник, временно пропустивший записи, также не становится достоверным только после повторного подключения. Система должна знать, какие области требуют согласования. Попытка выбрать «похожий» диск вручную без анализа поколения метаданных способна сделать старое содержимое источником ошибочного восстановления.
RAID 10: предел устойчивости зависит от расположения копий
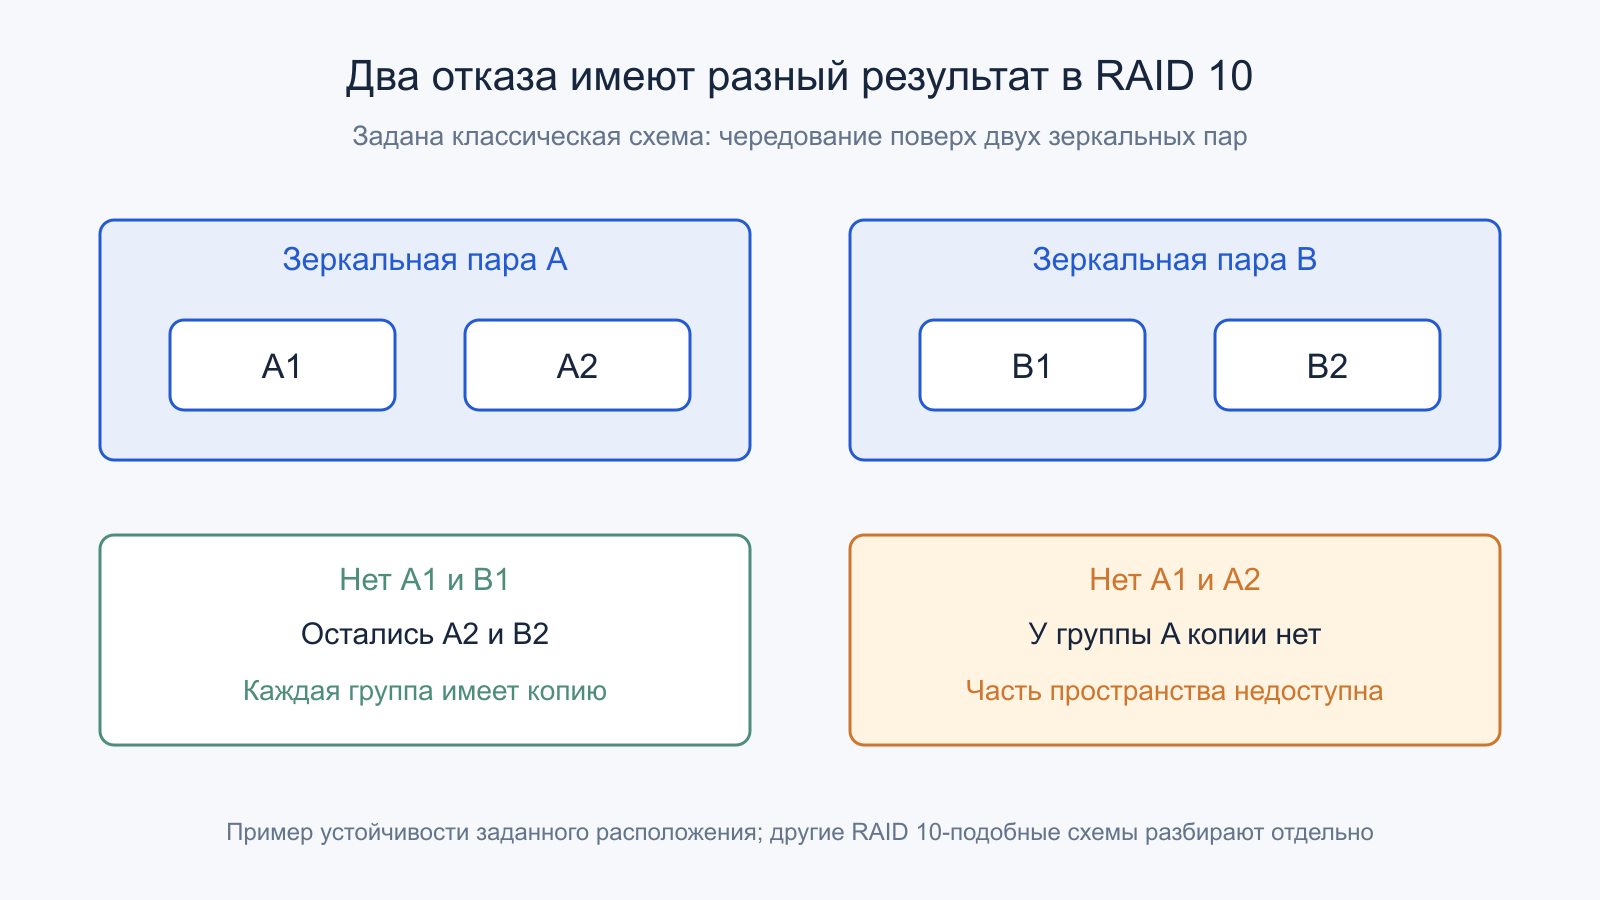
Классическую схему RAID 10 удобно представить как чередование поверх зеркальных пар. Четыре равных диска дают две пары: A1/A2 и B1/B2. Потеря A1 и B1 оставляет по одной копии каждой группы, а потеря A1 и A2 уничтожает обе копии части логического пространства. Поэтому фраза «RAID 10 выдерживает два отказа» без указания их расположения неполна.
Для обычной схемы из N равных устройств с двумя копиями идеальная полезная ёмкость составляет N × C / 2. Это описание заданного расположения, а не универсальная формула всех вариантов с названием RAID 10. Linux поддерживает дополнительные схемы near, far и offset, а некоторые реализации допускают иное число устройств или копий. Их свойства следует разбирать по реальному отображению блоков, а не переносить картинку двух пар на всё семейство.
Отсутствие вычисления чётности не означает отсутствие служебной работы. Контроллер или ОС всё равно маршрутизирует запросы, обновляет копии, хранит метаданные и занимается восстановлением. При нагрузке из мелких записей такая организация может быть удобной, но фактические задержки определяются также накопителями и очередями. Меньшая полезная ёмкость является осознанной платой за выбранную структуру, а не показателем того, что половина устройств простаивает.
Как чётность позволяет восстановить один неизвестный блок
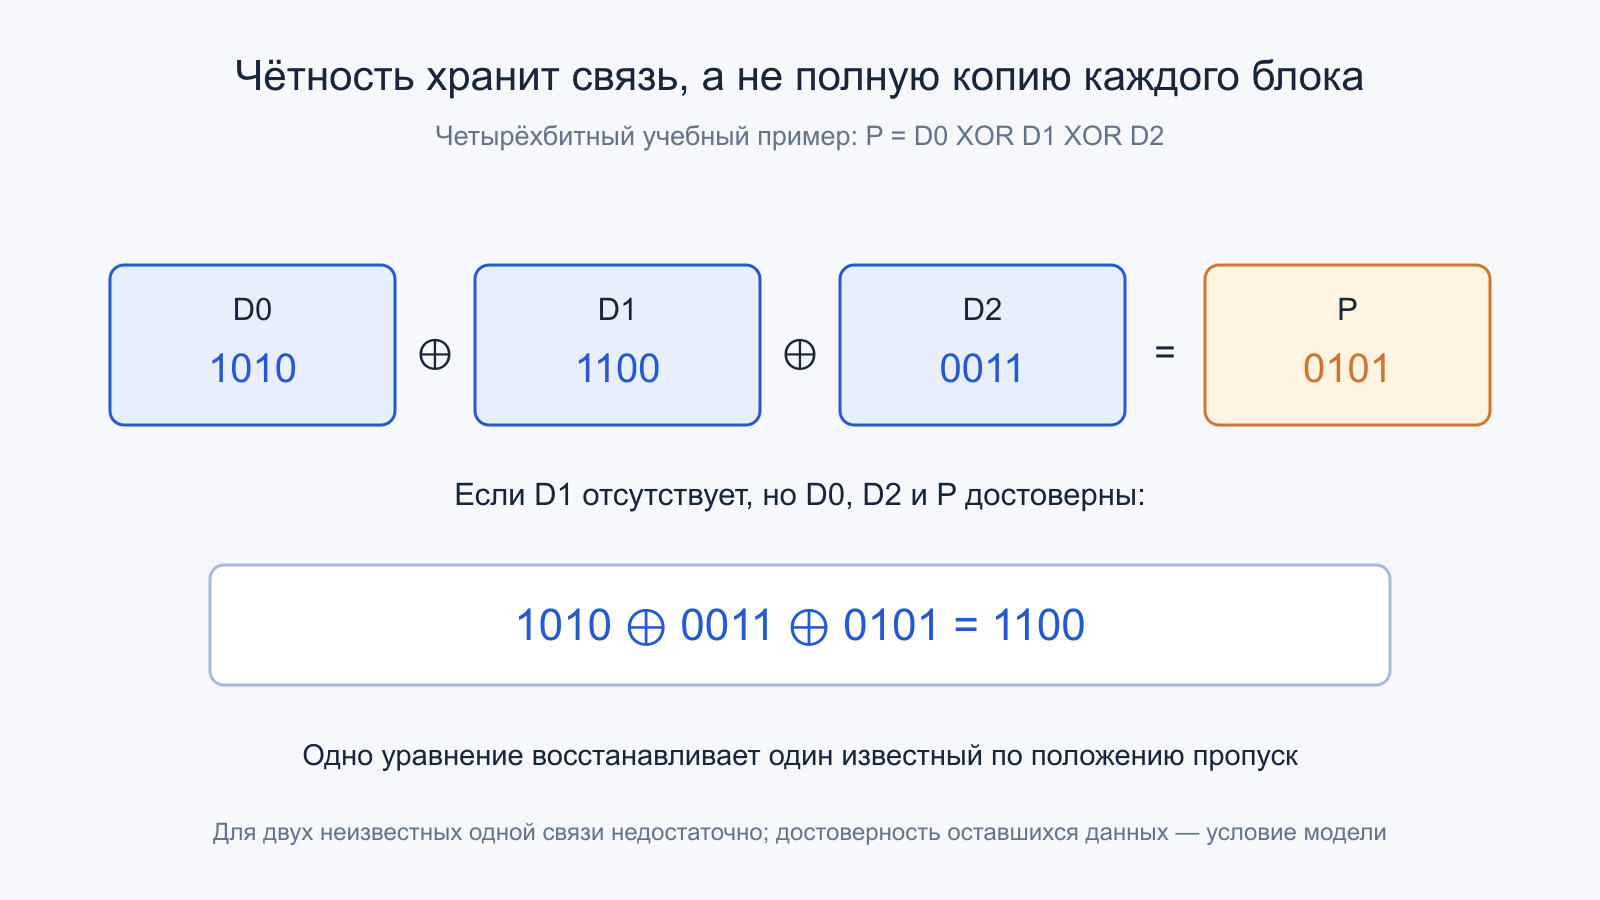
В учебной группе возьмём три четырёхбитных значения: D0 = 1010, D1 = 1100 и D2 = 0011. Побитовое исключающее ИЛИ даёт P = D0 XOR D1 XOR D2 = 0101. Если известно, что отсутствует D1, его можно вычислить как D0 XOR D2 XOR P: 1010 XOR 0011 XOR 0101 = 1100. Здесь используется обратимость операции, а не сохранённая полная копия D1.
Эта модель работает потому, что положение неизвестного известно, а оставшиеся значения достоверны. Если два элемента произвольно изменились, одного уравнения уже недостаточно для однозначного восстановления обоих. Аналогично несоответствие чётности само по себе не всегда сообщает, какой именно блок ошибочен. Необходимо различать объявленную потерю устройства, обнаруженную ошибку чтения и тихое получение неверных байтов — это разные входные условия.
Реальная порция содержит много байтов, над которыми выполняются соответствующие вычисления. Чётность RAID не является сжатием и не позволяет восстановить произвольный объём исчезнувших данных без оставшихся участников. Она хранит строго определённую дополнительную связь. Для понимания полезно сначала восстановить маленький пример вручную, а затем проследить, сколько исходных порций требуется прочитать, когда отказ уже произошёл.
Чем RAID 5 отличается от RAID 6
В обычном RAID 5 одна порция избыточности на полосу распределяется между участниками по заданной схеме. Это устраняет постоянное назначение одного диска только под чётность, но не отменяет общую работу обновления. При N равных устройствах идеальная полезная ёмкость составляет (N − 1) × C. Для рассматриваемой организации требуется не менее трёх участников, а избыточности хватает на одну отсутствующую порцию каждой полосы.
RAID 6 хранит две независимые избыточные связи; их нельзя понимать как две одинаковые копии простого XOR. В распространённых кодах вторая связь вычисляется иначе, чтобы можно было решить задачу двух неизвестных. Подробности зависят от реализации. Для обычной схемы ёмкость равна (N − 2) × C, требуется не менее четырёх участников, а корректное восстановление предполагает сохранность нужных остальных данных и метаданных.
Запас на два отсутствующих диска не делает массив защищённым от любого сочетания ошибок. Повреждение контроллера, согласованно неверная запись или потеря важных метаданных не сводятся к условию «два диска отключились». При выборе уровня полезно сформулировать модель отказа словами. Только после этого становятся понятны ограничения обещания, которое выражает число избыточных порций.
Почему полезная ёмкость и число терабайт на этикетках различаются
Шесть одинаковых накопителей по 8 ТБ дают учебные 48 ТБ в RAID 0, 24 ТБ в классическом двухкопийном RAID 10, 40 ТБ в RAID 5 и 32 ТБ в RAID 6. Это идеальные десятичные значения до метаданных, резервирования и файловой системы. Горячий резерв, не участвующий в хранении пользовательских полос, тоже нельзя одновременно прибавлять к полезной ёмкости работающего массива.
Десятичные 40 ТБ — это 40 × 10¹² байт, или примерно 36,38 ТиБ при делении на 2⁴⁰. Разница единиц не означает, что контроллер спрятал часть пространства. Но поверх неё действительно могут существовать другие расходы: служебные области, выравнивание, журнал, резерв пула и форматирование. Для проекта хранения нужно учитывать оба механизма отдельно, иначе одно объяснение ошибочно подменяет другое.
При разных ёмкостях простая модель обычно ограничивает общую используемую область меньшим участником. Некоторые системы распределяют оставшееся пространство специальными способами, но это уже дополнительная организация, которую следует назвать. Нельзя применять её преимущества к любому массиву RAID 5. Также номинальная ёмкость нового диска не гарантирует совпадения доступного числа секторов с заменяемым: решение принимается по фактическим параметрам совместимой реализации.
Маленькая запись и полная полоса выполняют разную работу
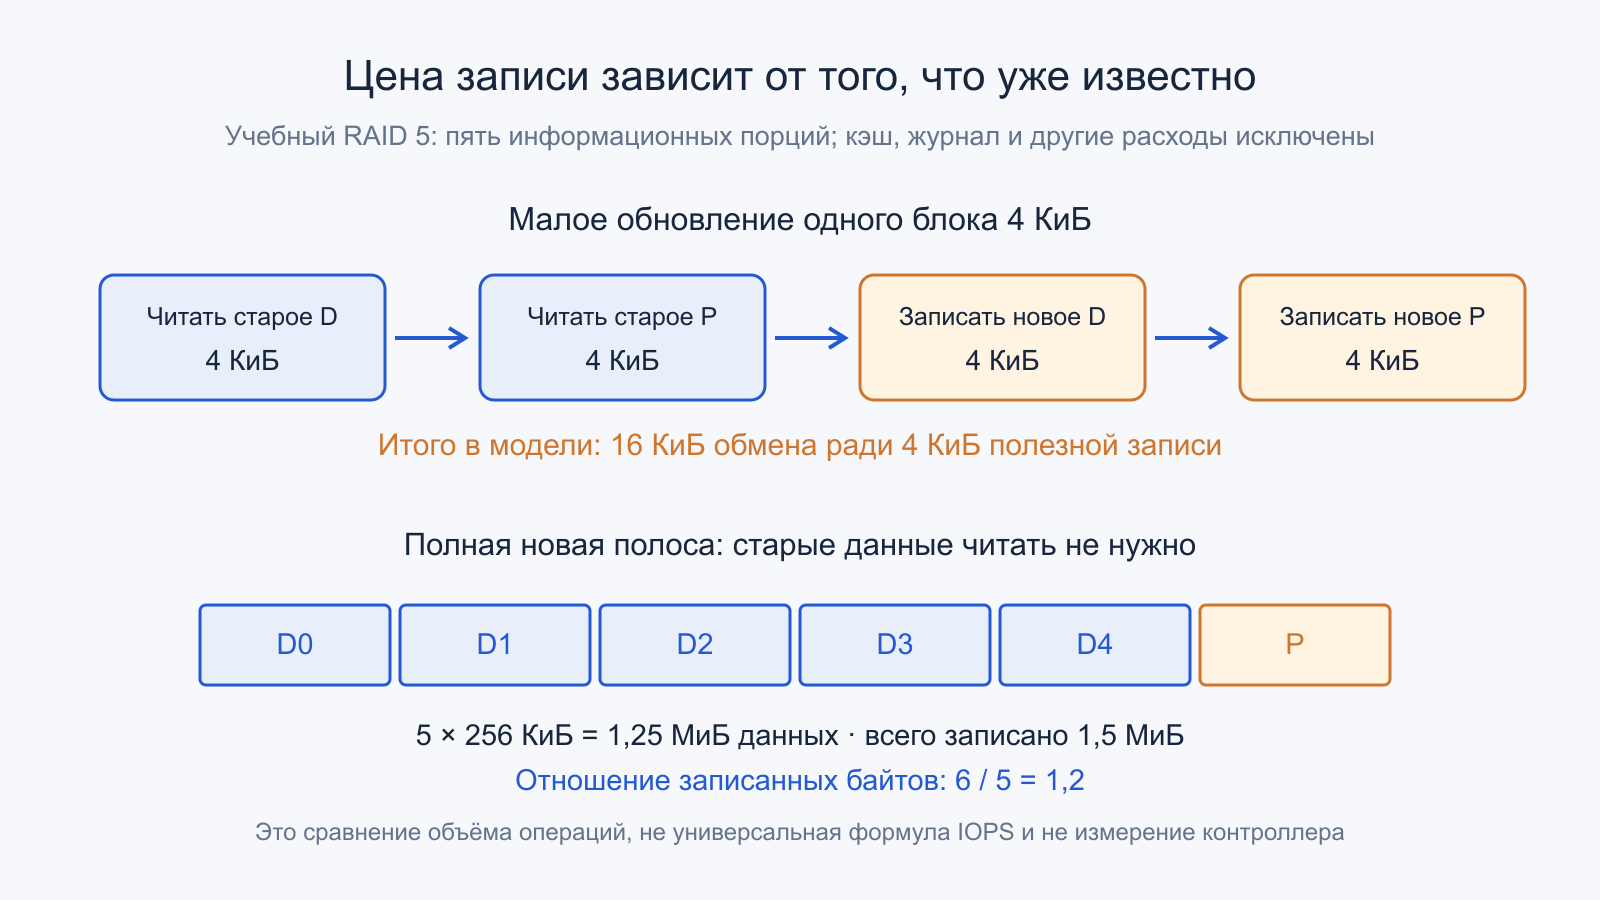
Для простого обновления одного блока RAID 5 можно прочитать прежний информационный блок и прежнюю чётность, вычислить новую чётность, затем записать новое содержимое и новое значение P. Это путь read-modify-write. В учебном случае блока 4 КиБ получаются два чтения по 4 КиБ и две такие записи: 16 КиБ обмена ради 4 КиБ полезного изменения, без прочих расходов.
Если же сразу известны все пять новых информационных порций нашей шестидисковой полосы, прежние данные для вычисления P не нужны. При chunk 256 КиБ программа меняет 1,25 МиБ полезных данных, а массив записывает 1,5 МиБ вместе с чётностью. Идеальное отношение записанных байтов равно 6/5, то есть 1,2. Это другой случай, который нельзя сравнивать с маленькой одиночной записью одной универсальной «штрафной» цифрой.
Реальная система выбирает способ обновления, объединяет запросы и использует кэш. Порции могут приходить не одновременно, а секторная организация и накопители добавляют собственные расходы. Поэтому число четыре не является готовой формулой производительности любого RAID 5 в IOPS. При измерениях фиксируют размер, выравнивание, глубину очереди, долю записи и требование долговечности. Иначе сравнение отражает разные пути выполнения, а не только разные уровни.
Кэш записи меняет момент подтверждения, но требует понятной защиты
В режиме write-back система может подтвердить запрос после помещения в свой кэш, а на основные участники отправить его позже. Это помогает объединять изменения и скрывать задержку. Но нужно точно знать, сохраняется ли уже подтверждённая запись при потере питания и отказе компонента кэша. Обычная энергозависимая память не получает такой гарантии от самого названия RAID.
Защищённый кэш контроллера, журнал на отдельном устройстве и собственная защита питания SSD решают разные задачи. Один механизм не доказывает защиту всей цепочки. Если нижний накопитель подтверждает запись из незащищённого внутреннего кэша и не выполняет необходимые требования сохранения, защищённая память выше не исправляет автоматически это поведение. Важны согласованные гарантии каждого участника и правильная передача запросов долговечности.
С точки зрения приложения запись в буфер ОС, успешное завершение обычного ввода-вывода и предусмотренная синхронизация долговечного состояния — разные события. Массив должен корректно обслуживать соответствующие требования верхнего уровня, но не обязан угадывать намерение программы. Поэтому результаты теста без синхронизации нельзя объявлять скоростью надёжного сохранения транзакций. Сравнивать следует одинаковый смысл завершения, а не одинаковое название кнопки в тестовой утилите.
Write hole возникает из-за незавершённого согласования полосы
Запись полосы затрагивает несколько устройств и обычно не является одной физически неделимой операцией. Если питание исчезло после обновления данных, но до сохранения соответствующей чётности, оставшиеся значения могут относиться к разным поколениям. Пока все исходные блоки доступны, избыточность можно пересчитать. При одновременной потере нужного участника старую чётность уже опасно использовать как доказанно правильную основу реконструкции.
Linux MD документирует разные механизмы защиты этой ситуации. Журнал данных и чётности позволяет организовать восстановление предусмотренной последовательности после сбоя. Partial Parity Log относится к RAID 5 и сохраняет частичную чётность для своей конкретной задачи; он не является полным журналом пользовательских данных и не обещает сохранить все находившиеся в полёте изменения. Эти свойства нельзя произвольно переносить на другой контроллер или уровень.
Карта намерений записи, write-intent bitmap, отмечает области, которым может понадобиться согласование, и помогает ограничить объём повторной обработки. Она не хранит запасное содержимое каждого изменённого файла. Наличие bitmap, журнала файловой системы и журнала RAID — три разных факта. Чтобы понять последствия аварийного выключения, требуется проследить, какие сведения сохранил каждый слой, и по какой процедуре система выбирает согласованное состояние.
Деградированное чтение зависит от того, какой блок понадобился
После потери участника RAID 5 часть логических данных по-прежнему находится на доступных устройствах и может читаться обычным путём. Когда нужен отсутствующий информационный блок, приходится собрать оставшиеся элементы соответствующей полосы и вычислить неизвестное. Поэтому не каждое чтение автоматически становится одинаково дорогим. Доля запросов к отсутствующему содержимому и параллельность нагрузки заметно влияют на наблюдаемую задержку.
Дополнительная работа расходует каналы, очереди, вычислительные ресурсы и время сохранившихся накопителей. При этом фоновые задачи и дальнейшие записи могут продолжаться. Производительность деградированного массива необходимо рассматривать как отдельный режим, а не получать умножением нормальной скорости на постоянный коэффициент. Два одинаковых по ёмкости массива способны по-разному переживать отказ из-за характера обращений и допустимого фона восстановления.
Слово degraded обозначает уменьшение предусмотренного состава или избыточности, а не обязательно уже доказанное повреждение всех файлов. В то же время статус «массив доступен» не обещает, что каждый возможный сектор успешно прочитается. Это особенно существенно, когда реконструкция впервые требует давно не использовавшиеся области. Уровень RAID описывает возможность решения при заданных достоверных входных данных, а не гарантирует, что физические носители всегда предоставят их без ошибки.
Паспортный показатель неисправляемых ошибок чтения нельзя без дополнительных предположений превращать в независимую вероятность каждого прочитанного бита. Простое умножение огромного объёма на показатель и вывод «массив неизбежно потеряется» подменяет инженерную оценку выдуманной статистической моделью. Ошибки могут иметь зависимость от состояния поверхности, условий, времени и особенностей устройства. Корректный вывод скромнее: восстановление обращается к большому объёму сохранившихся данных, поэтому доступность каждого нужного блока и запас избыточности имеют значение. Степень риска оценивают по реальным условиям и достоверным данным, сохраняя независимую возможность восстановления.
Восстановление массива ограничивается объёмом и общими ресурсами
Если требуется заполнить весь компонент ёмкостью 8 × 10¹² байт при эффективной скорости записи 150 × 10⁶ байт/с, только деление объёма на темп даёт около 53 333 секунд, или 14,81 часа. При 80 МБ/с та же модель даёт 27,78 часа. Это нижняя расчётная оценка для заданного постоянного эффективного темпа, без пауз и дополнительных проходов, а не обещанный срок реального rebuild.
В нашей модели полного восстановления одного участника шестидискового RAID 5 для каждой его порции читаются пять остальных. Чтобы записать 8 ТБ на замену, суммарно обрабатываются 40 ТБ входных порций: по 8 ТБ с каждого оставшегося участника. При непрерывных 150 МБ/с на замену этому соответствует около 750 МБ/с суммарного чтения. Другие схемы и оптимизация по используемым областям способны изменить объём работы.
Полезная нагрузка конкурирует с восстановлением за те же устройства и каналы. Увеличение фонового темпа может сократить окно уменьшенной избыточности, одновременно ухудшив задержку приложений. Уменьшение темпа делает обратный обмен. Нужны измеримые требования к обслуживанию и наблюдение за ошибками, а не универсальное положение регулятора. Рост числа дисков также не гарантирует ускорения, если узким местом остаётся заменяемый накопитель или общий путь.
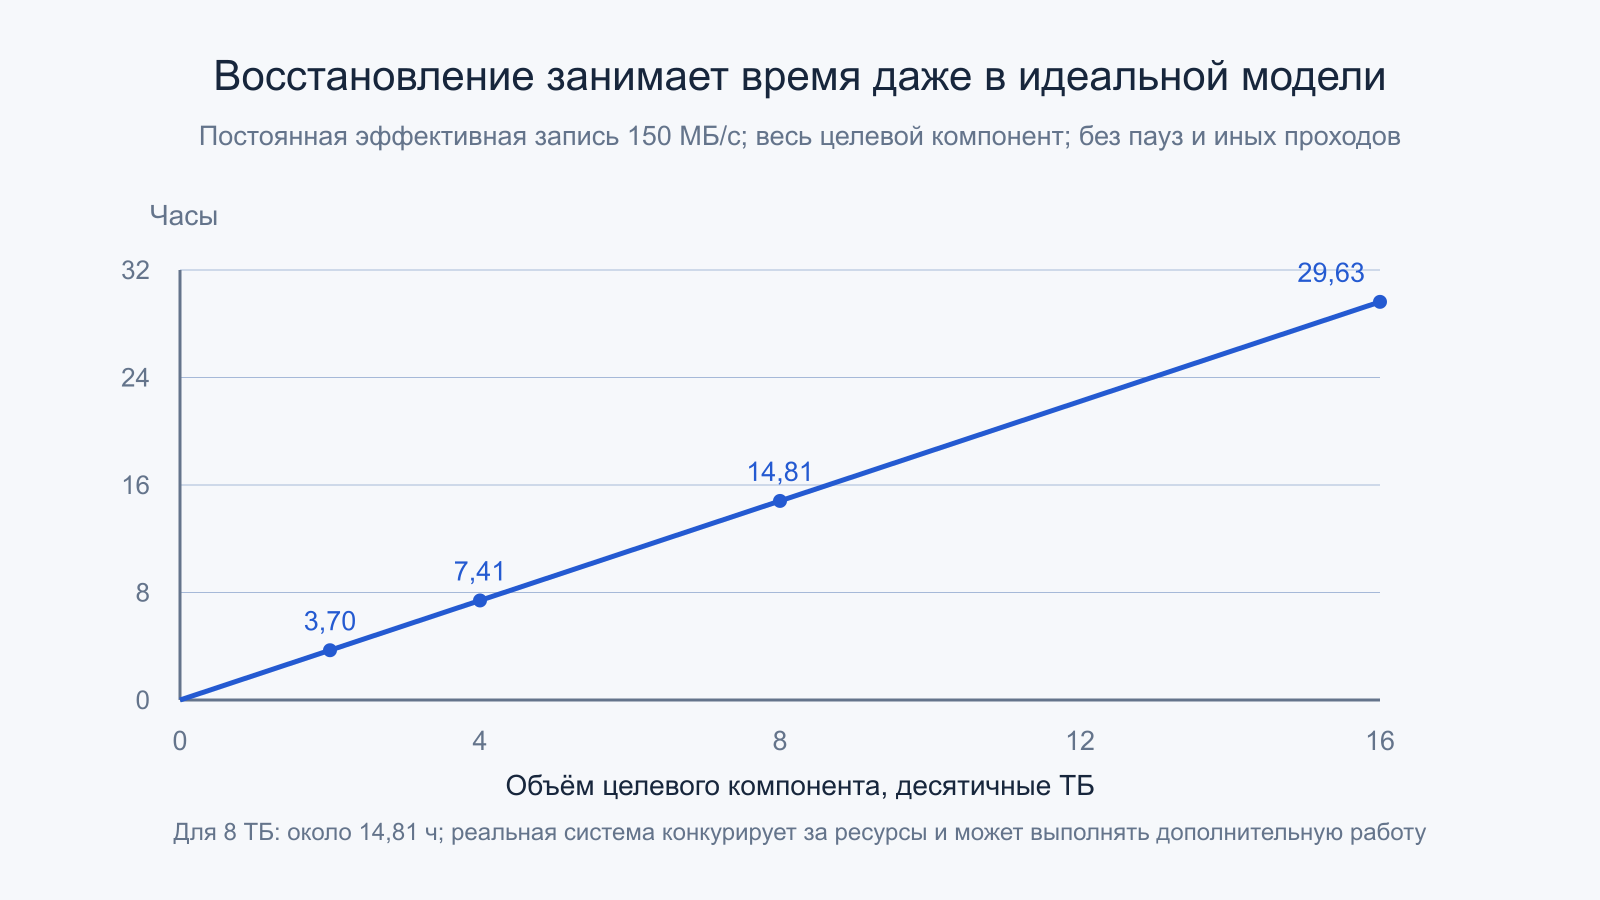
Скорость в этой оценке следует брать для длительной работы в нужных условиях, а не из начального короткого участка теста. У SSD после исчерпания быстрого буфера может измениться темп записи; у дисковых систем существенно поведение длинных потоков и одновременных случайных запросов. Температура и ограничения интерфейса тоже способны влиять на эффективный результат. Это не делает один тип носителя автоматически непригодным, но объясняет, почему паспорт последовательной скорости не задаёт время восстановления. Измеряют подходящую нагрузку, фиксируют объём обработанных областей и уточняют оценку по фактическому продвижению, сохраняя запас на неопределённость.
Горячий резерв сокращает ожидание замены, а не создаёт готовую копию
Hot spare заранее подключён и доступен для назначения вместо отказавшего участника. До включения в восстановление он обычно не содержит актуальных пользовательских полос этого массива. Поэтому резерв нельзя считать ещё одной полностью синхронизированной копией. Его польза в сокращении времени реакции: системе не требуется ждать, пока человек привезёт, установит и правильно назначит подходящий накопитель.
После назначения запасного устройства всё равно предстоит перенести или реконструировать данные. До завершения соответствующих областей защита не становится эквивалентной нормальному состоянию. Далее возможны дополнительные операции переноса обратно на выбранное место; это свойства политики реализации, а не обязательное поведение всех массивов. В отчёте нужно называть фактическое состояние и процент выполненной работы, а не просто факт наличия запасного диска в корпусе.
Различаются выделенный резерв одного массива и общий резерв нескольких групп. Совместимость ёмкости, интерфейса, форматирования и политики назначения проверяют заранее. Также нужен сигнал об отказе: физически установленный запасной участник мало помогает, если его состояние неизвестно или автоматическое назначение не предусмотрено. Резерв уменьшает организационную задержку, но не заменяет наблюдение за системой и независимый план возврата данных.
Проверка избыточности, контрольные суммы и резервная копия решают разные задачи
Фоновая проверка может обнаружить несоответствие зеркальных копий или чётности и вызвать чтение редко используемых областей. Но проверка согласованности не всегда знает, какое из отличающихся содержимых является правильным пользовательским результатом. Если обе стороны зеркала читаются, но различаются, для выбора нужны дополнительные сведения. Обычный RAID не следует автоматически наделять сквозными контрольными суммами всех файлов.
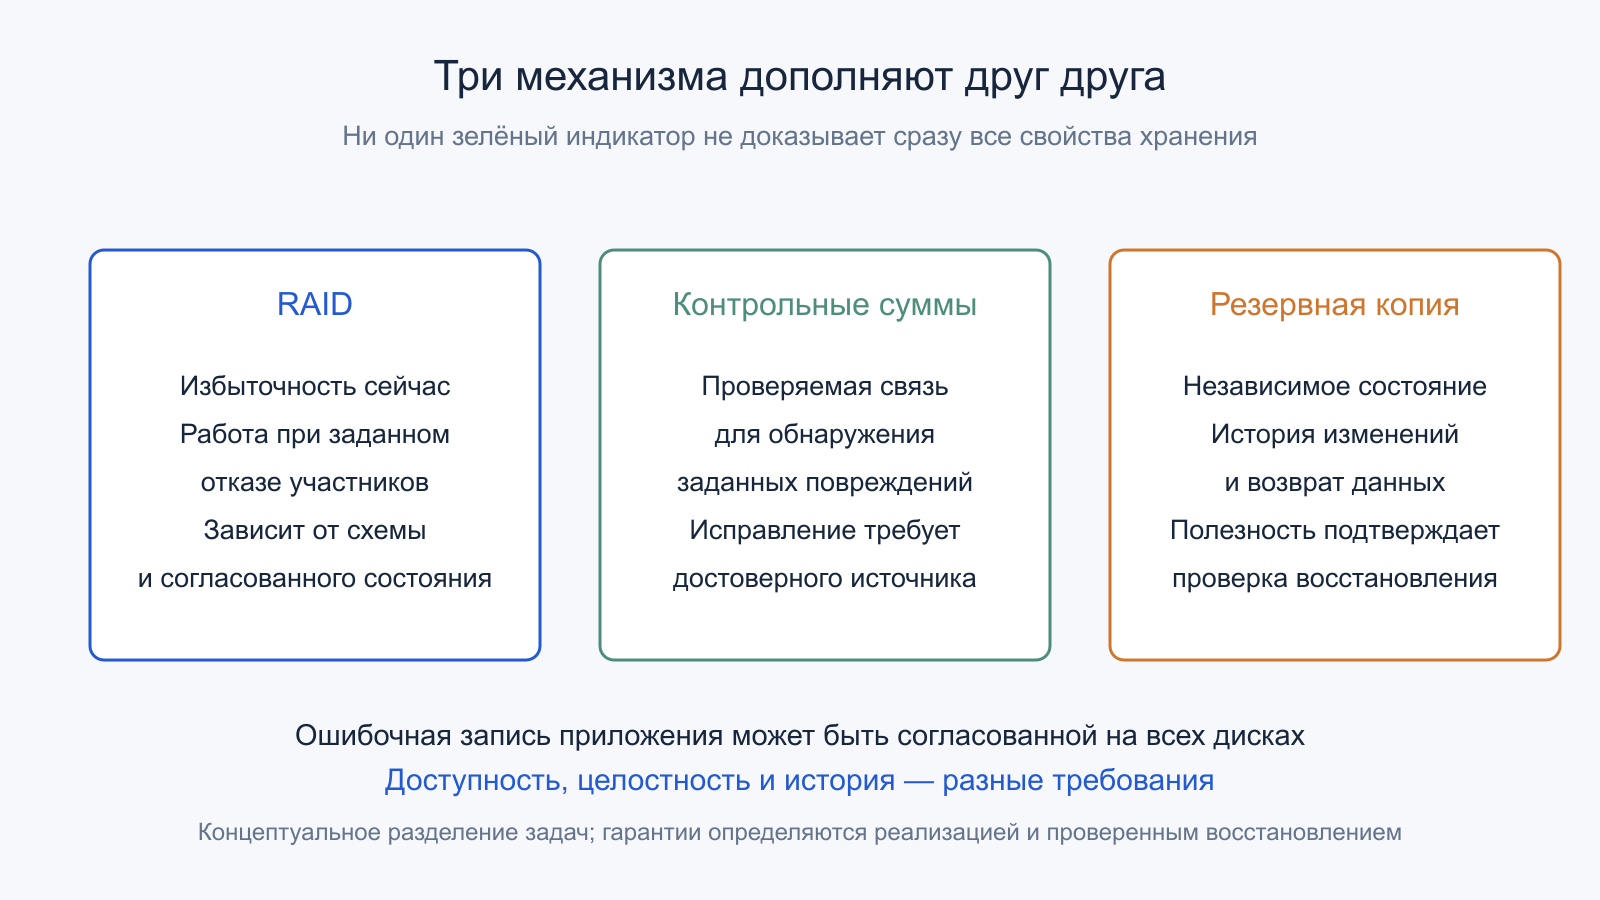
Системы, которые связывают данные с проверяемыми контрольными суммами и используют избыточность для исправления, обладают дополнительным механизмом. Его наличие зависит от всего стека хранения. Даже такая защита не распознаёт законную с технической точки зрения, но ошибочную запись приложения. Если программа сохранила неверные данные и контрольная сумма рассчитана для них, все нижние слои способны согласованно подтвердить именно этот результат.
Резервная копия хранит независимое состояние, к которому можно вернуться после нежелательного изменения или потери основной системы. Её полезность подтверждается проверкой восстановления и достаточной историей. Массив поддерживает доступность в предусмотренном классе отказов, проверка избыточности оценивает внутреннее согласование, контрольные суммы обнаруживают заданные повреждения. Эти механизмы дополняют друг друга; один зелёный индикатор не доказывает сразу все три свойства.
Выбор уровня начинается с нагрузки и сценария отказа
Сначала описывают объём полезных данных, характер чтения и записи, размер обращений, необходимую параллельность и допустимую задержку. Затем рассматривают работу при отказе и восстановлении: какие приложения должны продолжать обслуживаться, какой фон допустим и сколько времени занимает возврат полной избыточности. Для больших последовательных файлов и мелких синхронных изменений важны разные пути. Таблица нормальных мегабайт в секунду не раскрывает оба случая.
Следующий вопрос — общие причины отказов. Несколько дисков могут зависеть от одного питания, разъёма, контроллера, прошивки или внешнего события. Модель независимых случайных отказов каждого носителя не описывает такие зависимости. Именно поэтому оценка массива не заканчивается подсчётом «сколько дисков может выпасть». Проверяют физическую организацию, наблюдение, доступность замен и возможность восстановить нужное состояние вне общего домена отказа.
Для действующей системы полезнее сначала составить карту участников и гарантий, чем немедленно менять уровень. Название RAID, ёмкость, расположение копий, политика кэша, журналирование, текущая синхронизация и проверенная резервная копия должны образовать непротиворечивую картину. Преобразование или принудительная сборка массива меняют данные и требуют отдельной процедуры; статья не предлагает универсальных команд для этих действий. Хорошее решение определяется тем, что система действительно выдерживает, а не количеством установленных накопителей.
Первичные источники
Общие схемы отделены от примеров конкретных реализаций. Документация Linux описывает поведение MD и dm-raid, а руководство Seagate — указанное семейство NAS OS; их ограничения не объявляются свойствами любого контроллера.
- Linux Kernel — RAID arrays: метаданные, состояния, синхронизация и проверка избыточности.
- Linux Kernel — RAID 4/5/6 cache: журнал, write-through, write-back и момент завершения ввода-вывода.
- Linux Kernel — Partial Parity Log: назначение и границы защиты PPL для RAID 5.
- Linux Kernel — dm-raid: варианты расположения чётности и копий RAID 10.
- Seagate — Business Storage NAS OS: RAID Modes.
- SNIA — Common RAID Disk Data Format Specification, Version 2.0 Revision 19.