ECC, CRC и SMART: как компьютер обнаруживает ошибки данных и где заканчивается защита
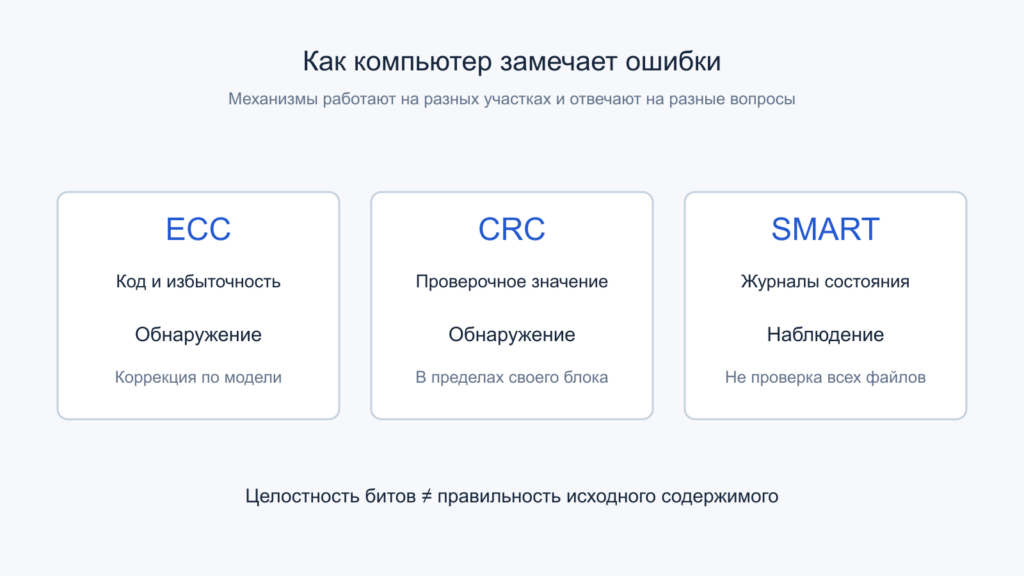
ECC, CRC и SMART отвечают на разные вопросы: коррекция по модели, проверка блока и наблюдение состояния. Открыть иллюстрацию в полном размере.
Данные проходят через вычислительные блоки, кэши, оперативную память, контроллеры, линии связи и накопитель. В каждом месте возможны свои ошибки: изменившийся бит, неверный адрес, потерянная запись или корректно выполненная команда с неправильным содержимым. Поэтому у компьютера нет одного универсального признака «данные защищены». Есть несколько механизмов с разными границами действия.
ECC добавляет избыточность для обнаружения и предусмотренной коррекции ошибок. CRC обычно помогает обнаруживать повреждения блока при передаче или хранении. SMART и родственные журналы состояния сообщают о работе накопителя, но не проверяют смысл каждого файла. Эти средства полезны вместе, если понимать, что именно проверено и какая ошибка остаётся за пределами проверки.
Содержание статьи
- Защищённый участок всегда имеет начало и конец
- От контроля чётности к корректирующему коду
- Что обещает SECDED и к какому слову относится обещание
- On-die ECC и платформенный ECC находятся на разных уровнях
- Коррекция, журналирование и очистка накопившихся ошибок
- Как работает CRC и почему полином имеет значение
- Учебный CRC: обнаружение и конкретный предел
- Почему несколько проверок не образуют одну непрерывную границу
- SMART описывает состояние, а не подтверждает каждый байт
- Обнаружить повреждение и восстановить данные — разные возможности
- RAID сохраняет доступность при части отказов, но не историю
- Как читать систему защиты целиком
- Вопросы к характеристикам и журналам
- Первичные источники
- Читайте также
Защищённый участок всегда имеет начало и конец
Представим путь: приложение сформировало буфер, контроллер памяти закодировал данные, накопитель принял команду, его контроллер записал содержимое в NAND, а файловая система позднее прочитала файл. Проверка на одном участке не охватывает автоматически остальные. Например, код памяти не обязан замечать ошибку, возникшую после того, как данные уже покинули защищённую область.
Особенно важен момент формирования проверочной информации. Если программа по ошибке записала число 1235 вместо требуемого 1234, ECC и CRC могут безукоризненно защищать именно 1235. Все проверки сойдутся: повреждения после кодирования не было. Аппаратная целостность битов отличается от правильности расчёта, адреса назначения и намерений пользователя.
Поэтому правильный вопрос звучит конкретно: какой блок данных закодирован, где проверяется код и какие изменения он должен обнаруживать? Слово ECC на странице памяти, контрольная сумма архива и зелёный статус диска отвечают на разные вопросы. Нельзя складывать их в единый процент гарантии сохранности.
От контроля чётности к корректирующему коду
Простейший учебный пример — один бит чётности для группы данных. Он выбирается так, чтобы число единиц в защищённом слове было чётным или нечётным по принятому правилу. Изменение одного бита нарушает условие. Но два изменившихся бита могут восстановить прежнюю чётность: проверка совпадёт, хотя содержимое уже другое.
Одна проверка также обычно не сообщает, какой именно бит изменился. Для коррекции нужно больше взаимосвязанных проверочных соотношений. Они формируют признаки, по которым декодер различает предусмотренные ошибочные состояния. Это принципиальная разница между обнаружением несовпадения и восстановлением исходного значения. Наличие избыточного бита само по себе не означает возможности исправить любые данные.
Что обещает SECDED и к какому слову относится обещание
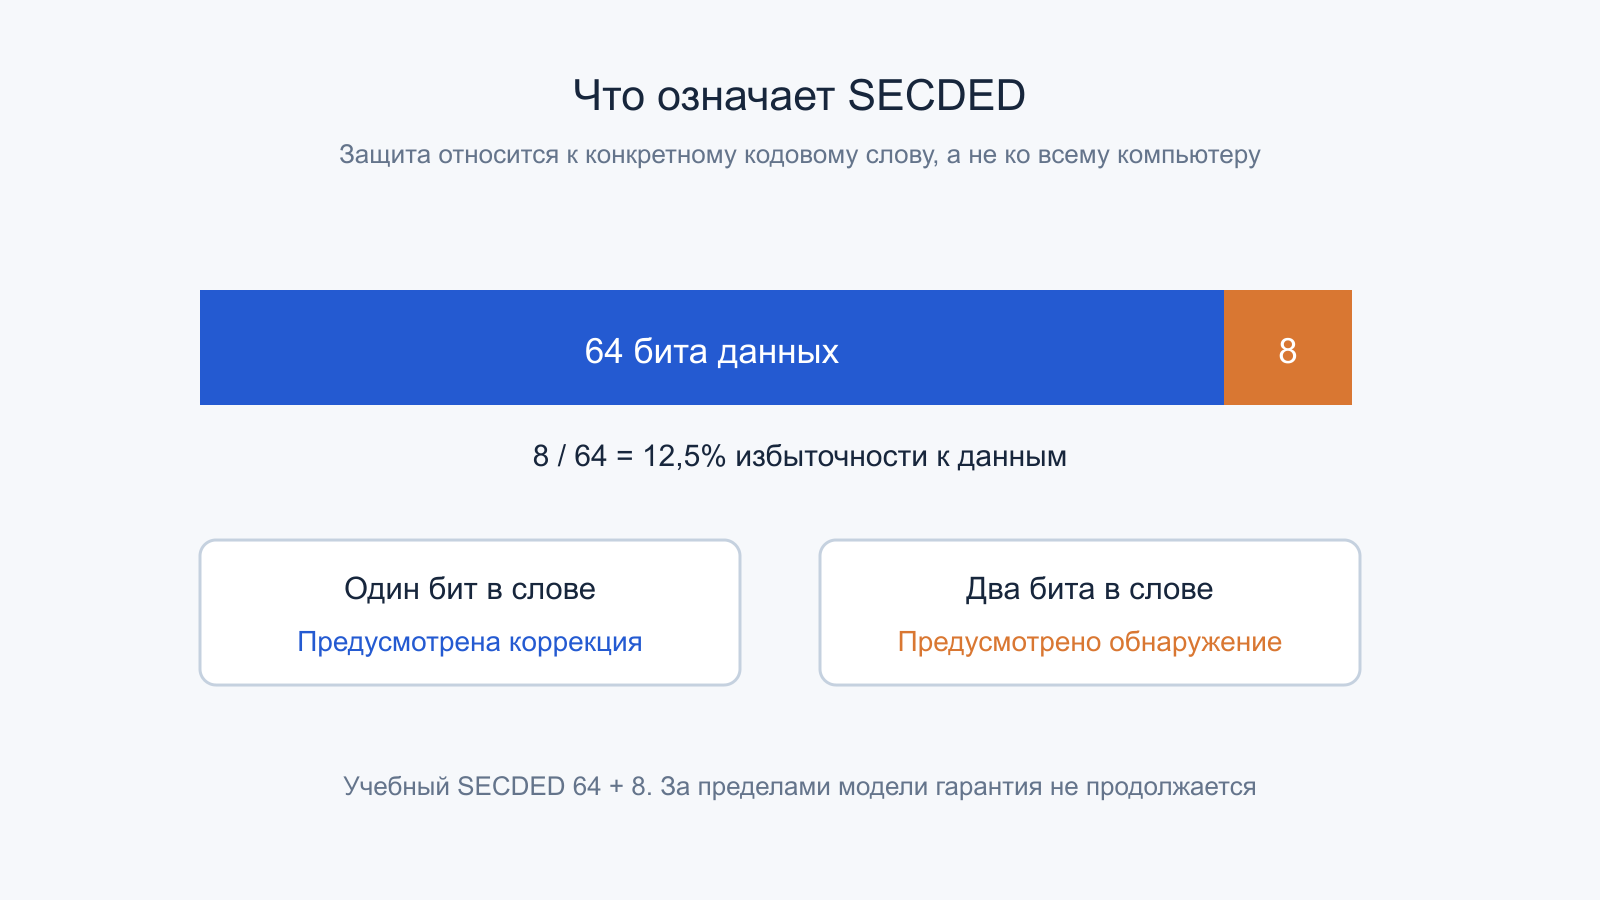
SECDED означает Single Error Correction, Double Error Detection: исправление одиночной и обнаружение двойной битовой ошибки в пределах конкретного кодового слова. В классическом варианте используется расширенный код Хэмминга. Проверочные соотношения дают синдром; дополнительная общая чётность помогает различать определённые случаи. Исправление выполняют по правилам данного декодера.
«Одна ошибка» здесь означает один изменившийся бит в защищённом кодовом слове, а не один отказ на всём компьютере. За секунду могут быть исправлены одиночные ошибки в разных словах, если подсистема это поддерживает. И наоборот, одна физическая помеха способна затронуть несколько битов одного слова и выйти за возможности коррекции. Важны расположение повреждений и организация памяти.
Учебная арифметика для 64 полезных битов выглядит так: семь проверочных разрядов позволяют выделить достаточно синдромов, поскольку 2⁷ = 128 ≥ 64 + 7 + 1. Добавление общей чётности даёт знакомую схему 64 + 8 = 72 бита. Это пример построения кода, а не обязательный формат каждой современной подсистемы DDR5.
Избыточность относительно полезных данных составляет 8 / 64 = 12,5%, а доля полезных битов в полном слове — 64 / 72 ≈ 88,9%. Эти проценты имеют разные знаменатели. Их нельзя автоматически объявлять потерей пропускной способности на 12,5%: проверочные линии, организация доступа и размещение кодов зависят от реализации.
Маленький пример синдрома
Чтобы увидеть сам принцип, возьмём обычный учебный код Хэмминга 7,4 без дополнительной общей чётности SECDED. Проверочные позиции пронумеруем 1, 2 и 4; данные займут позиции 3, 5, 6 и 7. Для данных 1011 при чётной проверке получится слово 0110011, записанное слева направо от позиции 1 к позиции 7.
Первая проверка охватывает позиции 1, 3, 5, 7; вторая — 2, 3, 6, 7; третья — 4, 5, 6, 7. Если изменится бит в позиции 6, нарушатся вторая и третья проверки. Их веса дают 2 + 4 = 6: синдром указывает позицию предполагаемой одиночной ошибки. Декодер может вернуть этот бит в исходное состояние.
Однако слово «предполагаемой» существенно. Синдром интерпретируется в принятой модели одиночной ошибки. Если изменить другую комбинацию битов, тот же набор нарушений не обязан означать тот же физический случай. Дополнительная чётность расширенного кода нужна именно для различения предусмотренных состояний. Учебный пример не описывает точную разводку DIMM и не обещает защиту от произвольного отказа микросхемы.
Почему больше двух ошибок — отдельный случай
За пределами заявленной модели результат не обязан оставаться безопасным. Для обычного SECDED некоторые многобитовые повреждения могут выглядеть как исправимая одиночная ошибка, и декодер изменит ещё один бит. Другие комбинации способны превратить одно допустимое слово в другое. Поэтому фраза «ECC исправит один бит, а всё остальное обязательно обнаружит» неверна.
Более сильные схемы защищают другие модели ошибок: например, группы битов или отказ определённого устройства памяти при подходящей организации. Но название семейства не раскрывает условия полностью. Нужны сведения о контроллере, режиме, структуре модулей и выбранном кодировании. Нельзя переносить возможности серверной схемы на любую плату только по наличию букв ECC.
On-die ECC и платформенный ECC находятся на разных уровнях
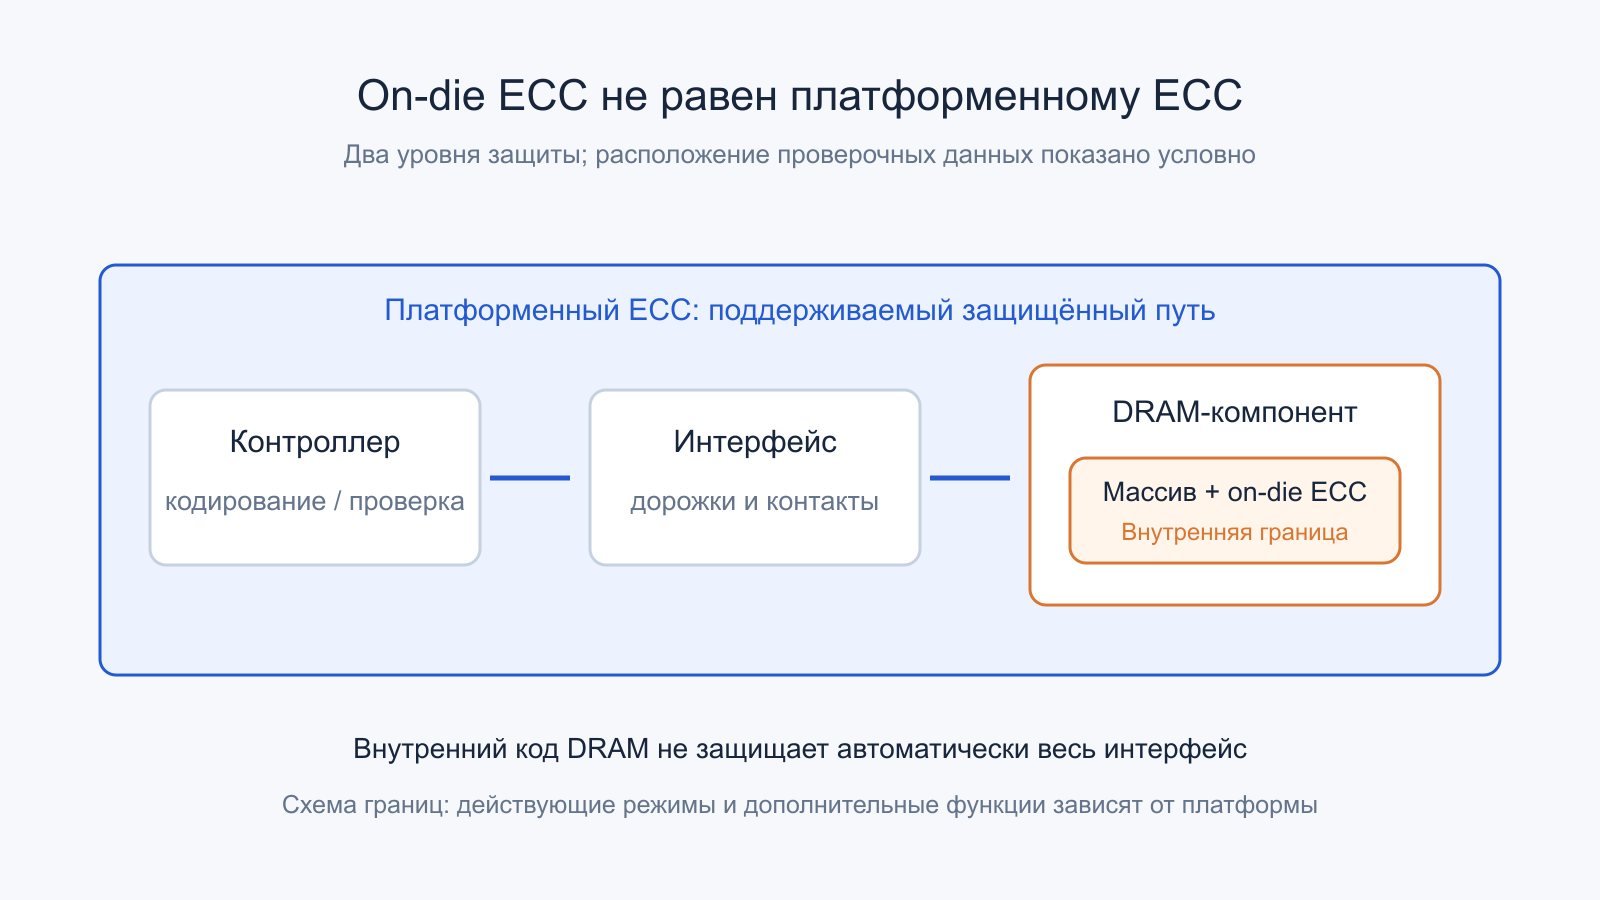
DDR5 имеет внутренний on-die ECC для массива DRAM. На странице Micron для DDR5 указан вариант 128 + 8 с исправлением одиночной ошибки. Проверочные биты этого механизма находятся внутри компонента и не превращают обычный модуль автоматически в платформенную ECC-память. Это защита определённого внутреннего участка, полезная при увеличении плотности DRAM.
После выхода данных из этого участка остаются выводы корпуса, дорожки платы, разъёмы, приёмник и контроллер. Внутренний код не становится общей защитой всего пути между процессором и DIMM. Для платформенного ECC нужна соответствующая архитектура передачи и проверки, поддержка процессора и платы, совместимые модули и активный режим. Конкретные дополнительные функции интерфейса рассматривают отдельно.
Registered, unbuffered, ранги и ECC описывают разные свойства. Буферизация управляющих сигналов не является синонимом коррекции данных, а два ранга не означают двойной уровень ECC. В технической характеристике нужно искать точное сочетание возможностей и совместимость. Физически устанавливаемый модуль не всегда работает в том же режиме, который обещан для другой платформы.
Защита может существовать и внутри процессора: для отдельных кэшей, внутренних структур и соединений. Однако обобщённая надпись «ECC поддерживается» не перечисляет их все. Поддержка, включение, действующий режим и доступная телеметрия — четыре разных пункта. Проверка одного пункта не заменяет остальные.
Коррекция, журналирование и очистка накопившихся ошибок
Исправленная ошибка означает, что конкретный механизм обнаружил событие и смог восстановить данные по своим правилам. Она не равна потере файла, но и не является доказательством идеального состояния аппаратуры. Важны повторяемость, адреса, каналы, условия и динамика. Один счётчик без контекста недостаточен для вывода о физической причине.
Система также должна донести событие до администратора. Документация Linux EDAC разделяет исправленные, неисправленные и другие классы событий; возможности отчётности зависят от драйвера и контроллера. Отсутствие записей в неподдерживаемой системе не доказывает отсутствие ошибок. Иногда счётчик просто недоступен на выбранном уровне наблюдения.
Scrubbing — предусмотренное чтение защищённых областей с проверкой и, при возможности, восстановлением. Если исправленное содержимое возвращается в хранение, это уменьшает время существования накопившегося повреждения. Иначе к первой скрытой ошибке со временем может добавиться вторая в том же слове. Конкретные режимы и интервалы определяет платформа; они расходуют ресурсы и не исправляют произвольный аппаратный отказ.
Даже одинаковые итоговые счётчики могут описывать разные ситуации. Условные десять событий за тысячу часов дают среднюю частоту 0,01 события в час; десять за последний час — частоту в тысячу раз выше при том же числе в счётчике. Это не универсальный порог замены. Для вывода нужны история, распределение по адресам и условия регистрации. Перезапуск или замена драйвера также могут изменить начало отсчёта доступной статистики.
Как работает CRC и почему полином имеет значение
CRC рассматривает последовательность битов как полином с коэффициентами ноль и один. Остаток деления по модулю два образует проверочное значение. В этой арифметике сложение выполняется через XOR без переноса. Аппаратная реализация хорошо подходит для потока данных, поэтому CRC широко применяется в каналах связи и форматах хранения.
Приёмник выполняет согласованную проверку. Несовпадение означает, что принятое содержимое не удовлетворяет выбранному правилу. Но совпадение оставляет возможность определённых необнаруживаемых комбинаций. Длина полинома, его коэффициенты, размер защищённого блока, порядок битов и настройки алгоритма важны одновременно. Два варианта с названием «CRC32» не обязательно дают одинаковое число для одного файла.
RFC 3385 подробно рассматривает зависимость результата от модели ошибок и длины блока. Это информационный документ 2002 года о выборе проверок для iSCSI; здесь он используется для математических принципов, а не как описание всех современных интерфейсов. Случайные независимые ошибки и пакетное повреждение нескольких соседних битов — разные модели. Один процент не характеризует обе сразу.
Учебный CRC: обнаружение и конкретный предел
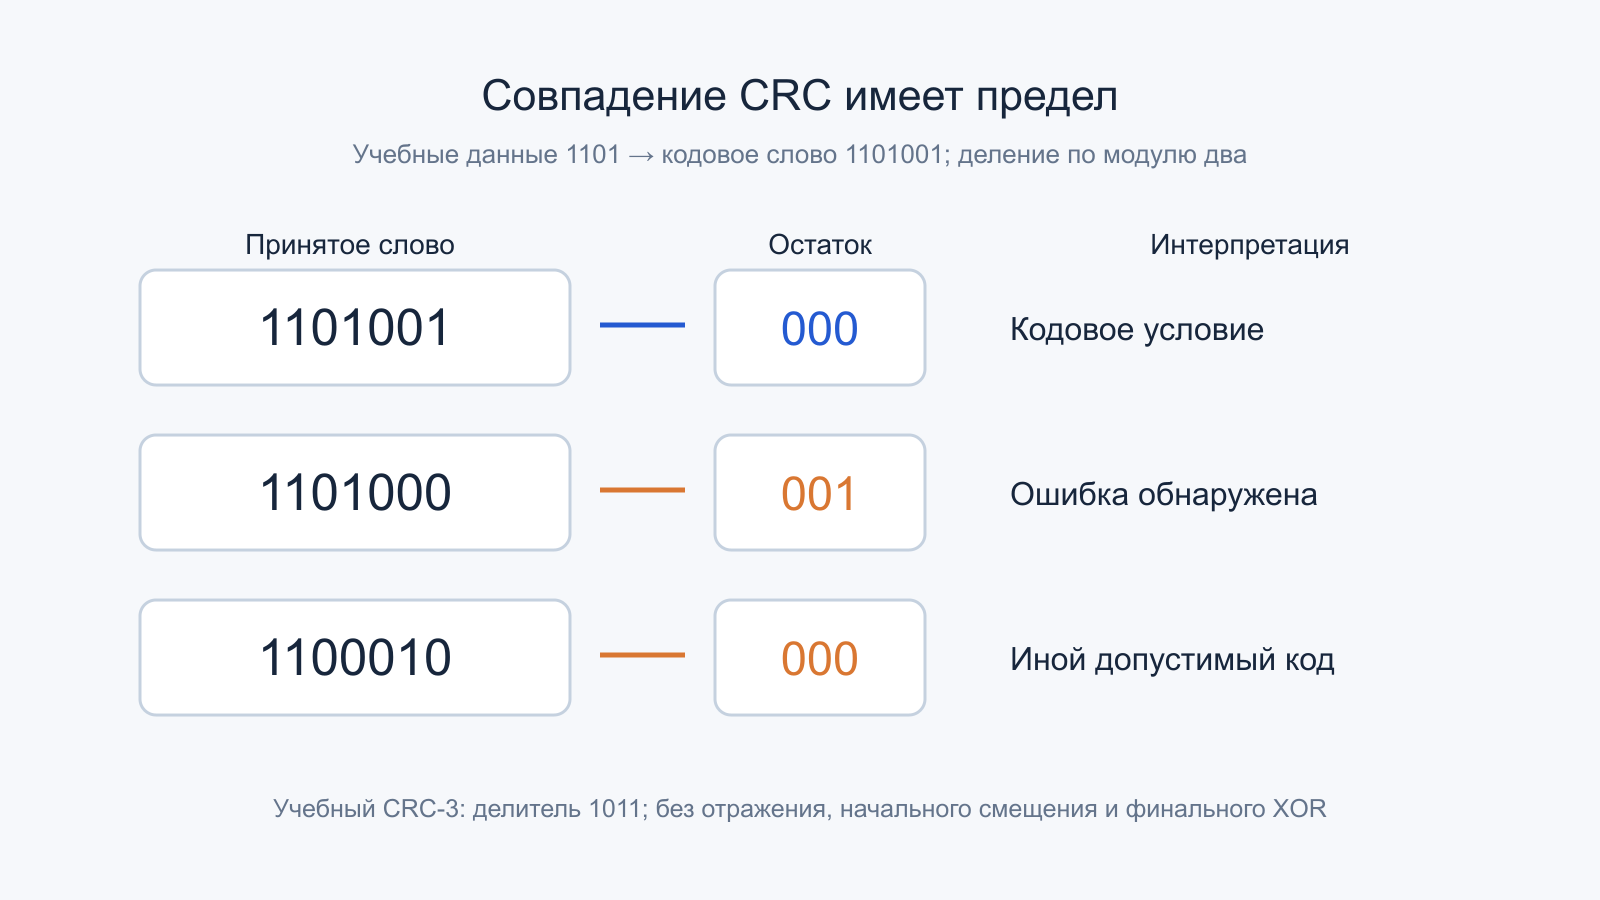
Возьмём специально маленький пример без отражения битов, начального смещения и финального XOR. Данные равны 1101, делитель — 1011, то есть полином третьей степени. Приписываем три нуля и делим 1101000 по модулю два. Остаток равен 001; передаваемое слово получается 1101001.
Проверочное деление этого слова даёт нулевой остаток. Если последний бит изменится и получится 1101000, остаток станет 001: повреждение обнаружено. Но другое слово 1100010 также делится на 1011 без остатка. Между ним и исходным словом лежит изменение 0001011, совпадающее с кратным делителю шаблоном.
Этот пример показывает существование необнаруживаемых комбинаций, а не недостаток конкретного коммерческого устройства. Реальные полиномы значительно длиннее, а их свойства подбирают под задачи протокола. Однако конечное проверочное поле не может однозначно обозначить все возможные длинные сообщения. Нулевой остаток означает выполнение кодового условия, а не математическое доказательство неизменности любых данных.
Число изменившихся битов и протяжённость пакета ошибок тоже различаются. В шаблоне 0001011 изменяются три бита, но участок от первого до последнего изменения занимает четыре позиции. Для оценки пакетных ошибок важно именно такое определение длины. Подмена длины пакета количеством единиц приводит к неверному прочтению свойств полинома.
Когда допустима оценка 2⁻³²
Для условной модели, где уже повреждённые блоки дают равномерно распределённые 32-битные проверочные значения, вероятность случайного совпадения оценивается как 1 / 2³² ≈ 2,33 × 10⁻¹⁰. Для миллиона таких повреждённых блоков математическое ожидание совпадений составляет примерно 0,000233. Это расчёт внутри допущения, а не измеренная надёжность диска.
Нельзя превращать это число в вероятность ежегодной потери файла: неизвестны частота повреждений, их структура, размер блоков и остальные части системы. Также нельзя обещать обнаружение каждой умышленной подмены. CRC не является криптографической защитой: атакующий, способный менять данные и проверочное значение, может пересчитать проверку. Для аутентичности нужны соответствующие криптографические механизмы и доверенный источник ключей или эталона.
Почему несколько проверок не образуют одну непрерывную границу
Канал может проверить пакет, передать полезную нагрузку в буфер и закончить свою ответственность. Позднее накопитель создаст собственный код для записи. Между этими событиями существует участок, где действует другая защита или её нет. Поэтому исправный CRC интерфейса не заменяет ECC оперативной памяти, а ECC NAND не является проверкой всего пути от приложения.
Особенно показателен неверный адрес. Данные и их проверка могут доехать без изменения, но оказаться записанными не туда, если конкретная схема не связывает проверку с адресом или контекстом. Аналогично можно получить старую, но внутренне корректную версию блока. Защита от изменения битов, перепутанного назначения и потери свежести требует разных свойств.
Сквозная проверка на уровне файла или приложения переносит границу ближе к тому объекту, который нужен пользователю. Но ей также необходимы достоверный эталон и правильная точка вычисления. Хеш, рассчитанный уже после повреждения исходного файла, закрепит повреждённое состояние. Совпадение копии с таким эталоном честно подтвердит равенство двух неправильных экземпляров.
Можно отдельно оценить цену хранения проверок. В учебной схеме по одной 32-битной сумме на каждый блок 4 КиБ приходится четыре служебных байта на 4096 полезных: около 0,0977%. Для 1 ТиБ данных получается 268 435 456 блоков и ровно 1 ГиБ самих сумм. Индексы, размещение, резервные копии и вычислительные затраты сюда не включены. Небольшой объём избыточности не отменяет необходимости правильно организовать её хранение и проверку.
SMART описывает состояние, а не подтверждает каждый байт
SMART появился как механизм наблюдения и оценки состояния накопителей. Атрибуты, пороги и внутренние правила зависят от семейства устройства. Seagate отдельно предупреждает, что интерпретации отдельных SATA-атрибутов сторонними программами могут расходиться с фирменной логикой. Нормализованное значение, сырое поле и вычисленный приложением процент нельзя читать как взаимозаменяемые величины.
В NVMe существует стандартизованный журнал SMART/Health Information, но конкретное заполнение и дополнительные поля всё равно требуют документации. Например, руководство Seagate Nytro 4350, редакция A ноября 2023 года, отдельно описывает Critical Warning, Available Spare и Percentage Used. Это разные характеристики: предупреждение, резерв и оценка использования ресурса. Они не складываются в простую универсальную шкалу здоровья.
Процент использованного ресурса не является вероятностью отказа завтра. Он связан с принятой изготовителем моделью износа. Небольшое значение не исключает внезапной неисправности электроники, а достижение расчётного ресурса не задаёт точную секунду прекращения работы. Температура, сообщения об ошибках и изменение счётчиков нужны для понимания состояния, но не дают гарантий на будущее.
Статус PASS означает, что выбранный набор условий не вызвал отрицательный итог в момент запроса. Он не означает последовательного чтения всех пользовательских файлов и сравнения с правильными оригиналами. Предупреждение требует внимания, но точное время будущего отказа по нему не вычисляется. Даже благополучная телеметрия не заменяет независимую копию нужных данных.
Важно также различать ошибку носителя и ошибку передачи. Проверка интерфейса относится к принятому пакету; внутренняя коррекция носителя — к своему хранимому представлению. Поэтому увеличение счётчика с названием CRC не является прямым доказательством разрушения NAND или магнитной поверхности. Название поля необходимо связать с его определением, интерфейсом и конкретной моделью. Одно похожее слово в двух программах не гарантирует одинакового смысла.
Успешная повторная попытка чтения может скрыть задержку от приложения и обеспечить правильный результат, но не обязательно убрать факт события из накопленного журнала. И наоборот, программная ошибка файловой системы может возникнуть без зарегистрированной аппаратной ошибки носителя. Слои наблюдают разные условия. Для интерпретации полезно сопоставлять момент события, команду, состояние интерфейса и сообщение верхнего уровня, сохраняя границу вывода, а не превращая любую запись в приговор всему диску.
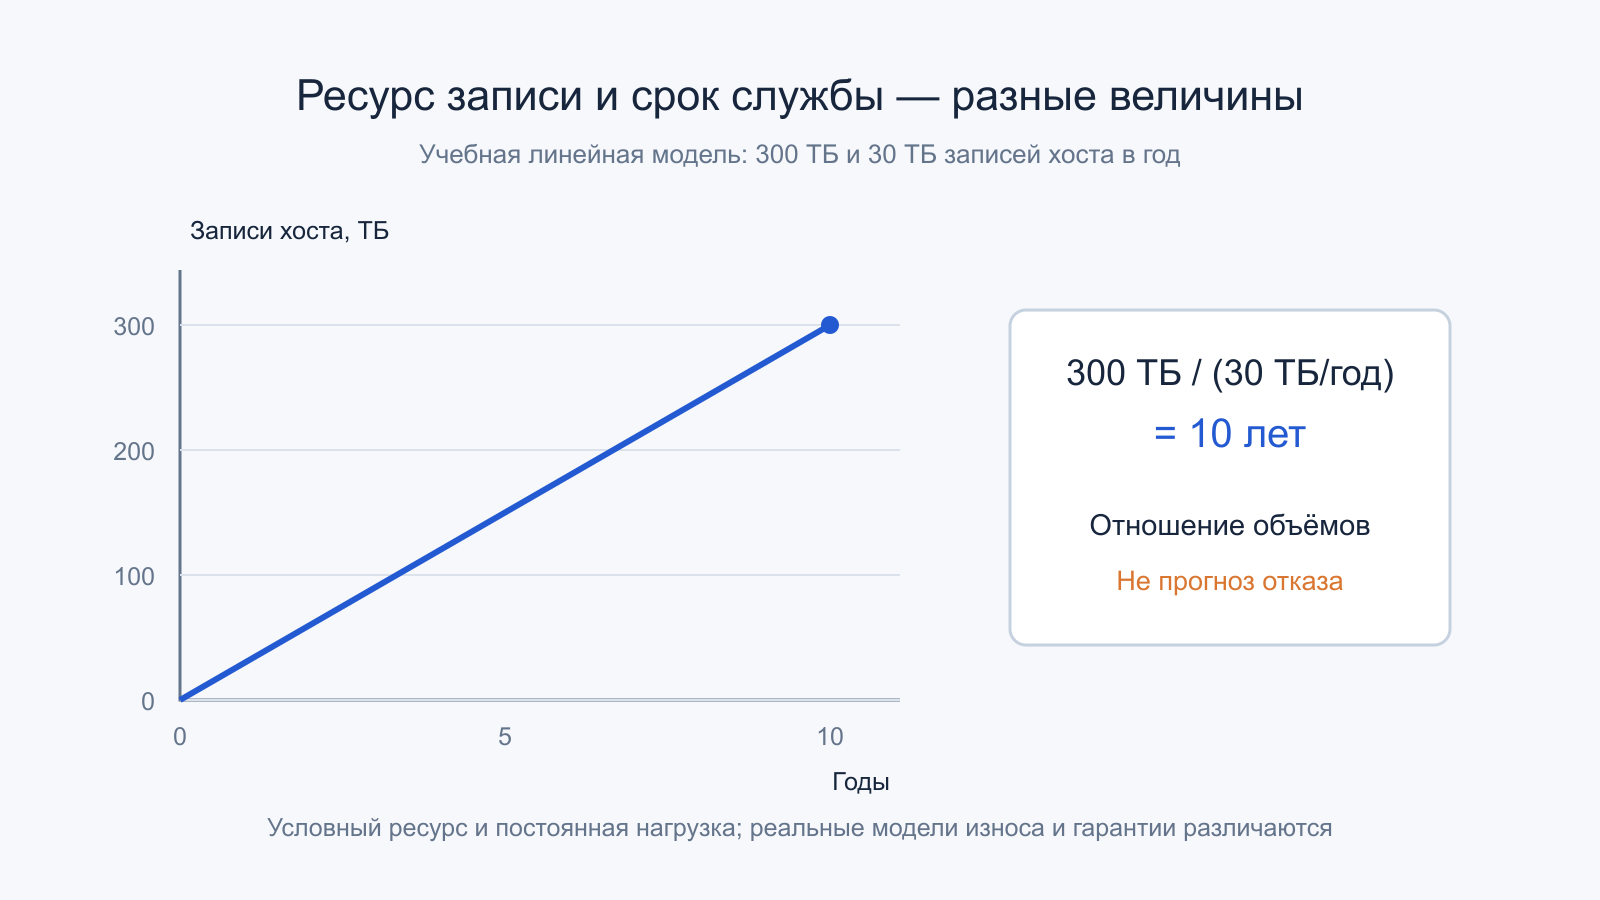
Учебный расчёт ресурса без предсказания срока службы
Предположим условный накопитель с заявленным ресурсным показателем 300 ТБ записей и наблюдаемыми записями хоста 30 ТБ в год. Простое деление даёт десять лет до достижения этого объёма при неизменной нагрузке. Это только отношение двух величин. Оно не учитывает правила конкретной гарантии и не является обещанием десятилетней исправности.
Записи хоста также не равны автоматически физическим записям NAND. Внутренняя сборка мусора, перемещение страниц и другие операции меняют объём работы носителя. Коэффициент усиления записи относится к определённым счётчикам и нагрузке. Смешение хостового объёма, внутренних стираний и процента износа создаёт красивый, но неверный прогноз.
Обнаружить повреждение и восстановить данные — разные возможности
Контрольная сумма способна показать несовпадение, но для восстановления нужна дополнительная информация: корректирующая избыточность, другая пригодная копия или резервная версия. Файловая система с проверкой без избыточного хранения может сообщить ошибку вместо повреждённого содержимого. Это полезнее незаметной выдачи неправильных данных, но исходный файл само по себе не возвращает.
Документация Microsoft ReFS показывает конкретный пример границ. Метаданные проверяются контрольными суммами, а Integrity Streams для данных файлов является отдельной возможностью. При подходящем отказоустойчивом Storage Spaces система пытается использовать избыточность для исправления. На одиночном носителе без нужного резерва обнаружение не создаёт отсутствующий правильный экземпляр.
Фоновый scrub также проверяет только то, что охвачено соответствующей функцией. Само название файловой системы не означает, что все файлы включены в проверку. Из этой документации нельзя вывести одинаковое поведение любой клиентской ОС или любого массива. Важны редакция, настройки, тип хранения и реально действующий режим.
RAID сохраняет доступность при части отказов, но не историю
Зеркало может позволить продолжить работу после потери одного устройства, если оставшийся экземпляр доступен и пригоден. Но правильная команда удаления удалит файл на логическом томе независимо от количества дисков. Повреждённое приложением содержимое также может честно попасть во все копии. Для контроллера массива это может быть полностью корректная запись.
Резервная копия решает другую задачу: предоставляет отдельную версию для восстановления. Её ценность зависит от независимости, доступности, сохранённых ключей и проверенной процедуры возврата. Копия, которую никто не пробовал прочитать, остаётся предположением. ECC, контрольные суммы и RAID уменьшают отдельные риски, но не заменяют выбор нужной версии файла.
Как читать систему защиты целиком
Представим условную рабочую станцию: платформенный ECC активен, накопитель сообщает PASS, файл хранится на зеркале. В приложении возникает ошибка и сохраняется неверный результат расчёта. Все три аппаратных признака могут остаться нормальными. Если нужна предыдущая версия, решающей станет версия резервной копии или история документа, а не отсутствие исправленных ошибок памяти.
Другой сценарий: один бит изменился в защищённом слове RAM и был исправлен до передачи приложению. Файл может остаться правильным, хотя журнал зарегистрирует событие. Третий: при чтении файла контрольная сумма не совпала, а пригодной копии нет. Здесь обнаружение произошло, но автоматическое восстановление невозможно. Одинаковое слово «ошибка» скрывает три разных результата.
Оценивать систему полезно по цепочке доказательств: где возникло наблюдение, какой участок проверялся, что именно исправлено и есть ли независимый источник восстановления. Эта логика помогает читать спецификации без ложной уверенности от одного процента или одной аббревиатуры. Чем конкретнее граница защиты, тем понятнее её реальная польза.
Вопросы к характеристикам и журналам
- Какой код и размер кодового слова используются; какие ошибки он исправляет и обнаруживает?
- Речь о внутреннем on-die ECC или об активной защите платформенного пути памяти?
- Доступна ли отчётность исправленных и неисправленных событий на этой системе?
- Что включает контрольная сумма: данные, адрес, версию или только отдельный блок?
- Как производитель определяет поля ресурса и предупреждения конкретного накопителя?
- Чем подтверждается возможность восстановления: избыточностью, пригодной копией или проверенной резервной версией?
- Не подменяет ли зелёный статус устройства проверку содержимого нужных файлов?
Первичные источники
- Synopsys — Error Correction Code in DDR Memories: типы и границы ECC подсистем памяти.
- Micron — DDR5 DRAM: внутренний on-die ECC и характеристики DDR5.
- Linux Kernel — Error Detection And Correction Devices: режимы, классы событий и scrub.
- RFC 3385, 2002 — CRC/Checksum Considerations: полиномы, длина блока и модели ошибок.
- Seagate — Interpretation of SMART diagnostic results: ограничения трактовки SATA SMART.
- Seagate Nytro 4350 Product Manual, Rev A, ноябрь 2023: конкретный пример полей NVMe SMART/Health.
- Microsoft Learn — ReFS integrity streams: проверка данных и восстановление с подходящей избыточностью.
Комментарии