NVMe ZNS и FDP: как управление размещением меняет работу SSD
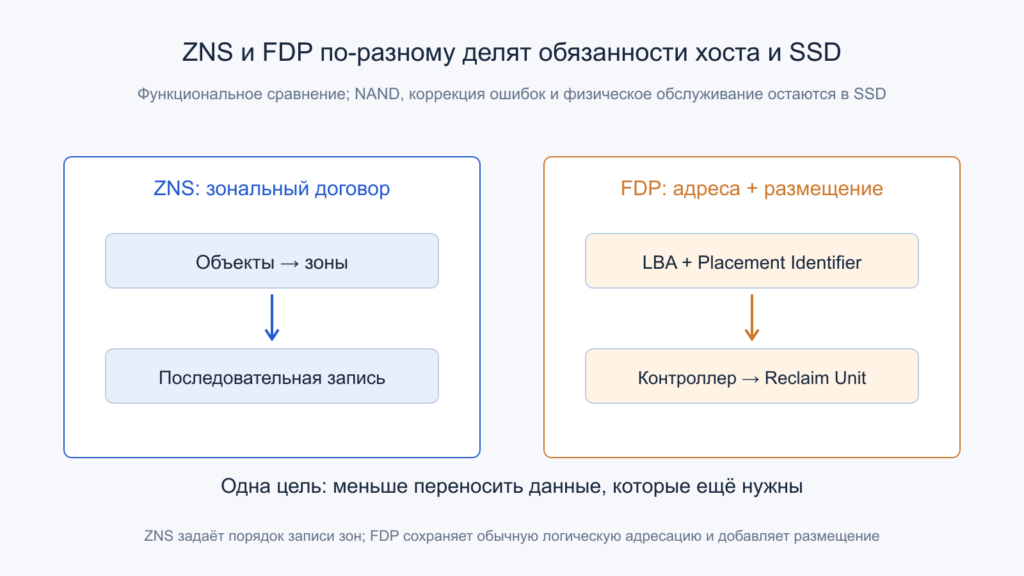
Модели имеют общую цель уменьшения переноса живых данных, но различный договор между приложением и устройством. Открыть иллюстрацию в полном размере.
Обычный SSD получает логические адреса, но почти ничего не знает о смысле записанных данных. Контроллеру неизвестно, что один файл будет удалён через минуту, а соседний останется на месяцы. Когда они оказываются в одной физической области, освобождение места требует переносить ещё живые данные. ZNS и Flexible Data Placement решают эту проблему разными способами: меняют договор между программой и накопителем о размещении и повторном использовании памяти.
Разберём эти механизмы глубже обычного сравнения скоростей NVMe. Публичные документы проверены на 26 октября 2026 года. Все числа ниже относятся к учебным моделям; измерений оборудования владельца сайта здесь нет. Рассматривается архитектура, без команд форматирования, сброса зон или изменения конфигурации рабочего накопителя.
Содержание статьи
- Зачем накопителю понимать время жизни данных
- WAF нужно считать на явно выбранной границе
- ZNS меняет правила записи логического пространства
- Размер зоны и её полезная ёмкость могут различаться
- Состояния зон описывают ресурс, а не только заполнение
- Zone Append решает проблему порядка команд
- Хост управляет освобождением, но не становится контроллером NAND
- Журнал и LSM-таблицы подходят не автоматически
- FDP сохраняет обычную адресацию и добавляет размещение
- RU, RG и RUH не являются тремя именами одной зоны
- Placement Identifier выбирает путь размещения, а не адрес чтения
- Первоначальная изоляция отличается от постоянной
- Число направлений нужно согласовать с гранулярностью освобождения
- Почему разделение горячих и холодных данных снижает перенос
- Обратная связь полезна, пока сама не перегружает путь
- Долговечность не выводится из одного уменьшенного WAF
- Размещение не заменяет устойчивость при отключении питания
- Готовность экосистемы проверяется по конкретному пути
- Официальные первичные источники
- Читайте также
Зачем накопителю понимать время жизни данных
Физическую страницу NAND нельзя произвольно перезаписать тем же способом, каким программа обновляет логический блок. Новая версия обычно размещается в другом месте, а прежняя становится неактуальной. Для повторного использования группы страниц приходится стереть соответствующие физические блоки. Если внутри остаются необходимые данные, их сначала нужно перенести. Этот обмен не был отдельной полезной записью приложения.
Размещение короткоживущих и долгоживущих объектов вместе способно многократно повторять такой перенос. Быстро меняющийся журнал освобождает свои страницы, но несколько постоянных объектов удерживают область от полного освобождения. Если похожие по сроку удаления данные находятся рядом, больше областей может стать полностью неактуальными без сохранения многочисленных соседей. Программа часто знает об этом больше контроллера.
Это знание не всегда точно. Файл, который планировали хранить недолго, может неожиданно стать постоянным; большой объект может удаляться по частям. Поэтому полезный механизм должен учитывать наблюдаемое поведение и обратную связь. Простое разделение по расширению файла не гарантирует хорошего размещения. Существенны моменты обновления, удаления и действительная организация записи во всём программном пути.
WAF нужно считать на явно выбранной границе
Write Amplification Factor сравнивает объём записи на носитель с объёмом записи, принятым от хоста, при оговорённом способе учёта. В презентации NVM Express о FDP это отношение используется для объяснения затрат внутреннего переноса. Если хост передал 100 ГБ, а учтённая запись NAND составила 250 ГБ, WAF равен 2,5.
У приложения может существовать дополнительное усиление ещё до устройства. Например, база принимает 1 ТБ полезных изменений, а журналирование и слияние таблиц превращают их в 3 ТБ команд записи хоста. При внутреннем коэффициенте SSD 1,1 на выбранной границе получается 3,3 ТБ. Уменьшение только внутреннего WAF не устраняет работу базы и файловой системы.
Следует заранее определить, включаются ли служебные данные, коррекция, уплотнение и фоновые операции в конкретный счётчик. Два производителя могут раскрывать разные показатели. Делить произвольные числа из разных источников нельзя. Содержательный отчёт сохраняет исходное состояние, интервал, логическую нагрузку и определение обоих объёмов; иначе красивый коэффициент не объясняет реальную экономию.
ZNS меняет правила записи логического пространства
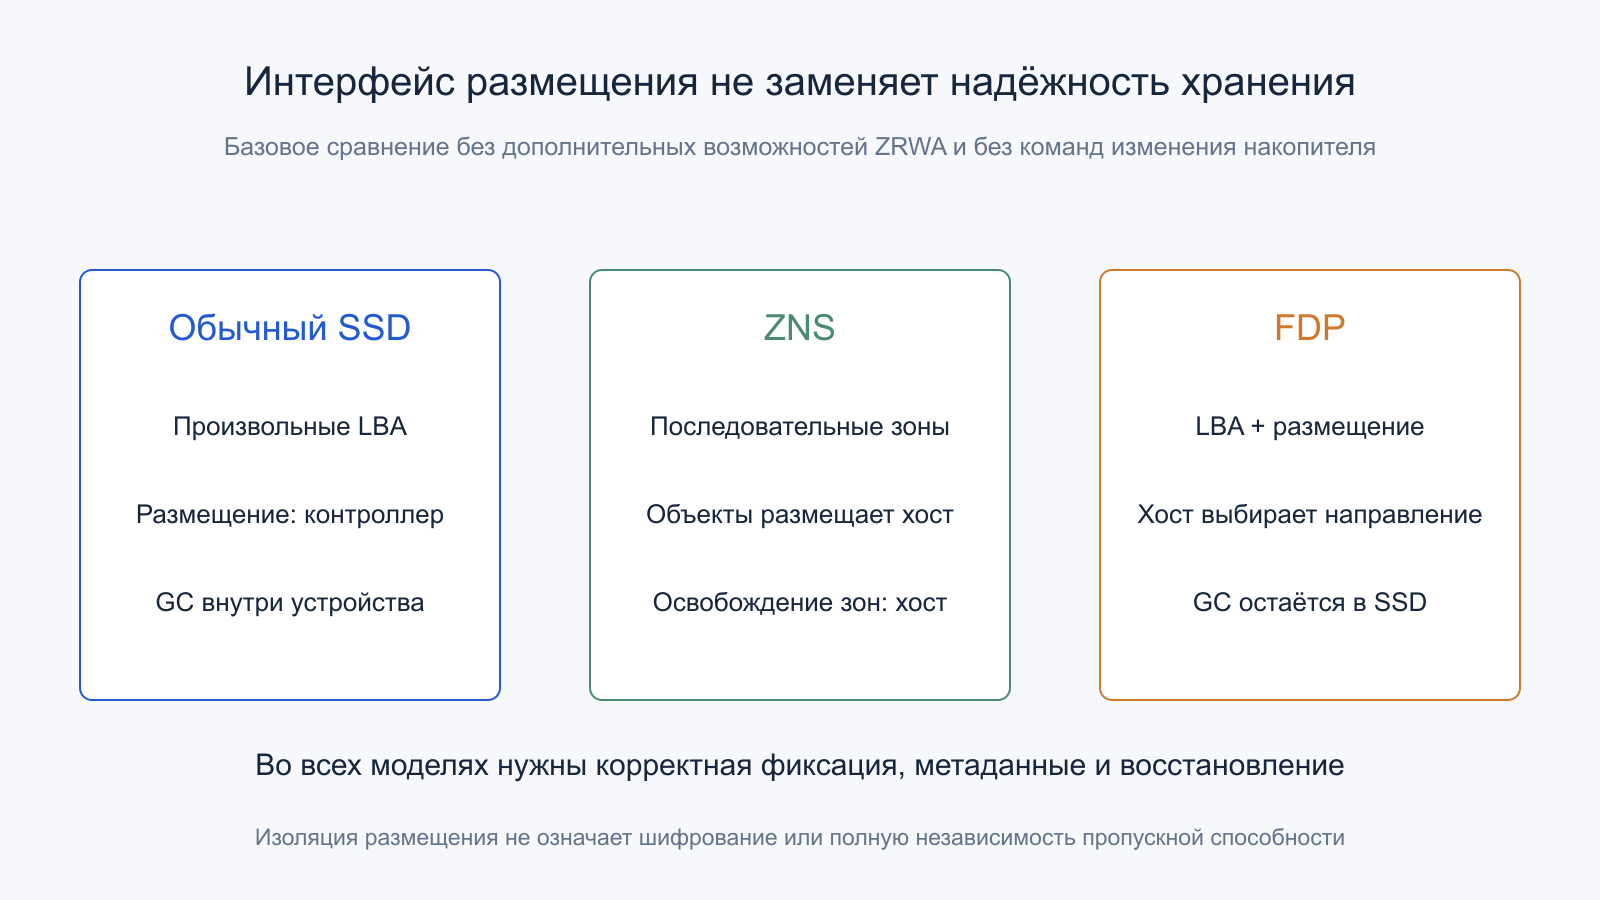
Zoned Namespace разделяет пространство адресов на зоны. В базовом последовательном режиме каждая зона имеет указатель записи, write pointer. Обычная запись должна соответствовать допустимому положению этого указателя; повторное обновление уже занятого адреса тем же способом не разрешается. Чтение остаётся произвольным по доступным адресам. Это изменение интерфейсного контракта, а не скрытая оптимизация контроллера.
Описание Zoned Storage отдельно подчёркивает: зоны ZNS имеют тип sequential-write-required. Возможность обычных зон в других стандартах зональных накопителей не следует переносить сюда автоматически. Контроллер может предоставлять отдельное пространство имён с обычным набором команд, но это не делает саму последовательную зону произвольно перезаписываемой.
У актуальных семейств спецификаций существуют дополнительные возможности, включая ограниченную область случайной записи ZRWA при соответствующей поддержке. Она имеет собственные правила и ресурсы; её нельзя подразумевать для каждого SSD. Далее рассматривается базовая модель без ZRWA. Программа должна точно знать выбранный режим, а не рассчитывать, что устройство молча исправит нарушение порядка.
Размер зоны и её полезная ёмкость могут различаться
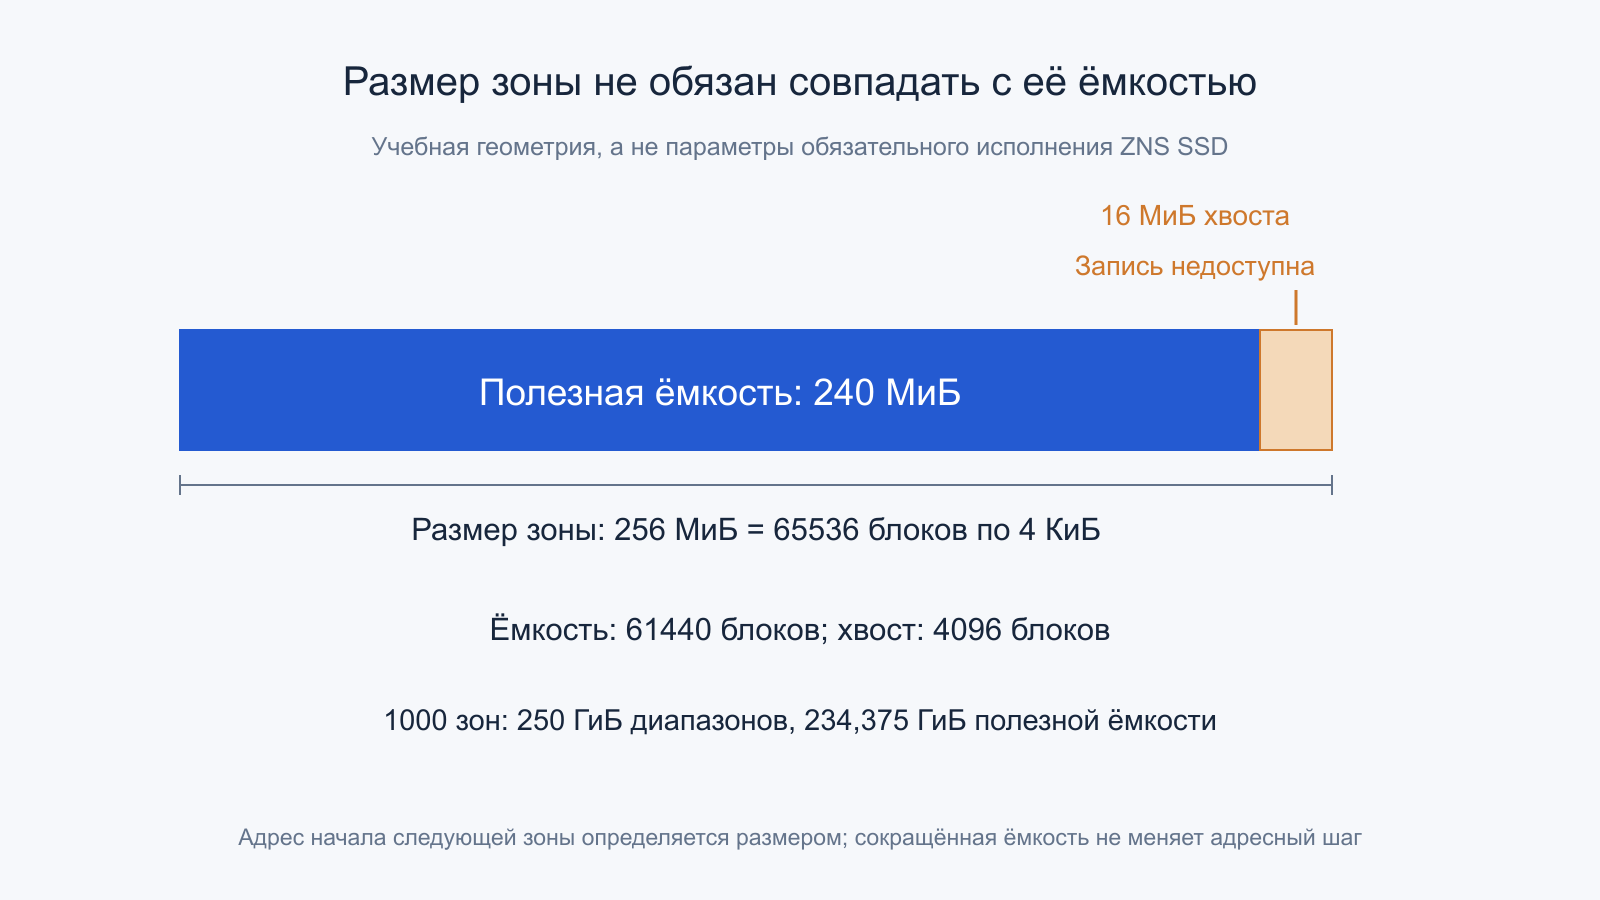
Zone size описывает адресный шаг между зонами и число логических блоков в соответствующем диапазоне. Zone capacity определяет, сколько блоков внутри него доступно для записи. Полезная ёмкость не обязана равняться размеру. Такое различие позволяет сохранить удобную геометрию адресов, согласовав доступный объём с реальной организацией носителя. Хвост диапазона нельзя считать дополнительным резервом пользовательской записи.
В учебной конфигурации размер зоны равен 256 МиБ, ёмкость —240 МиБ, логический блок —4 КиБ. Тогда размер содержит 65536 блоков, полезная часть —61440, а оставшиеся 4096 блоков соответствуют 16 МиБ недоступного для записи хвоста. Следующая зона начинается по адресу, определяемому полным размером, а не сокращённой ёмкостью.
Для 1000 одинаковых зон сумма адресных диапазонов равна 250 ГиБ, а сумма полезных ёмкостей —234,375 ГиБ. Это только выбранный пример. В реальной системе читают характеристики зон и пространства имён. Подстановка общего количества адресов вместо суммы доступных ёмкостей способна завысить место, которое приложение действительно сможет использовать.
Состояния зон описывают ресурс, а не только заполнение
Пустая зона, открытая зона, закрытая зона и полная зона различаются состоянием и занятыми ресурсами контроллера. Открытие может быть явным или возникнуть при первой допустимой записи. Закрытие не означает удаления содержимого и не возвращает указатель в начало. Полная зона перестаёт принимать обычное последовательное продолжение до предусмотренного повторного использования.
Нужно отдельно учитывать предел открытых и предел активных зон. К активным относятся также закрытые зоны с незавершённым жизненным циклом. Поэтому закрыть много зон недостаточно, чтобы обязательно освободить весь лимит активности. В учебном устройстве с максимумом 8 открытых и 16 активных зон состояние «8 открытых плюс 8 закрытых активных» уже расходует все 16.
Попытка начать ещё один независимый поток должна учитывать эти ограничения заранее. Завершение зоны может оставить неиспользованную ёмкость, а её сброс связан с утратой доступности прежнего содержимого. Это не бесплатные способы увеличить количество очередей. Планировщик приложения должен управлять жизненным циклом, сохраняя данные и достаточный запас зон для следующей работы.
Zone Append решает проблему порядка команд
NVMe допускает несколько очередей и переупорядочение выполнения. Даже если программа вычислила последовательные адреса двух записей, устройство может обработать их в другом порядке. Для обычных последовательных записей это создаёт конфликт с write pointer. Простая сериализация одной незавершённой команды на зону уменьшает свободу параллельного обслуживания.
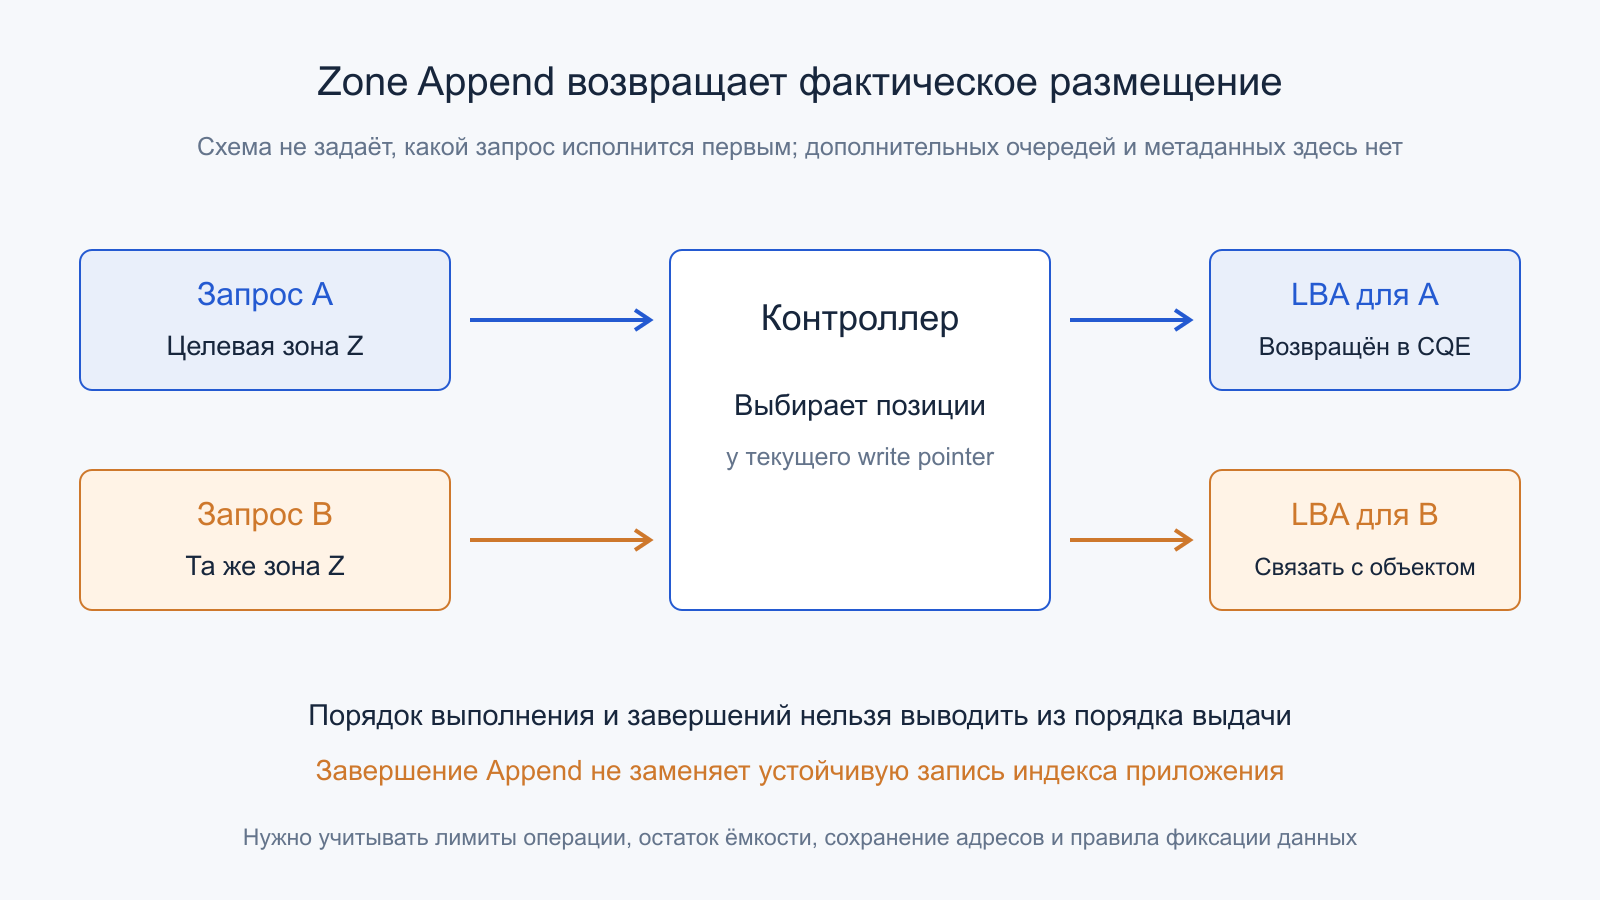
Zone Append позволяет указать целевую зону, поручив устройству выбрать её текущее допустимое положение записи. Завершение возвращает фактически использованный начальный LBA. Поэтому приложение узнаёт размещение после выполнения и должно сохранить эту связь со своим объектом. Порядок поступления завершений также не обязан совпадать с порядком выдачи запросов. Об этом механизме отдельно говорит спецификация ZNS 1.1e.
Append не отменяет пределы размера операции, зоны и оставшейся ёмкости. Он не предоставляет произвольный выбор адреса внутри уже записанной части. И главное, возвращённое размещение нужно включить в согласованную систему метаданных. Успешная доставка блока без надёжной записи соответствующего индекса ещё не гарантирует восстановление объекта после сбоя.
Хост управляет освобождением, но не становится контроллером NAND
Для повторного использования зоны приложение должно знать, что её прежние данные больше не нужны либо перенесены и правильно отражены в метаданных. Это переносит часть организации хранения на хост. Логическая зона при этом не является обязательным прямым отображением на один конкретный физический erase block. Между интерфейсом и ячейками остаётся реализация накопителя.
Коррекция ошибок, плохие блоки, физическое обслуживание и надёжность носителя сохраняются в ответственности SSD. Поэтому ZNS нельзя описывать как обязательную передачу приложению всех сырых адресов NAND. Полезная граница другая: программа управляет размещением объектов по зонам и моментом освобождения крупной области, а устройство обеспечивает физическое исполнение согласованных операций.
Хост также может сам создать дорогой перенос, если смешал в одной зоне объекты с разными сроками жизни. Последовательная запись не доказывает отсутствие усиления во всей системе. Иногда уменьшается скрытая работа SSD, но возрастает видимая работа приложения. Оценивать нужно суммарную запись и задержку законченного сценария, включая восстановление и обслуживание свободного пространства.
Журнал и LSM-таблицы подходят не автоматически
Log-structured организация естественно добавляет новые версии в конец, но этого ещё недостаточно. Система должна согласовать удаление объектов, повторное использование зон и устойчивые метаданные. Большие неизменяемые таблицы удобны, когда срок жизни соседних файлов близок. При сильном различии остаются частично занятые зоны, даже если каждый файл был записан строго последовательно.
ZenFS для RocksDB использует свойства LSM-таблиц и подсказки времени жизни для размещения файлов по зонам. Один файл может иметь несколько участков, а одна зона — несколько файлов. Это пример адаптированного программного пути, а не обещание, что установка ZNS-накопителя автоматически ускорит любую базу с обычной файловой системой.
zonefs в документации Linux представляет последовательные зоны файлами и сохраняет их ограничения для приложения. Она намеренно не скрывает последовательную модель за полной иллюзией произвольного POSIX-хранилища. Выбор такого слоя меняет обязанности разработчика. Нужны понятные точки фиксации, обработка ошибок и стратегия работы при исчерпании доступных ресурсов.
FDP сохраняет обычную адресацию и добавляет размещение
Flexible Data Placement предлагает другой компромисс. Команда по-прежнему обращается к логическим блокам обычного пространства имён; последовательный write pointer зоны не становится обязательным правилом каждой записи. Хост дополнительно передаёт сведения о желаемом размещении. Контроллер продолжает управлять логическим отображением, физической записью и сборкой мусора.
Смысл — сгруппировать данные так, чтобы физические области становились ненужными согласованно. Обновление LBA не требует от приложения самостоятельно искать новый свободный логический адрес, как при организации журнала поверх ZNS. Но отсутствие такого ограничения не означает бесплатной оптимальности. Программа должна выбрать полезные группы, а накопитель — поддерживать и использовать соответствующий механизм.
Сравнение именно этих моделей включено в материал рабочей группы SNIA, опубликованный 26 февраля 2026 года. FDP и ZNS развиваются как разные способы сотрудничества хоста и SSD. Назвать FDP «ZNS без зон» недостаточно: различаются адресный контракт, управление освобождением и доступная обратная связь.
RU, RG и RUH не являются тремя именами одной зоны
Reclaim Unit, RU, описывает группу энергонезависимой памяти, которую контроллер может физически освобождать независимо от других RU. Reclaim Group, RG, объединяет такие единицы. Это упрощённая видимость организации носителя, а не список точных координат всех ячеек. Размер и конфигурацию следует получать от устройства, не задавая универсальную величину в гигабайтах.
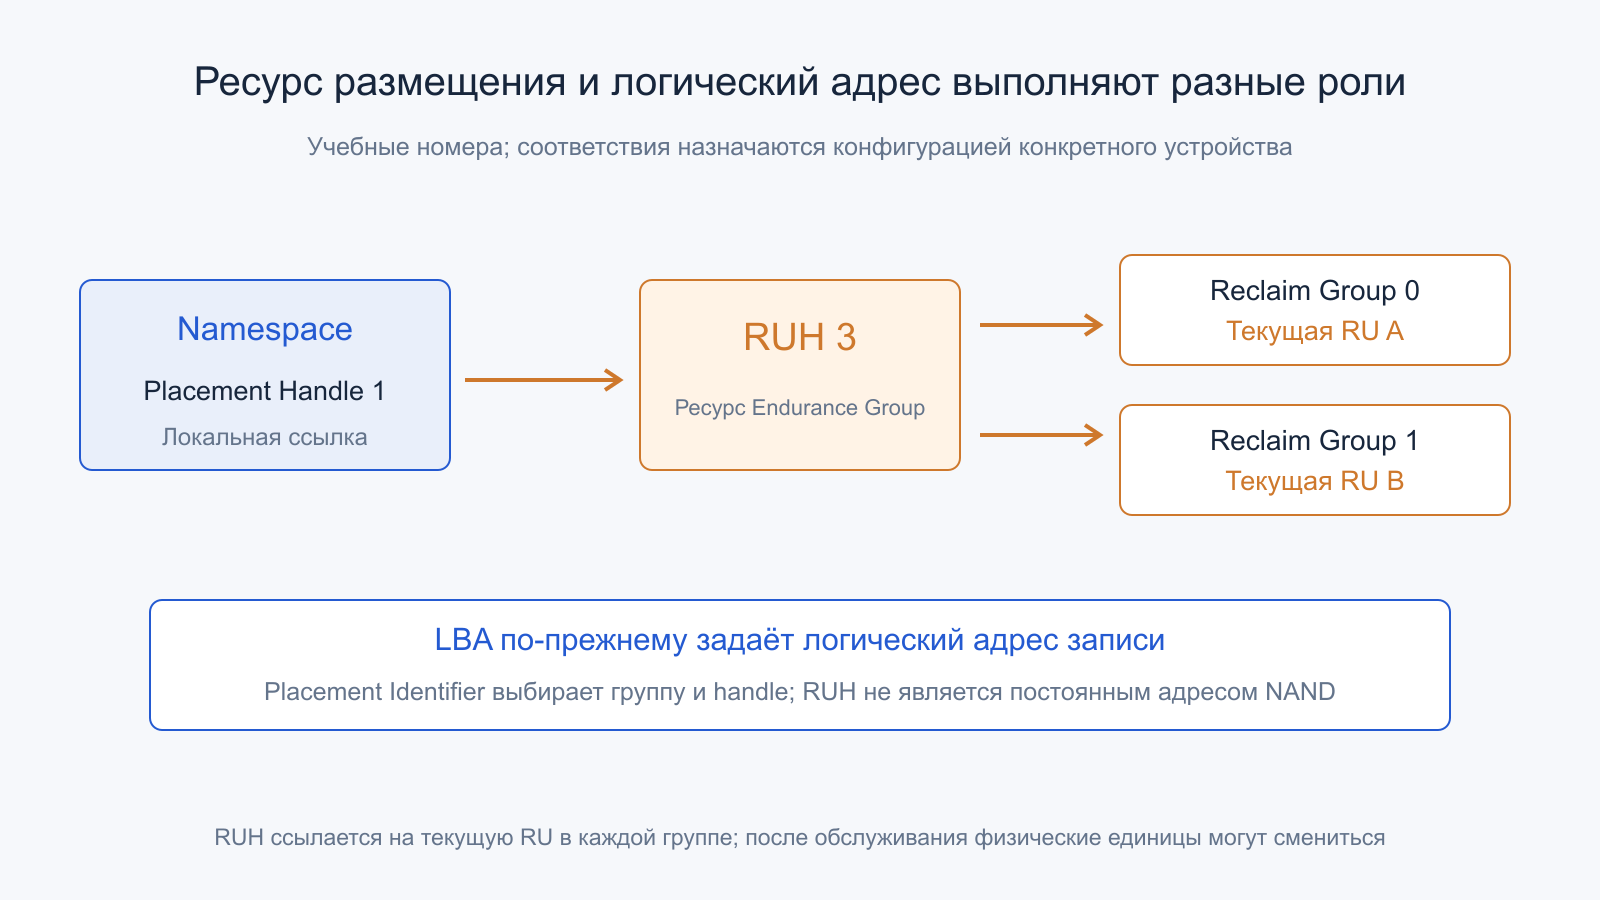
Reclaim Unit Handle, RUH, представляет ресурс, который ссылается на текущую RU в каждой соответствующей группе. Он позволяет поддерживать несколько направлений размещения одновременно. После заполнения и дальнейшего обслуживания набор используемых физических единиц меняется. Поэтому постоянное число handle не является вечным физическим адресом содержимого или именем одной неизменной области NAND.
Документация xNVMe разделяет эти сущности и их области действия. В частности, namespace получает доступ к определённым ресурсам группы выносливости. Такое разделение нужно для правильной реализации, но приложение всё равно должно опираться на логический адрес объекта. По одному RUH нельзя впоследствии прочитать все его старые данные без обычной адресации.
Placement Identifier выбирает путь размещения, а не адрес чтения
Placement Handle относится к пространству имён и выбирает доступный ему Reclaim Unit Handle. Placement Identifier включает сведения о группе и соответствующем handle в установленном формате. Поля не следует путать с LBA: команда по-прежнему содержит логическое место назначения, а идентификатор добавляет организацию его физического размещения.
У двух пространств имён одинаковое численное значение локального handle не обязано означать один ресурс. Обратная ситуация тоже возможна: им могут предоставить общий RUH, и тогда данные разных namespaces способны попадать в связанные единицы. Следовательно, разделение пространства адресов и разделение физического размещения нужно проверять по конфигурации, а не выводить друг из друга.
В первичном техническом обзоре FDP эти связи описаны отдельно от логической адресации. Такая модель помогает понять совместимость: приложение, которое не использует специальные сведения, сохраняет обычные операции, но не получает автоматически осмысленного разделения своих данных. Польза возникает там, где знания о нагрузке доходят до накопителя.
Первоначальная изоляция отличается от постоянной
FDP различает ресурсы с первоначальным и постоянным разделением данных. В первом случае выбранное размещение обеспечивается при записи, но последующая внутренняя сборка мусора может изменить соседство. Во втором предусмотрено сохранение соответствующей изоляции на протяжении жизни данных. Нельзя прочитать поддержку FDP и автоматически предположить более сильный вариант.
Эту разницу рассматривает технический разбор Samsung. Для приложения важно, какая гарантия действительно нужна и какие ресурсы она занимает. Большее число одновременно обслуживаемых направлений способно требовать больше буферов и усложнять использование параллелизма NAND. Самое подробное разделение не обязано давать максимальную полосу каждому потоку.
Изоляция размещения также не является криптографической защитой или полной изоляцией производительности. Потоки способны делить контроллер, питание, интерфейс и другие аппаратные ресурсы. Для многопользовательской системы права доступа, очистка данных и ограничения обслуживания задаются отдельными механизмами. Обещание «сосед никогда не повлияет» из одного термина RUH не следует.
Число направлений нужно согласовать с гранулярностью освобождения
Политика «отдельное направление каждому объекту» выглядит привлекательной, пока не учтены ограниченные ресурсы. Маленький файл может занять небольшую долю крупной области, оставив остальное место неудобным для совместного использования. Миллионы объектов не означают миллионы доступных аппаратных handles. Приложению приходится объединять их в классы, сохраняя достаточно похожее поведение внутри каждого класса.
Учебная система имеет 64 направления, для которых одновременно удерживается по 1 ГиБ частично используемого пространства. Если средняя полезная доля составляет 25%, в них лежат 16 ГиБ актуальных данных при 64 ГиБ занятого ресурса выбранной модели. Остальные 48 ГиБ нельзя автоматически объявить ни потерянными навсегда, ни немедленно доступными любому потоку: результат определяется правилами размещения, продолжения записи и освобождения.
Укрупнение классов уменьшает раздробленность, но повышает риск смешать объекты с разным сроком жизни. Дробление улучшает семантическое разделение, однако усложняет балансировку и требует больше ресурсов. Это инженерный компромисс. Для него полезно оценивать размер объектов, распределение сроков удаления, число одновременно активных писателей и реальный запас свободного пространства при установившейся нагрузке.
Почему разделение горячих и холодных данных снижает перенос
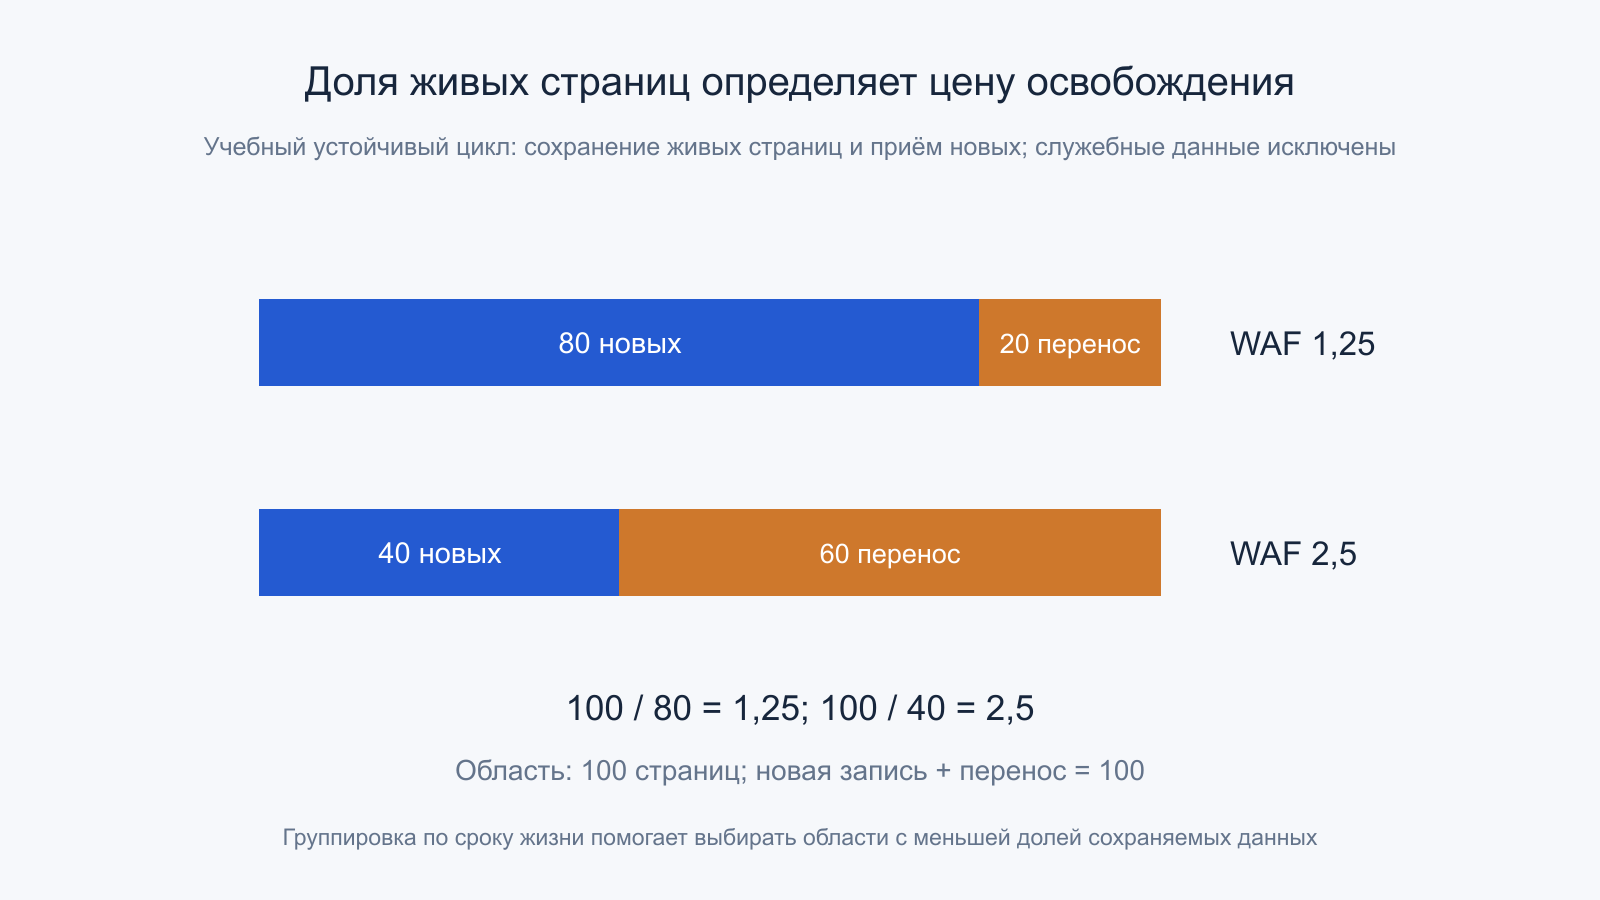
Рассмотрим условную освобождаемую область из 100 равных страниц. Если 20 ещё актуальны, перед стиранием их переносят. Освободившийся ресурс позволяет принять 80 новых страниц, а всего записывается 100: 80 новых и 20 перенесённых. Коэффициент такой устойчивой модели равен 100/80 = 1,25. Служебные данные и дополнительные механизмы здесь исключены.
Если живыми остаются 60 страниц, для 40 новых приходится записать 100, то есть WAF получается 2,5. Разница объясняется долей сохраняемого содержимого, а не ускорением самой команды стирания. Совместное размещение объектов с близким сроком удаления помогает выбирать области с меньшей долей живых данных. Но результат зависит от действительных обновлений.
Если приложение сообщает неверную классификацию, холодные объекты снова удерживают горячую область. Даже точная первоначальная классификация может устареть. Поэтому полезно сопоставлять группировку со счётчиками и событиями устройства, а затем корректировать политику. Ни FDP, ни ZNS не способны сами доказать, что семантика времени жизни, придуманная приложением, соответствует реальному потоку.
У уменьшения переноса есть и потенциальный энергетический эффект, однако коэффициент записи нельзя прямо перевести в процент экономии всего сервера. Контроллер продолжает принимать команды, считывать данные и обслуживать NAND. Если условная переменная часть расхода равна 10 Дж на гигабайт физической записи, устранение 100 ГБ переноса убирает 1000 Дж только этой части модели. Постоянная мощность, чтение и затраты программы в такое произведение не входят.
Обратная связь полезна, пока сама не перегружает путь
FDP предусматривает конфигурационные сведения, статистику, состояние ресурсов и события. Они позволяют наблюдать, насколько выбранная группировка согласована с размещением и освобождением. Руководство Samsung по работе с FDP описывает эти возможности и программные пути. Конкретные поля и область счётчика нужно читать для применимой версии.
Чтение управляющей информации после каждой маленькой записи способно стать самостоятельным ограничением. Кроме затрат обращения, несколько потоков и переупорядочение команд усложняют точное сопоставление событий. Снимок оставшейся ёмкости RU не обязательно описывает состояние через несколько микросекунд, когда уже выполняются другие команды. Политика должна учитывать эту конкуренцию.
Практический смысл обратной связи — проверять устойчивое поведение и замечать нарушения предположений. Она не заменяет корректность записи, обработку завершений и журналирование метаданных. В отчёте разделяют изменения политики управления и измерение полезного потока. Иначе уменьшение внутреннего переноса можно случайно купить большей задержкой хоста и получить худший результат приложения.
Даже уменьшение среднего времени не гарантирует сокращение редких пауз. В одном сценарии освободившаяся полоса помогает чтению; в другом задержку определяют уже очередь, фоновые задачи приложения или ограничение общего интерфейса. Поэтому рядом с WAF сохраняют распределение времени ответа и выбранный процентиль. Сравнение имеет смысл при одинаковой интенсивности запросов: снижение нагрузки само по себе способно улучшить задержки без изменения размещения.
Долговечность не выводится из одного уменьшенного WAF
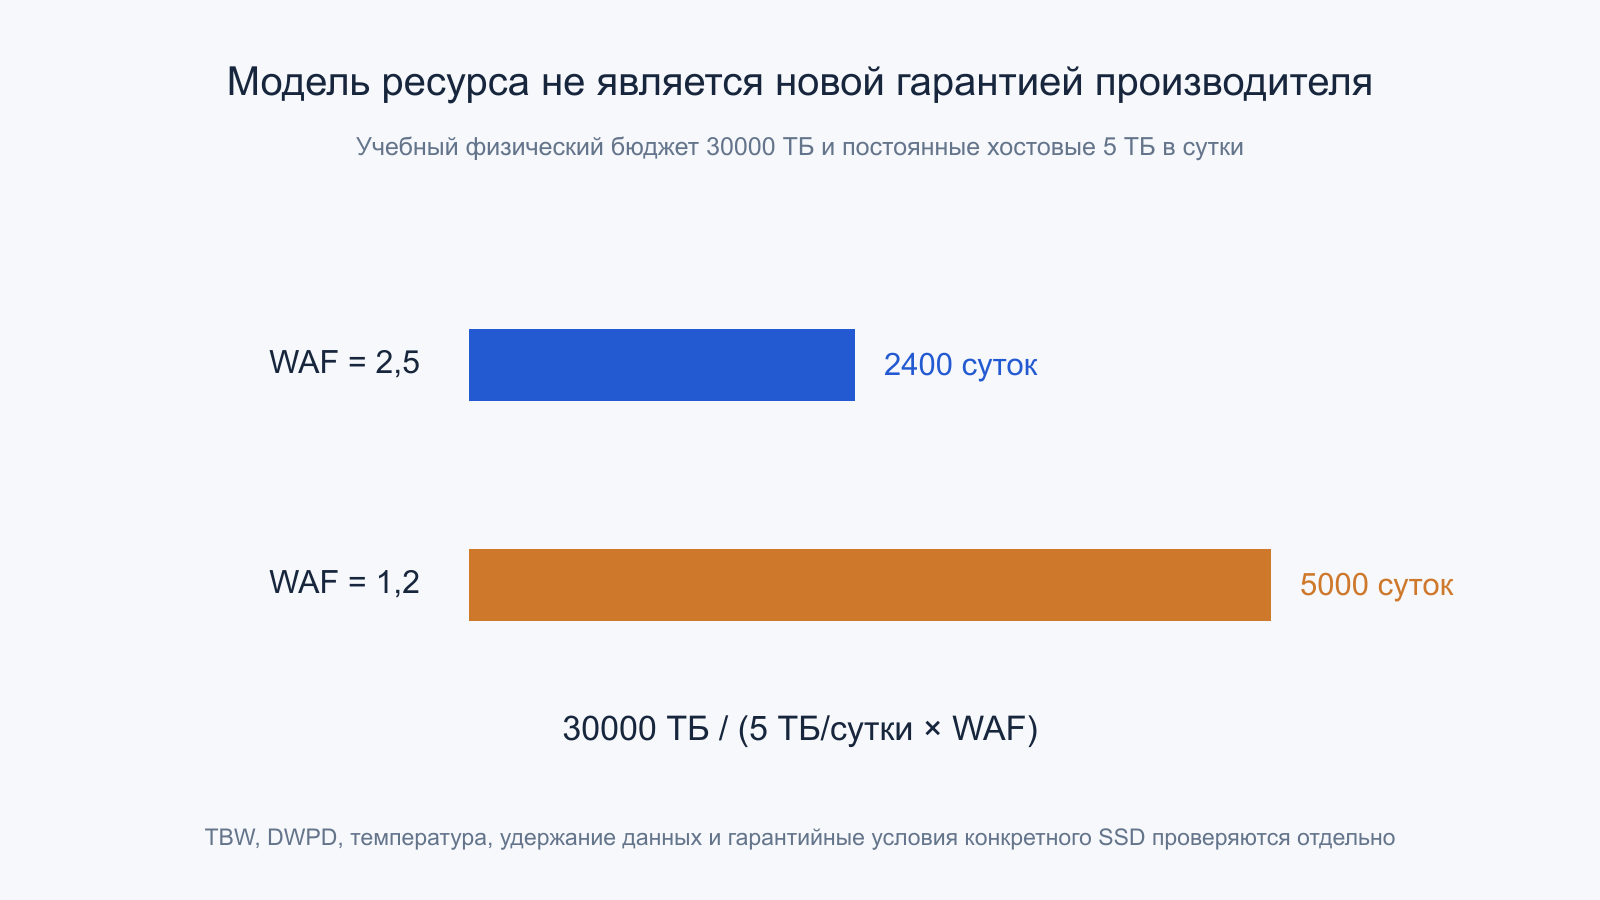
Учебный допустимый бюджет записи выбранной физической модели равен 30000 ТБ. При хостовом потоке 5 ТБ в сутки и WAF 2,5 расход составляет 12,5 ТБ в сутки, расчётный срок —2400 суток. При WAF 1,2 расход равен 6 ТБ, а частное даёт 5000 суток. Это только деление заданного бюджета на постоянную нагрузку.
Такие числа не являются гарантией ресурса реального SSD. Производитель определяет допустимые условия, показатели TBW или DWPD, температурные режимы и профиль нагрузки. Надёжность удержания данных, запас блоков и физическое обслуживание не исчезают после удачного размещения. Нельзя умножить гарантийный срок любого устройства на отношение двух коэффициентов и объявить новый официальный ресурс.
Важно также сохранять одинаковую границу полезной работы. Если новая организация уменьшила WAF устройства, но заставила приложение записывать вдвое больше, ожидаемая экономия может исчезнуть. Для срока службы оценивают совокупный поток на NAND, а для решения о внедрении — ещё задержку, потребление, ёмкость и стоимость программной поддержки. Один коэффициент описывает только часть результата.
Размещение не заменяет устойчивость при отключении питания
Успешное завершение команды, запись в энергонезависимую память и согласованность нескольких структур приложения — разные границы. В зависимости от поддерживаемого кэша и правил используются предусмотренные механизмы фиксации, включая Flush и FUA в соответствующих операциях. Их семантика не становится ненужной от того, что данные направлены в правильную зону или RU.
Для Zone Append особенно важна связь между возвращённым адресом и устойчивым индексом объекта. Для FDP требуется сохранить обычные логические метаданные и корректно восстановить конфигурационное состояние. После сбоя приложение не должно угадывать, какие незавершённые операции успели стать доступными. Процедура восстановления опирается на документированные гарантии и собственный формат хранения.
Повторное использование области также требует строгого жизненного цикла ссылок. Старые читатели не должны обращаться к уже освобождённому содержимому. В зональной модели сброс нельзя считать обычным удалением одного файла; настройку FDP нельзя воспринимать как безвредный переключатель поверх любой существующей конфигурации. Инженерный проект заранее определяет миграцию, сохранение данных и проверку восстановления на отдельной среде.
Готовность экосистемы проверяется по конкретному пути
К октябрю 2026 года существуют спецификации, документы реализаций и исследования использования размещения. Но наличие стандартного механизма не означает его поддержку каждым потребительским NVMe SSD, драйвером или файловой системой. Нужно проверить точное устройство, прошивку, программный интерфейс и способ передачи сведений через промежуточные слои. Виртуализация и удалённое хранение добавляют собственные границы.
KIOXIA описывала демонстрацию FDP и RocksDB на OCP 2024. Слово «демонстрация» следует сохранить: оно подтверждает показанный сценарий, а не универсальную доступность каждой функции всем покупателям серии. Аналогично успешный опыт одного кэша нельзя превращать в обещание того же коэффициента для другой базы и заполнения.
Содержательная проверка сравнивает одинаковую полезную работу, заполнение и установившийся режим. Сохраняют задержки, общий объём записи, корректность после сбоев и поведение при нехватке ресурсов. Тогда ZNS оценивается как явный зональный договор, а FDP — как совместимое управление размещением поверх обычной адресации. Выбор определяется тем, какие обязанности программа готова принять и какой результат подтверждён для её данных.
Короткий тест на пустом накопителе особенно легко скрывает различие подходов: в начале ещё достаточно свободных физических областей и почти нечего переносить. Для проверки механизма нужны повторяемое состояние заполнения и достаточно длинный цикл обновлений. При этом из статьи не следует универсальная длительность подготовки или обязательный процент заполнения: методика зависит от исследуемого приложения и документированных условий устройства.
Для удалённого хранилища отдельно проверяют сохранение намерения размещения через весь путь. Если промежуточный сервер объединяет потоки или создаёт новые команды без соответствующих сведений, накопитель видит уже другую нагрузку. Наличие FDP на конечном SSD не доказывает передачу классификации от исходного приложения. Такой разрыв локализуют по наблюдаемым командам и конфигурации; менять классификацию данных вслепую в этой ситуации недостаточно.
Официальные первичные источники
- NVM Express — Hyperscale Innovation: Flexible Data Placement Mode.
- NVM Express — Zoned Namespace Command Set, 1.1e, 2024.
- Zoned Storage — модель ZNS, геометрия и ресурсы.
- Linux — zonefs.
- Zoned Storage — RocksDB с ZenFS.
- xNVMe — FDP и связи RU/RUH/Placement Handle.
- Samsung — Introduction to Flexible Data Placement.
- Samsung — Getting Started with FDP.
- Samsung — NVMe FDP: организация и изоляция.
- SNIA — материал рабочей группы FDP, февраль 2026.
- KIOXIA — демонстрация FDP с RocksDB, октябрь 2024.