Аппаратная трассировка лучей: BVH, RT-блоки и пределы ускорения
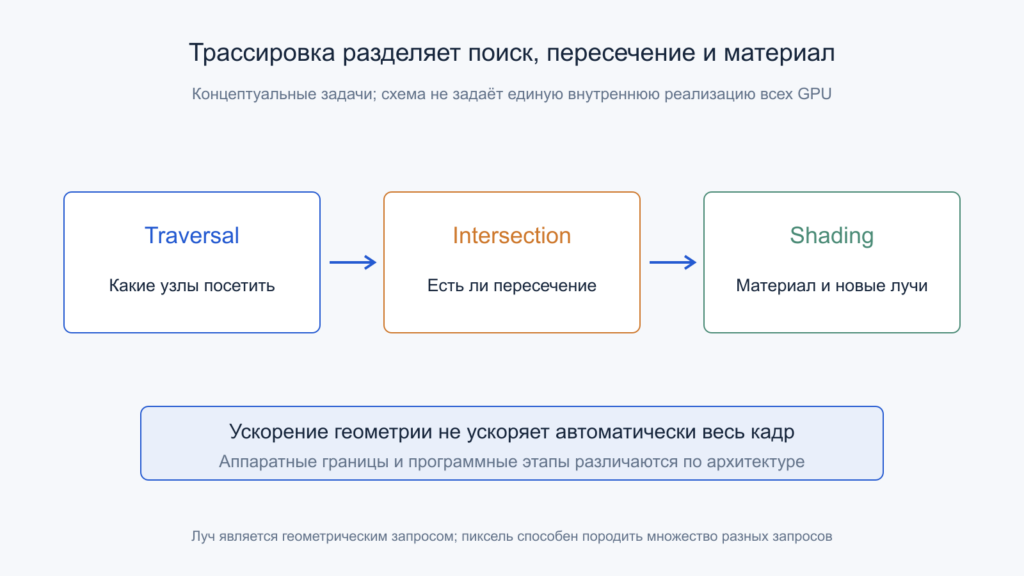
Фиксированные блоки ускоряют определённое подмножество работы. Точная граница между аппаратурой и шейдерами зависит от архитектуры. Открыть иллюстрацию в полном размере.
Аппаратная трассировка лучей ускоряет поиск геометрических пересечений, но готовый кадр включает гораздо больше работы. Нужно построить структуры сцены, пройти их узлы, проверить примитивы, выполнить материалы, породить новые запросы и обработать шум. Поэтому одинаковое число RT-блоков может давать совершенно разные результаты в сцене с прозрачной листвой, зеркалами и плотной анимированной геометрией.
Разберём внутреннюю задачу поиска, связь BVH с памятью и причины, по которым рост скорости пересечений не превращается в такое же увеличение FPS. Особое внимание уделено современным механизмам кластерной геометрии, картам непрозрачности и переупорядочению исполнения. Состояние первичных документов сверено на 26 октября 2026 года. Все собственные численные модели учебные, без выдуманных измерений оборудования владельца сайта.
Содержание статьи
- 1. Луч является запросом с границами
- 2. BVH позволяет не проверять каждый треугольник
- 3. Проверка ограничивающего параллелепипеда имеет собственную математику
- 4. TLAS и BLAS решают задачи экземпляров и геометрии
- 5. Обход, пересечение и шейдинг — разные этапы
- 6. Ближайшее и первое найденное попадания не совпадают автоматически
- 7. Прозрачность может возвращать поиск к программируемой логике
- 8. Пользовательский примитив не превращается автоматически в аппаратный треугольник
- 9. Качество построения дерева покупается отдельной работой
- 10. Обновление и перестроение имеют разные ограничения
- 11. Память структуры является самостоятельным ограничением
- 12. Несвязные лучи ухудшают совместную работу вычислителей
- 13. Payload и состояние пути конкурируют за ресурсы
- 14. Кластерная геометрия меняет цену динамических деталей
- 15. Разные архитектуры оптимизируют разные части задачи
- 16. Пропускная способность ограничивается самым тесным участком
- 17. Алгебра кадра ограничивает пользу ускоренного RT-блока
- 18. Число лучей и шум связывают качество с временем
- 19. Как проверить пользу нового механизма
- Первичные источники
- Читайте также
1. Луч является запросом с границами
Геометрически луч можно записать как P(t)=O+tD, где O задаёт начало, D — направление. Практический запрос дополнительно имеет допустимый интервал параметра t, маску экземпляров и другие условия. Если направление не нормировано, t не обязан совпадать с расстоянием в метрах. Изменить длину D, сохранив прежние границы t, означает изменить геометрическую область поиска.
Запрос может искать ближайшее принятое пересечение либо только факт перекрытия пути. Для тени иногда достаточно найти любой подходящий непрозрачный объект между поверхностью и источником света. Для отражения обычно нужны положение и свойства ближайшей видимой поверхности. Эти режимы используют похожую геометрию, но допускают разное раннее завершение и разный объём последующей работы.
Также луч не равен пикселю. Один пиксель способен породить несколько выборок, каждая — дополнительные лучи для освещения и продолжения пути. Некоторые запросы вообще служат другим вычислениям, например проверке видимости. Поэтому показатель «лучей в секунду» имеет смысл только вместе с типом запроса, геометрией, интервалом поиска и необходимыми шейдерами.
2. BVH позволяет не проверять каждый треугольник
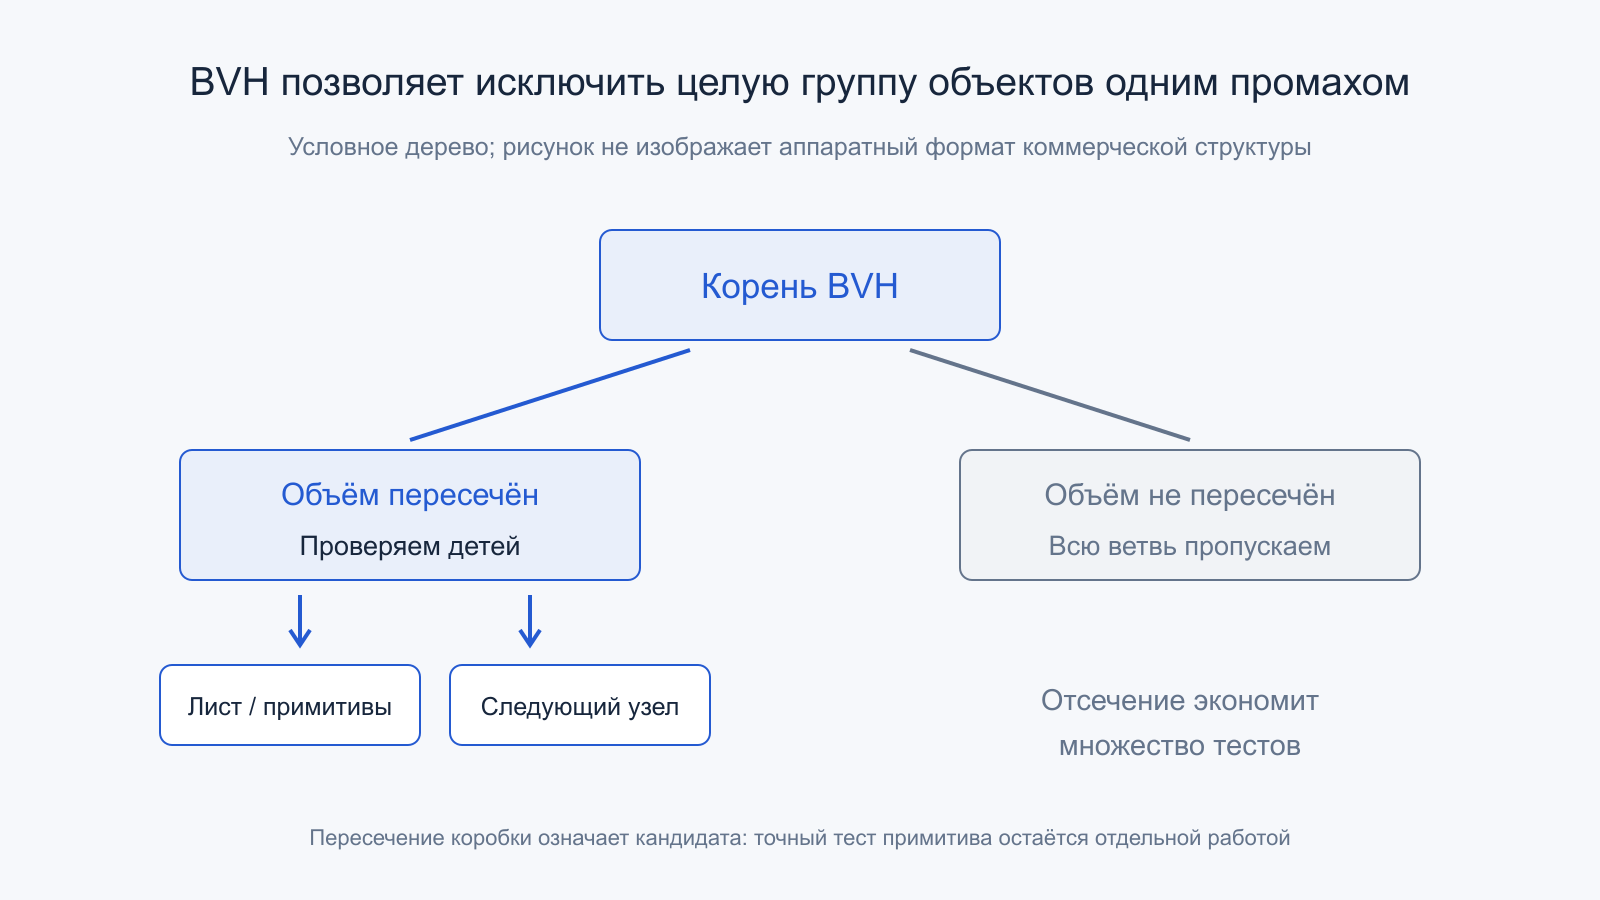
Bounding Volume Hierarchy группирует примитивы в дерево ограничивающих объёмов. Если луч не пересекает объём узла, содержимое соответствующей ветви можно пропустить. Лист содержит ссылки на геометрию либо подходящее её представление. Чем лучше объёмы отделяют ненужные участки, тем меньше геометрических проверок требуется. При плохом перекрывающемся дереве преимущество уменьшается.
Авторы pbrt показывают BVH и модели построения на открытом примере. Это удобная объясняющая реализация, а не раскрытая внутренняя раскладка любого коммерческого RT-блока. Современная аппаратная структура может иметь широкие узлы, сжатые координаты и специальные пакеты примитивов. Общая идея отсечения сохраняется, а число байтов и шаги обхода различаются.
Глубина дерева сама по себе не определяет качество. Неглубокий узел с несколькими сильно пересекающимися дочерними объёмами может потребовать пройти почти все ветви. Более глубокая структура способна эффективно отбрасывать пространство. Для оценки важны число посещённых узлов, геометрические проверки, поведение памяти и распределение лучей. Формула «логарифм числа треугольников» не гарантирует такого времени в произвольной сцене.
3. Проверка ограничивающего параллелепипеда имеет собственную математику
Для AABB, ориентированного по координатным осям, часто объясняют пересечение через интервалы трёх плоских слоёв. Каждая ось задаёт диапазон t, в котором луч находится между двумя границами. Пересечение этих диапазонов и исходного интервала луча определяет, остаётся ли допустимый участок. При отрицательном направлении границы необходимо упорядочить, а нулевые компоненты требуют корректного отдельного обращения.
В учебном случае O=(0;0;0), D=(1;0,5;0,25), минимум коробки (2;0,5;0,25), максимум (4;2;1). Ось X даёт [2;4], Y — [1;4], Z — [1;4]. Их общий интервал [2;4] пересекается с выбранным диапазоном луча [0;10], поэтому коробка является кандидатом. Это ещё не доказательство пересечения конкретного треугольника внутри неё.
Численная устойчивость нужна на границах и общих рёбрах. Слишком агрессивное округление границы объёма способно потерять настоящий объект, тогда как более консервативная коробка обычно лишь добавляет лишнюю проверку. Следовательно, уменьшение памяти координат должно сохранять корректное охватывание. Аппаратное ускорение требует не только быстрого деления, но и правильно определённых правил предельных случаев.
4. TLAS и BLAS решают задачи экземпляров и геометрии
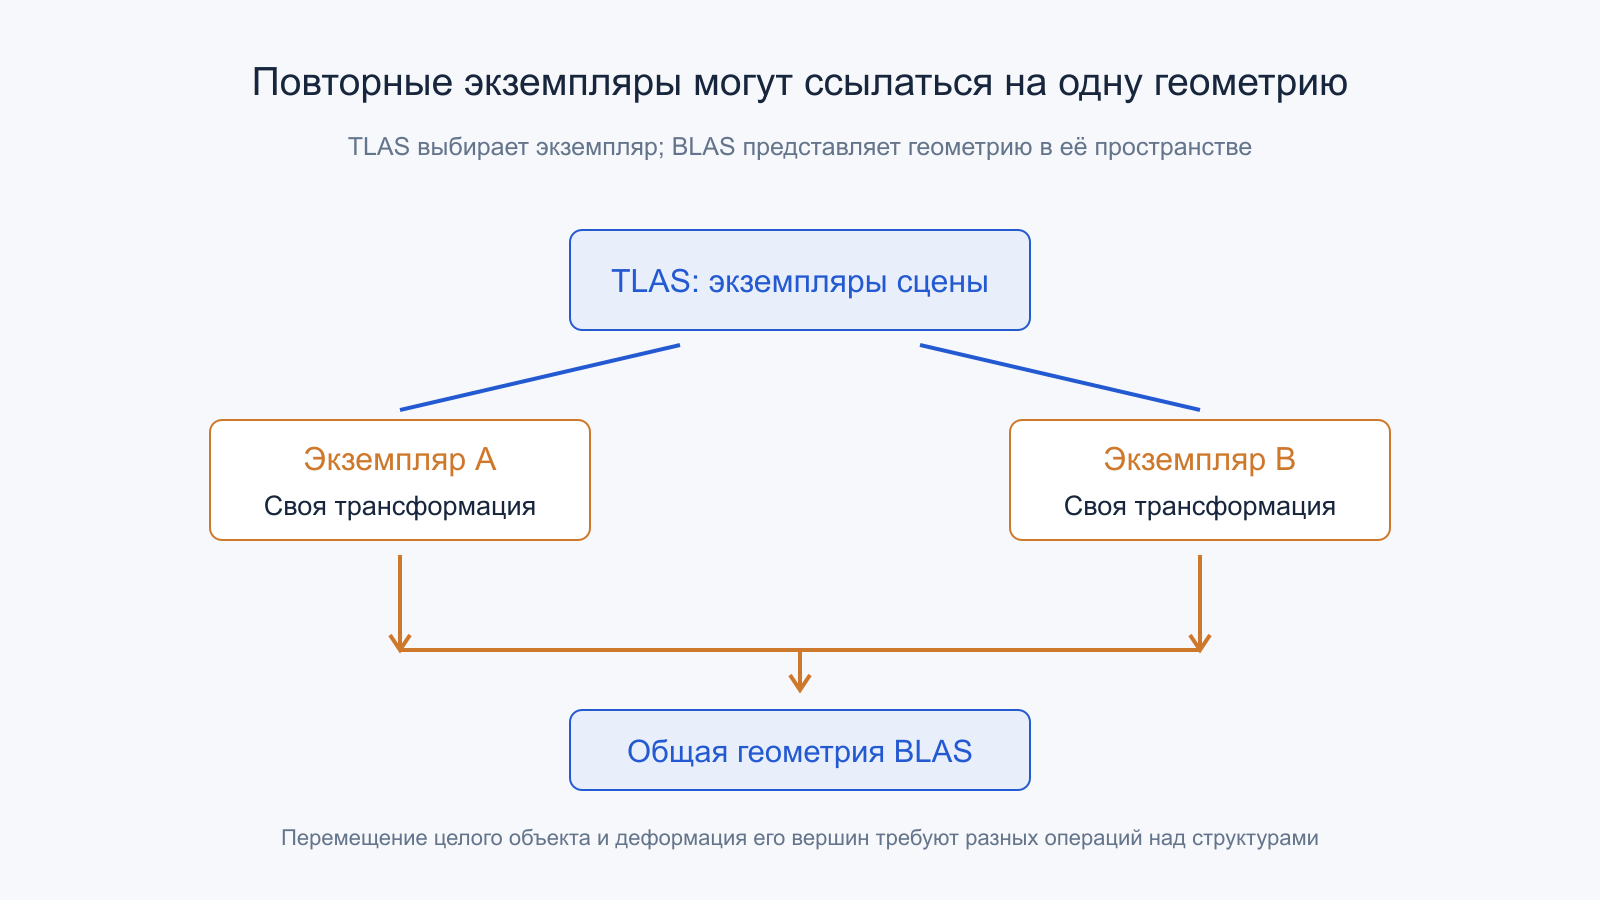
Спецификация Vulkan разделяет верхнюю и нижнюю структуры ускорения. BLAS описывает геометрию, TLAS — экземпляры с преобразованиями и ссылками. Один набор геометрии можно использовать несколько раз без полного дублирования его треугольников. Так устроена важная часть экономии для повторяющихся объектов сцены.
При переходе к экземпляру луч преобразуется в его пространство. Это не требует каждый раз перемещать весь исходный меш в мировые координаты. Однако преобразование должно быть допустимым, а интервалы и параметры — согласованными. Масштабирование экземпляра особенно полезно для понимания, почему параметр луча нельзя автоматически трактовать как физическое расстояние после произвольной перенормировки направления.
Граница между структурами также определяет стоимость изменения. Перемещение целого жёсткого объекта и деформация его вершин являются разными обновлениями. Большое число экземпляров экономит геометрию, но добавляет работу верхнему уровню и управлению. Для законченной сцены важны оба уровня, а не только компактность одного меша. Программное приложение отвечает за корректное время жизни и синхронизацию используемых структур.
5. Обход, пересечение и шейдинг — разные этапы
При аффинном преобразовании точки O и вектора D одним согласованным преобразованием сохраняется параметр t в выражении луча. Если после этого дополнительно нормировать D, необходимо согласованно изменить интервал. Это простое соотношение позволяет рассуждать о масштабированных экземплярах без ошибки единиц. Нормаль поверхности при освещении преобразуется по другому правилу и не является направлением луча.
Traversal выбирает, какие узлы и листья посещать. Intersection определяет пересечение с конкретным примитивом и его параметры. Shading вычисляет материал, освещение и дальнейшее поведение пути. Специализированная аппаратная логика может взять на себя часть первых двух задач, пока программируемые вычислители выполняют материалы. Точные границы реализации зависят от архитектуры.
Описание обхода Vulkan определяет наблюдаемую семантику кандидатов и обработку попаданий. API не раскрывает универсальную внутреннюю схему каждого GPU. Поэтому нельзя переносить названия аппаратных движков NVIDIA на AMD или считать количество тестов коробок в одной инструкции общей единицей всех производителей. Сопоставлять нужно законченный режим.
Шейдинг может оказаться дороже поиска: сложный материал читает текстуры, выполняет вычисления и порождает новые запросы. После ускорения геометрической части именно он часто становится ограничением. Обратный случай тоже возможен: простой теневой запрос почти не имеет материала, зато проходит сложную сцену. Одно слово ray tracing объединяет задачи с совершенно разным соотношением аппаратной и программируемой работы.
6. Ближайшее и первое найденное попадания не совпадают автоматически
Порядок обхода дерева не обязан точно соответствовать расстоянию до всех поверхностей. Первое найденное подходящее пересечение может оказаться дальше другого, ещё не проверенного. Для ближайшего результата поиск должен сохранить предусмотренную корректность, уменьшая текущую верхнюю границу после принятого попадания. Это позволяет отбрасывать часть более далёких кандидатов, не объявляя произвольный первый результат окончательным.
В учебной сцене непрозрачные поверхности пересекаются при t=8 и t=3. Если обход первым обнаружил восьмёрку, запрос ближайшей поверхности должен ещё найти тройку. Теневой запрос с допустимым ранним завершением способен остановиться после восьмёрки, если оба значения находятся между исходной точкой и источником. Он отвечает на другой вопрос и поэтому может выполнить меньше работы.
Функциональная спецификация DXR отдельно определяет any-hit, closest-hit и условия завершения. Any-hit не означает «шейдер самого ближайшего объекта». Его вызовы не гарантированы в порядке расстояния, а некоторые кандидаты программа может отвергнуть. Алгоритм накопления прозрачности не должен без отдельного соглашения предполагать сортированный список всех пересечений вдоль пути.
7. Прозрачность может возвращать поиск к программируемой логике
У листа дерева с альфа-текстурой геометрический треугольник охватывает и видимую часть, и отверстия. После пересечения нужно определить, покрыта ли конкретная точка. Если требуется any-hit, программируемый код читает данные материала и принимает либо отвергает кандидата. Трасса снова продолжается после отвергнутой точки. Множество таких событий увеличивает цену даже простой по числу треугольников растительности.
Opacity micromap заранее классифицирует небольшие области треугольника как непрозрачные, прозрачные или требующие уточнения. В подходящем режиме известные области позволяют сократить программные проверки, а неизвестные сохраняют нужный путь обработки. Это структура классификации покрытия, а не универсальная замена любому прозрачному материалу с преломлением и сложным объёмным рассеянием.
В учебном наборе из тысячи подходящих кандидатов восемьсот получают известную классификацию и двести требуют шейдера. Число программных проверок уменьшается с тысячи до двухсот, на 80%. Но время кадра не обязано уменьшиться на 80%: остаются построение карты, геометрический поиск, доступ к памяти и остальные материалы. Число сокращённых вызовов является локальной метрикой.
8. Пользовательский примитив не превращается автоматически в аппаратный треугольник
Процедурная геометрия может задаваться ограничивающим объёмом и пользовательской функцией пересечения. Коробка помогает найти кандидата, но точный тест выполняется по другому контракту. Быстрый проход аппаратного AABB не означает, что сложная функция расстояния внутри получила такую же специализированную поддержку. Она может потребовать много программируемых итераций и промежуточного состояния.
Существуют архитектурные расширения для других примитивов. Например, описание RTX Blackwell рассматривает Linear Swept Spheres для подходящих волос и похожей геометрии. Это конкретный поддержанный механизм, а не утверждение о нативном исполнении произвольной процедурной поверхности. Нужны соответствующие API, драйвер и представление данных, согласованное с выбранным оборудованием.
Точность процедурного теста также относится к алгоритму. Пропуск тонкой детали из-за грубого шага не становится правильным, если запрос быстро обработан. Полезная оценка включает сравнение с эталонной геометрией и граничными случаями. Если приложение использует более дешёвый приближённый примитив, выигрыш следует описывать вместе с изменением качества, а не приписывать целиком улучшению RT-блока.
9. Качество построения дерева покупается отдельной работой
Построитель должен решить, какие объекты объединять. Хорошее разбиение уменьшает дальнейшие посещения, но поиск такого разбиения сам требует времени. Surface Area Heuristic связывает оценочную стоимость с площадями дочерних объёмов и числом примитивов. Это модель распределения лучей, а не обещание одинаковой вероятности для камерного луча, отражения и теневого запроса.
В учебной оценке стоимость посещения равна 1, теста примитива — 2. У родителя площадь 100, у детей 40 и 30, внутри 4 и 6 примитивов. Получаем 1+(40/100)×4×2+(30/100)×6×2=7,8 условной единицы вместо 20 для проверки всех десяти. Это выбранные числа и упрощённая эвристика, без предсказания времени аппаратного блока.
Реальная структура должна учитывать память, ширину узла и особенности нагрузки. Меньше арифметических тестов не всегда означает меньше времени, если получился плохой доступ к памяти. Также дополнительная оптимизация бесполезна, когда геометрия немедленно меняется. Выгодность построителя определяется суммой его расходов и дальнейшего использования, поэтому статические и быстро деформируемые сцены могут требовать разных решений.
10. Обновление и перестроение имеют разные ограничения
Refit либо предусмотренный API update меняет границы существующей структуры, сохраняя существенные отношения её организации. Это бывает дешевле полного построения, однако после сильной деформации объёмы способны начать сильно перекрываться. Структура остаётся корректной, но требует больше посещений. Перестроение может вернуть качество ценой дополнительных вычислений и временной памяти.
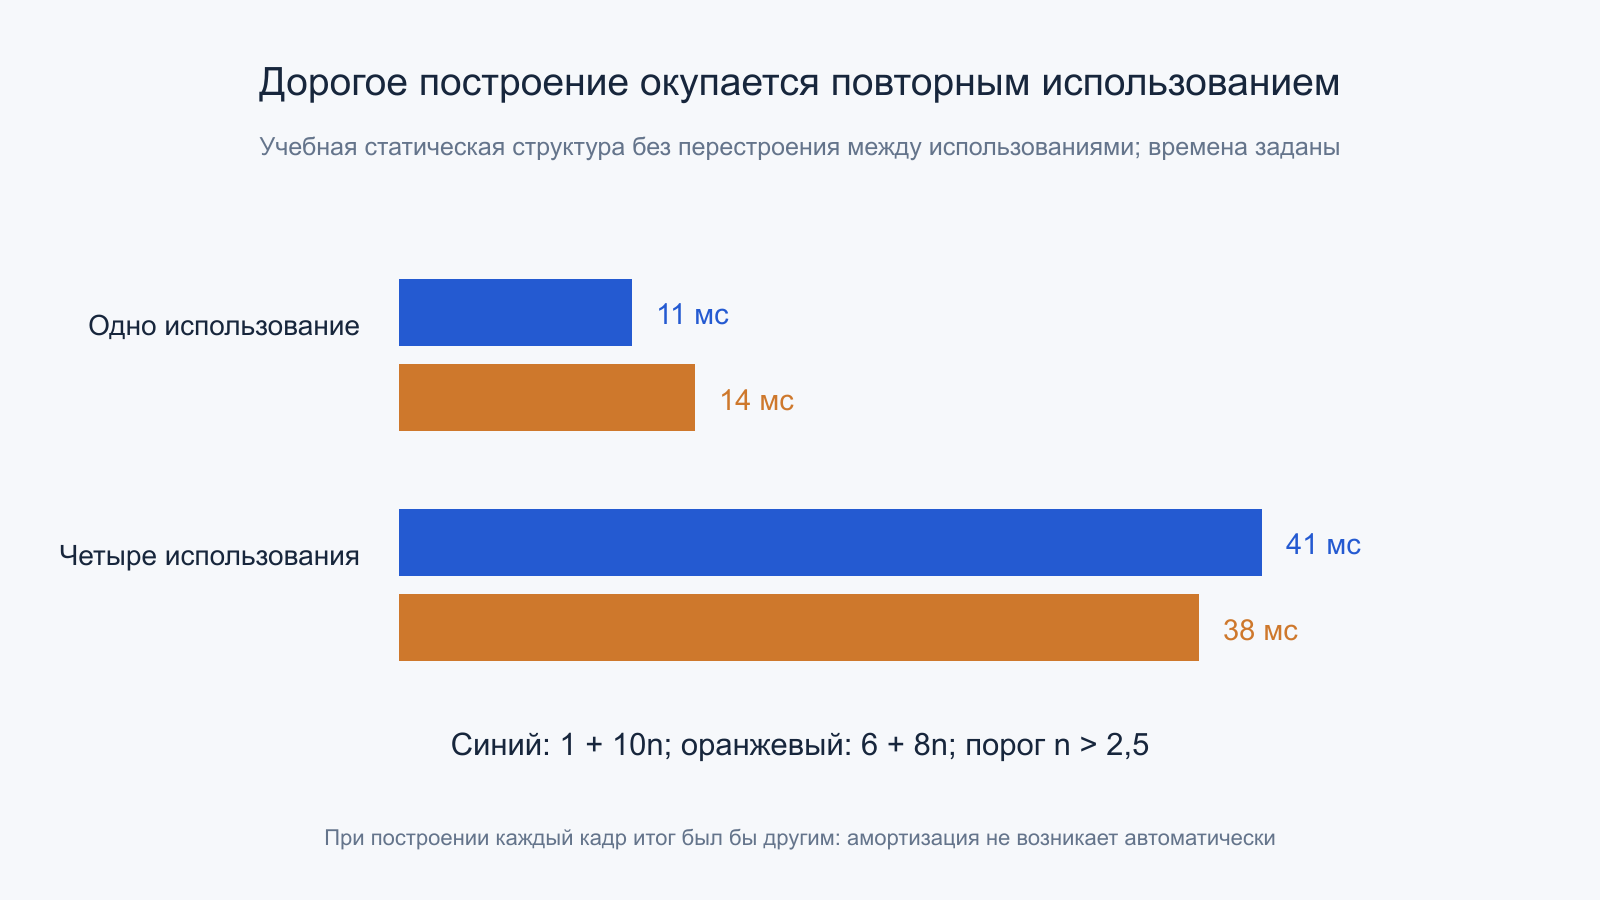
Зададим дешёвое построение 1 мс и трассировку 10 мс на использование; более качественное — 6 мс и 8 мс соответственно. При одном использовании суммы равны 11 и 14 мс. При четырёх без перестроения — 41 и 38 мс. Равенство 1+10n=6+8n достигается при n=2,5; с третьего целого использования второй вариант выигрывает в этой последовательной модели.
Нельзя автоматически обновлять структуру после любого изменения. API задаёт допустимые виды модификаций, исходные флаги и ограничения размеров. Изменение топологии и изменение положения прежних вершин — разные события. При нарушении контракта результат может стать некорректным, а не просто медленным. Для сравнения производительности сначала нужно подтвердить, что оба варианта представляют одну и ту же актуальную сцену.
11. Память структуры является самостоятельным ограничением
У полного двоичного дерева с одним примитивом в каждом листе и N листьями есть 2N−1 узлов. Для миллиона листьев это 1999999 узлов. Если каждому условно выделить 32 байта, получится 63999968 байт, около 61,04 МиБ. Это математическая модель конкретного дерева, а не оценка реального формата BLAS определённого GPU.
Нужно дополнительно учитывать сами вершины, индексы, экземпляры, материалы, временный scratch и возможные копии для обновления. Сжатие узлов может уменьшить объём и трафик, но требует подходящего декодирования и консервативных границ. Широкий BVH имеет другое число и состав узлов. Поэтому считать память произвольной сцены единственным коэффициентом на треугольник ненадёжно.
Учебное сокращение структур с 2 до 1,2 ГБ экономит 0,8 ГБ. Если остальные данные занимают 8 ГБ, общий объём меняется с 10 до 9,2 ГБ, только на 8%. Локальное уменьшение на 40% не является таким же уменьшением всего потребления видеопамяти. При работе близко к её пределу даже этот запас может быть ценным, но границу следует назвать.
12. Несвязные лучи ухудшают совместную работу вычислителей
Соседние камерные лучи часто посещают похожие объекты. После нескольких отражений их направления и материалы могут разойтись. Тогда потоки в одной аппаратной группе требуют разных участков кода и данных. Часть исполнительных позиций ожидает, пока выполняется чужая ветвь. Одновременно уменьшается повторное использование данных, а запросы памяти становятся менее согласованными.
В условной группе из 32 позиций при выполнении ветви только восемь полезны для этой ветви: локальная доля составляет 25%. Это не измерение загрузки GPU и не универсальная эффективность всей трассировки. Другие группы способны исполняться параллельно. Пример лишь показывает, почему одинаковая суммарная арифметика даёт разное время при разной организации работы.
Shader Execution Reordering стремится собрать более похожую работу перед соответствующим этапом. Но переупорядочение тоже имеет цену и должно сохранять программный контракт. Оно не создаёт когерентность любого набора лучей бесплатно. Поддержка определённого API-вызова и фактическое аппаратное ускорение отличаются: некоторые допустимые реализации могут выполнять минимальный вариант без полезного изменения порядка.
13. Payload и состояние пути конкурируют за ресурсы
Луч может нести цвет, идентификаторы, случайное состояние и другие данные. Чем больше живого состояния сохраняется через поиск и вызовы шейдеров, тем выше расходы хранения и перемещения. Полезно различать состояние одного запроса и суммарную структуру программы. Большой payload способен влиять на планирование, даже если геометрические тесты сами остаются прежними.
Для масштаба зададим программный массив из миллиона сохранённых записей путей. При 32 байтах на запись он занимает 32 МБ, при 128 —128 МБ, без накладных расходов. Это модель явно выделенного массива, а не утверждение о миллионе одновременно резидентных аппаратных лучей. Внутреннее состояние RT-конвейера может организовываться иначе и иметь собственные ограничения.
Сокращать данные следует с сохранением смысла. Повторно вычислить дешёвую величину иногда выгоднее, чем хранить, но повторное чтение большой текстуры может изменить баланс. Нельзя удалить требуемый идентификатор только ради меньшей записи и затем сравнивать другой алгоритм как равнозначный. Проверка должна включать результат, время и фактический объём при одинаковой полезной работе.
14. Кластерная геометрия меняет цену динамических деталей
Архитектурный документ RTX Blackwell описывает Mega Geometry с кластерами треугольников и Cluster-level Acceleration Structures. Вместо повторной обработки каждого треугольника части сцены получают промежуточные структуры, которые можно повторно использовать. Это помогает при изменении уровня детализации, когда состав небольших геометрических групп меняется часто.
В документе CLAS строится из компактной группы вплоть до 256 треугольников. Такая группа становится строительным элементом следующего уровня. Это не означает, что все лучи обязаны проверить все её треугольники либо что приложение ускорится в 256 раз. Новое представление меняет построение, хранение и обработку геометрии, сохраняя затраты материалов и остальных этапов.
Открытый репозиторий RTX Mega Geometry SDK является программным свидетельством реализации, а технологическая демонстрация — свидетельством конкретного сценария. Они не доказывают поддержку каждого расширения любой игрой и любым драйвером. Для оценки важно, использует ли движок механизм и какая геометрия фактически поступает в трассировку, включая совпадение детализации с растеризованной сценой.
15. Разные архитектуры оптимизируют разные части задачи
У Blackwell описаны специализированные изменения RT-блоков для кластеров и дополнительных типов примитивов. Это сведения производителя о собственной архитектуре. AMD в истории HIP RT за август 2025 года отдельно перечисляет возможности RDNA 4: сжатый BVH8, пакеты треугольников, intersectable instances и ориентированные объёмы для качественного построения.
Ориентированный объём может плотнее охватить вытянутый повёрнутый объект, чем AABB в прежних осях. Однако его представление и тест имеют собственную цену. Сжатая широкая структура также меняет соотношение арифметики и памяти. Из одинакового слова acceleration нельзя вывести одинаковую внутреннюю организацию, поэтому количество брендированных блоков разных производителей не является прямым коэффициентом сравнения.
Наличие функций библиотеки не гарантирует, что их использует выбранный игровой API-путь. HIP RT, DXR и Vulkan представляют разные программные контракты. Для практического сравнения нужны точные устройство, драйвер, движок, сцена и включённые функции. Существование архитектурной возможности полезно объясняет потенциальное преимущество, а фактический результат требует наблюдения в соответствующей реализации.
16. Пропускная способность ограничивается самым тесным участком
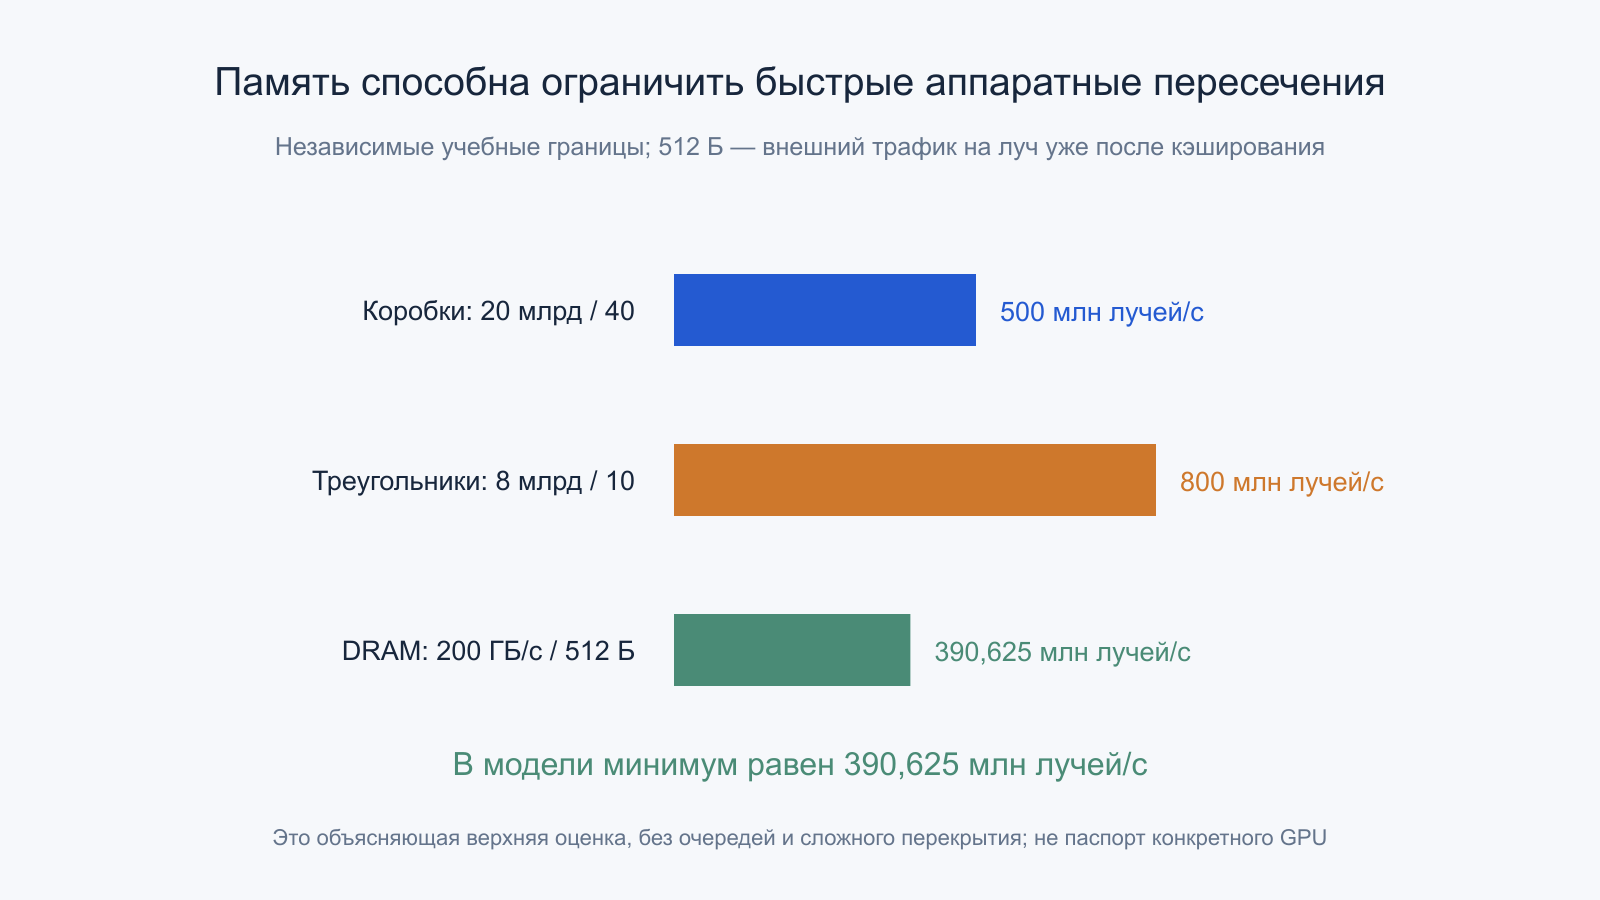
Зададим независимые учебные пределы: 20 миллиардов тестов коробок в секунду, 8 миллиардов тестов треугольников и 200 ГБ/с доступного трафика DRAM. Пусть один луч в среднем требует 40 коробок, 10 треугольников и 512 байт фактического внешнего трафика после кэширования. Получаются границы 500, 800 и 390,625 миллиона лучей в секунду соответственно.
В этой упрощённой модели итог не превышает 390,625 миллиона даже при достаточной независимости запросов. Удвоение только скорости треугольников не изменит тесную границу памяти. Если повысить повторное использование и уменьшить внешний трафик, ограничением способен стать обход. Все показатели заданы искусственно и не описывают паспорт конкретного RT-ядра.
Реальная система имеет очереди, неоднородные лучи и перекрытие этапов, поэтому минимум является объясняющей верхней оценкой, а не точным прогнозом. Средние посещения также меняются вместе с направлением лучей и структурой сцены. Полезные счётчики и профилировщик позволяют определить, какой участок ограничивает данный кадр. Одного арифметического пика недостаточно для такого диагноза.
17. Алгебра кадра ограничивает пользу ускоренного RT-блока
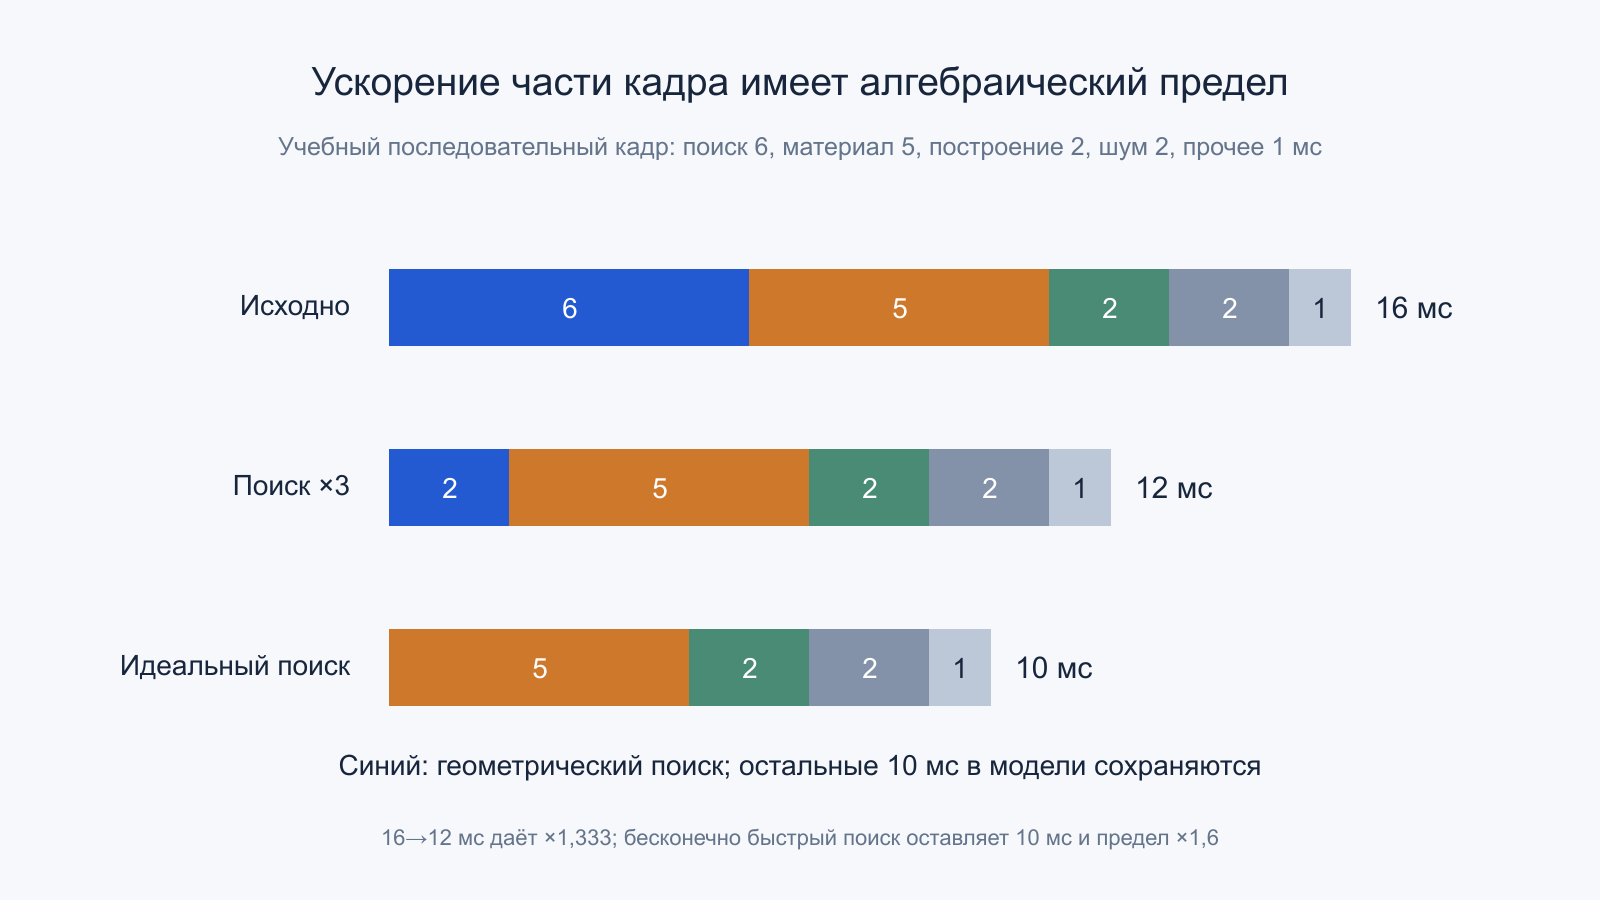
В последовательной учебной модели кадр занимает 16 мс: обход и пересечения —6, шейдинг —5, построение —2, обработка шума —2, прочее —1. Если ускорить только первые 6 мс втрое, получится 12 мс и ускорение 1,333 раза. Даже бесконечно быстрый поиск оставит 10 мс, ограничивая выигрыш величиной 1,6 раза.
Исходные 16 мс соответствуют 62,5 кадра в секунду, 12 мс —примерно 83,33. Процент уменьшения времени и процент увеличения FPS различаются из-за обратной зависимости. В настоящем конвейере часть работ перекрывается, и эффект определяется критическим маршрутом. Поэтому простое сложение длительностей отдельных GPU-задач тоже требует проверки, прежде чем считать его полным временем кадра.
После улучшения геометрии разработчик может потратить запас на большее число лучей либо более точную сцену. Тогда качество вырастет при похожем FPS. Это полезный результат, но он отличается от ускорения прежнего кадра. Корректный отчёт фиксирует разрешение, число выборок, геометрию и алгоритмы реконструкции, чтобы не сравнивать незаметно разные объёмы работы.
18. Число лучей и шум связывают качество с временем
Кроме времени GPU существует подача работы со стороны CPU. Если подготовка сцены или команд ограничивает кадровый ритм, ускорение геометрического поиска может почти не изменить наблюдаемый FPS. Синхронизация и ожидание ресурсов также входят в полный маршрут. Для такого случая нужно увидеть, какой компонент действительно задаёт интервал между кадрами, прежде чем объяснять отсутствие выигрыша неисправностью RT-блоков.
Для учебного изображения 1920×1080 зададим две выборки на пиксель и ровно три лучевых запроса на выборку. Получается 12441600 запросов на кадр и 746496000 на секунду при 60 FPS. Это намеренно фиксированный бюджет. Реальные пути могут завершаться раньше, продолжаться вероятностно и порождать другое количество проверок видимости, поэтому число отражений не всегда достаточно для такого подсчёта.
При независимых выборках и конечной дисперсии стандартная ошибка оценки убывает примерно как обратный квадратный корень числа выборок. Увеличение их числа вчетверо в такой модели уменьшает характерный шум вдвое, а не вчетверо. Корреляции, редкие яркие вклады и выбранный метод выборки меняют практический результат. Это статистическая связь, а не гарантия визуального качества сцены.
Денойзер использует дополнительную пространственную и временную информацию, но способен создавать собственные ошибки, следы движения и потерю деталей. Его результат не равен физически рассчитанному большему числу независимых лучей. Поэтому ускорение с изменённой реконструкцией следует проверять на движении и сложных материалах. Более гладкий неподвижный кадр сам по себе не подтверждает эквивалентность изображения.
19. Как проверить пользу нового механизма
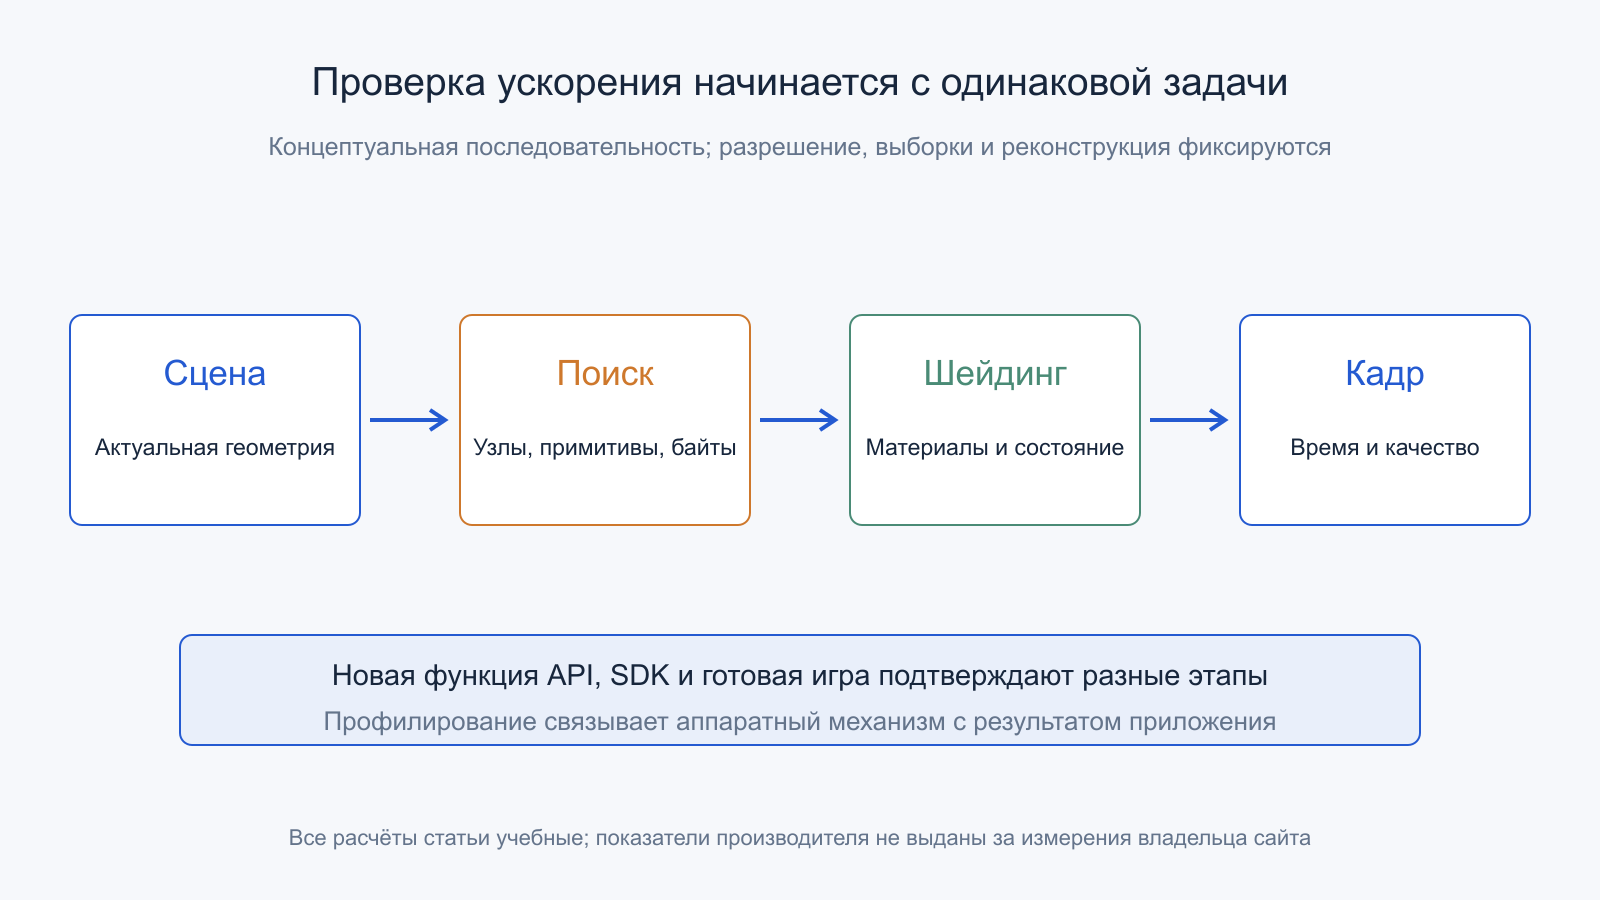
Начинают с одинаковой сцены и явно заданных запросов. Затем отдельно смотрят построение, обновление, число посещений, трафик и шейдинг. Проверяют режимы прозрачности, потребление памяти и корректность границ. Практический материал NVIDIA также подчёркивает необходимость профилирования: универсально выгодной организации для всех сцен нет.
Руководство Khronos различает ray pipeline и ray query: общий ресурс геометрии не делает одинаковым управление шейдерами и планирование. Новые функции API следует проверять по возможностям драйвера. Состояние спецификации, наличие расширения, опубликованный SDK и результат готовой игры представляют разные уровни подтверждения, даже когда используют похожие названия.
Главный эффект аппаратной трассировки состоит в том, что дорогое геометрическое подмножество стало выполняться специализированно. Но дерево, память, материалы и число запросов остаются частью задачи. BVH и RT-блок нельзя оценить отдельно от того, какую работу им предоставляет движок. Проверяемый результат связывает время кадра с качеством, актуальной геометрией и полным маршрутом обработки луча.
Первичные источники
Использованы функциональная спецификация DXR с датой редакции 19 октября 2026 года, разделы Vulkan об обходе и структурах, руководство Khronos, открытая реализация pbrt, архитектурный документ RTX Blackwell, репозиторий RTX Mega Geometry и описание HIP RT. Ссылки приведены в тематических разделах. Алгебра времени, потоков и памяти является самостоятельными учебными моделями и не воспроизводит результаты игровых тестов.