FP8, FP4 и микромасштабирование: как железо считает с малой точностью
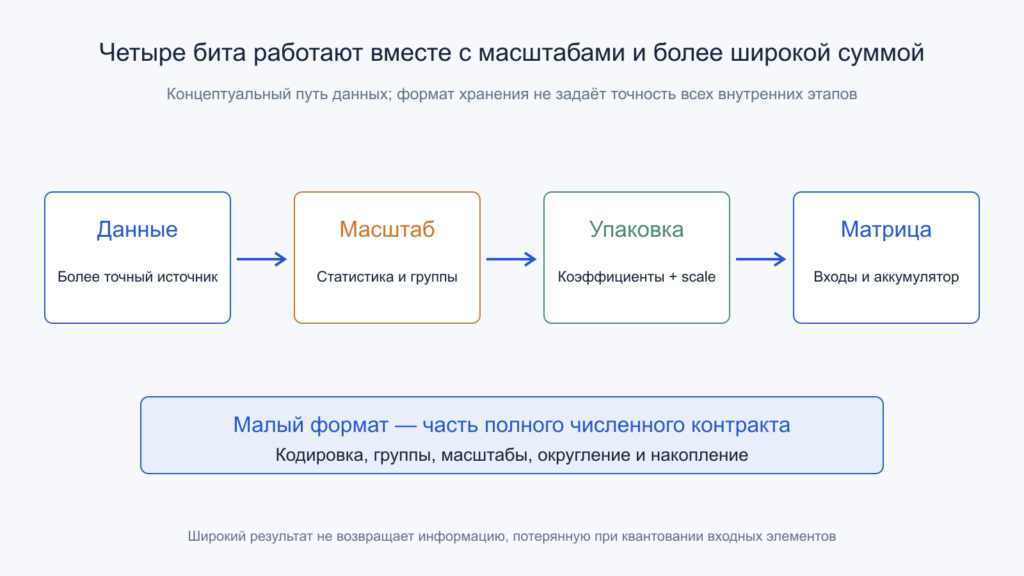
Низкая разрядность входов не определяет точность аккумулятора и результата. Правила контейнера и операции проверяют отдельно. Открыть иллюстрацию в полном размере.
Четырёхбитная арифметика кажется парадоксом: шестнадцати комбинаций мало даже для простого набора измерений, а ускоритель использует их внутри больших нейронных сетей. Секрет не в том, что точность перестала иметь значение. Маленькое число становится частью более широкого представления со знаком, порядком, локальным масштабом и правилами вычисления. Эти части определяют и качество, и реальные расходы памяти.
Разберём FP8, FP4 и микромасштабирование как аппаратный механизм. Отдельно рассмотрены форматы OCP MX и NVFP4, их расположение в памяти и путь к матричному блоку. Срез публичных документов сделан на 26 октября 2026 года. Численные сценарии ниже учебные; они не являются тестами владельца сайта или обещанием одинаковой точности для любых моделей.
Содержание статьи
- 1. Число битов не определяет смысл записанного значения
- 2. E4M3 и E5M2 обменивают точность на диапазон
- 3. E2M1 содержит небольшой набор уровней
- 4. Масштаб является частью представления данных
- 5. OCP MX задаёт масштаб для небольшого блока
- 6. NVFP4 использует другую иерархию масштабов
- 7. Настоящий объём включает метаданные
- 8. Меньшие блоки уменьшают область влияния выброса
- 9. Округление задаёт конкретный результат между уровнями
- 10. Насыщение и потеря малых значений имеют разные причины
- 11. Матричный блок не обязан накапливать в четырёх битах
- 12. Скаляры масштаба можно вынести из суммы только в своей группе
- 13. Транспонирование меняет границы микроблоков
- 14. Квантование само расходует вычисления и память
- 15. Число операций требует явно выбранного соглашения
- 16. Обучение требует сохранять малые обновления
- 17. Что подтверждено в документах и реализациях
- 18. Проверка качества должна видеть редкие и чувствительные случаи
- 19. Как связать формат с реальной выгодой
- Первичные источники
- Читайте также
1. Число битов не определяет смысл записанного значения
Один и тот же байт можно трактовать как целое число, фиксированную точку или плавающую точку. Для правильного восстановления нужны формат и дополнительные параметры. В плавающей точке часть битов задаёт знак, часть — порядок, часть — дробную часть значащего. Доступные значения распределены неравномерно: шаг увеличивается при переходе к более крупному порядку.
Для нормального положительного двоичного значения удобно записать x=2ᵉ·(1+m), где m определяется дробными битами. Скрытая ведущая единица не занимает отдельного бита хранения. В специальных областях правила отличаются: существуют субнормальные значения, нули и, в некоторых форматах, бесконечности либо NaN. Поэтому подсчёт комбинаций без таблицы кодирования не сообщает диапазон чисел.
Малый формат может быть хорошим контейнером для конкретного распределения и плохим для другого. Важно, сколько значений сосредоточено возле нуля, насколько велики выбросы и какие ошибки допустимы последующей операции. Выбор разрядности является выбором численного контракта. Наличие в ускорителе режима FP4 не означает, что любой массив можно безопасно сократить до четырёх бит.
2. E4M3 и E5M2 обменивают точность на диапазон
Исследование FP8 Formats for Deep Learning описывает два восьмибитных представления: знак плюс четыре бита порядка и три дробных в E4M3 либо пять и два в E5M2. Во втором больше возможностей порядка, но грубее сетка внутри одного диапазона. Эти параметры следует читать вместе с правилами специальных значений, а не как уменьшенную копию FP32.
В рассматриваемых кодировках максимальная конечная величина E4M3 равна 448, а E5M2 — 57344. E4M3 не кодирует бесконечность так же, как E5M2; для NaN также действуют свои правила. Существуют варианты FP8 с другими соглашениями, поэтому имя из API и конкретная спецификация важнее общего слова FP8. Переносить таблицу одной кодировки на другую нельзя.
В интервале от единицы до двух три дробных бита дают шаг 0,125, два — 0,25. Это не постоянная абсолютная ошибка всего формата: при другом порядке шаг меняется. Восемь бит можно распределить иначе, но нельзя одновременно получить произвольную точность и произвольный диапазон. Общий масштаб помогает разместить нужные данные в сетке, сохраняя этот компромисс.
3. E2M1 содержит небольшой набор уровней
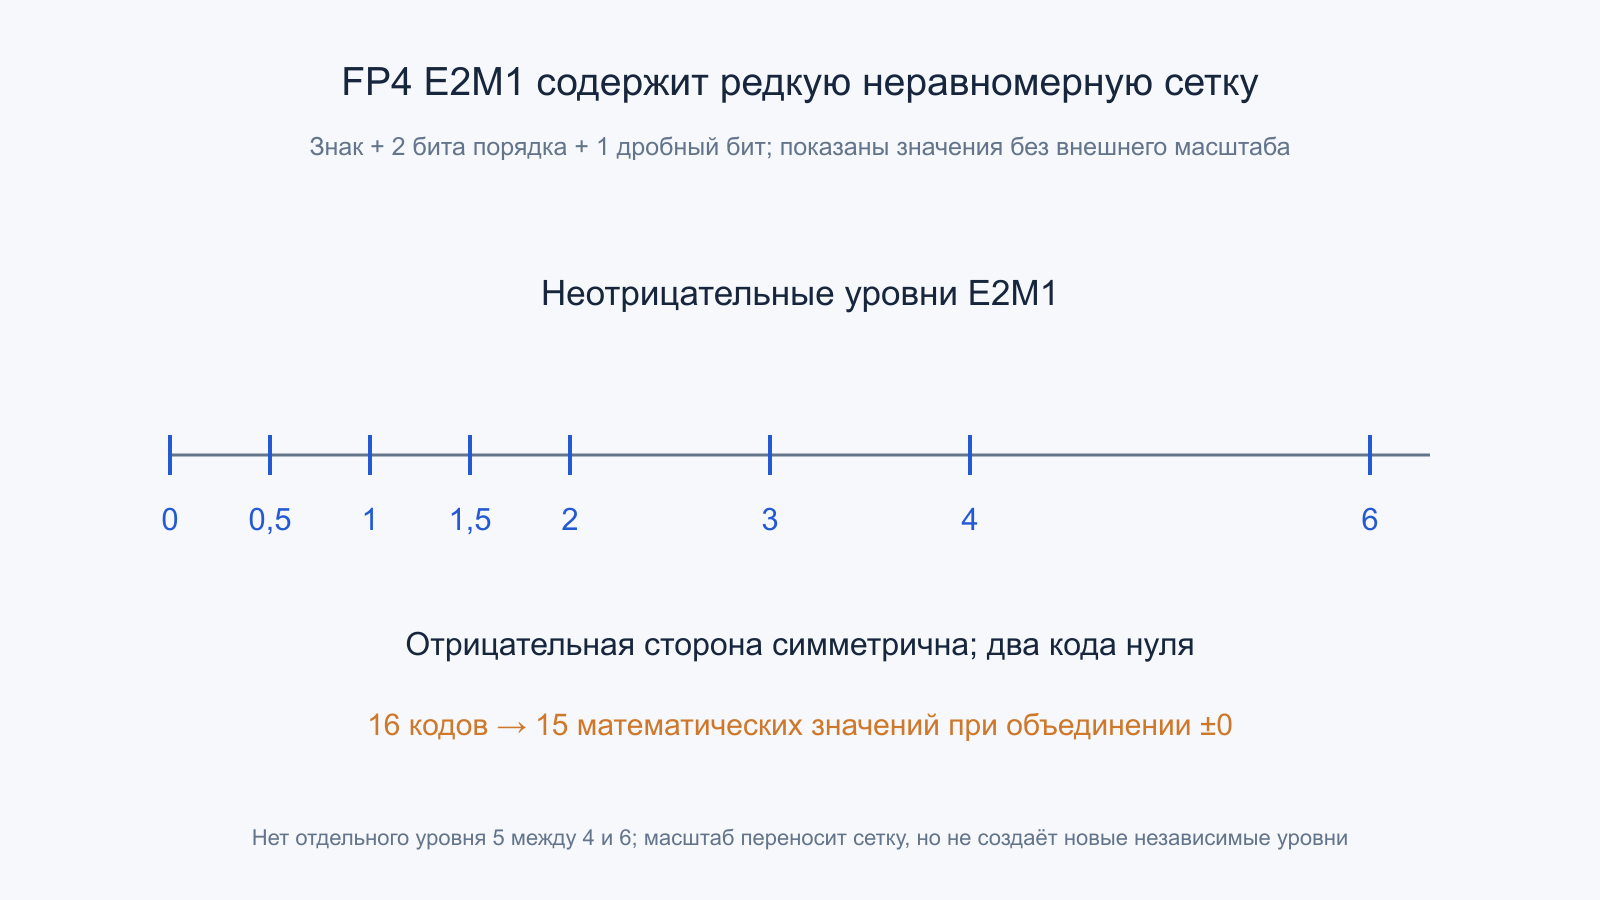
Четырёхбитный E2M1 использует знак, два бита порядка и один дробный бит. Для обсуждаемой кодировки положительные уровни вместе с нулём равны 0; 0,5; 1; 1,5; 2; 3; 4; 6. Отрицательные образуют симметричную сторону. Два знака нуля дают шестнадцать кодов, но пятнадцать различных математических значений, если считать положительный и отрицательный ноль одним числом.
Здесь нет отдельных кодов бесконечности и NaN. Максимальная модульная величина равна шести, минимальная ненулевая — половине. Это сразу показывает, зачем нужен масштаб. Вектор с реальными значениями около тысяч нельзя представить непосредственно, но можно хранить небольшие коэффициенты и отдельно число, умножение на которое возвращает подходящий диапазон.
При этом масштаб не добавляет независимых дробных битов каждому элементу. Отношения соседних уровней остаются грубыми. Между четырьмя и шестью отсутствует пять; между единицей и полутора нет 1,25. Если задача чувствительна именно к таким различиям, одной перенастройкой общего множителя все ошибки убрать нельзя. Требуются другой формат, другое разбиение либо сохранение точности важных операций.
4. Масштаб является частью представления данных
В простейшем случае восстановленное значение имеет вид x̂=s·q, где q хранится в малом формате, а s задаёт масштаб. При кодировании исходное x делят на s и округляют до допустимого q. Некоторые программные интерфейсы хранят обратный множитель, поэтому направление действия нужно проверять. Название scale само по себе не определяет, умножает библиотека или делит.
В учебном примере q=1,5 и s=8 дают восстановленные 12. При s=0,25 тот же четырёхбитный код означает 0,375. Передать только упакованные q без соответствующих масштабов недостаточно. Также получатель должен знать, к каким элементам относится каждый масштаб: ко всему тензору, строке, группе или двумерной плитке.
Выбор s влияет на два разных риска. Слишком маленький масштаб приводит крупные числа к границе формата и насыщению. Слишком большой делает небольшие значения плохо различимыми или нулевыми. Оптимальный выбор зависит от распределения и критерия ошибки. Максимум модуля является полезной статистикой, но минимизация наибольшей ошибки и минимизация средней квадратичной ошибки не всегда дают одинаковый результат.
5. OCP MX задаёт масштаб для небольшого блока
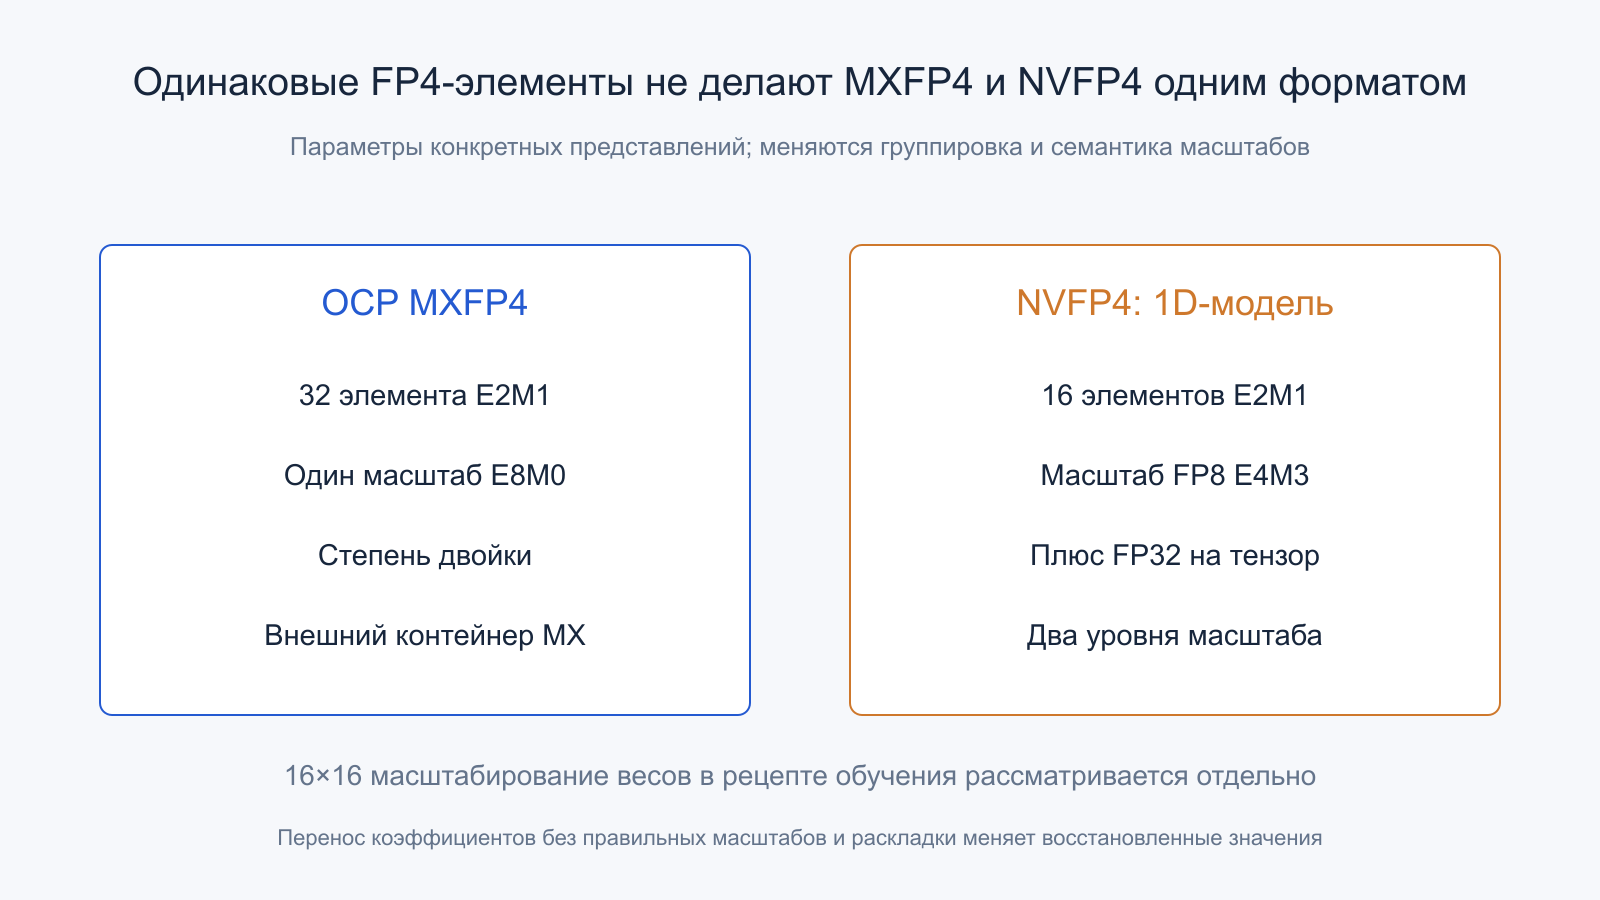
OCP Microscaling Formats версии 1.0 определяет конкретные MXFP8, MXFP6, MXFP4 и MXINT8 с блоком из 32 элементов и восьмибитным масштабом E8M0. MXFP4 использует E2M1 для элементов. Буквы MX сообщают о блочном представлении; обычный скаляр FP4 и блок MXFP4 не являются одинаковой полной структурой хранения.
E8M0 хранит неотрицательный масштаб степенного вида без дробных битов значащего. У него собственные правила диапазона и NaN; это не обычный FP8 E4M3. В результате аппаратуре удобно переносить общий порядок блока. Но доступный набор масштабов грубее набора с дробной частью, что способно оставить часть диапазона элементов неиспользованной.
Спецификация формата не требует поддержки абсолютно всех вариантов каждым устройством. Важны реализованные подмножество и операции. Также описание математической семантики не является универсальным обещанием одного порядка внутреннего накопления на всех процессорах. Для побитовой воспроизводимости нужны дополнительные сведения об инструкции, округлении, аккумуляторе и реализации библиотеки. Совпадение внешнего контейнера ещё не доказывает одинакового результата каждой длинной суммы.
6. NVFP4 использует другую иерархию масштабов
Описание NVFP4 от NVIDIA за июнь 2025 года сочетает E2M1 с локальным масштабом FP8 E4M3 для 16 элементов и дополнительным масштабом FP32 для тензора. При выбранной декодирующей записи x̂=q·sₗ·sₜ. Меньший блок ограничивает область влияния отдельного выброса, а дробная часть локального масштаба позволяет точнее подбирать сетку.
Это не переименование MXFP4. Различаются размер группы, тип масштаба и дополнительный уровень. Нельзя взять E8M0 из MX, заменить заголовок файла на NVFP4 и ожидать правильной интерпретации. Преобразование требует восстановить или переквантовать значения по правилам целевого представления. Оно может добавить ошибку, работу и временную память.
В статье далее для подсчёта хранения используется одномерный вариант 16 элементов на локальный масштаб. Документация Transformer Engine также описывает двумерное масштабирование весов блоками 16×16 в конкретном рецепте обучения. Эти схемы нужно подписывать отдельно: число масштабов на элемент и отношения при транспонировании у них различаются.
7. Настоящий объём включает метаданные
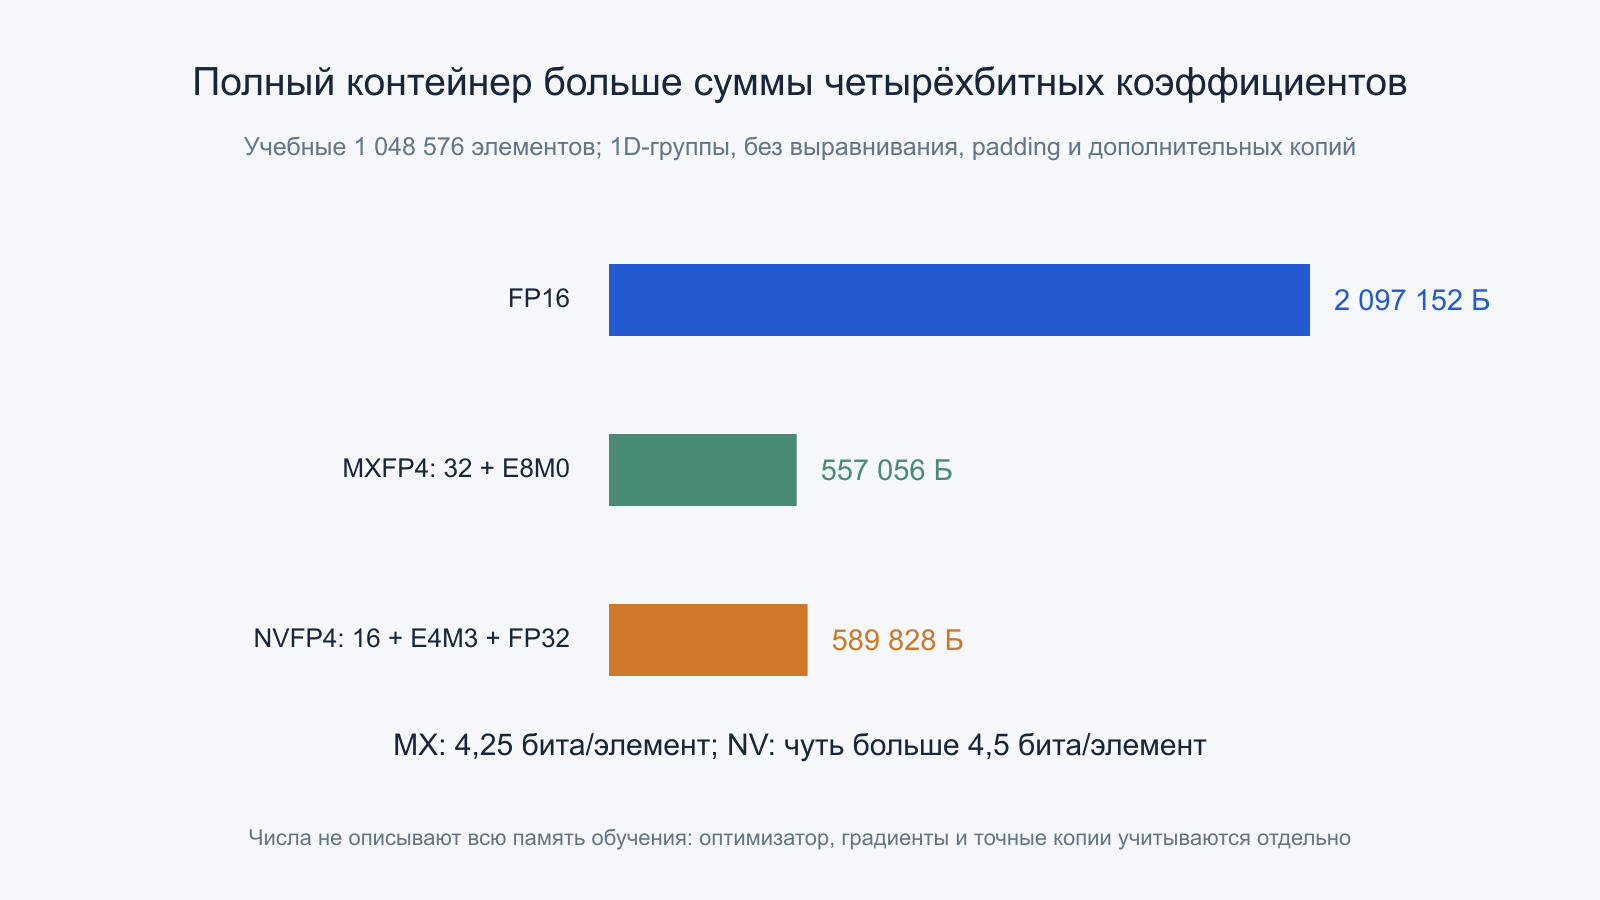
Зададим 1048576 элементов без дополнения и выравнивания. В FP16 они занимают 2097152 байта, то есть 2 МиБ. Голые четырёхбитные коэффициенты требуют 524288 байт. Для MXFP4 добавляются 32768 однобайтных масштабов: всего 557056 байт, или 0,53125 МиБ. Среднее хранение составляет 4,25 бита на элемент, а не ровно четыре.
В одномерной модели NVFP4 нужно 65536 локальных масштабов и один четырёхбайтный глобальный: всего 589828 байт. Это около 0,562504 МиБ и немного больше 4,5 бита на элемент. По сравнению с FP16 уменьшение составляет примерно 3,56 раза, у выбранной MX-модели — 3,76. Это арифметика полезного содержимого представления, без обещания такого же сокращения памяти приложения.
Реальный контейнер может иметь дополнение размеров, специальные раскладки масштабов, служебные поля и дополнительные копии. В обучении остаются градиенты, состояния оптимизатора и другие тензоры. Поэтому модель с четырёхбитными весами не обязательно помещается в четверть прежнего объёма. Сначала определяют, что именно сжато и сколько полных представлений одновременно существует в памяти.
8. Меньшие блоки уменьшают область влияния выброса
Хвост неполного блока тоже требует правил. Если длина измерения не кратна размеру группы, контейнер может дополняться до аппаратно допустимой формы. Заполнитель не должен превращаться в полезные данные матрицы. Для маленьких тензоров относительная цена дополнения бывает заметной, хотя в большом учебном массиве выше она намеренно исключена. Считать такие расходы следует по фактической раскладке.
Если одна группа содержит и большой выброс, и много небольших значений, общий масштаб определяется компромиссом между ними. При сохранении большого значения маленькие могут попасть на слишком редкую сетку. Разделение позволяет спокойной части получить собственный масштаб. Однако границы блоков должны совпасть с устройством данных; перестановка элементов меняет соседство и иногда численный результат квантования.
Рассмотрим учебную группу с максимумом 4,5 и значением 1,1. При масштабе 1 ближайшие E2M1 дают 4 и 1, ошибки −0,5 и −0,1. При масштабе 0,75 максимум соответствует q=6 точно, а 1,1 округляется к q=1,5 и восстанавливается как 1,125, с ошибкой +0,025. Оба масштаба выбраны вручную для объяснения, без моделирования автоматического рецепта.
Такой пример показывает возможность более подходящей сетки, но не доказывает превосходство каждого меньшего блока. Дополнительные масштабы занимают место и требуют обработки. Иное распределение может почти не выиграть. Честная оценка сравнивает ошибку и полное время при одинаковой задаче, а не выбирает только выгодный отдельный вектор.
9. Округление задаёт конкретный результат между уровнями
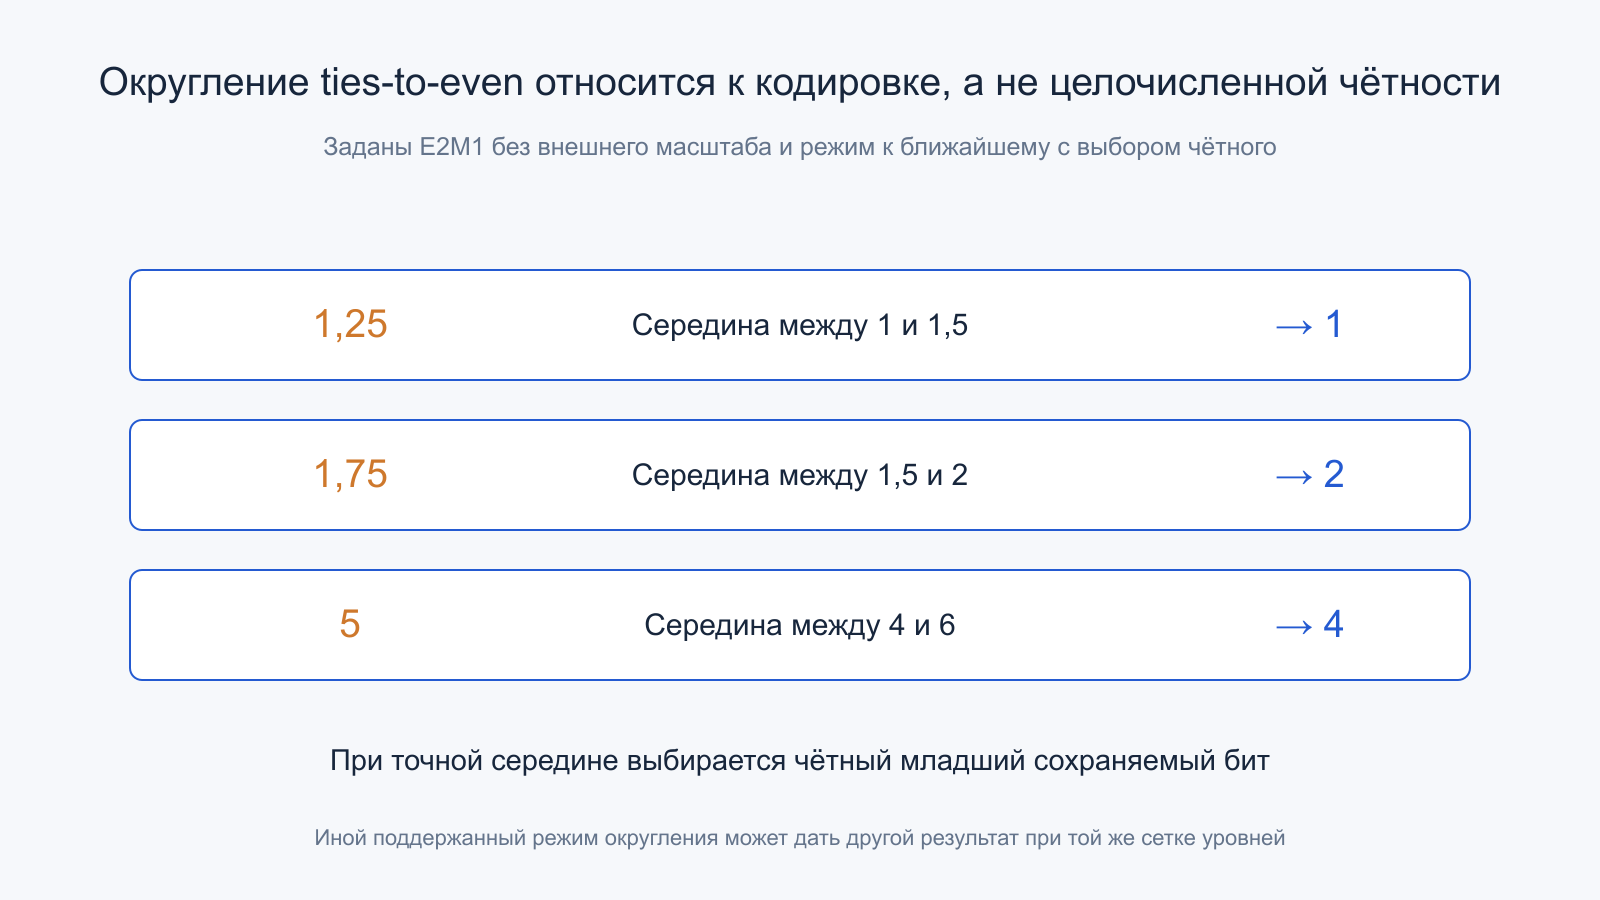
Для демонстрации используем округление к ближайшему с выбором чётного при точной середине, roundTiesToEven. «Чётный» здесь относится к младшему сохраняемому биту кодировки, а не к тому, является ли математическое значение целым чётным числом. Это особенно легко перепутать в сетке, где соседями становятся 1 и 1,5 либо 4 и 6.
Без масштаба 1,25 находится посередине между 1 и 1,5 и округляется к 1. Значение 1,75 между 1,5 и 2 округляется к 2. Значение 5 между 4 и 6 округляется к 4. Эти результаты следуют из выбранной кодировки E2M1 и указанного режима. Другой поддержанный режим способен дать другой результат, не меняя сам список представимых уровней.
Округление масштабированного числа происходит после соответствующего преобразования. Если сначала округлить исходное значение, а потом поделить, получится другая операция. Для проверки важно зафиксировать последовательность и точность промежуточных шагов. Малые примеры с точными серединами полезны именно тем, что отличают нарушение контракта от обычной допустимой погрешности низкой разрядности.
10. Насыщение и потеря малых значений имеют разные причины
Когда модуль нормализованного числа превосходит доступный диапазон, преобразование должно следовать выбранному правилу обработки переполнения. Насыщение ограничивает величину краем сетки, сохраняя знак. Это не то же самое, что округление внутри диапазона. Ошибка крупного выброса при насыщении может быть значительно больше половины соседнего шага.
На другом конце возникают нулевые результаты: маленькое число оказывается ближе к нулю, чем к минимальному ненулевому уровню. При масштабе 1 граница между 0 и 0,5 находится в 0,25; точный результат на границе зависит от режима округления. После увеличения масштаба этот промежуток в исходных единицах становится шире. Тем самым защита выброса способна подавить много небольших элементов.
Диагностика должна различать долю насыщенных, долю нулевых и распределение ошибок относительно исходных величин. Средняя абсолютная ошибка может выглядеть небольшой при большом числе нулей, хотя исчезли важные редкие обновления. Также нужны правила исходных NaN и бесконечностей. Отсутствие их отдельных кодов в FP4 не означает, что аварийное значение обязано незаметно стать корректным числом.
11. Матричный блок не обязан накапливать в четырёх битах
Формат входов, внутреннего произведения, аккумулятора и результата может различаться. Матричная операция читает малые коэффициенты и масштабы, формирует произведения и суммирует их в предусмотренной более широкой форме. После этого результат может сохраняться в BF16, FP32 либо снова квантоваться. Поэтому фраза «вся модель считает в FP4» часто скрывает смешанную арифметику.
cuBLAS 12.8 отдельно описывает входные типы, масштабирование и вычислительные режимы. Из наличия узкого входа нельзя вывести точность каждого внутреннего этапа. Для воспроизведения нужны конкретные параметры операции и поддержанная архитектура. Широкий выход не восстанавливает информацию, уже потерянную при округлении входного массива.
В длинной сумме важны взаимное сокращение слагаемых и порядок сложения. Два больших близких результата способны оставить маленькую разность, чувствительную к ошибкам. Даже FP32-аккумулятор не делает эту разность точной относительно исходных FP32-входов, если они были предварительно изменены. Правильный эталон должен явно указывать, сравниваются ли исходные значения или уже декодированные низкоразрядные.
12. Скаляры масштаба можно вынести из суммы только в своей группе
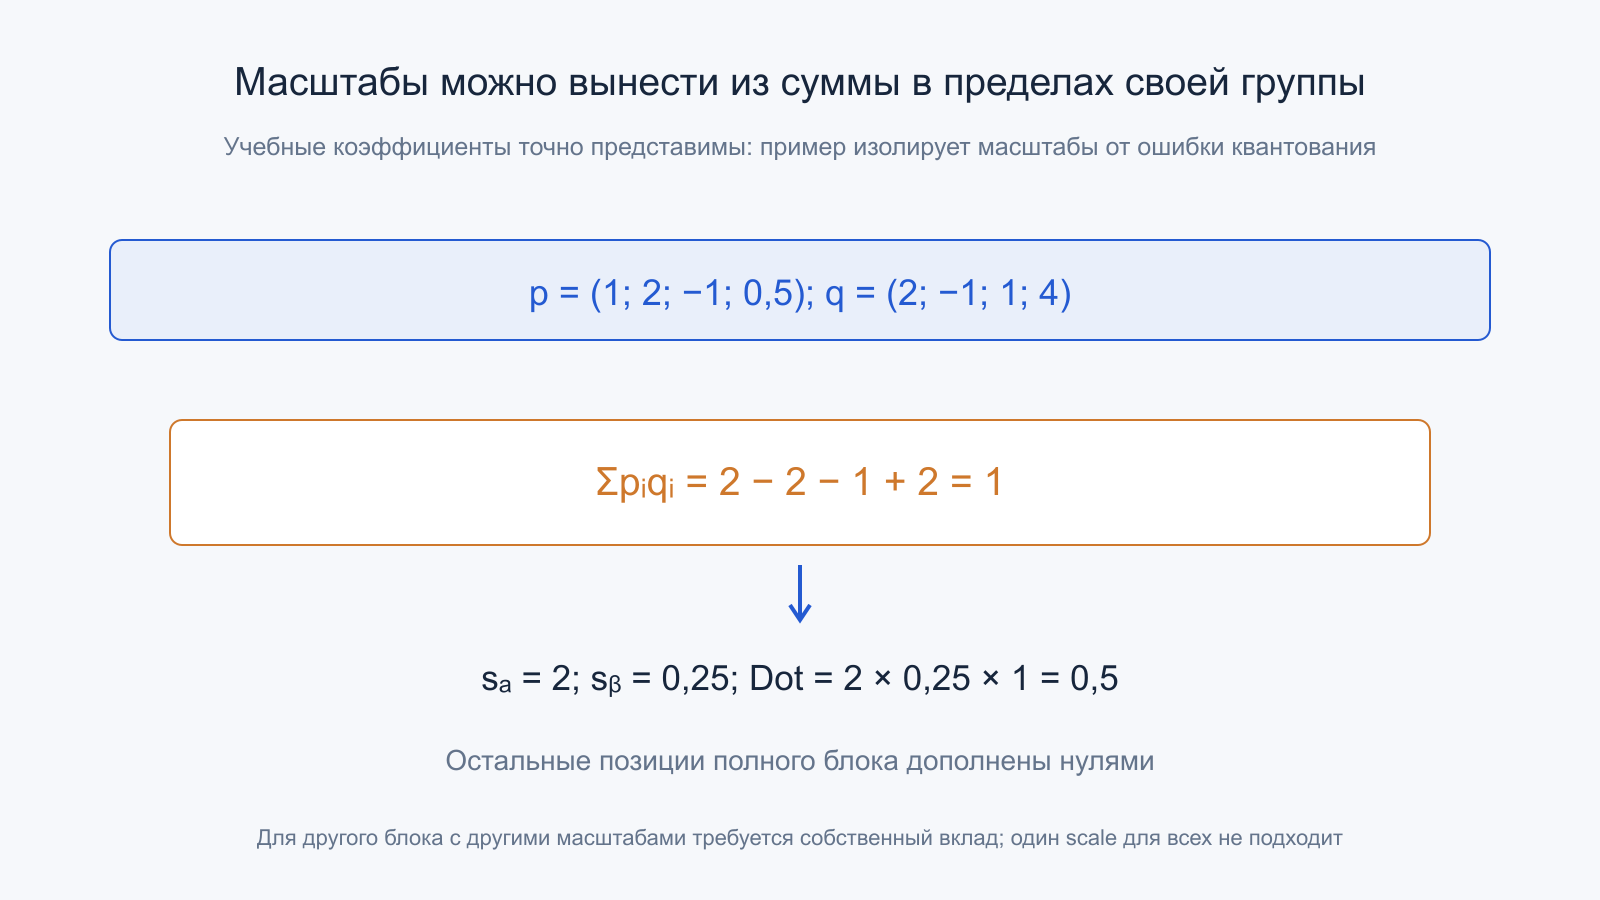
Для блока Aᵢ=sₐpᵢ и Bᵢ=sᵦqᵢ математически сумма произведений равна sₐsᵦ·Σpᵢqᵢ. Это позволяет разделить малые элементы и общие множители. Но если следующий блок имеет другой масштаб, его вклад нужно обработать отдельно. Вынести один произвольно выбранный масштаб из всей матрицы означало бы изменить числа.
Возьмём четыре ненулевых коэффициента p=(1;2;−1;0,5) и q=(2;−1;1;4), остальные позиции блока дополним нулями. Сумма малых произведений равна 2−2−1+2=1. При sₐ=2 и sᵦ=0,25 восстановленный скалярный результат равен 0,5. Все выбранные коэффициенты представимы в E2M1; пример изолирует действие масштабов от ошибки квантования.
В аппаратуре реальные блоки должны поступать в нужном порядке вместе с правильными масштабами. Ошибка индекса масштаба способна дать внешне правдоподобный численный результат, поэтому одного отсутствия NaN недостаточно для проверки. Полезны тесты с намеренно разными масштабами соседних групп. Они проверяют адресацию и раскладку, а не повторяют уже известную арифметику одинаковых единиц.
13. Транспонирование меняет границы микроблоков
Группы вдоль строк исходной матрицы после транспонирования не обязательно совпадают с группами нового требуемого направления. Просто переставить четырёхбитные коэффициенты недостаточно, если новая операция ожидает другие совместные масштабы. Возможны хранение нескольких квантованных представлений или повторное квантование из более точного источника. Оба решения имеют цену памяти и времени.
Двумерное разбиение помогает некоторым операциям использовать согласованное представление весов в прямом и обратном проходах. Однако оно иначе группирует выбросы и меняет число масштабов. Конкретный рецепт Transformer Engine следует читать как сочетание формата и алгоритма, а не как обязательное свойство любого файла NVFP4. У активаций и градиентов могут сохраняться одномерные группы.
Дополнительно аппаратная раскладка иногда переставляет сами масштабы для удобного параллельного чтения. Такой swizzle не является новым математическим масштабом, но определяет адресацию контейнера. Неверная интерпретация может смешать значения разных групп. Поэтому перенос между библиотеками должен учитывать упаковку, направление группировки, дополнение размеров и порядок байтов, даже если список численных форматов совпадает.
14. Квантование само расходует вычисления и память
Упаковка по два четырёхбитных элемента в байт дополнительно требует согласовать их порядок. Номер младшей половины байта и направление чтения определяются контейнером. Отдельный элемент не обязан иметь собственный байтовый адрес. Это влияет на загрузки, изменение небольших участков и совместимость инструментов. Распаковать правильные коэффициенты важнее, чем просто получить ожидаемую длину файла.
Чтобы получить динамический масштаб, необходимо определить статистику массива, затем преобразовать и упаковать элементы. В зависимости от реализации чтения могут объединяться, но работа не исчезает. Для маленькой матрицы запуск дополнительного ядра способен занять больше времени, чем сэкономит ускоренный GEMM. Для большого повторно используемого веса расходы проще распределить на много операций.
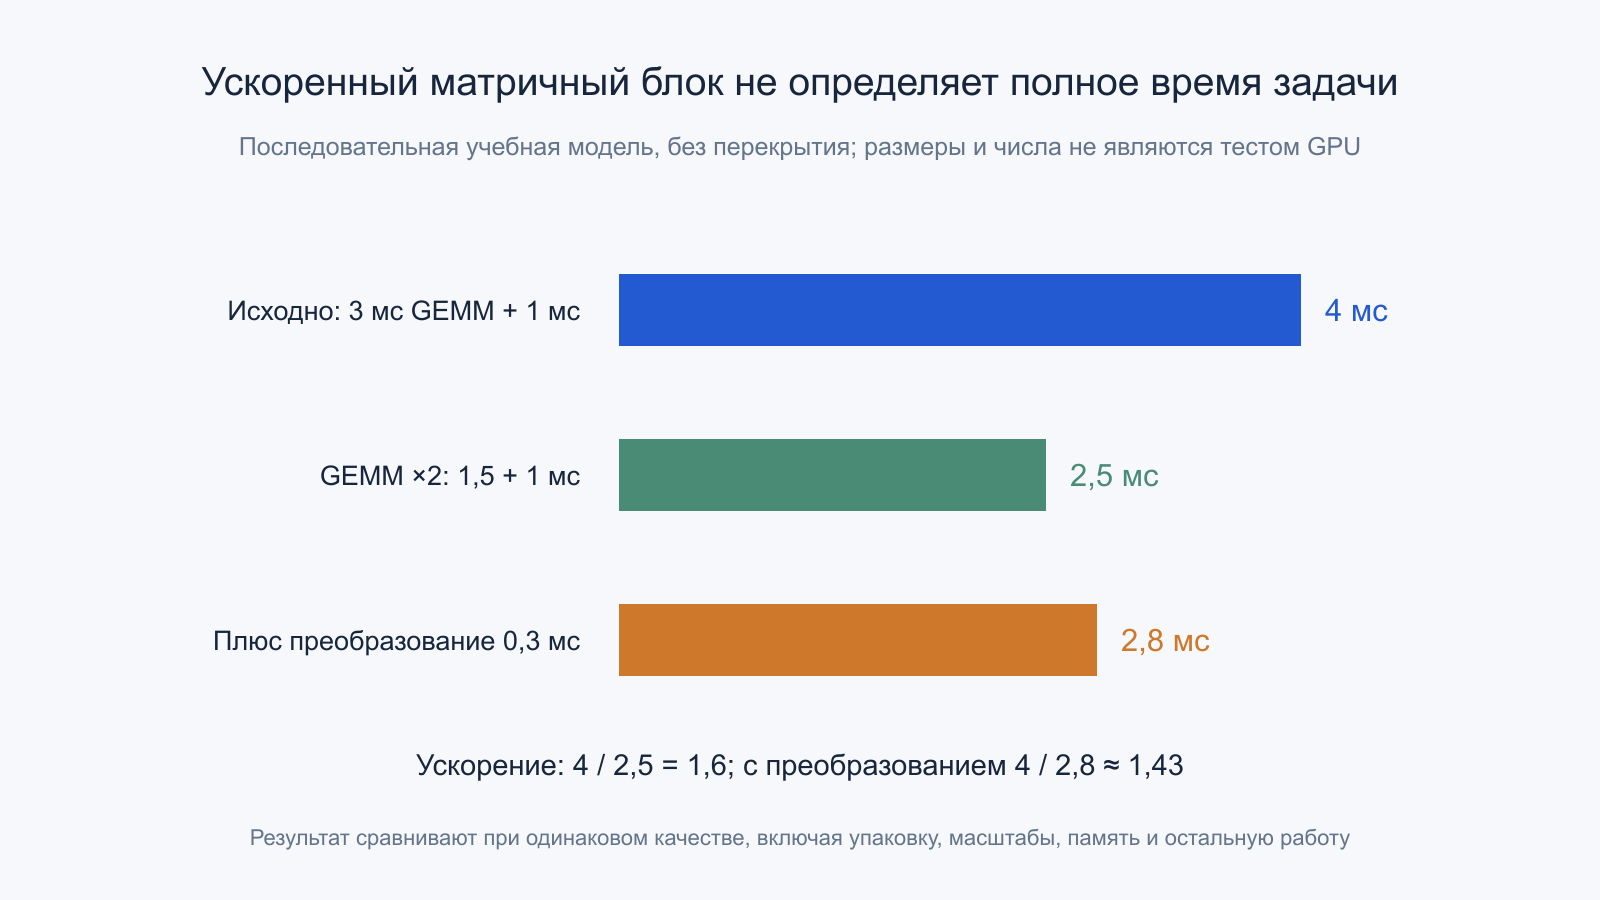
В учебной задаче матричная часть занимает 3 мс, остальная работа — 1 мс: всего 4 мс. Если матричная часть ускоряется вдвое, получается 2,5 мс и ускорение 1,6 раза. Добавим 0,3 мс отдельного преобразования: уже 2,8 мс и около 1,43 раза. Это последовательная модель, без предположения о перекрытии этапов или реальном конкретном GPU.
При частой смене активаций цена динамического преобразования повторяется. При распределённой работе статистика глобального масштаба может требовать согласования между участниками. Передавать квантованные данные без одинакового понимания масштаба нельзя. Поэтому преимущество малых элементов на линии связи оценивают вместе с метаданными, синхронизацией и точкой, где данные снова становятся пригодны для вычисления.
15. Число операций требует явно выбранного соглашения
Для матриц M×K и K×N часто используют оценку 2MNK операций, считая умножение и сложение двумя действиями. При M=N=K=1024 получается 2147483648, около 2,147 миллиарда операций. Это условное соглашение для производительности GEMM, а не число независимых инструкций процессора. При иной границе подсчёта цифра в TOPS изменится.
Удвоение рекламной пропускной способности для разреженного режима также требует подходящего рисунка разреженности и его поддержки. Плотная матрица не становится разреженной из-за малого формата. Нельзя сравнивать плотный FP8 одного устройства с разреженным FP4 другого и приписывать всё отношение только разрядности. В таблице должны совпадать режим, операция, условия и учёт масштабов.
Время полезной работы дополнительно ограничивается памятью, формой матриц и доступным параллелизмом. Небольшие либо неудобные размеры могут использовать лишь часть матричных блоков. Рост арифметического пика не гарантирует такой же скорости декодирования одного токена или обработки малого пакета. Нужно измерить весь нужный маршрут с фиксированным качеством результата, а не только максимально выгодную искусственную матрицу.
16. Обучение требует сохранять малые обновления
При выводе важна точность готовой функции, при обучении ещё и накопление большого числа небольших изменений. Округление каждого слишком малого обновления к нулю способно остановить полезную динамику. Поэтому смешанные рецепты сохраняют часть состояния в более высокой точности, выбирают чувствительные операции отдельно и оценивают не один проход, а сходимость на длительном горизонте.
Стохастическое округление использует вероятностный выбор соседних уровней. В учебном случае число 1,2 между 1 и 1,5 можно округлять вверх с вероятностью 0,4 и вниз с вероятностью 0,6: математическое ожидание будет 1,2. Отдельный результат остаётся приближённым. Отсутствие смещения в такой локальной модели не доказывает автоматически сходимость любой сложной сети.
Рецепты также могут применять преобразования распределения перед квантованием. Их корректность зависит от того, где выполнено преобразование и как согласована последующая операция. Нельзя добавить случайное преобразование одному операнду и ожидать сохранения исходного произведения. Для инженерного сравнения фиксируют весь рецепт, точные библиотеки, случайные состояния и качество на одинаковом объёме обучения.
17. Что подтверждено в документах и реализациях
OCP MX 1.0 опубликована в сентябре 2023 года, а исследование микромасштабирования оценивает конкретные варианты и задачи. Это разные виды свидетельств: нормативное представление и экспериментальная работа. Аппаратная поддержка требует отдельного процессора и программного пути. Существование спецификации само по себе не превращает каждый старый ускоритель в устройство с нативным MXFP4.
Документы NVIDIA связывают NVFP4 с матричными блоками Blackwell и конкретными библиотечными режимами. Материал от 8 июня 2026 года описывает рецепт JAX/MaxText, включая выбор операций MLP и сохранение более высокой точности в attention. Это измерения автора документа на названной конфигурации, а не универсальное обещание качества четырёхбитного обучения.
Показ исследовательского результата, наличие API и готовый квантованный checkpoint подтверждают разные этапы. Для практического вывода проверяют точную модель GPU, поддержанные операции, библиотеку и формат исходных весов. Качественный результат одного семейства моделей не следует переносить на другую задачу без оценки её метрик. Совместимость контейнера и численная пригодность алгоритма остаются разными проверками.
18. Проверка качества должна видеть редкие и чувствительные случаи
Средняя ошибка реконструкции тензора полезна, но не заменяет оценку задачи. Некоторые направления ошибки влияют сильнее других; редкий большой промах может почти не изменить среднее. Для языковой модели также важны выбранные данные и длина контекста, для другой системы — собственные чувствительные режимы. Сравнение требует одинакового входа и заранее определённого критерия приемлемости.
На численном уровне полезно отдельно видеть насыщение, обнуление, изменение масштаба и ошибку после матричного накопления. Это позволяет отличить потерю информации при упаковке от проблемы адресации либо нестабильного алгоритма. Для специальных значений и точных границ округления нужны отдельные маленькие проверки. Случайный большой массив редко попадает во все важные крайние случаи.
Неопределённость также относится к эксперименту: случайность обучения, разброс времени и прогрев системы влияют на выводы. Один удачный проход недостаточен для заявления об эквивалентности. Полезный отчёт показывает выбранный допуск, распределение результатов и затраты на достижение качества. Тогда экономия битов становится проверяемым инженерным компромиссом, а не только красивой подписью ускорителя.
19. Как связать формат с реальной выгодой
Правильная цепочка начинается с точной семантики: какие значения кодируются, какие масштабы используются и как выполняется округление. Затем считают полный контейнер, дополнительные представления и преобразования. После этого проверяют аппаратную поддержку матричной операции и ограничение приложения. Нарушение любого звена способно уничтожить ожидаемое преимущество, даже если отдельный блок выдаёт высокий пик.
Выгода может проявиться как меньший объём весов, более крупный пакет, снижение передачи по памяти либо сокращение времени вычислений. Это разные результаты. При переносе ограничения на другой участок дальнейшее уменьшение разрядности может перестать ускорять задачу. При этом сохранённый объём памяти иногда остаётся ценным, даже если время почти не изменилось.
FP8, MXFP4 и NVFP4 полезны именно как согласование математического распределения с устройством памяти и матричного тракта. Масштабы возвращают диапазон, но не отменяют грубую сетку малых коэффициентов. Более широкий аккумулятор помогает сумме, но не восстанавливает потерянные входы. Понимание этих границ позволяет оценивать ускорение вместе с качеством и полными расходами системы.
Первичные источники
Использованы спецификация OCP MX 1.0, исследования Microscaling Data Formats for Deep Learning и FP8 Formats for Deep Learning, описание NVFP4, документация cuBLAS и Transformer Engine, а также материал NVIDIA о JAX/MaxText 2026 года. Ссылки на документы приведены рядом с соответствующими механизмами. Учебные расчёты объёма, округления и времени не являются результатами этих экспериментов.