Видеокарта изнутри: вычислительные блоки, VRAM, пропускная способность и время кадра
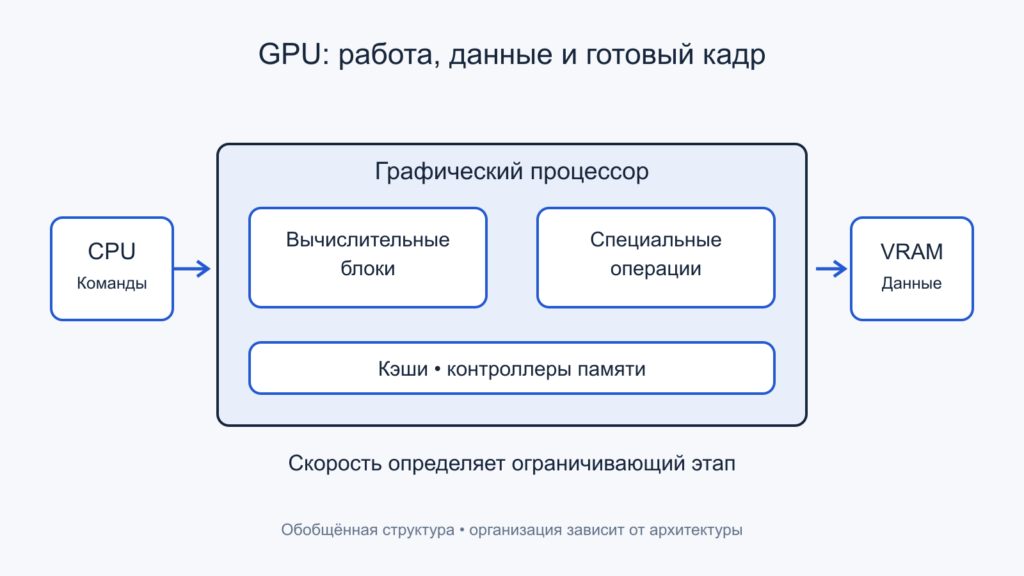
Видеокарта объединяет вычислительные и специализированные блоки, кэши и внешнюю память; скорость зависит от их совместной работы. Открыть иллюстрацию в полном размере.
У двух видеокарт может совпадать объём памяти, а поведение в одной сцене будет совершенно разным. Одна быстро считает освещение, но задерживается на обращениях к данным; другая уверенно держит среднюю частоту кадров, однако периодически останавливается при подгрузке ресурсов. Даже высокая загрузка GPU не объясняет, какой именно участок ограничивает результат. Видеокарта объединяет вычислительную архитектуру, несколько видов памяти, специализированные блоки, связь с процессором и систему управления мощностью. Понять её работу можно, если проследить путь одного кадра и отдельно оценить количество работы, движение данных и сроки её завершения.
Содержание статьи
- Что находится между командой программы и готовым изображением
- Вычислительные блоки: почему нельзя сравнивать только их количество
- Текстуры, растеризация, трассировка и матричные операции
- Иерархия памяти: где действительно находятся данные
- VRAM: ёмкость, полоса и задержка отвечают на разные вопросы
- Почему PCI Express и видеопамять нельзя подменять друг другом
- Время кадра: одна средняя величина скрывает разные ощущения
- Как CPU и GPU делят работу: конвейер вместо сложения
- Мощность и частота: производительность должна удерживаться
- Как оценивать результат без ловушек в показателях
- Первичные источники и границы применения
- Читайте также
Что находится между командой программы и готовым изображением
В дискретной видеокарте GPU получает команды через интерфейс с центральным процессором, обычно PCI Express. Видеопамять расположена рядом с GPU и подключена к его контроллерам памяти. Между ними работают внутренние шины и кэши. На плате также находятся преобразователи питания, микросхемы служебной памяти, цепи тактирования и видеовыходы. Охлаждение определяет, какую рабочую точку эта система сможет поддерживать продолжительное время. Число вентиляторов само по себе ничего не говорит о том, сколько полезной работы выполняется за секунду.
Встроенный GPU устроен иначе на уровне системы: часто он использует общую с CPU оперативную память. Это меняет бюджет пропускной способности и обмен данными, но не отменяет вычислительные блоки, кэши и обработку команд. Поэтому выражение «видеопамять» нужно читать в контексте архитектуры. Выделенная область общей RAM и локальные микросхемы GDDR на дискретной плате не становятся одинаковыми только потому, что операционная система показывает их объём в гигабайтах.
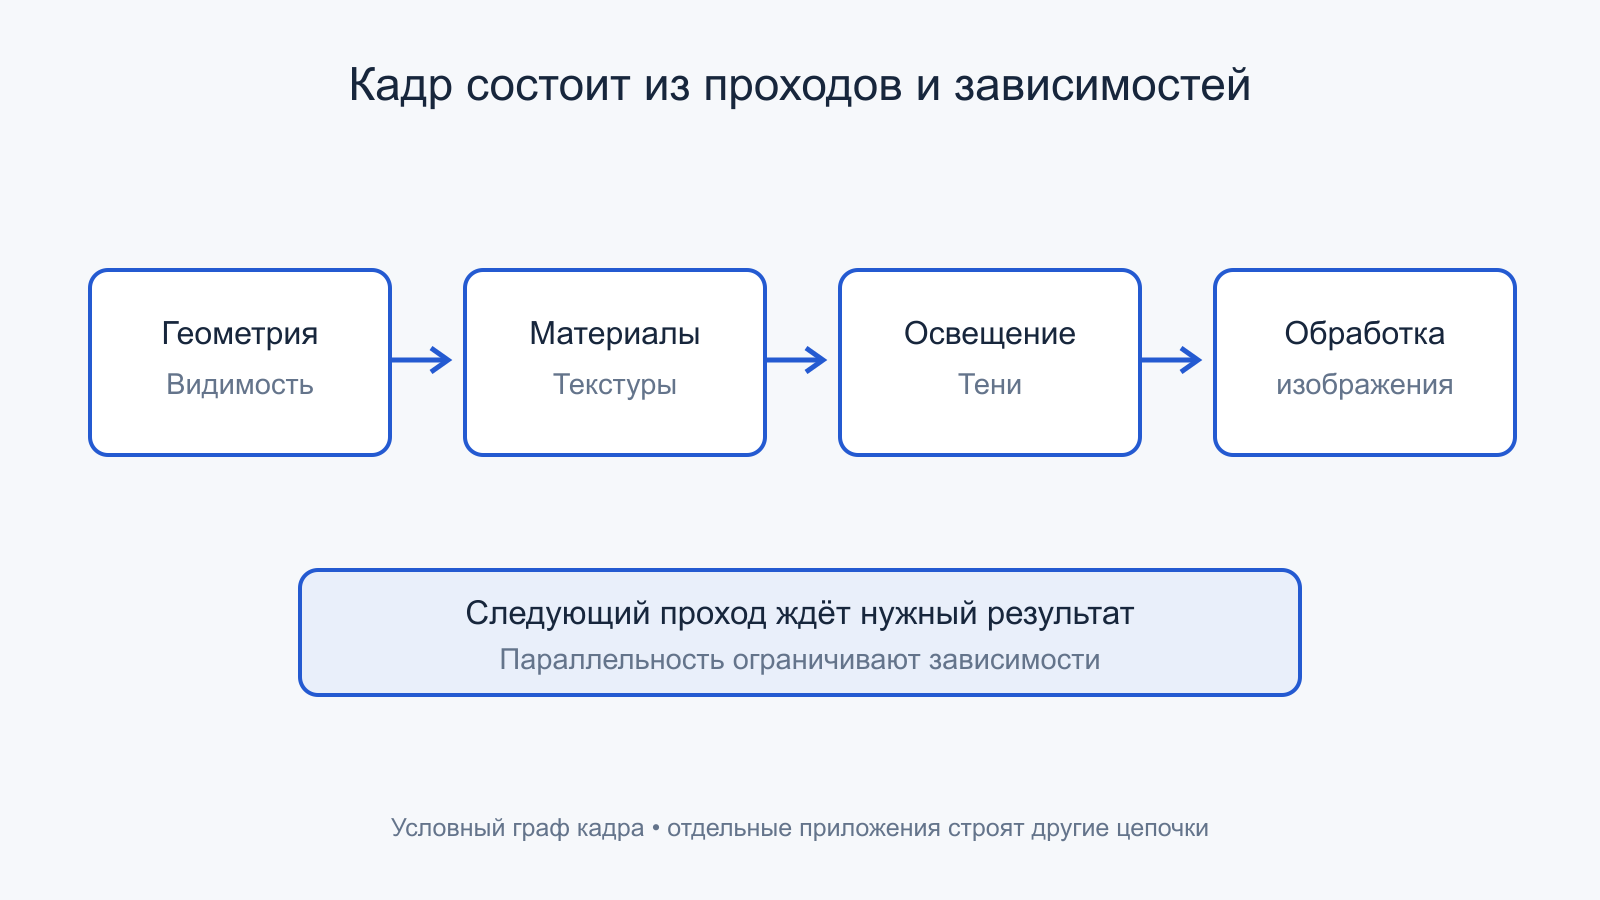
Графическая программа описывает ресурсы и работу через API. Драйвер и среда исполнения преобразуют этот поток в задания для устройства. В типичной сцене нужны подготовка геометрии, определение видимых поверхностей, выборки текстур, вычисление освещения и несколько проходов обработки изображения. Между проходами существуют зависимости. Следующая операция иногда не может начаться, пока предыдущая не записала результат. Возможность выполнять задания параллельно полезна только там, где эти зависимости и доступные ресурсы это допускают.
Вычислительные блоки: почему нельзя сравнивать только их количество
GPU рассчитан на большое количество похожих операций над разными элементами данных. Для изображения такими элементами могут быть вершины, пиксели, образцы освещения или фрагменты текстуры. Исполнительные устройства объединены в более крупные блоки со своими планировщиками, регистрами и локальными ресурсами. У NVIDIA один из таких уровней называется Streaming Multiprocessor, у AMD используются собственные уровни Compute Unit и Workgroup Processor. Названия и внутренняя организация зависят от семейства. Перевод рекламного числа «ядер» одной фирмы в число «ядер» другой без анализа архитектуры не работает.
Число арифметических операций в секунду также требует расшифровки. Нужно знать формат данных, вид инструкции, возможность одновременно выполнять разные операции и условия расчёта частоты. Производительность FP32, FP16, целочисленных инструкций и матричных операций относится к разным задачам. Пиковое значение предполагает достаточно независимых инструкций, подходящие данные и отсутствие ожидания памяти. Сложное ветвление, синхронизация или неподходящая точность могут оставить значительную часть теоретических возможностей невостребованной.
Группы потоков и расхождение ветвей
В CUDA потоки выполняются группами по 32, называемыми warp. Это конкретная модель NVIDIA, а не универсальное название для всех GPU. В архитектурах AMD говорят о wavefront или wave; поддерживаемая ширина и выбор режима зависят от поколения и программы. Потоки одной группы могут обрабатывать разные данные, но совместное исполнение выгоднее, когда они проходят похожую последовательность инструкций. Если часть элементов требует одного длинного расчёта, а другая — другого, аппаратуре приходится обслуживать обе ветви с разными активными участниками.
Представим учебный алгоритм, где половине элементов нужен дорогой эффект, а второй половине он не нужен. Условие в коде выглядит экономным, но выигрыш зависит от того, как эти элементы распределены по группам. Если внутри каждой группы они перемешаны, потенциально выполняется дорогая ветвь при неполной полезной активности. Если данные сгруппированы по сходной работе, результат может измениться. Из этого не следует, что любое ветвление вредно: пропуск действительно большого объёма ненужных вычислений нередко окупает накладные расходы.
Occupancy — наличие готовых групп, а не процент полезной скорости
Когда одна группа ждёт данные, планировщик может выдать инструкции другой. Occupancy характеризует, сколько групп или потоков размещено относительно аппаратного предела выбранной архитектуры. Доступность регистров, локальной общей памяти и другие лимиты ограничивают это размещение. Высокое значение помогает скрывать некоторые задержки, но не создаёт дополнительной пропускной способности там, где канал уже занят. Документация NVIDIA прямо отделяет рост occupancy от гарантированного роста производительности.
Попытка любой ценой разместить больше потоков может даже ухудшить расчёт: например, сокращение доступных регистров заставит чаще обращаться к более далёкой памяти. Для обычного пользователя это означает, что график «занятости» отдельного ресурса нельзя превращать в оценку качества видеокарты. Для разработчика правильный вопрос звучит иначе: какие ожидания уменьшаются после изменения конфигурации и сократилось ли время нужного прохода? Метрика полезна как объяснение результата, когда результат уже измерен.
Текстуры, растеризация, трассировка и матричные операции
Не вся графика выполняется одинаковыми арифметическими блоками. Текстурные устройства помогают выбирать и фильтровать данные. Растеризация связывает геометрические примитивы с покрываемыми ими участками изображения. Операции глубины, смешивания и записи результатов имеют собственные пути и ограничения. Если программа создаёт огромное количество мелких примитивов, узкое место может находиться раньше тяжёлого пиксельного шейдера. Если каждый пиксель требует множества выборок, арифметический резерв сам по себе ситуацию не исправит.
Аппаратная помощь трассировке ускоряет определённые операции обхода структур сцены и поиска пересечений; конкретная граница между специализированным блоком и шейдерами различается. Полный эффект включает подготовку структур ускорения, создание лучей, обработку материалов и устранение шума. Поэтому отношение числа блоков трассировки двух архитектур не даёт готового отношения скорости игры. Изменение геометрии и материалов способно иначе загрузить тот же набор аппаратных ресурсов.
Матричные ускорители полезны для алгоритмов, которые удаётся выразить поддерживаемыми матричными операциями и форматами. В игровых технологиях они могут участвовать в восстановлении изображения или других вычислениях. Они не заменяют все этапы кадра и не увеличивают автоматически скорость обычного шейдера. Названия Tensor Core и аналоги других производителей нужно связывать с конкретной архитектурой и программным путём. Для оценки важна работа приложения с этими возможностями, включая накладные расходы и качество результата.
Иерархия памяти: где действительно находятся данные
Ближе всего к исполнению находятся регистры. Далее расположены локальные для вычислительного блока ресурсы, различные уровни кэша и общая видеопамять. Точная организация меняется, однако общий смысл сохраняется: повторное использование уже полученных данных обходится дешевле нового обращения к внешним микросхемам. Большой кэш помогает, если нужные данные в него попадают и успевают использоваться повторно. Размер кэша без сведений о характере обращений не описывает его эффективность.
Важна и пространственная близость запросов. Если соседние потоки читают соседние элементы, контроллер может обслуживать их более компактными транзакциями. Если каждый поток требует небольшой фрагмент из далёкой области, передача полезных байтов расходует больше ресурсов. Поэтому одна задача достигает высокой доли номинальной полосы памяти, а другая остаётся значительно ниже. Разницу нельзя сразу объяснять плохими микросхемами: причиной может быть сам порядок работы с данными.
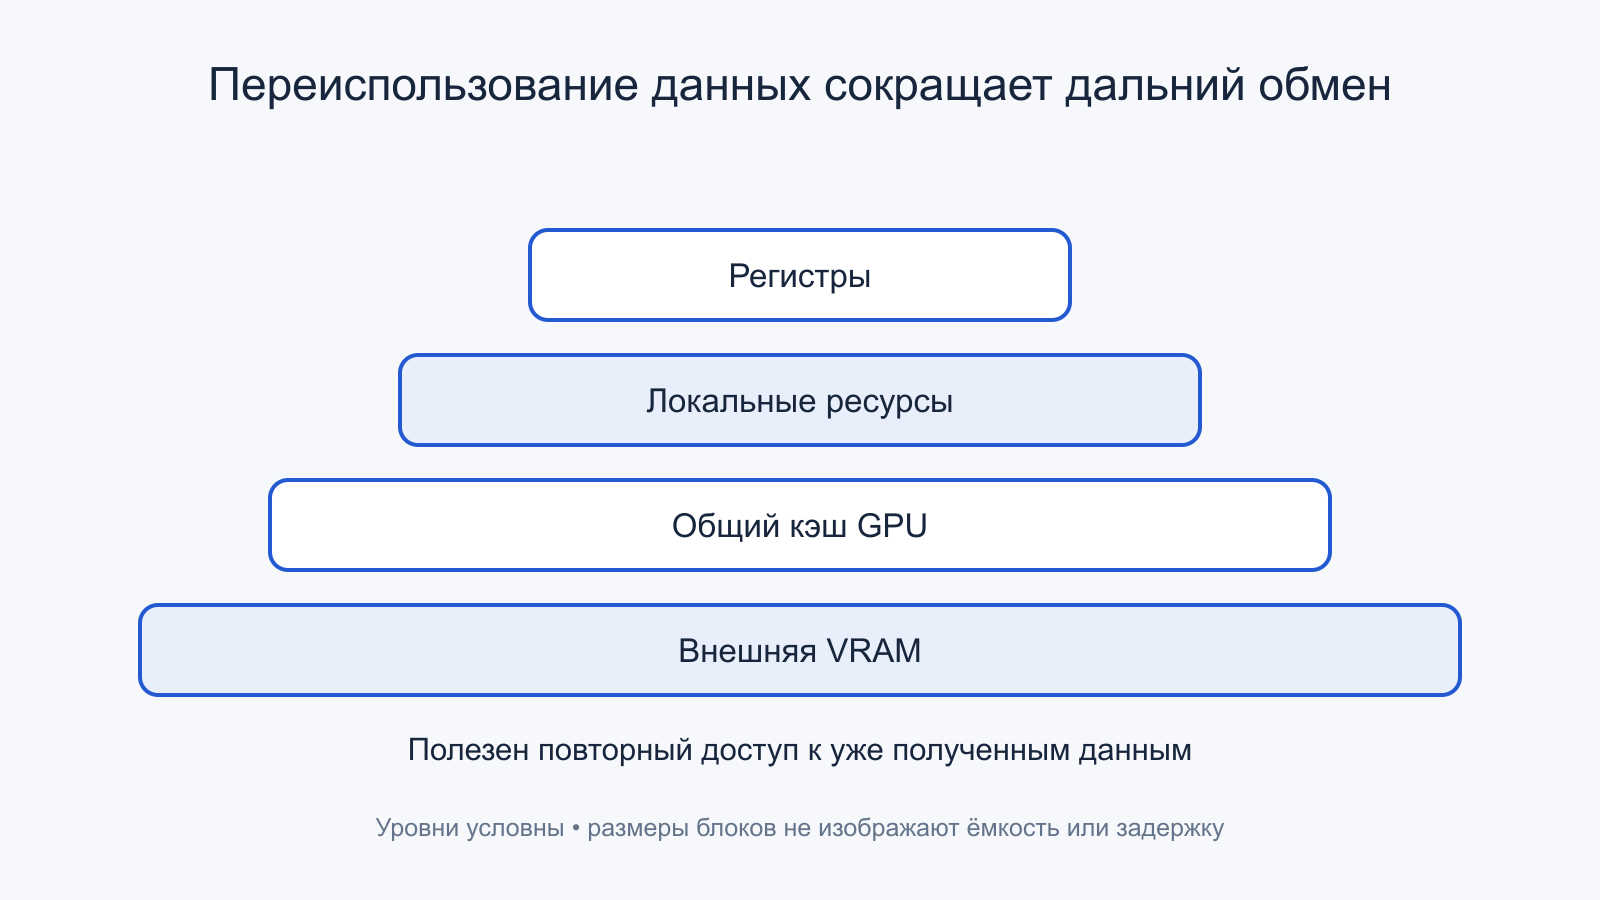
Сжатие некоторых графических поверхностей способно уменьшать внешний трафик. Оно зависит от типа ресурса, содержимого и поддерживаемых режимов, поэтому «эффективную полосу» нельзя считать постоянным множителем для всех приложений. Кэш также не превращает узкую внешнюю шину в широкую при любой нагрузке. Для последовательного чтения большого массива с минимальным повторным использованием результат будет отличаться от сцены, где многие обращения приходятся на одни и те же данные.
VRAM: ёмкость, полоса и задержка отвечают на разные вопросы
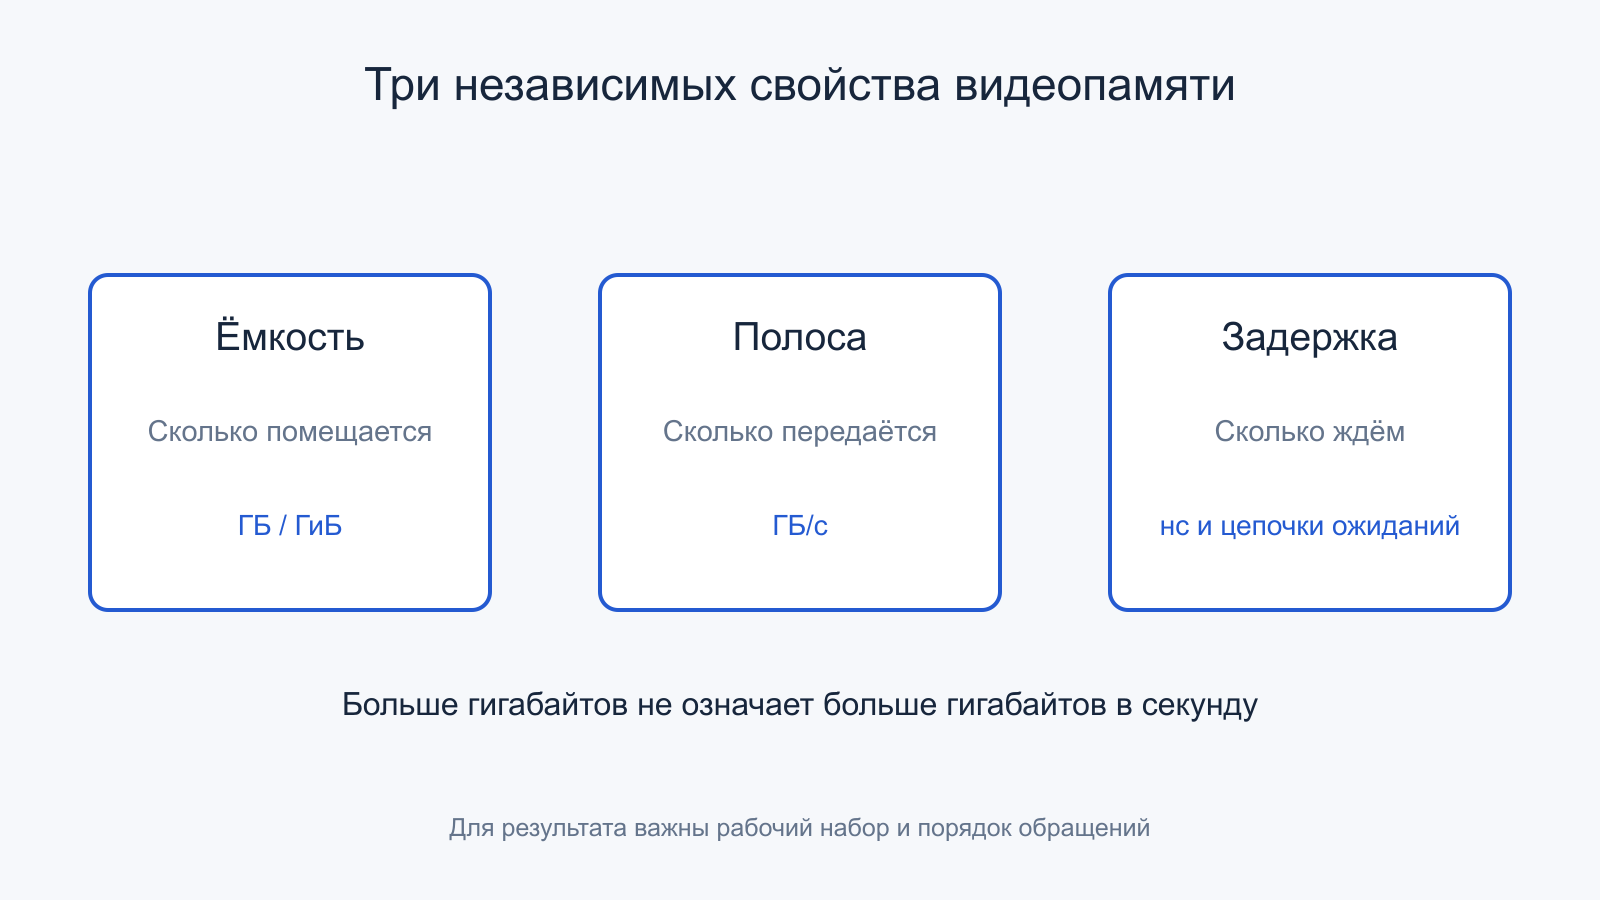
Ёмкость показывает, какой объём данных может одновременно размещаться в локальной видеопамяти. Полоса показывает потенциальный объём передачи за время. Задержка описывает, сколько приходится ждать результат отдельного обращения или цепочки зависимых обращений. Дополнительные гигабайты не сокращают автоматически ожидание и не ускоряют передачу уже помещающегося набора ресурсов. Зато достаточная ёмкость помогает избежать дорогих перемещений и перераспределения, если приложение действительно приближается к доступному бюджету.
Видеопамять нужна не только текстурам. В ней размещаются геометрия, буферы глубины и цвета, временные поверхности, структуры трассировки, код и служебные данные. Один несжатый буфер 3840 × 2160 с четырьмя байтами на пиксель занимает 33 177 600 байт, около 31,6 МиБ. Это полезный масштаб, но не расчёт потребления всей игры: буферов несколько, форматы различаются, используются дополнительные проходы и резервирование. Нельзя умножить один экранный буфер на частоту и получить весь трафик GPU.
Показатель выделенной памяти в утилите тоже требует осторожности. Приложение может заранее зарезервировать ресурс, который не участвует в текущем кадре. Операционная система управляет бюджетами размещения; документированный DXGI-бюджет отличается по смыслу от физической ёмкости на коробке. Превышение доступного бюджета способно ухудшать поведение, но само число «занято почти всё» ещё не доказывает, что конкретная остановка вызвана нехваткой VRAM. Нужны изменение настроек, временная связь и повторяемость эффекта.
Учебный расчёт пропускной способности
Пусть условная память передаёт 18 Гбит/с на контакт данных, а суммарная ширина интерфейса равна 256 бит. Теоретическая полоса составляет 18 × 256 / 8 = 576 ГБ/с в десятичных единицах. Условный вариант с той же скоростью и шиной 128 бит даёт 288 ГБ/с. Это расчёт номинального интерфейса. Он не учитывает командные паузы, характер запросов, долю записей, конфликты и кэш. Указанную эффективную скорость передачи нельзя ещё раз умножать на два из-за знакомого слова DDR.
Предположим теперь, что один проход должен передать 2 ГБ данных и не может переиспользовать их из кэша. При реально достигнутых 400 ГБ/с нижняя оценка времени передачи равна 5 мс. Удвоение числа арифметических устройств не уберёт эти 5 мс, если объём трафика и достигнутая полоса остались прежними. И наоборот: если проход выполняет много вычислений над небольшим набором уже загруженных данных, расширение внешнего канала может дать слабый эффект. Это два разных ограничения одной системы.
Сколько вычислений приходится на один переданный байт
Для приближённого анализа удобно посчитать арифметическую интенсивность: отношение числа операций к объёму данных, пришедших из рассматриваемого уровня памяти. Возьмём условный GPU с пиком 20 триллионов операций в секунду и достигнутой внешней полосой 400 ГБ/с. Их отношение равно 50 операций на байт. Задача с интенсивностью 10 операций на байт сможет получить из такого канала данные лишь для 4 триллионов операций в секунду. Уже здесь видно, почему указанные 20 триллионов не будут достигнуты, даже если программа содержит достаточно параллельных элементов.
У задачи с интенсивностью 100 операций на байт внешняя память допускает более высокий вычислительный темп, чем арифметический пик выбранного условного GPU. Тогда вероятнее другое ограничение. Это модель верхних границ, а не предсказатель времени приложения: она не учитывает задержки зависимых запросов, отдельные виды инструкций, ветвления и обмен внутри кэшей. Счёт операций также обязан совпадать с методикой заявленного пика. Если умножение со сложением считается двумя операциями в одной величине и одной в другой, сравнение теряет смысл.
Полезный приём оптимизации — уменьшить число обращений, сохранив промежуточный результат ближе к вычислениям. Но такое переиспользование занимает регистры или общие локальные ресурсы и может уменьшить число одновременно размещённых групп. Получается инженерный компромисс: экономия внешнего трафика ценой другого ресурса. Поэтому попытка судить об эффективности по единственному счётчику постоянно приводит к противоречиям. Хороший результат возникает, когда конкретная программа согласует свои потребности с несколькими аппаратными пределами одновременно.
Почему PCI Express и видеопамять нельзя подменять друг другом
PCI Express связывает дискретный GPU с остальной системой, а локальный интерфейс памяти обслуживает внутреннюю работу с VRAM. Их полосы, задержки и назначения различаются. Текстуры обычно передают на видеокарту заранее и затем используют много раз. Если приходится постоянно подтягивать большие ресурсы из RAM, стоимость обмена становится заметнее. Даже когда весь рабочий набор доступен через отображение адресов, физическое расположение данных продолжает иметь значение.
Resizable BAR меняет возможности адресного доступа CPU к видеопамяти, но не добавляет контакты шине GDDR и не делает PCIe локальной памятью GPU. Эффект зависит от приложения, платформы и управления ресурсами. Сходным образом более быстрое поколение PCIe не гарантирует заметного изменения во всех играх: если обмен мал относительно вычислений, его ускорение почти не влияет на кадр. Проверять нужно фактически согласованные поколение и ширину линии под нагрузкой, учитывая штатные режимы энергосбережения в простое.
Время кадра: одна средняя величина скрывает разные ощущения
Для равномерной последовательности 60 кадров/с период равен примерно 16,67 мс, 120 кадров/с — 8,33 мс, 144 кадров/с — 6,94 мс. Но средняя частота не требует равенства интервалов. В учебной последовательности из 100 кадров 99 интервалов занимают по 8 мс, а один — 80 мс. Всего получается 872 мс, то есть около 114,7 кадра/с. Среднее число выглядит высоким, хотя один длинный интервал остаётся хорошо заметной остановкой.
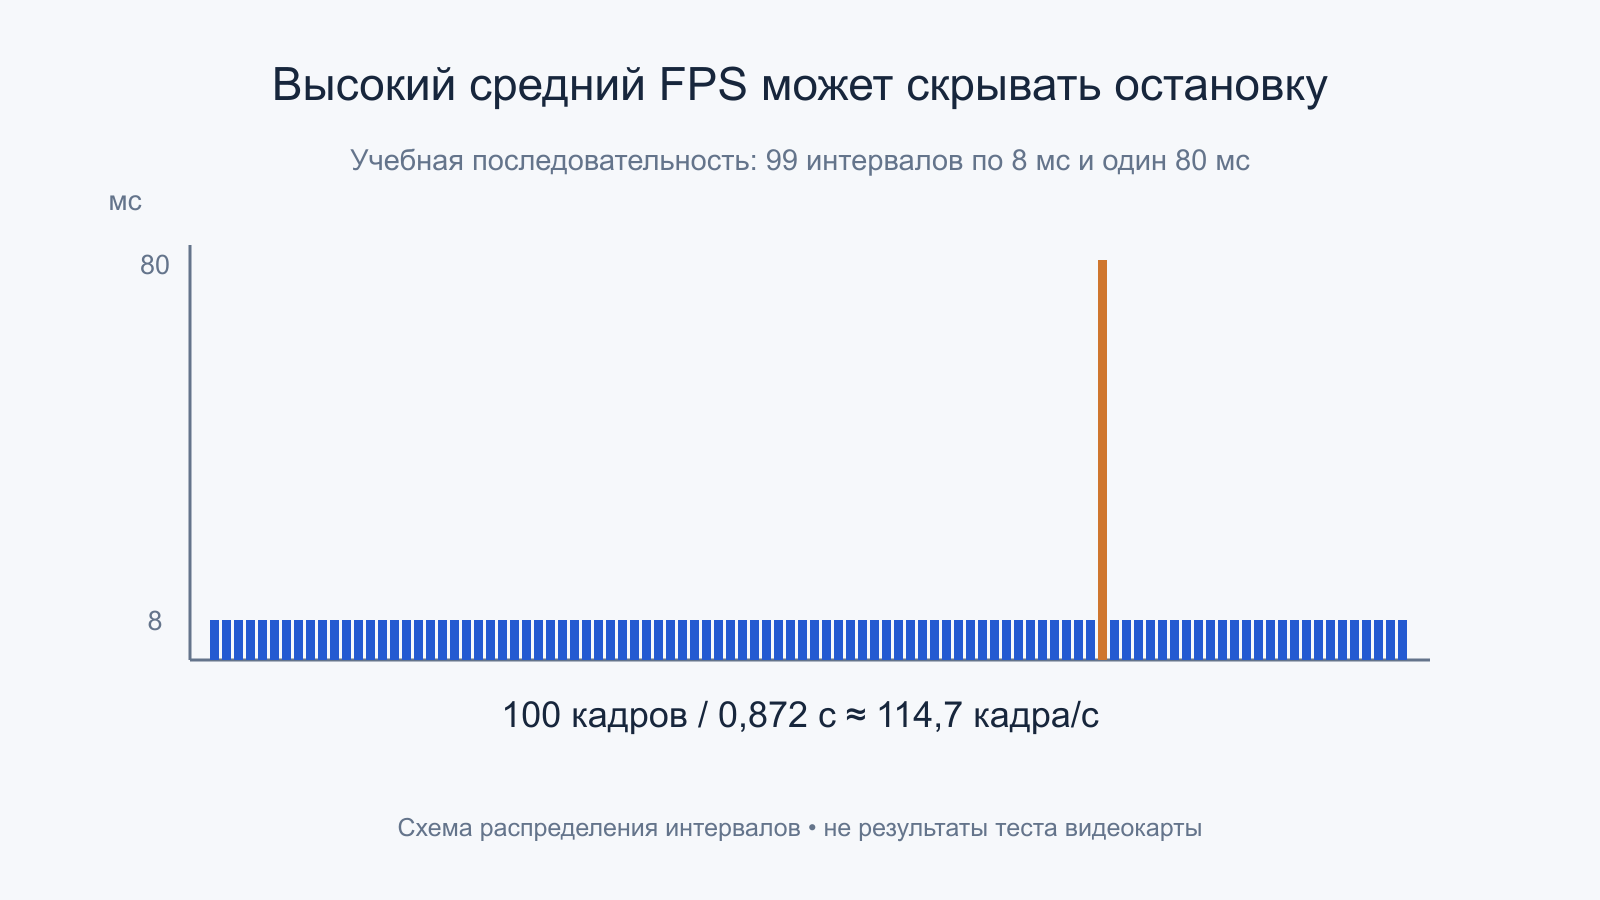
Показатели 1% low и процентили нужны для описания медленной части распределения. Они не равны минимальному мгновенному FPS. Методика 1% low может использовать среднее по выбранной доле наиболее длинных интервалов либо иное правило конкретной программы; обратная величина 99-го процентиля времени кадра тоже не обязана совпадать с ней. В отчёте следует назвать определение. Чем короче запись, тем сильнее несколько событий меняют статистику, поэтому точные сотые доли без повторов создают ложное ощущение достоверности.
Необходимо также понимать точку измерения. Интервалы отправки кадров приложением, завершения работы GPU и фактической смены изображения относятся к разным событиям. Очередь может накопить готовые кадры, синхронизация — изменить моменты их показа, а дисплей — обновляться по собственному расписанию. PresentMon документирует несколько временных характеристик CPU, GPU и вывода; доступность и точность отдельных метрик зависят от пути представления. Одна строка FPS не описывает весь тракт от действия пользователя до света.
Как CPU и GPU делят работу: конвейер вместо сложения
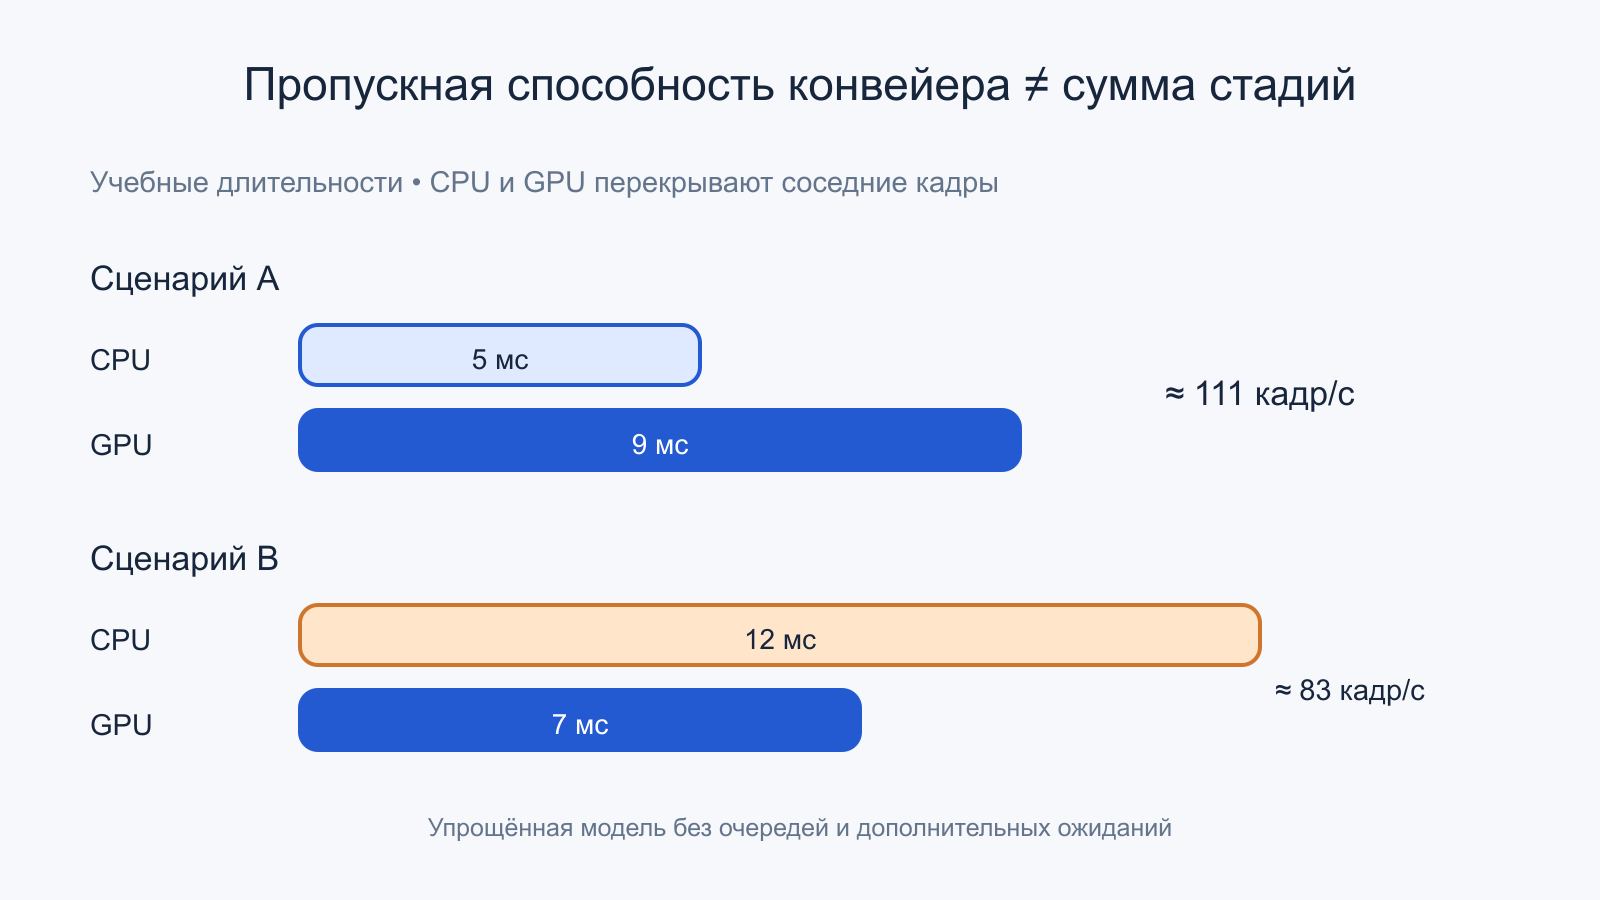
В упрощённой установившейся системе CPU может готовить следующий кадр, пока GPU завершает предыдущий. Если подготовка требует 5 мс, а исполнение GPU — 9 мс, пропускная способность конвейера ограничивается примерно более длинной стадией, а не простой суммой 14 мс. При этом задержка конкретного кадра действительно включает несколько последовательных участков и ожидания. Производительность потока и задержка одного результата связаны, но это разные величины.
Если сократить подготовку с 5 до 3 мс при неизменных 9 мс GPU, частота может почти не измениться. Если, наоборот, CPU требует 12 мс, а GPU 7 мс, снижение разрешения способно освободить графический процессор ещё сильнее без заметного прироста кадров. Это учебная модель: реальные кадры имеют зависимости, очереди, фоновые задачи и переменную стоимость. Тем не менее она объясняет, почему невысокая общая загрузка многоядерного CPU не исключает ограничения главным потоком.
Генерация промежуточных кадров добавляет ещё один слой. Она формирует дополнительные изображения из доступных кадров и сопутствующих данных, но не означает такую же частоту новых расчётов игровой логики и обработки ввода. Нужно отдельно указывать частоту исходного рендеринга и вывода, состояние восстановления изображения, качество и задержку. Документация NVIDIA для интеграции Frame Generation отдельно рассматривает отправку и показ. Сравнивать два результата только по итоговому FPS при разных режимах генерации некорректно.
Бюджет кадра помогает оценивать изменения по существу
Для цели 120 кадров/с весь повторяющийся интервал должен укладываться примерно в 8,33 мс. Если условный обязательный проход занимает 3 мс, а остальные зависимые этапы вместе требуют ещё 7 мс и не перекрываются, ускорение только первого прохода вдвое сократит итог с 10 до 8,5 мс. Получится заметный выигрыш, однако заданный бюджет всё ещё превышен. Назвать это «ускорением GPU вдвое» было бы ошибкой: вдвое ускорен отдельный участок, а не вся работа.
Та же логика относится к приложениям вне игр. Монтаж может ждать декодирование исходного формата, моделирование — подготовку сцены на CPU, вычисление — копирование исходных массивов. Программа способна хорошо загружать GPU внутри короткой стадии и большую часть общего времени проводить в другом месте. Поэтому полезно различать скорость отдельного ядра вычисления и время выполнения задачи от начала до готового результата. Только второй показатель отвечает на вопрос, насколько быстрее закончится пользовательская работа при заданном качестве.
Мощность и частота: производительность должна удерживаться
Рабочая частота GPU меняется вместе с нагрузкой, температурой, доступным питанием и правилами управления устройством. Два прохода могут иметь разные частоты при одинаковой формальной загрузке: один интенсивнее переключает вычислительные узлы, другой чаще ждёт данные. Указанная повышенная частота не является обещанием постоянного значения в каждой задаче. Полезнее сравнивать устойчивое поведение после выхода системы на характерный для данного сценария режим.
Телеметрия мощности также должна иметь определённую границу. Мощность кристалла, всей платы и потребление компьютера из розетки различаются. Деление FPS на разные показатели мощности даёт несопоставимые результаты. Для инженерного сравнения можно оценить энергию на выполненную работу, однако условия качества, длительность и состав системы должны совпадать. Краткий разгон перед достижением температурного равновесия не описывает длительный рендеринг, а игровая нагрузка не заменяет все вычислительные приложения.
Как оценивать результат без ловушек в показателях
Сначала задают практическую цель: равномерное движение в конкретном режиме, завершение вычисления за нужное время или обработка проекта без постоянных перемещений ресурсов. Затем фиксируют разрешение, качество, API, версию приложения и драйвера, лимит кадров, синхронизацию, восстановление изображения и генерацию кадров. Одна и та же надпись «высокие настройки» после обновления приложения может означать другой набор эффектов. Сравнение имеет смысл только при совпадающей задаче.
- Записать повторяемый участок, отдельно отметив первый запуск с подготовкой кэшей и последующие проходы.
- Рассмотреть график интервалов и медленную часть распределения, сохранив исходные данные и определение метрик.
- Поменять один фактор: разрешение для пиксельной нагрузки, качество текстур для бюджета ресурсов, конкретный тяжёлый эффект для соответствующего прохода.
- Сопоставить изменение времени с активностью GPU, частотой, мощностью и памятью, учитывая доступность телеметрии.
- Повторить наблюдение и отделить устойчивый эффект от компиляции, подгрузки, фоновой работы и случайного события.
Сильное ускорение после снижения разрешения поддерживает гипотезу ограничения графической частью, но само по себе не различает полосу памяти и арифметику. Исчезновение остановок после снижения качества текстур поддерживает связь с ресурсами, однако возможно изменение и других внутренних путей. Профилировщик разработчика способен разобрать отдельные проходы точнее пользовательского оверлея. Честный вывод сохраняет эту границу: наблюдение показывает зависимость результата от условий, а не всегда единственную физическую причину.
Первичные источники и границы применения
Термины и ограничения исполнения проверены по документации конкретных архитектур и инструментов. Все численные сценарии и диаграммы в статье учебные; они не изображают результаты испытаний определённой видеокарты.
- NVIDIA — CUDA Programming Guide: модель исполнения и устройство программируемого GPU.
- NVIDIA — CUDA Best Practices Guide: память, передача данных и occupancy.
- AMD GPUOpen — RDNA Performance Guide: ресурсы, очереди и память.
- Microsoft — DXGI_QUERY_VIDEO_MEMORY_INFO: бюджет и использование видеопамяти.
- Intel GameTechDev — PresentMon: временные характеристики и ограничения сбора.
- NVIDIA — Streamline DLSS Frame Generation Programming Guide.
Комментарии