Память видеокарты: GDDR, HBM, каналы и цена движения данных
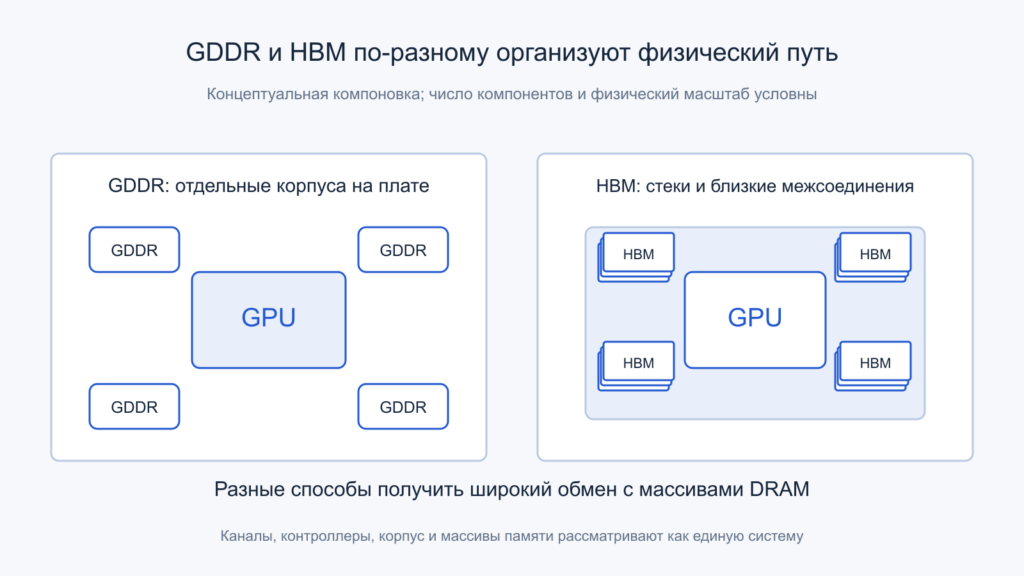
GDDR и HBM используют разные способы физически соединить массивы с GPU; число компонентов и масштаб на схеме условны. Открыть иллюстрацию в полном размере.
Две видеокарты имеют одинаковый объём памяти, но одна заметно быстрее в конкретной задаче. После увеличения разрешения загрузка вычислительных блоков остаётся неполной, а время кадра растёт. В вычислении небольшой набор данных обрабатывается быстро, тогда как большой резко замедляет ту же последовательность операций. Эти наблюдения объясняются не только количеством гигабайтов: значение имеют организация каналов, движение данных и повторное использование уже полученной информации.
Память GPU — система из массивов DRAM, интерфейсов, контроллеров и кэшей. GDDR и HBM предлагают разные способы соединить большие массивы с процессором. Ниже рассматриваются механизмы, а не рейтинг изделий. Числовые примеры обозначены как учебные; параметры конкретных поколений относятся к указанным документам и не являются результатами испытаний оборудования владельца сайта.
Содержание статьи
- Ёмкость и пропускная способность отвечают на разные вопросы
- Массив DRAM не переключается со скоростью внешних контактов
- Как GDDR распределяет обмен между компонентами
- GDDR6X и GDDR7 меняют способ сигнализации
- HBM переносит широкий интерфейс ближе к процессору
- Упаковка меняет конструкцию и тепловые ограничения
- Расчёт пиковой полосы требует правильного множителя
- Банки и строки влияют на доступную параллельность
- Чтение и запись делят ресурсы интерфейса
- Согласованные обращения экономят передаваемые байты
- Кэши уменьшают внешний обмен, если данные используются повторно
- Сжатие может менять эффективный трафик, но зависит от данных
- Арифметическая интенсивность связывает вычисление с полосой
- Недостаток ёмкости меняет сам маршрут данных
- Цена движения данных выражается и в энергии
- Задержку скрывают независимой работой, а не одним числом потоков
- Надёжность памяти имеет определённую область защиты
- Как проверять, что ограничивает конкретную задачу
- Официальные первичные источники
- Читайте также
Ёмкость и пропускная способность отвечают на разные вопросы
Ёмкость показывает, сколько данных можно разместить в доступном адресном пространстве памяти устройства. Пропускная способность описывает скорость их перемещения через выбранную границу. Время ответа на отдельный запрос характеризует задержку. Эти три величины связаны, но ни одна не заменяет остальные. Большой массив может иметь сравнительно узкий интерфейс, а широкий интерфейс не гарантирует, что задача эффективно заполняет его полезной работой.
В графике память хранит не только текстуры. Нужны буферы кадров, геометрия, промежуточные поверхности, структуры ускорения, данные шейдеров и служебные области. В вычислительной задаче сюда добавляются исходные массивы, результаты и временные рабочие пространства библиотек. Поэтому размер исходного файла нельзя считать точным требованием к VRAM: после загрузки формат, копии и набор одновременно существующих ресурсов способны измениться.
Устройства с одинаковой заявленной ёмкостью могут использовать разное число микросхем, разрядность интерфейса и скорость контакта. Даже слово «канал» требует уточнения: оно может обозначать интерфейс компонента, независимую часть контроллера или подразделение стека HBM. Перед сравнением полезно определить, о какой границе обмена говорится и какие физические ресурсы за ней стоят.
Интегрированный GPU способен использовать общую системную память вместо отдельного массива GDDR или HBM. В таком случае процессорные и графические запросы конкурируют за связанные ресурсы, а выделенный программой объём не равен физическому добавлению DRAM. Рассматриваемая здесь организация дискретной памяти не переносится на такую систему автоматически: сначала определяют её реальную топологию.
Массив DRAM не переключается со скоростью внешних контактов
Внутри DRAM данные организованы в строки, столбцы и банки. Для обращения к закрытой строке её нужно активировать, затем выполнить требуемую операцию и соблюсти временные ограничения. Снаружи же интерфейс передаёт длинные последовательности данных на высокой скорости. Разница между внутренним массивом и внешним обменом компенсируется архитектурой выборки, буферами и параллельной работой независимых участков.
Предвыборка позволяет за внутренний шаг подготовить несколько порций для последующей передачи. Поэтому высокая скорость на выводе не означает, что каждая ячейка DRAM обслуживает произвольный запрос с той же частотой. Увеличение скорости сигнализации способно поднять полосу длинного потока, не сократив пропорционально задержку активации строки. Это одна из причин, почему «быстрее память» не всегда означает одинаковое ускорение всех задач.
Маркетинговая эффективная скорость, частота тактового сигнала и скорость символов также могут быть разными числами. Для расчёта полосы нужен уже определённый поток битов на один контакт данных. Если в спецификации дана такая эффективная скорость, нельзя дополнительно умножать её на два только потому, что в названии есть DDR. Повторный учёт передачи по фронтам создаёт завышенный результат.
Как GDDR распределяет обмен между компонентами
GDDR обычно соединяет GPU с отдельными корпусами памяти на печатной плате. Контроллеры и сигнальные линии распределены по границе процессора, а соединения должны соблюдать электрические ограничения выбранного поколения. По мере увеличения числа контактов растут требования к разводке, корпусу и питанию. Поэтому ширина интерфейса является свойством всей конструкции, а не параметром, который можно свободно увеличить программной настройкой.
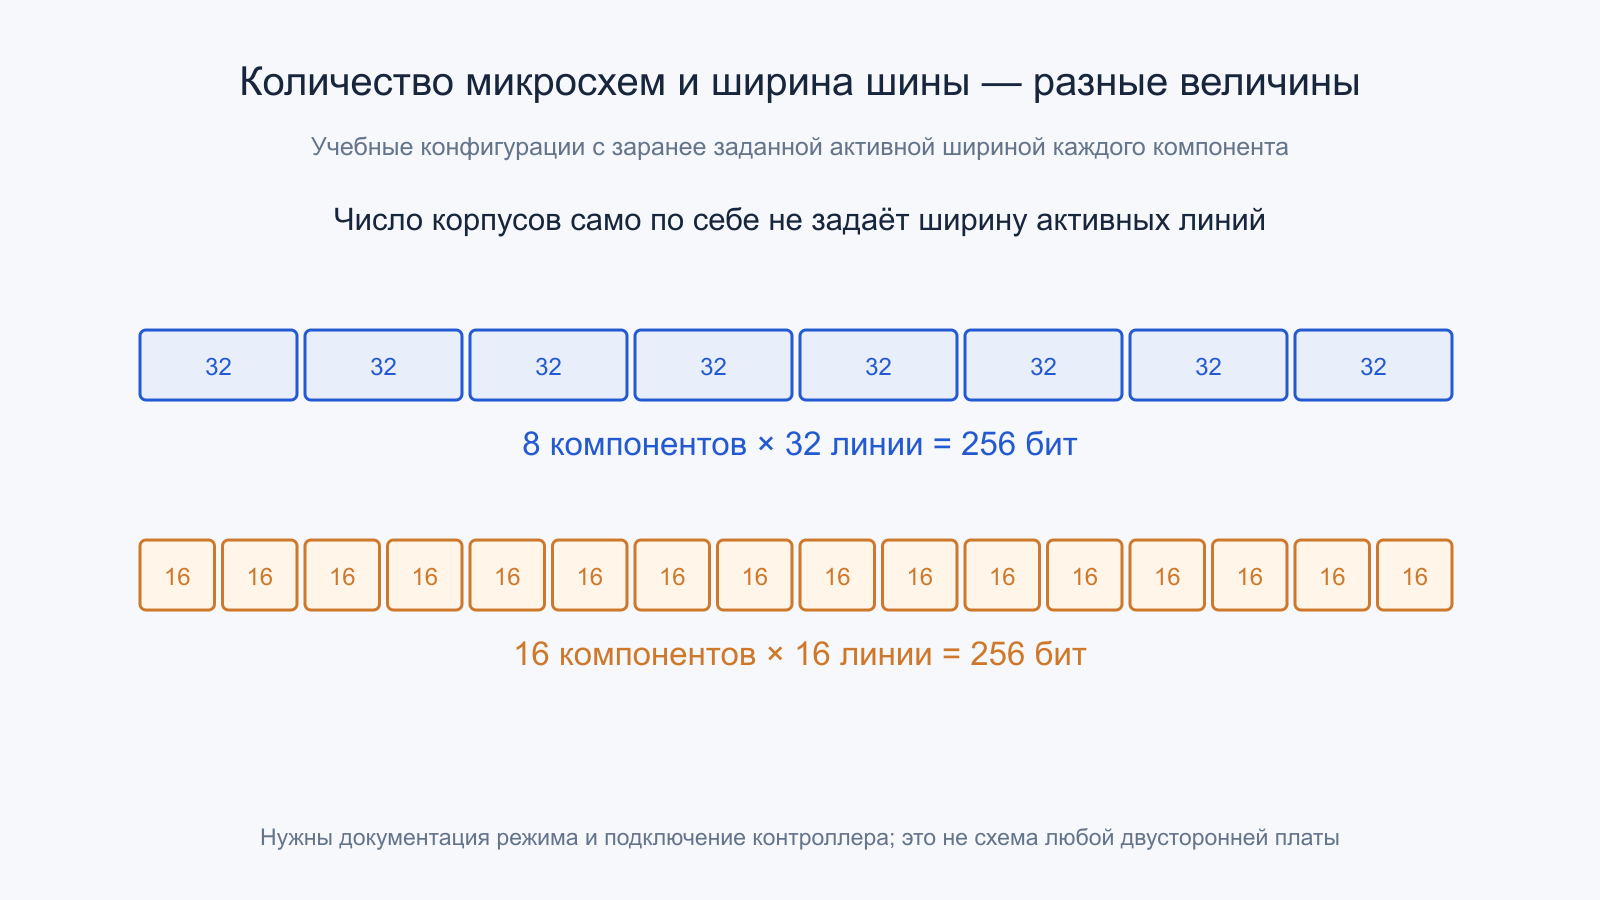
Micron описывает GDDR6 как компоненты с 32 линиями данных. У конкретных реализаций существуют дополнительные способы организации и режимы, поэтому физическое число корпусов ещё не даёт точной ширины активного интерфейса. Для условной конфигурации из восьми компонентов, каждый из которых использует 32 линии, получается суммарная ширина 256 бит. Здесь заранее предполагается соответствующее подключение контроллеров.
При наращивании ёмкости возможны конфигурации, в которых два компонента делят организацию канала и работают с другой шириной каждого компонента. Если шестнадцать корпусов используют по 16 активных линий, итог снова составляет 256 бит. Это учебная иллюстрация, а не схема любой карты с памятью с двух сторон платы. Без документации режима нельзя вывести удвоение полосы только из удвоения количества микросхем.
GDDR6X и GDDR7 меняют способ сигнализации
Бинарный сигнал различает два уровня и переносит один бит на символ. При четырёх уровнях PAM4 можно кодировать два бита на символ, но расстояние между уровнями уменьшается при том же общем размахе напряжения. Поэтому повышение битовой скорости за счёт многоуровневого сигнала предъявляет собственные требования к шуму, линейности и точности приёма. Оно не является бесплатным удвоением качества канала.
В обзоре графической памяти Micron GDDR6X связана с PAM4, а семейство GDDR7 рассматривается отдельно. Нельзя считать обозначения X и следующего поколения простой заменой одной частоты. Меняются интерфейс и архитектурные решения, а совместимость определяется GPU и платой. Микросхему другого поколения нельзя назначить подходящей заменой по совпадению ёмкости или похожему размеру корпуса.
При сравнении нужно приводить всё к одинаковым единицам: эффективные биты в секунду на линию, число активных линий и выбранное направление обмена. Скорость символов и количество возможных уровней помогают понять физику передачи, но готовую полезную полосу приложения определяют также команды, расписание DRAM и характер обращений. Более сложная сигнализация не отменяет эти ограничения.
HBM переносит широкий интерфейс ближе к процессору
HBM использует несколько кристаллов памяти в стеке и большое число соединений с соседним процессором через соответствующую технологию корпуса и межсоединений. Вертикальные соединения внутри стека и широкий внешний обмен позволяют получить большую совокупную полосу без необходимости разгонять каждый вывод до той же скорости, что у узкого интерфейса. Это другой компромисс между упаковкой, количеством линий и скоростью одной линии.
Стек HBM не является одним монолитным «очень быстрым чипом». В нём существуют каналы и внутренние ресурсы, которыми управляет контроллер. Для разных поколений и продуктов меняются ширина, организация и число уровней. Например, Samsung приводит для своих HBM3 организацию 1024 бита и скорость до 6,4 Гбит/с на контакт. Эти параметры нельзя автоматически приписать всем поколениям HBM.
Разбор NVIDIA Ampere показывает связь числа стеков HBM2 с контроллерами конкретной конфигурации GA100/A100. Это полезный пример того, что полный проект кристалла и реально выпущенный продукт могут иметь разное число активных ресурсов. Для расчёта карты нужно брать её конфигурацию, а не максимальную блок-схему семейства.
Упаковка меняет конструкцию и тепловые ограничения
Отдельные корпуса GDDR занимают место на плате и требуют большого количества согласованных соединений с GPU. HBM переносит плотную сеть обмена в другую конструкцию корпуса, где расстояния и технологии соединений иные. Поэтому сравнение одной цены или площади микросхемы памяти не описывает стоимость всей системы. Учитываются корпус процессора, межсоединения, производство, выход годных изделий и проверка готового узла.
Размещение памяти рядом с мощным вычислительным кристаллом также связывает их тепловые условия. Хорошая температура GPU по одному датчику ещё не доказывает одинаковый запас каждого элемента памяти. Точки измерения, локальные перепады и допустимые режимы задаются конструкцией. Указание на высокий стек не позволяет само по себе вычислить температуру верхнего кристалла или назвать необходимую систему охлаждения.
При этом большой интерфейс не обязан постоянно передавать пик. Управление частотой и энергосостояниями меняет доступные режимы во времени, а длительная задача может работать иначе короткой. Сопоставляя измеренную полосу с паспортом, проверяют фактическую частоту, температуру и ограничения мощности в том же интервале. Номинальное значение в таблице нельзя без этой проверки считать текущим режимом всех контактов.
Расчёт пиковой полосы требует правильного множителя
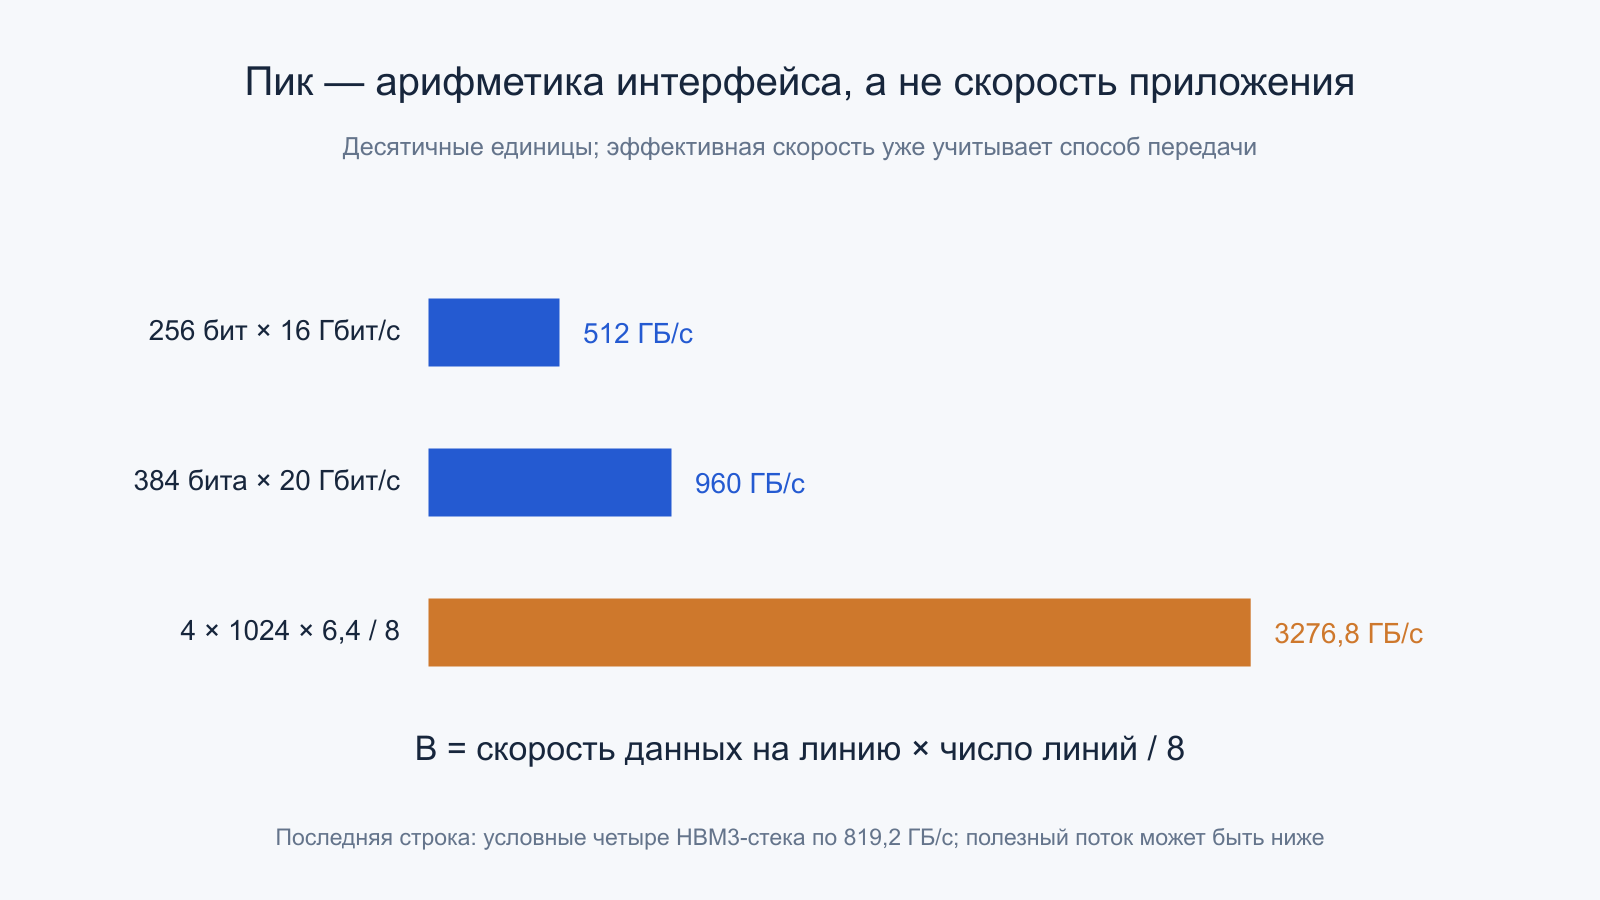
Если эффективная скорость одной линии равна R бит/с, а активных линий W, то идеализированная полоса данных равна B = R × W / 8 байт/с. Для условных 256 бит и 16 Гбит/с получается 512 ГБ/с. Для 384 бит и 20 Гбит/с —960 ГБ/с. Здесь используются десятичные единицы и уже эффективная скорость данных, поэтому дополнительного множителя DDR в формуле нет.
Для приведённого примера HBM3 получаем 1024 × 6,4 / 8 = 819,2 ГБ/с на стек. Четыре одинаковых стека при полностью доступных интерфейсах дали бы 3276,8 ГБ/с, или 3,2768 ТБ/с. Это арифметическая сумма пиков: она ещё не учитывает, сумеет ли контроллер и задача одновременно использовать все соответствующие каналы.
Пиковая полоса характеризует определённую границу обмена при подходящем режиме. Её нельзя прямо приравнять к скорости чтения текстур, копирования файла через PCIe или вычисления программы. У кэша, DRAM и внешнего соединения разные пути и ограничения. Для содержательного сравнения важно сначала установить, какую границу пересекает каждый измеряемый байт.
Банки и строки влияют на доступную параллельность
Когда несколько обращений попадают в уже открытую строку, устройство может обслужить их иначе, чем последовательность, требующая частого закрытия и активации разных строк. Независимые банки позволяют перекрывать часть операций. Поэтому распределение адресов по банкам и каналам влияет на скорость даже при одном объёме переданных данных. Два внешне одинаковых потока чтений способны создавать разное внутреннее расписание.
При этом точное отображение адресов является свойством контроллера и организации памяти. Нельзя универсально объявить, что каждый соседний адрес обязательно попадает в соседний физический канал. Для равномерного распределения могут использоваться дополнительные преобразования адресных битов. Важны документация конкретной архитектуры и фактические показатели, а не восстановление схемы по одному простому рисунку.
Внутренние ограничения также связывают отдельные команды: минимальные интервалы, восстановление после записи и обслуживание DRAM не исчезают из-за большого числа вычислительных блоков GPU. Высокая загрузка памяти не обязательно означает один постоянно открытый канал. Она может отражать сложное расписание нескольких банков, в котором часть времени полезные данные вообще не передаются по внешнему интерфейсу.
Чтение и запись делят ресурсы интерфейса
Для обычного канала графической DRAM линии данных используются в разных направлениях в разное время. Поэтому арифметическое сложение пиков чтения и записи способно создать несуществующий суммарный поток. Контроллер планирует команды, соблюдает паузы при смене направления и учитывает зависимые операции. Длительная однонаправленная передача и мелкое чередование чтения с записью используют интерфейс по-разному.
Даже простое копирование массива требует как чтения исходных данных, так и записи результата, если оба массива находятся в рассматриваемой памяти и отсутствует устраняющее трафик повторное использование. При полезном объёме результата 8 ГБ минимальное движение через эту границу в такой модели составляет 16 ГБ. При 512 ГБ/с нижняя арифметическая оценка времени —31,25 мс, без учёта остальных ограничений.
Нужно заранее назвать определение эффективной полосы теста. Некоторые программы делят на время сумму прочитанных и записанных байтов, другие показывают размер одного массива. Одинаковый эксперимент тогда получает две цифры, отличающиеся вдвое, хотя физическое поведение не изменилось. Сравнение без определения счётчика может ошибочно приписать аппаратуре выигрыш или недостаток.
Согласованные обращения экономят передаваемые байты
Вычислительные потоки часто запрашивают небольшие элементы, а память обслуживает более крупные порции. Контроллер объединяет совместимые соседние обращения, чтобы не передавать один и тот же участок многократно. Если нужные элементы разбросаны далеко, каждая порция приносит много неиспользуемых байтов. Проблема заключается не в недостаточном числе арифметических блоков, а в низкой доле полезного содержимого обмена.
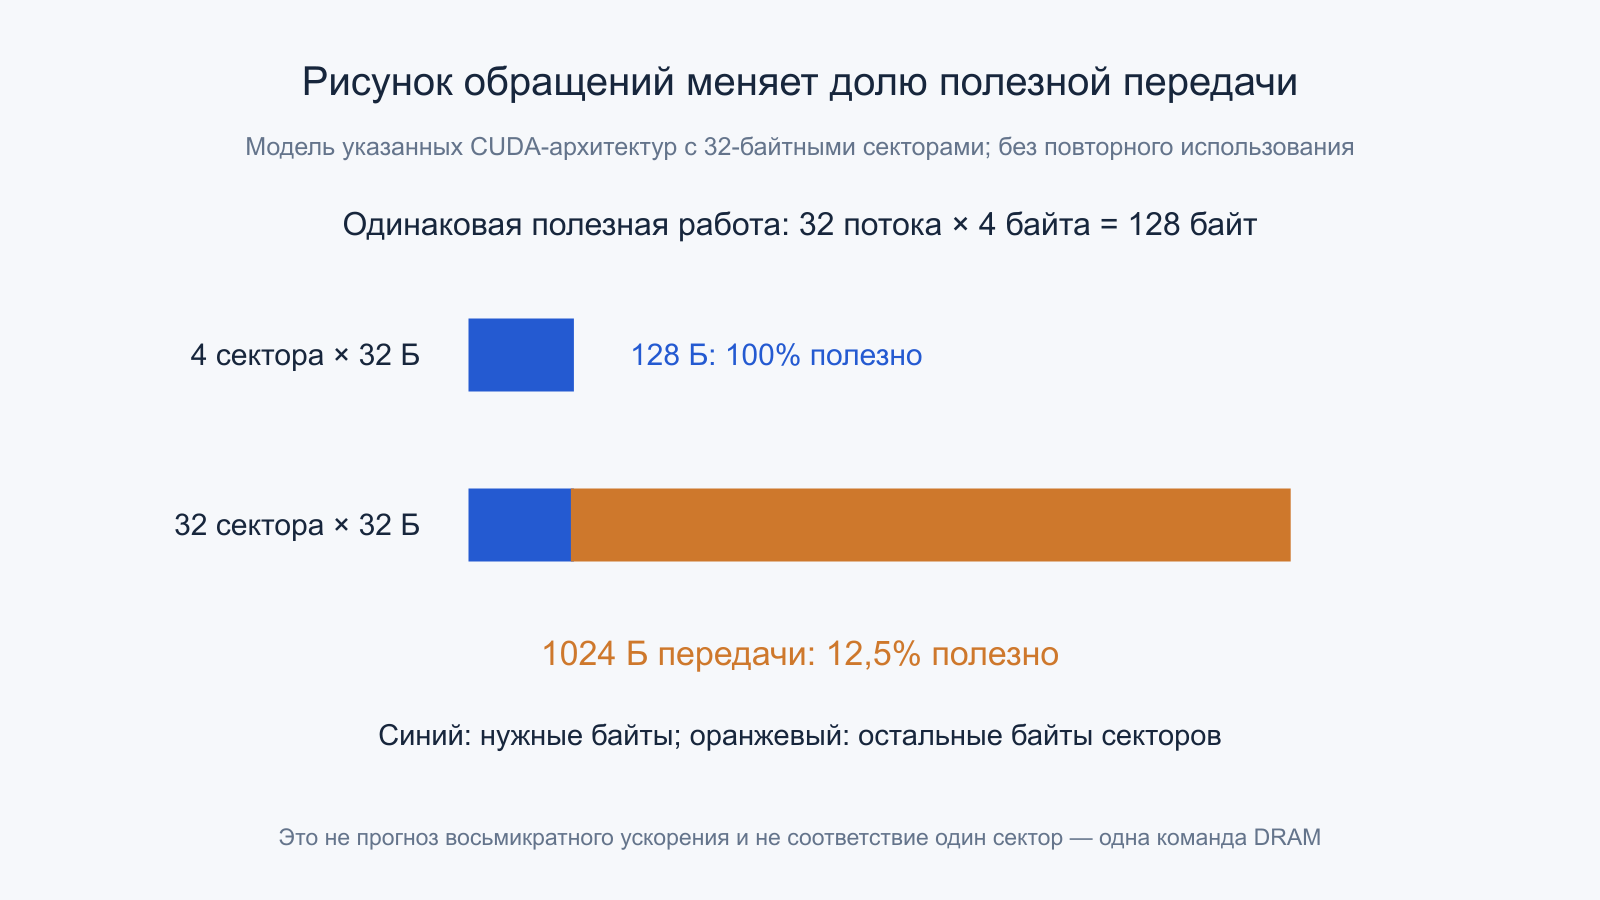
CUDA Best Practices Guide описывает для указанных compute capability правила объединения обращений в 32-байтные транзакции. В учебном примере 32 потока читают по четыре байта: полезно 128 байт. При соседнем выровненном расположении достаточно четырёх секторов по 32 байта. Если каждый элемент расположен в отдельном секторе, потребуется уже 1024 байта таких передач.
Доля полезного содержимого меняется со 100 до 12,5 процента, то есть в восемь раз. Это не обещание восьмикратного ускорения любой программы: кэши, повторные обращения и другие ограничения изменяют итог. Кроме того, сектор, видимый на этом уровне архитектуры, нельзя автоматически считать одной отдельной командой физической микросхемы DRAM. Иллюстрация относится к определённой модели запросов.
Кэши уменьшают внешний обмен, если данные используются повторно
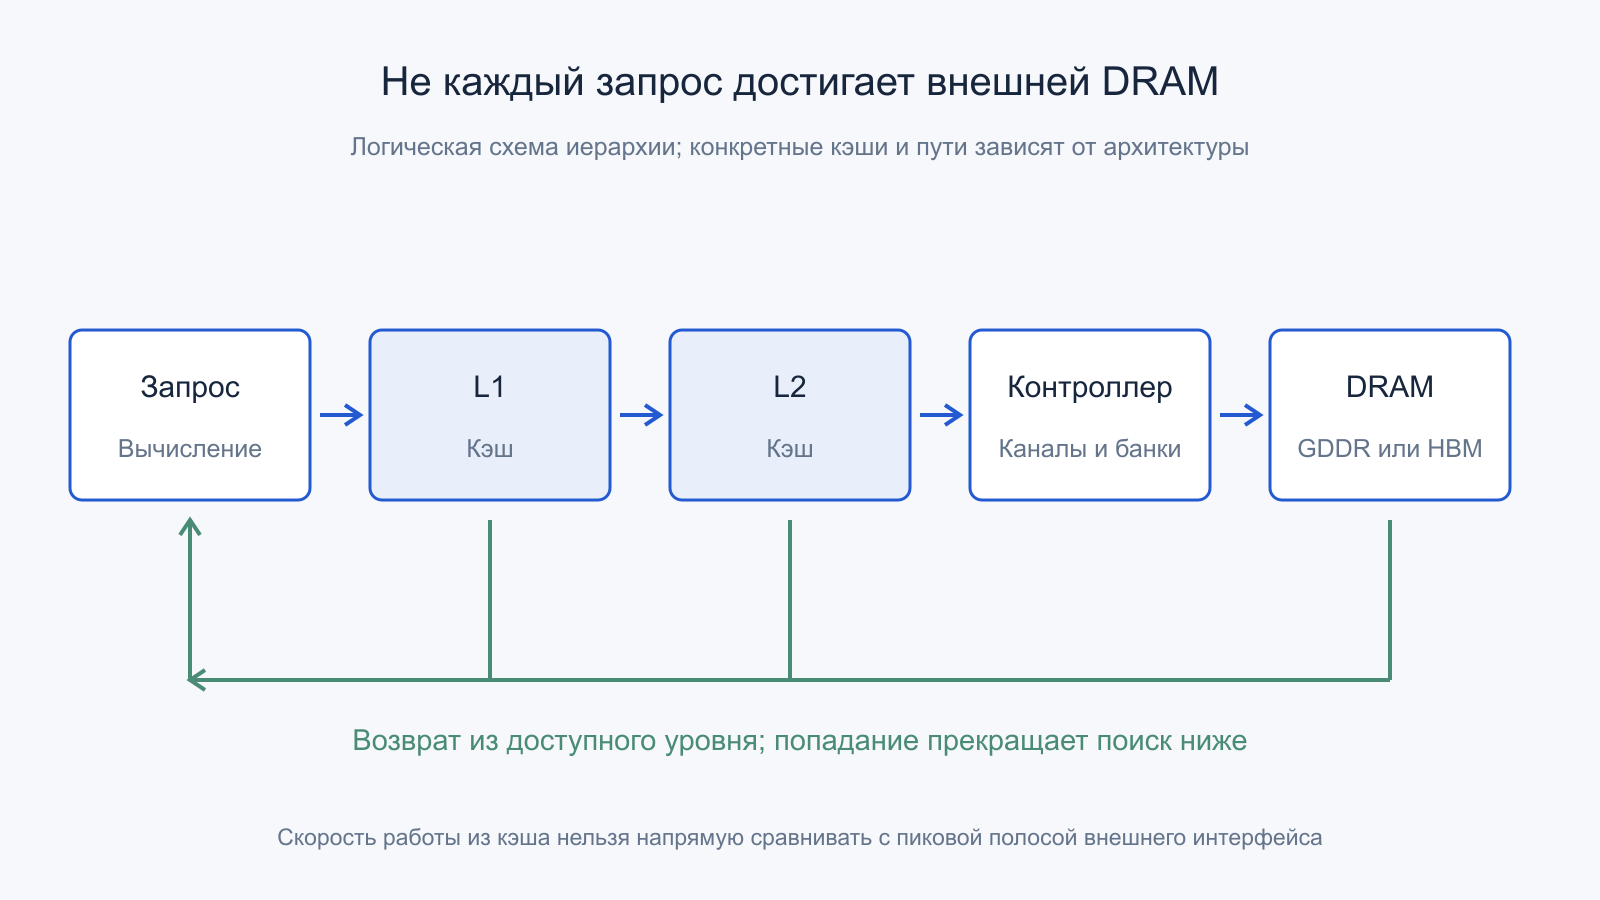
Кэш хранит ранее полученные данные ближе к вычислению. При попадании запрос может не доходить до внешней DRAM, что одновременно экономит полосу и меняет задержку. Поэтому измеренная скорость обработки набора, помещающегося в кэш, способна превышать паспортную полосу внешней памяти. Это не нарушение физического предела: сравниваются разные границы передачи данных.
Важны ёмкость рабочего набора, способы обращения и конкуренция потоков за кэш. Если множество независимых задач вытесняет данные раньше повторного использования, номинально большой кэш не гарантирует высокий процент попаданий. Параметр «размер массива» тоже недостаточен: программа может многократно использовать только небольшую его часть либо однократно просматривать весь диапазон.
Полезное размещение промежуточных данных сокращает дорогое движение. В некоторых алгоритмах небольшую порцию выгодно загрузить один раз, выполнить над ней несколько операций и только затем записать результат. Но локальные ресурсы ограничены, а увеличение временных данных может уменьшить число одновременно работающих потоков. Здесь существует инженерный компромисс, а не правило всегда занимать максимальный доступный объём быстрой памяти.
Сжатие может менять эффективный трафик, но зависит от данных
Графические архитектуры способны применять аппаратные способы сжатия определённых поверхностей и представлений. Если данные подходят для выбранной схемы, через часть границ передаётся меньше байтов, чем занимало бы исходное несжатое представление. Поэтому полезная нагрузка и физический трафик не всегда совпадают даже без попаданий в обычный кэш. Условия поддержки зависят от архитектуры и типа ресурса.
Из этого нельзя вывести постоянный коэффициент увеличения полосы памяти. Хорошо сжимающаяся поверхность, случайные значения и уже упакованные данные дают разный результат. Также нельзя предполагать, что любое вычислительное выделение памяти автоматически использует тот же механизм, что и графический буфер. Необходима поддержка конкретного пути и формата.
При исследовании производительности полезно отличать физические байты DRAM от логических байтов приложения и трафика между кэшами. Если один счётчик показывает уменьшение обращений, сначала выясняют, не изменились ли попадания, формат или способ сжатия. Только после этого можно связывать результат с реальной полосой контактов. Иначе одно архитектурное улучшение ошибочно превращается в выдуманную частоту микросхем.
Арифметическая интенсивность связывает вычисление с полосой
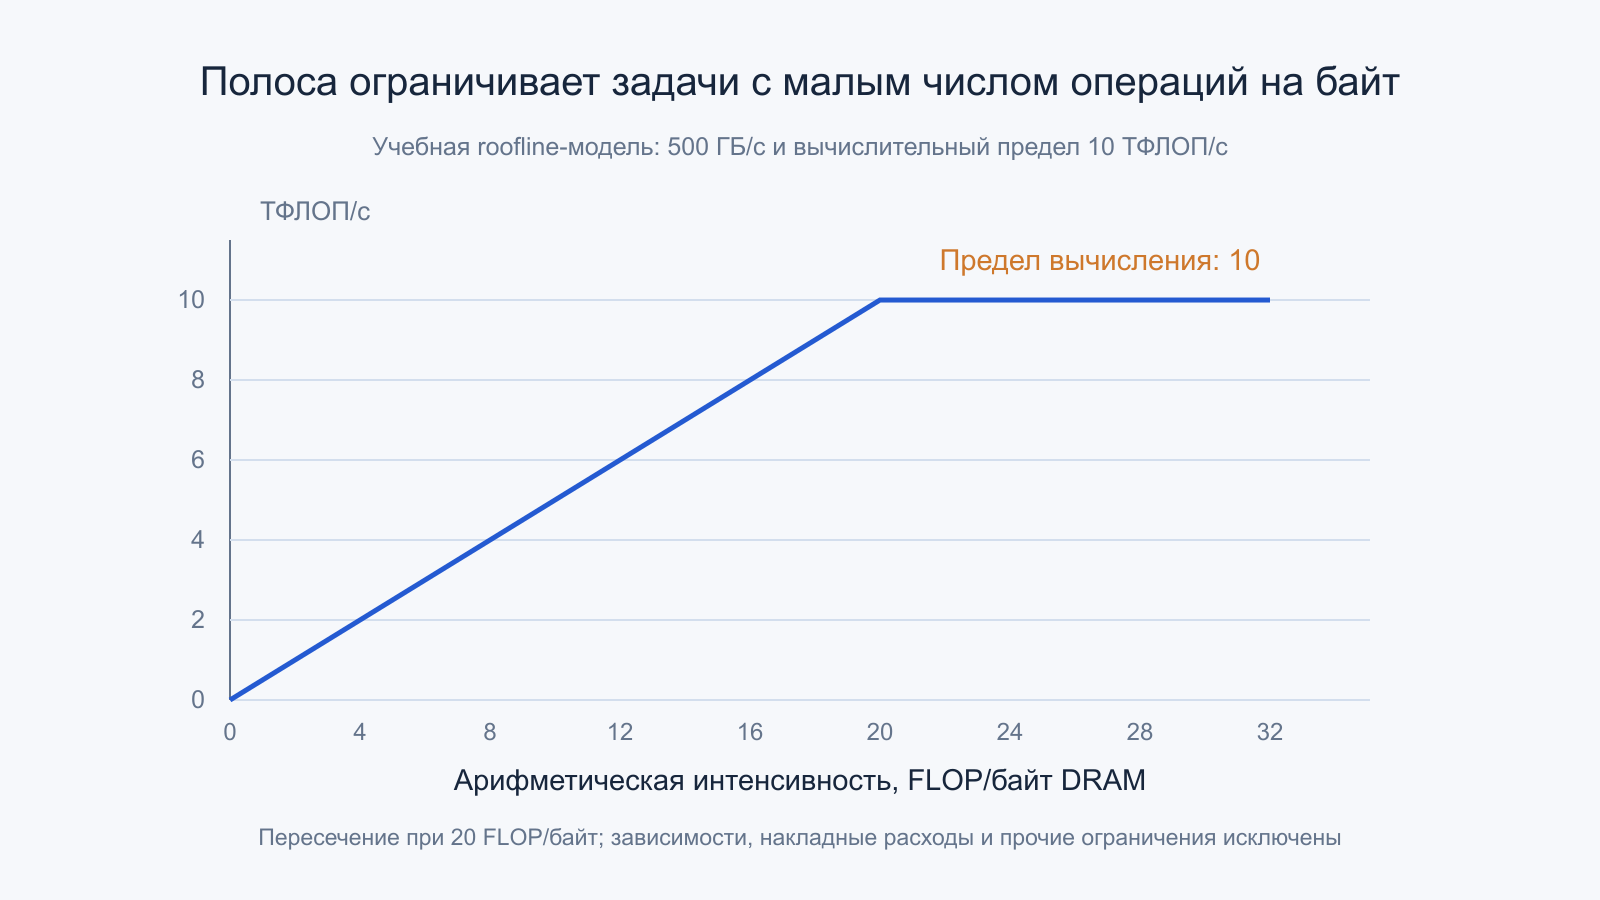
Арифметическая интенсивность задаёт число полезных операций на байт, прошедший через выбранную границу памяти. Для простой модели roofline предельная производительность равна минимуму из вычислительного пика и произведения полосы на интенсивность. Главное — согласовать определения: если рассматривается внешняя DRAM, в знаменатель должны попадать байты этого уровня, а не все обращения инструкций, включая обслуженные кэшем.
Пусть условный вычислительный предел равен 10 ТФЛОП/с, а доступная для модели полоса —500 ГБ/с. При интенсивности один FLOP на байт память ограничивает результат величиной 0,5 ТФЛОП/с; при восьми —4 ТФЛОП/с. Пересечение с вычислительным пределом наступает на 20 FLOP/байт. После этого одно увеличение полосы уже не поднимает ограничение данной модели.
Модель не включает зависимости, занятость исполнительных блоков, точность операций и накладные расходы. В реальном алгоритме увеличение интенсивности за счёт лишних ненужных вычислений не обязано улучшить полезное время. Цель состоит в повторном использовании нужных данных и уменьшении движения, а не в искусственном улучшении отношения двух счётчиков. Условный график показывает границы рассуждения, а не результат бенчмарка.
Недостаток ёмкости меняет сам маршрут данных
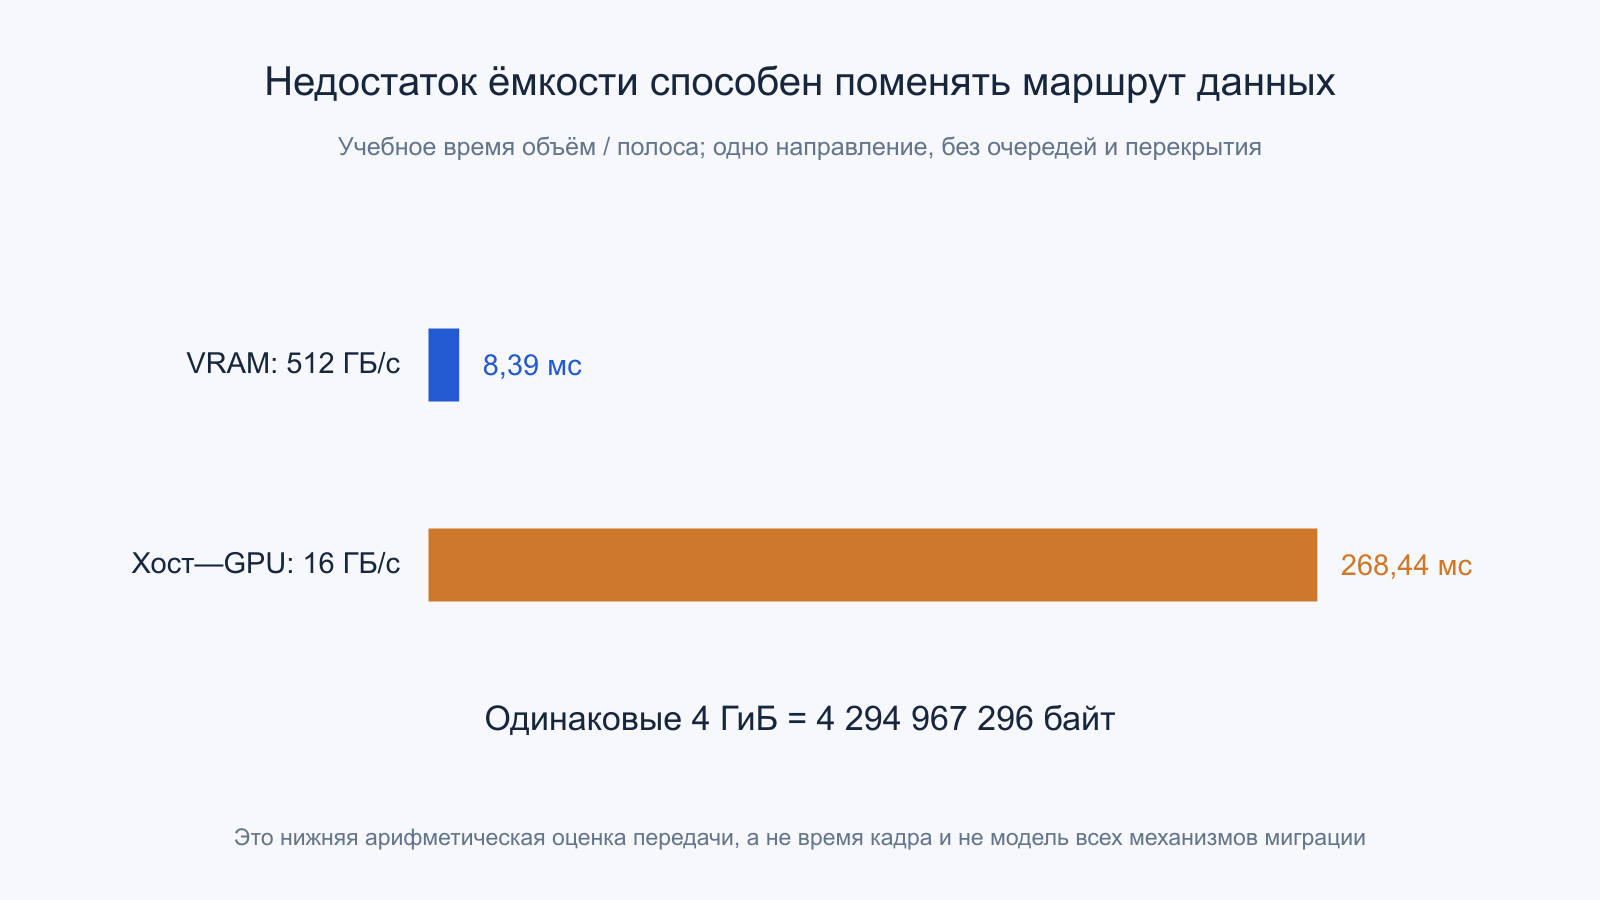
Пока рабочий набор остаётся в памяти устройства, обмен может идти по короткому внутреннему пути. Если необходимы страницы или ресурсы, находящиеся в системной памяти, появляются другие границы: внешнее соединение, управление отображениями и перенос данных. Поэтому превышение доступной VRAM способно вызывать резкий переход поведения, а не плавное уменьшение скорости на несколько процентов.
Для масштаба возьмём условные четыре ГиБ данных и эффективный однонаправленный канал хост—GPU 16 ГБ/с. Только передача занимает не менее 268,44 мс в этой модели. Через интерфейс внешней памяти GPU с 512 ГБ/с тот же объём соответствовал бы 8,39 мс арифметического времени. Здесь двоичный объём явно переведён в байты, а скорости заданы десятичными единицами.
Это не прогноз задержки кадра и не описание любого механизма управления памятью. Часть работы способна перекрываться, часть данных не потребуется переносить полностью, а миграции могут повторяться. Важен качественный вывод: дополнительный гигабайт ёмкости иногда предотвращает дорогой маршрут, даже когда не меняет полосу самой VRAM. Именно поэтому объём и скорость нужно оценивать вместе с рабочим набором.
Цена движения данных выражается и в энергии
Передача битов требует переключения ёмкостей, работы драйверов, приёмников и внутренних цепей. Сокращение ненужного обмена способно уменьшать не только время, но и потребление соответствующего участка. Однако энергию всего GPU нельзя получить из одной цифры интерфейса: существуют массивы DRAM, контроллеры, кэши, вычислительные блоки и фоновые расходы, которые не масштабируются одинаково.
В учебной модели компонентная энергия передачи равна четырём пикоджоулям на бит, а поток составляет 500 ГБ/с. Это четыре триллиона битов в секунду, поэтому соответствующая мощность равна 16 Вт. При двух пикоджоулях получится 8 Вт, при восьми —32 Вт. Числа выбраны для арифметики и не являются спецификацией GDDR, HBM или конкретного изделия.
Если сократить проходящий через эту границу поток вдвое, пропорционально уменьшится именно переменная составляющая выбранной модели. Полное потребление платы не обязано уменьшиться вдвое. Более того, освободившийся ресурс может позволить вычислительным блокам работать активнее. Поэтому энергетическую пользу оптимизации проверяют по завершённой полезной задаче и её реальному времени, а не только по мгновенной мощности.
Задержку скрывают независимой работой, а не одним числом потоков
Высокая полоса требует достаточного количества одновременно обслуживаемых данных. В простой стационарной модели произведение потока байтов на среднюю задержку даёт средний объём данных в пути. Для 500 ГБ/с и условных 300 нс это 150000 байт, примерно 146,5 КиБ. Такой расчёт объясняет потребность в параллельных обращениях, но не устанавливает точное число очередей или потоков аппаратуры.
Если следующий адрес зависит от только что прочитанного значения, программа не может заранее сформировать произвольное число независимых запросов. Здесь широкая память способна оставаться недогруженной, а время определяет цепочка зависимых задержек. В другом алгоритме множество независимых порций позволяет перекрывать ожидание вычислением и обменом. Одинаковая полоса DRAM тогда сопровождается разной полезной скоростью.
Увеличение количества потоков ограничено регистрами, локальной памятью, ресурсами планировщика и характером задачи. Больше параллелизма не всегда лучше: возможны дополнительный трафик, вытеснение данных и ожидание общих структур. Для интерпретации результата нужно знать, чего не хватает — независимых запросов, вычислительных ресурсов или полезной доли передачи. Одного процента загрузки контроллера недостаточно.
Надёжность памяти имеет определённую область защиты
Графическая память, интерфейс передачи, кэши и вычислительные блоки образуют разные области возможной ошибки. Механизм контроля одного участка не делает автоматически защищённой всю последовательность операций. Нужно различать исправление внутри массива, обнаружение нарушения при передаче и защиту данных на более широком пути. Поддержка и доступные счётчики зависят от конкретной архитектуры и режима.
Наличие ECC в описании ускорителя не является обещанием исправления любого сбоя программы, неверного адреса или логически неправильного результата. Обратный вывод тоже неверен: отсутствие пользовательской настройки не доказывает отсутствия всех внутренних средств контроля. Для анализа нужны документы изделия и точное описание того, что именно проверяется, исправляется и становится доступным программному наблюдению.
Ошибки, перегрев и нестабильность режима нельзя диагностировать только по падению средней скорости. Снижение частоты, повторная обработка, ограничения питания или нехватка ёмкости способны создавать похожие графики времени. Полезно фиксировать доступные счётчики, температурные условия, объём занятой памяти и повторяемость. Это помогает не объявлять неисправной память, когда изменился другой участок системы.
Как проверять, что ограничивает конкретную задачу
Сначала определяют полезную работу и её маршрут: объём реально используемых данных, число проходов, долю чтения и записи, возможность повторного использования и необходимость обмена с хостом. Затем сопоставляют время и доступные аппаратные счётчики. Если малый набор работает иначе большого, проверяют границы кэша и ёмкости. Если меняется только рисунок обращений, исследуют объединение запросов и распределение по ресурсам.
Для сравнения режимов памяти сохраняют одинаковую задачу, разрешение, формат данных, настройки обработки и тепловые условия. Разгон интерфейса способен менять стабильность и энергопотребление, поэтому один удачный короткий прогон не подтверждает улучшение для длительной работы. Здесь полезнее повторяемое время завершения, распределение задержек и отсутствие обнаруженных ошибок в заданных условиях, чем максимальная цифра частоты.
Содержательное объяснение производительности связывает ёмкость, полосу, задержку и полезные байты. GDDR и HBM решают задачу широкого обмена разными физическими средствами, а контроллеры и программа определяют, насколько удачно эти средства используются. Поэтому выбор и оценка памяти начинаются с движения данных в конкретной работе, а заканчиваются проверенным результатом, а не сравнением одних названий или гигабайтов.
Официальные первичные источники
- Micron — GDDR6: организация компонентов и технические материалы семейства.
- Micron — Graphics Memory: различия семейств графической памяти и многоуровневая сигнализация.
- Samsung — HBM: пример параметров HBM3; поколения и изделия различаются.
- NVIDIA — Ampere Architecture In-Depth: связь стеков HBM2 и контроллеров конкретной архитектуры.
- NVIDIA — CUDA C++ Best Practices Guide: объединение обращений, границы памяти и интерпретация эффективной полосы.
Комментарии