Аппаратная виртуализация: как процессор, память и устройства обслуживают виртуальные машины
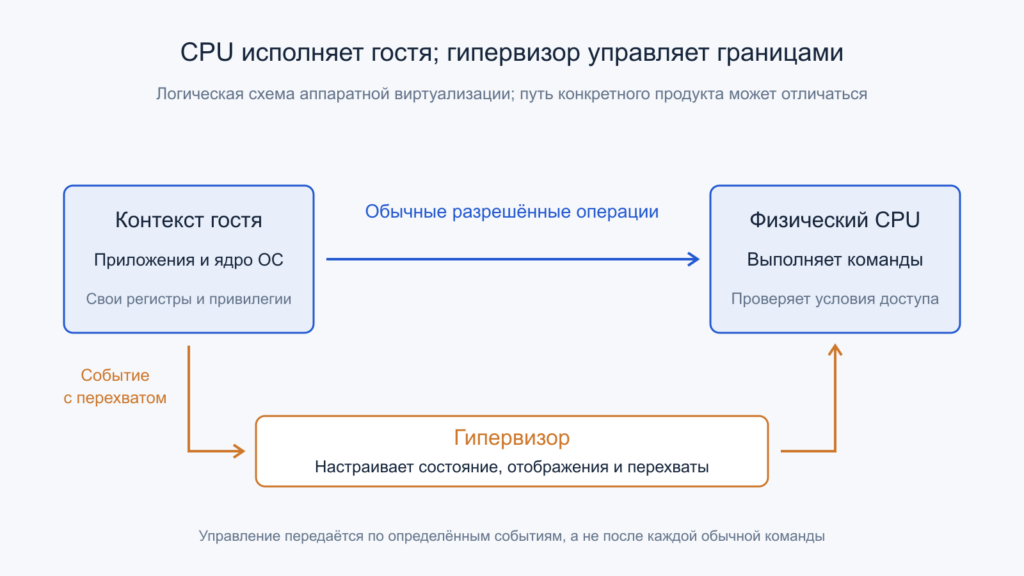
Аппаратная виртуализация разделяет прямое исполнение и управление границами; обычная команда не обязана вызывать VM exit. Открыть иллюстрацию в полном размере.
Виртуальная машина показывает собственные процессоры, оперативную память и сетевой адаптер, хотя физически использует ресурсы обычного компьютера. При одной задаче она почти не отличается по скорости от основной системы, а при другой заметно отстаёт. Добавление виртуальных ядер иногда даже увеличивает задержку. Чтобы объяснить эти наблюдения, нужно проследить не только исполнение команд, но и планирование, перевод адресов, прерывания и путь ввода-вывода.
Аппаратная виртуализация не создаёт второй комплект транзисторов. Она предоставляет механизмы управляемого исполнения и изоляции, а гипервизор организует на их основе несколько программных машин. Ниже рассматривается преимущественно семейство x86-64. Термины Intel и AMD разделены там, где их реализации отличаются; числа в расчётах условны и не являются результатами испытаний компьютера владельца сайта.
Содержание статьи
- Виртуальная машина, эмулятор и контейнер решают разные задачи
- Процессор исполняет гостя, сохраняя контроль гипервизора
- Виртуальный процессор — контекст исполнения, а не новое ядро
- VM exit возникает на определённом событии
- Учебная оценка стоимости переходов
- У памяти гостя появляются два этапа перевода адреса
- Почему полный обход таблиц может быть дорогим
- TLB и идентификаторы контекста сокращают повторную работу
- Большие страницы меняют охват, но требуют условий
- Гостевой page fault и нарушение EPT — разные события
- Прерывания и часы тоже входят в виртуальную платформу
- Устройство можно эмулировать, паравиртуализировать или назначить напрямую
- IOMMU ограничивает DMA, но CPU-виртуализация её не заменяет
- Локальность памяти сохраняет значение внутри виртуализации
- Вложенная виртуализация добавляет ещё одного владельца машины
- Как измерять издержки, не сводя всё к одному проценту
- Изоляция и конфиденциальная ВМ имеют разные границы
- Официальные первичные источники
- Читайте также
Виртуальная машина, эмулятор и контейнер решают разные задачи
У виртуальной машины есть модель аппаратной платформы, на которой запускается гостевая операционная система со своим ядром. При аппаратной виртуализации совместимые команды гостя исполняются физическим процессором, а специальные события контролируются гипервизором. При полной программной эмуляции реализация способна воспроизводить и другую архитектуру команд, переводя или интерпретируя её операции. Поэтому слово «виртуальный» ещё не описывает способ исполнения и его стоимость.
Контейнер обычно разделяет ядро основной ОС с другими контейнерами, используя её механизмы изоляции и распределения ресурсов. Это не означает, что у контейнера обязательно отсутствует дополнительный слой виртуальной машины: настольные продукты могут размещать контейнерную среду внутри ВМ. Нужно различать внутреннюю модель приложения и реальную цепочку исполнения на конкретном компьютере, а не определять архитектуру по одному значку программы.
И сами гипервизоры устроены неодинаково. В одном продукте компоненты управления и устройства выполняются в основной ОС, в другом используются особая управляющая среда и отдельные сервисы. Например, Microsoft описывает архитектуру Hyper-V через гипервизор, корневой и дочерние разделы. Это конкретная организация системы; её нельзя переносить как обязательную схему на все продукты виртуализации.
Процессор исполняет гостя, сохраняя контроль гипервизора
В Intel VMX различаются root operation и non-root operation. Эти состояния не заменяют обычные уровни привилегий внутри системы: гостевое ядро способно работать со своим CPL0, оставаясь в VMX non-root. Поэтому популярное выражение «гостевую ОС просто отправили в ring3» неправильно объясняет современную аппаратную виртуализацию. Приложения и ядро гостя сохраняют внутреннюю структуру привилегий, но поверх неё действуют отдельные правила контроля.
Гипервизор задаёт состояние и условия исполнения через предусмотренные структуры управления. В терминологии Intel это VMCS, переход к гостю называют VM entry, а возврат управления — VM exit. В AMD SVM используются VMCB и другой набор инструкций и контролей. Назначение механизмов сходно, но имена полей, детали сохранения состояния и способы обработки событий нельзя смешивать в одну вымышленную универсальную инструкцию.
Системное руководство Intel является первичным источником для VMX. Оно важно ещё и тем, что поддержка функций проверяется по возможностям конкретного процессора. Наличие общего пункта «виртуализация» в описании компьютера не гарантирует весь набор ускорений памяти, прерываний и ввода-вывода. Нужны совместимые CPU, прошивка, гипервизор и выбранная конфигурация гостя.
Виртуальный процессор — контекст исполнения, а не новое ядро
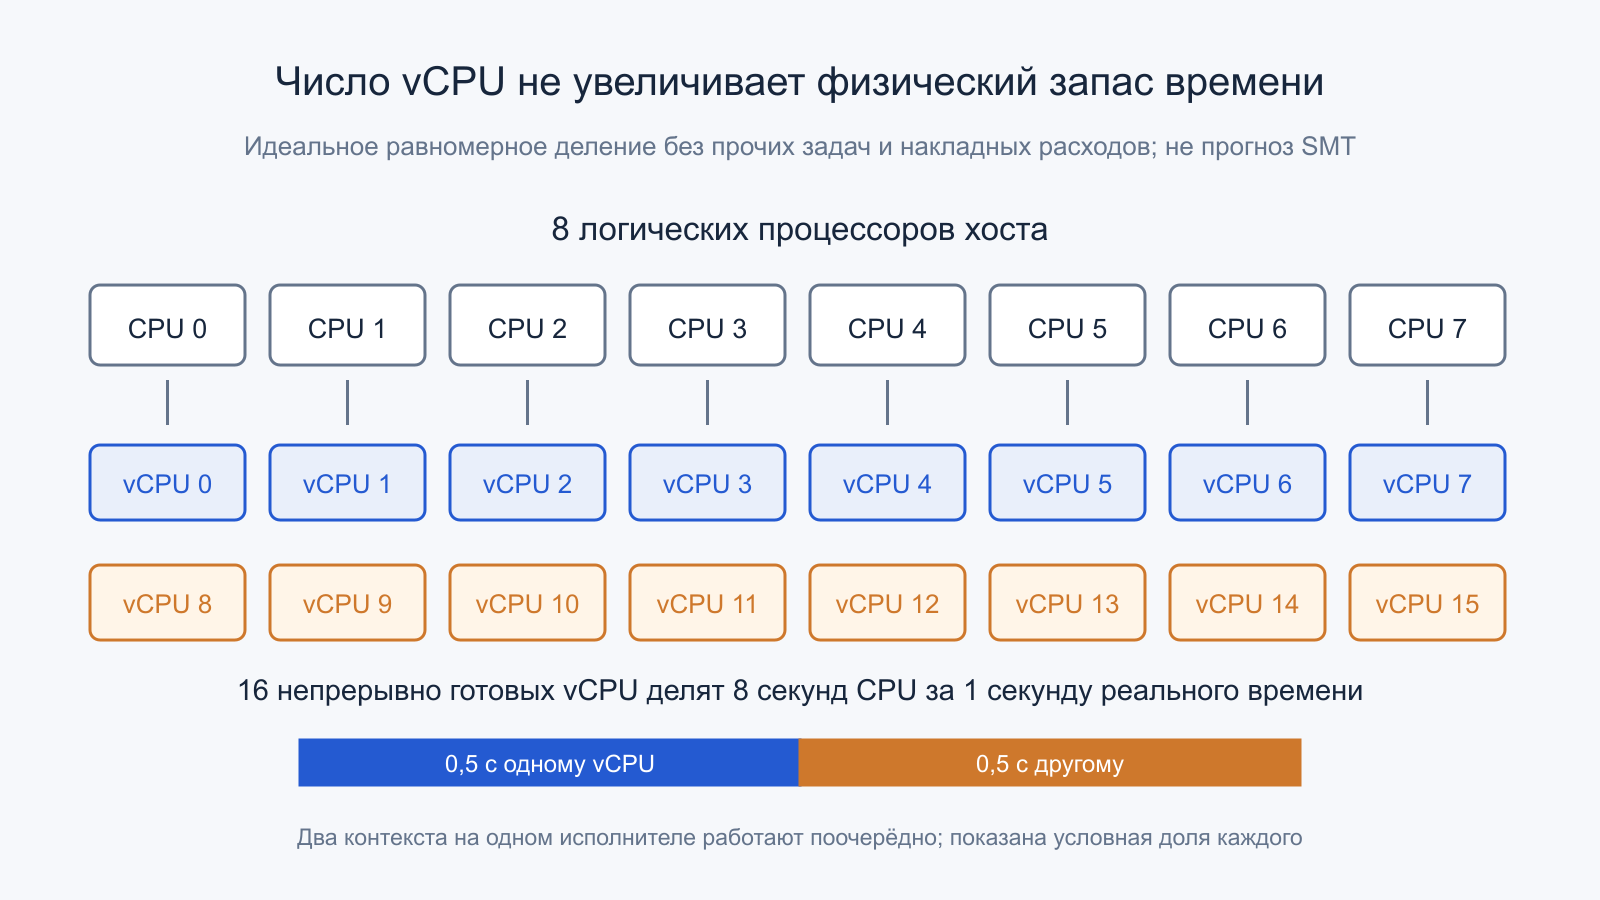
vCPU содержит архитектурное состояние гостевого процессора: регистры, управляющие параметры, ожидаемые события и связанную служебную информацию. Чтобы этот контекст действительно выполнял команды, планировщик должен предоставить ему физический логический процессор. Несколько vCPU могут по очереди использовать один исполнитель, а один vCPU в разные моменты способен работать на разных исполнителях, если политика размещения это разрешает.
Представим восемь логических процессоров хоста и шестнадцать непрерывно готовых к работе vCPU. В идеальной модели равномерного деления, без других задач и накладных расходов, на каждый vCPU приходится половина секунды процессорного времени за одну секунду реального времени. Это не точный прогноз скорости программы: SMT, разные ядра, память и синхронизация меняют результат. Но дополнительные виртуальные процессоры явно не удваивают физический запас времени.
Ожидание планирования существенно для взаимодействующих потоков. Один гостевой поток держит блокировку, но временно не исполняется; другой тратит доступное время на ожидание этой блокировки. Гостевая ОС может видеть достаточное число процессоров, хотя хост перегружен. Поэтому для объяснения задержки нужно сопоставлять состояние гостя с очередью готовых vCPU и нагрузкой физической системы, а не смотреть только на процент CPU внутри ВМ.
VM exit возникает на определённом событии
Обычная арифметическая операция или обращение к разрешённой памяти не обязаны передавать управление гипервизору. Выход происходит при настроенном перехвате либо условии, которое архитектура требует обработать отдельно. Причинами могут быть выбранные операции ввода-вывода, отдельные управляющие действия, определённые исключения или события, связанные с отображением памяти. Их набор зависит от архитектуры, доступных функций и установленных контролей.
Выход также не равен автоматическому переключению на любое приложение хоста. Сначала управление получает предусмотренная часть гипервизора. Она анализирует причину, изменяет нужное состояние и решает, можно ли продолжить гостя. Иногда обработка остаётся внутри ядра, иногда требуется обращение к процессу, моделирующему устройство. Поэтому два выхода с одинаковым названием в общем счётчике могут иметь разную фактическую цену.
Часть событий можно обработать без полного пути через программную модель благодаря аппаратным ускорениям. Однако сокращение числа выходов не является самостоятельной целью, если при этом нарушаются необходимые функции наблюдения, изоляции или учёта. Полезно измерять конкретную категорию событий и её вклад в задачу. Суммарное число за сутки без нормировки на время и объём полезной работы почти ничего не говорит о причине замедления.
Учебная оценка стоимости переходов
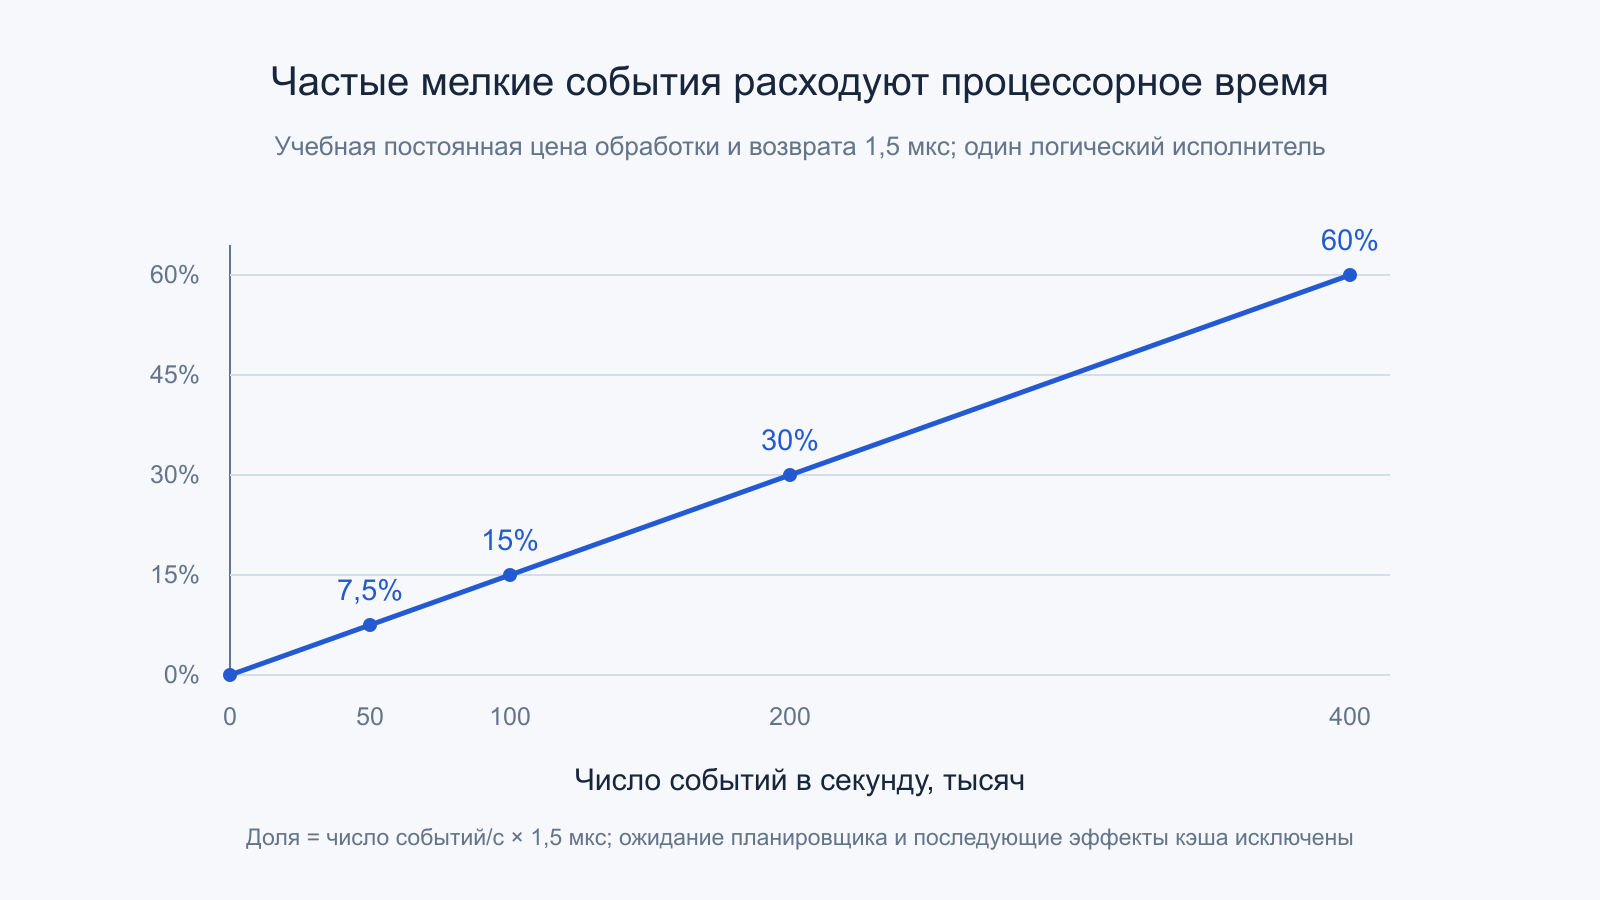
Допустим, совокупная стоимость одного события с выходом, обработкой и возвратом равна постоянным 1,5 мкс. При 100 тысячах таких событий в секунду они занимают 0,15 секунды процессорного времени за секунду, то есть 15 процентов одного логического исполнителя. При 200 тысячах получается 30 процентов, при 400 тысячах — 60 процентов. Это арифметическая модель, а не паспортное время VM exit для какого-либо процессора.
Модель предполагает последовательное выполнение обработок на одном исполнителе и не учитывает их пересечение с другой работой. Она также исключает последующие потери из-за изменения состояния кэшей, ожидание планировщика и очереди устройств. Реальная цена зависит от причины выхода, настроек безопасности, поколения CPU и реализации гипервизора. Число 1,5 мкс выбрано только для понятного масштаба, поэтому его нельзя применять как универсальную константу.
Даже такая ограниченная оценка показывает, почему задача с редкими выходами и длинными вычислительными участками отличается от задачи с большим числом мелких обращений к моделируемому устройству. В первом случае полезные команды могут занимать почти весь предоставленный квант, во втором значимую долю съедает обслуживание границы. Вывод нужно связывать с измеренной структурой нагрузки, а не с общим утверждением, что любая ВМ медленная или всегда работает без потерь.
У памяти гостя появляются два этапа перевода адреса
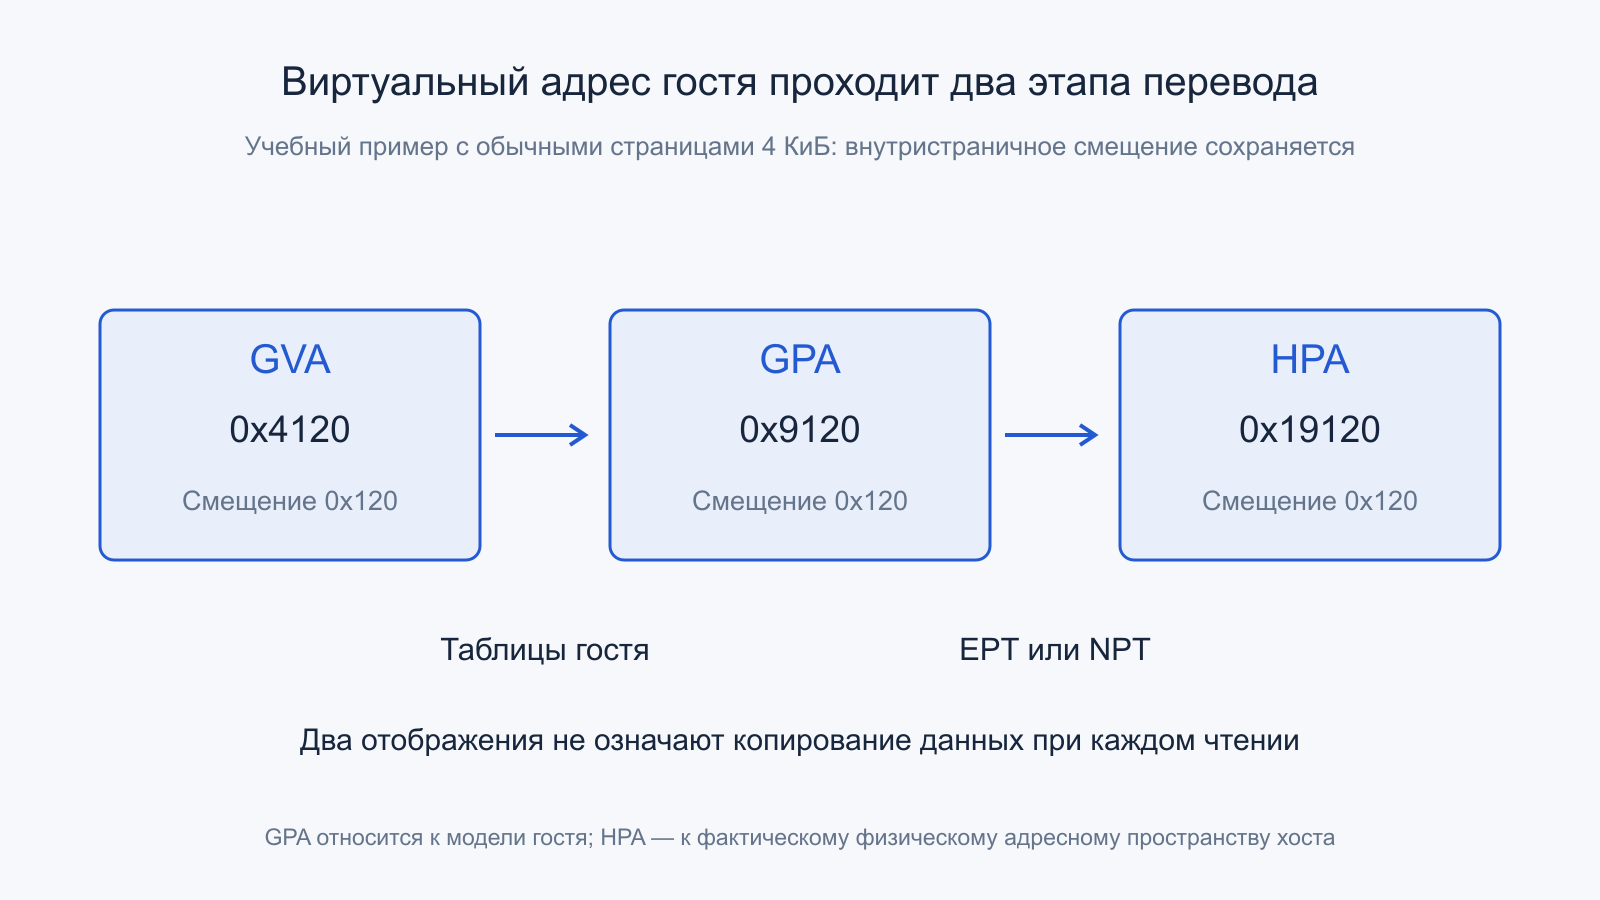
Обычная гостевая программа использует гостевой виртуальный адрес, GVA. Таблицы гостевой ОС переводят его в гостевой физический адрес, GPA. Слово «физический» здесь относится к модели машины, которую видит гость. Для реального обращения к памяти хоста нужен ещё один перевод — из GPA в физический адрес хоста, HPA. Именно на втором этапе гипервизор определяет, какие страницы действительно доступны этой машине.
В Intel аппаратный механизм второго этапа называется EPT, в AMD — nested paging, часто обозначаемый NPT. Для общего обсуждения используют выражение two-dimensional paging. Документация MMU KVM явно различает эти адресные пространства и варианты перевода. Нельзя считать GPA прямым указателем на ту же физическую страницу хоста только потому, что число в отладочном выводе выглядит как адрес памяти.
В условном примере с обычными страницами 4 КиБ адрес GVA 0x4120 переводится в GPA 0x9120, затем в HPA 0x19120. Смещение внутри страницы 0x120 сохраняется, а номера страниц меняются. Это иллюстрация двух отображений, а не обязательные адреса реальной ВМ. Наличие нескольких этапов не означает, что гипервизор программно копирует содержимое при каждом чтении.
Почему полный обход таблиц может быть дорогим
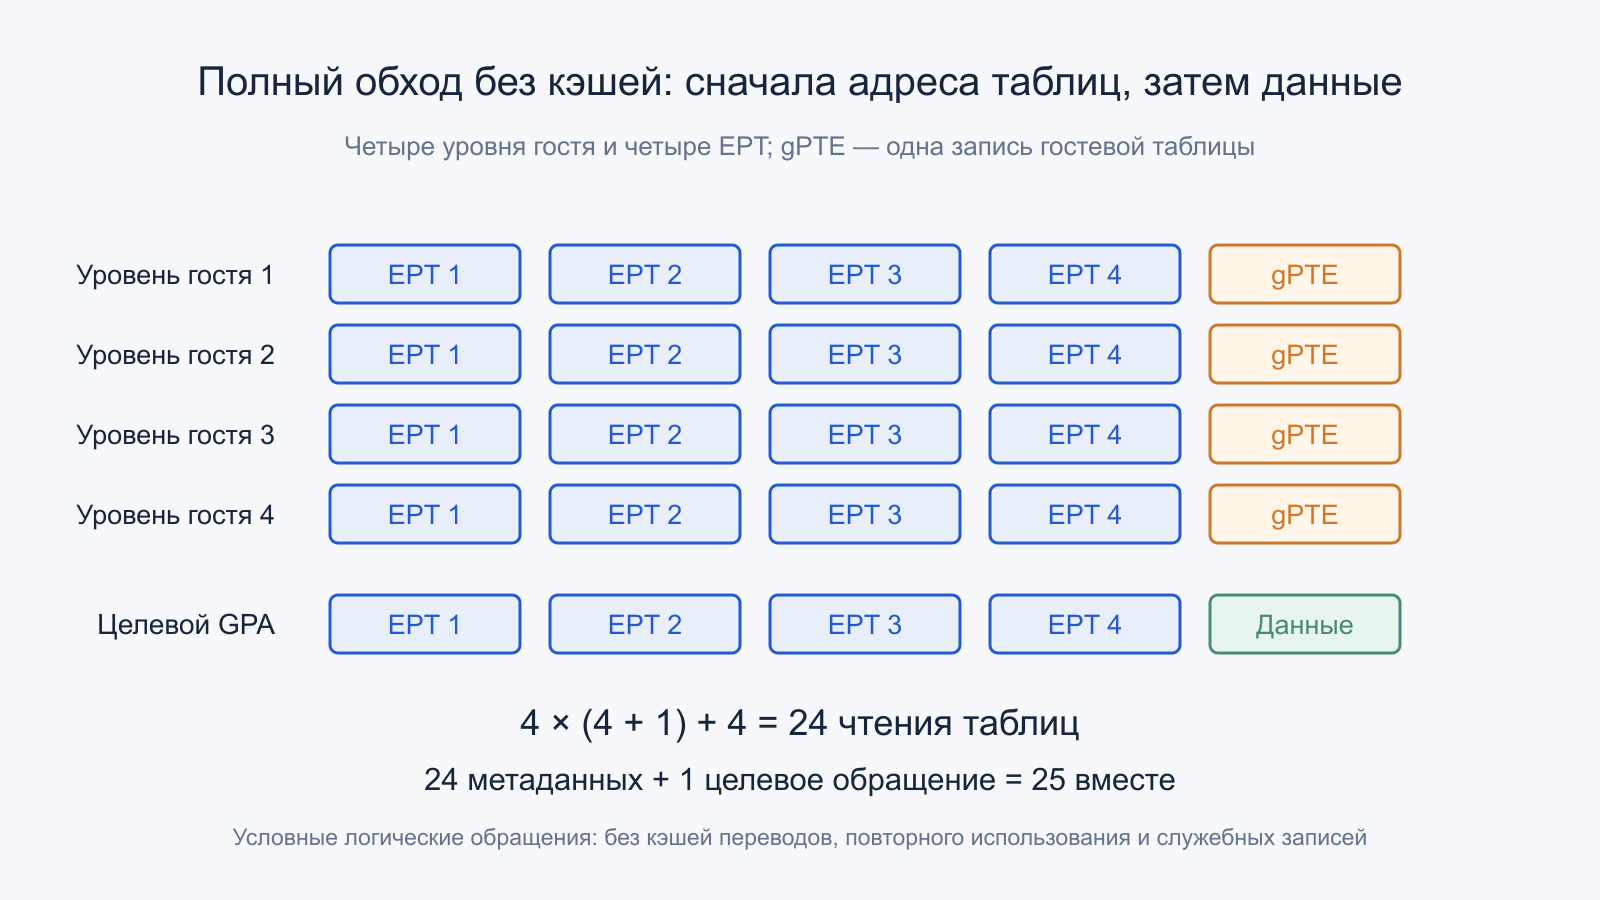
Рассмотрим нарочно неблагоприятную учебную модель: гостевые таблицы имеют четыре уровня, таблицы второго этапа тоже четыре, используются страницы 4 КиБ, все необходимые переводы и промежуточные результаты отсутствуют в кэшах. Для чтения каждой гостевой записи сначала нужен перевод её GPA через второй этап. Только после этого можно прочитать саму гостевую запись и перейти к следующему уровню.
Четыре гостевых уровня дают 4 × (4 + 1) = 20 обращений к метаданным. Затем требуются ещё четыре чтения второго этапа для окончательного GPA данных. Итого получается 24 чтения таблиц и ещё одно целевое обращение — 25 обращений вместе. Дополнительные записи служебных битов, ошибки и иные особенности здесь исключены. Считать 24 полным итогом, уже включающим данные, в этой модели неверно.
Это число не означает 25 реальных походов в DRAM на каждую машинную загрузку. TLB, кэши обхода страниц и обычные кэши процессора сохраняют переводы и записи таблиц, а большие страницы сокращают уровни. Поэтому важна доля промахов и расположение структур памяти. Пример объясняет, почему локальность адресных переводов имеет цену, но не задаёт постоянный коэффициент замедления приложения и не описывает все возможные режимы адресации x86.
TLB и идентификаторы контекста сокращают повторную работу
TLB хранит результаты перевода и связанные разрешения. При успешном попадании процессору не нужно заново проходить все таблицы только ради получения того же отображения. Аппаратная поддержка виртуализации включает способы различать контексты, чтобы сохранённые результаты не смешивались между машинами и адресными пространствами. В Intel один из механизмов называется VPID; в AMD SVM используются ASID со своими архитектурными правилами.
Идентификатор не делает старый перевод правильным после произвольного изменения отображения. Если гипервизор перепривязал страницу или изменил разрешения, нужные кэшированные сведения должны быть инвалидированы предусмотренным способом. В Intel действия с EPT и VPID имеют разные области применения; на AMD используются собственные средства управления. Сводить всё к совету «включить кэш TLB навсегда» нельзя, поскольку корректность доступа важнее сохранения устаревшей записи.
Большое число переключаемых контекстов и широкий случайный набор адресов могут уменьшать эффективность этих кэшей. Два гостя с одинаковым объёмом RAM поэтому способны создавать различную нагрузку на перевод: один последовательно обрабатывает небольшой рабочий набор, другой случайно касается множества страниц. Выделенный объём памяти показывает ёмкость, но не описывает локальность и стоимость каждого доступа.
Большие страницы меняют охват, но требуют условий
Один гибибайт (1 ГиБ) адресного пространства содержит 262144 страницы по 4 КиБ или 512 страниц по 2 МиБ. Для восьмибайтных конечных записей это соответственно 2 МиБ и 4 КиБ только самих записей отображения; верхние уровни таблиц и прочие структуры в эти суммы не включены. Укрупнение страниц может уменьшать объём метаданных и увеличивать охват переводов, но это не автоматическая экономия всей памяти виртуальной машины в 512 раз.
В абстрактном TLB со 128 одинаковыми слотами охват составил бы 512 КиБ для страниц 4 КиБ и 256 МиБ для страниц 2 МиБ. Это сравнение при искусственно равном числе слотов. Реальные процессоры могут иметь разные структуры и ёмкости TLB для разных размеров страниц, поэтому эти цифры нельзя выдавать за характеристики конкретного CPU. Полезен сам принцип: размер страницы меняет количество переводов для того же рабочего набора.
Для большого итогового отображения важны выравнивание, непрерывность физического диапазона, разрешения и возможности обоих этапов. Гость способен использовать большие страницы, а хост — разбить соответствующий диапазон мелкими. Отслеживание грязных страниц, миграция или защита отдельных областей также способны менять режим. Нужно проверять фактическое отображение, а не считать, что одна настройка в интерфейсе гарантирует выбранный размер на всём пути.
Гостевой page fault и нарушение EPT — разные события
Гостевая ОС управляет собственными таблицами страниц. Если её приложение обращается к отсутствующему или запрещённому отображению, возникает гостевое исключение page fault по правилам этой архитектуры. Это может быть нормальная часть ленивого выделения памяти, подкачки или защиты процесса. Наличие такой ошибки ещё не говорит о нарушении изоляции хоста и не означает, что гипервизор обязан завершить машину.
Нарушение разрешений второго этапа относится к другому уровню. В Intel соответствующее условие называют EPT violation; оно может использоваться, например, для обработки ещё не подготовленного отображения или отслеживания записей. Его обработка зависит от настроек, включая предусмотренные архитектурой специальные исключения. Поэтому утверждение «любой EPT violation всегда является обычным гостевым page fault» неверно. Это разные проверки с разными владельцами таблиц.
Нужно также отличать ожидаемое ограничение доступа от неправильно сформированной структуры перевода. В журналах могут фигурировать различные причины, которые нельзя объединять одним словом «память». Для диагностики полезны адресное пространство события, вид доступа, разрешения и контекст машины. Число событий без этой классификации не объясняет, связан ли расход времени с нормальным управлением страницами, устройством MMIO или ошибкой реализации.
Прерывания и часы тоже входят в виртуальную платформу
Устройство завершает операцию в физической системе, но уведомить нужно определённый виртуальный процессор. Между физическим событием и обработчиком гостя могут стоять переназначение прерывания, программная обработка и ожидание запуска нужного vCPU. Аппаратные средства виртуализации контроллеров прерываний сокращают часть этих действий. Названия и условия работы APIC virtualization у Intel и AVIC у AMD различаются; наличие ускорения не отменяет планировщик.
Гость использует часы для таймеров, измерения интервалов и планирования. Однако пауза исполнения vCPU не обязана означать паузу реального времени. После возвращения задача способна обнаружить, что срок таймера уже прошёл. Поэтому измерение задержки внутри ВМ отражает не только скорость выполнявшихся инструкций, но и время, в которое процессор вообще не был предоставлен этой машине.
Уменьшение периода программного таймера не устраняет ожидание физического ресурса. Оно может лишь увеличить частоту событий, которые нужно обслуживать. Для звука, интерактивного управления и сетевых приложений важны распределение задержек и редкие длинные паузы, а не только средний процент загрузки. Настройка виртуального времени требует поддержки гипервизора и гостя; универсального «идеального таймера» для всех ВМ нет.
Устройство можно эмулировать, паравиртуализировать или назначить напрямую
Эмулируемое устройство воспроизводит знакомый гостю аппаратный интерфейс. Это удобно для совместимости, но мелкие обращения к регистрам способны требовать значительной программной обработки. Паравиртуальный интерфейс проектируют с учётом виртуальной среды: гость использует специальный драйвер и обменивается описаниями буферов через согласованные структуры. Он остаётся устройством для гостевой ОС, хотя не повторяет каждую внутреннюю деталь старой физической платы.
Спецификация OASIS virtio описывает такой стандартизованный обмен, включая очереди. Снижение количества мелких уведомлений и пакетная обработка способны экономить работу, но очередь всё равно имеет задержку и ограниченные ресурсы. Термин «паравиртуальный» не гарантирует отсутствие копий во всех конфигурациях: фактический путь зависит от драйвера, сервиса хоста и устройства, которое обслуживает запрос.
При прямом назначении гость получает доступ к определённому физическому устройству или доступной аппаратной функции. Это меняет границы владения, требования к изоляции и возможности совместного использования. Назначение видеокарты не превращает её автоматически в ресурс для нескольких независимых машин. Поддержка разделения функций, сброса и миграции должна существовать в самой платформе и программном стеке, а не только в списке опций менеджера ВМ.
IOMMU ограничивает DMA, но CPU-виртуализация её не заменяет
Устройство способно обращаться к памяти через DMA независимо от обычной загрузки или сохранения команды CPU. Поэтому защита гостевых адресов с помощью EPT или NPT не является полной заменой контроля устройств. IOMMU переводит и ограничивает адреса, используемые назначенным устройством, а дополнительные механизмы работают с прерываниями и другими аспектами изоляции. У Intel VT-x и VT-d разные назначения; один пункт поддержки не доказывает наличие другого.
Документация Linux VFIO объясняет назначение устройств и ограничения групп изоляции. Топология мостов и возможности аппаратуры определяют, какие функции действительно можно отделить друг от друга. Если два устройства не изолированы на нужном уровне, программное переименование группы не создаёт отсутствующую физическую границу. Для корректного назначения также нужны подходящие разрешения, обработка сброса и управление временем жизни буферов.
Прямой путь может уменьшить часть накладных расходов, но усложнить сохранение состояния и перенос машины. Буферы могут быть закреплены в памяти, а внутреннее состояние устройства не обязано поддерживать перенос в произвольный момент. Поэтому сравнивать следует весь результат: производительность, доступность нужных функций и ограничения эксплуатации. «Ближе к железу» не означает автоматически лучший вариант для любой задачи и любого компьютера.
Локальность памяти сохраняет значение внутри виртуализации
Физическая память хоста может относиться к разным NUMA-узлам. При этом гостевая топология способна быть упрощённой или специально сконструированной. Гостевой процессор, его страницы и обслуживающее устройство могут в действительности оказаться на разных физических узлах, даже если в интерфейсе ВМ они выглядят соседями. Дополнительный слой отображения не отменяет реальные межпроцессорные соединения и пропускную способность контроллеров памяти.
Привязка vCPU к определённым исполнителям сама по себе не перемещает все страницы гостя к ближайшему контроллеру. Аналогично увеличение объёма виртуальной RAM не освобождает физическую память. При переподписке, подкачке или возврате страниц через ballooning меняется доступность реального ресурса. Эти механизмы выполняют полезные задачи управления, но их эффект нужно отличать от чистого времени аппаратного перевода адреса.
Полезная конфигурация зависит от размера рабочего набора и связей между потоками. Несколько небольших машин могут делить систему эффективнее одной чрезмерно большой; в другой задаче важна общая память между многими потоками. Универсального правила «выделить гостю всё доступное» нет. Нужны наблюдения за фактическим размещением, ожиданием и пропускной способностью, а также запас для самой управляющей среды.
Вложенная виртуализация добавляет ещё одного владельца машины
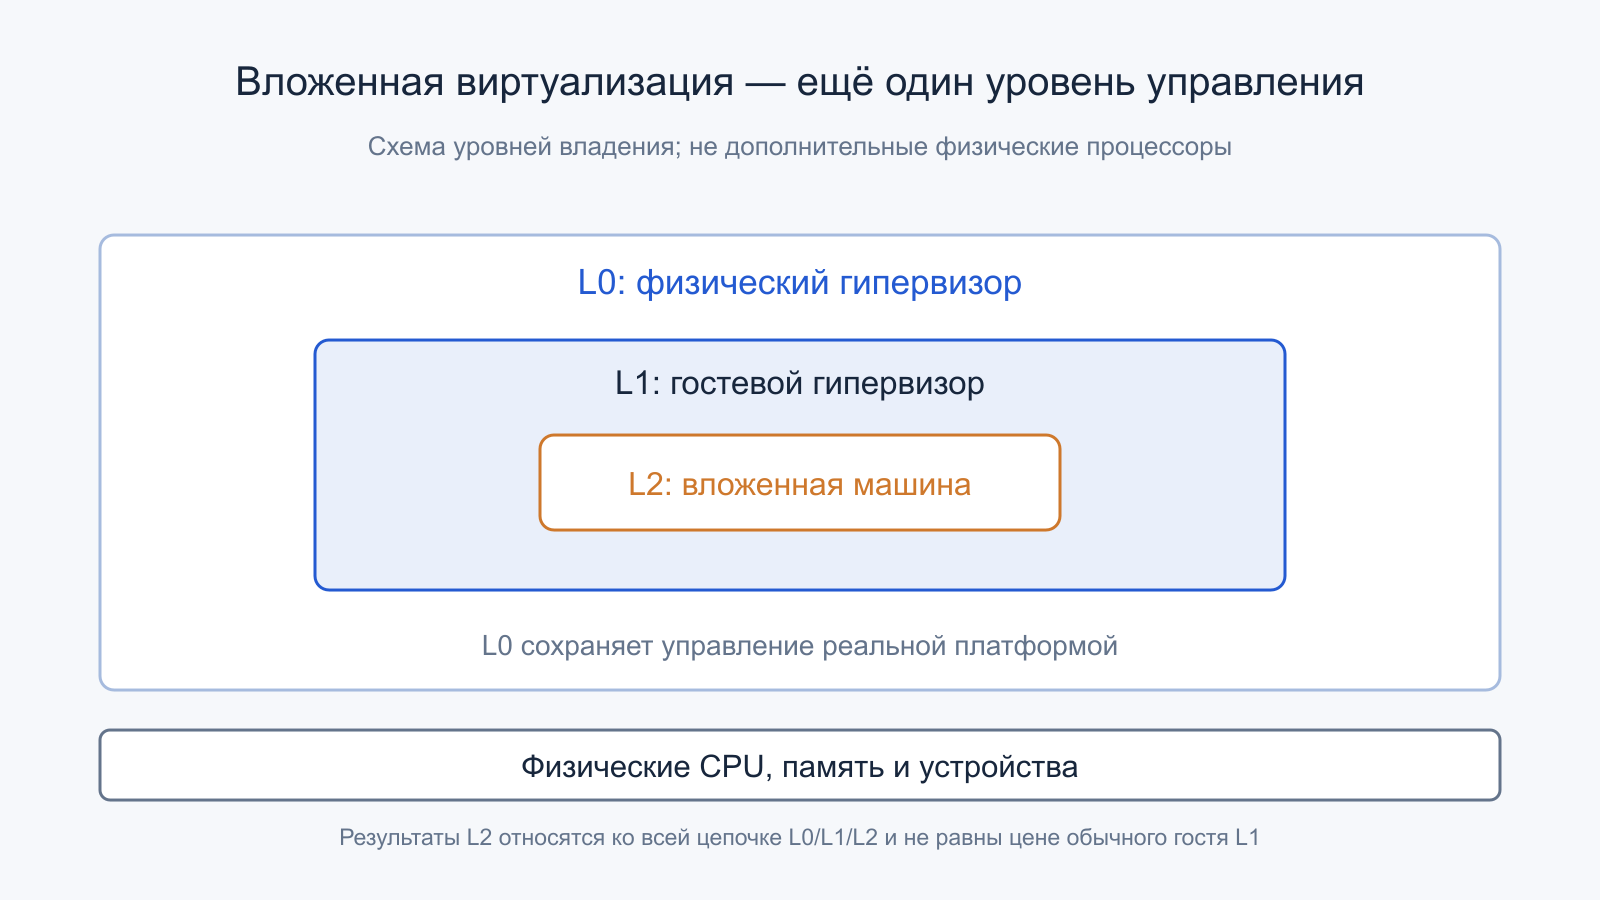
Во вложенной конфигурации физический гипервизор обозначают L0, гостевой гипервизор — L1, а машину внутри него — L2. L1 считает, что управляет аппаратными средствами виртуализации, но в действительности L0 должен предоставлять согласованную модель этих средств и сохранять контроль над физической платформой. Это больше, чем запуск обычного приложения внутри гостевой ОС: появляется дополнительный набор управляемых состояний и адресных отношений.
Документация KVM о вложенных гостях отдельно описывает возможности и ограничения такого режима. Нельзя предполагать, что все аппаратные таблицы буквально проходятся заново каждым слоем при каждом обращении. Реализация способна создавать объединённые отображения, кэшировать сведения и применять аппаратные ускорения. Конкретная поддержка определяется сочетанием CPU, версии гипервизора и возможностей, которые L0 предоставил L1.
Для лаборатории вложенные машины удобны: можно исследовать гипервизор, не выделяя отдельный сервер. Но результаты производительности относятся именно к этой цепочке слоёв. Сравнение вложенного L2 с основной системой не измеряет только стоимость обычной ВМ L1. Нужно указать глубину вложенности, модель CPU, способ устройств и состояние планировщиков всех уровней, иначе цифры теряют ясный технический смысл.
Как измерять издержки, не сводя всё к одному проценту
Сначала задают одинаковый полезный результат: обработать определённый объём данных, выполнить набор запросов или закончить вычисление с теми же параметрами. Затем разделяют процессорное время, реальное время и доступный машине ресурс. Если задача получила только половину физического времени, удвоение длительности нельзя целиком приписать инструкциям виртуализации. Это прежде всего изменение распределения ресурса, которое следует зафиксировать отдельно.
Для ввода-вывода сравнивают путь устройства, размер операций, очереди и кеширование. Ускорение после замены эмулируемого адаптера на паравиртуальный объясняет изменение модели устройства, но не доказывает такую же прибавку для вычислительной задачи. Сравнение памяти требует одинакового рабочего набора и учёта NUMA. Один общий балл смешанного теста полезен лишь для этой смеси, а не для предсказания любой программы.
Нужно сохранять и распределение задержек: медиану, высокие процентили и редкие паузы при достаточном объёме наблюдений. Средняя скорость способна остаться высокой, когда отдельные запросы ждут планирования или обработки устройства значительно дольше. Измерение внутри гостя желательно сопоставлять с наблюдениями хоста, не выдавая ни одно из них за полную картину без проверки определений счётчиков.
Изоляция и конфиденциальная ВМ имеют разные границы
Обычная аппаратная виртуализация помогает отделять гостевые системы и удерживать их обращения в выделенных областях. Но гипервизор входит в доверенную часть этой модели и управляет её ресурсами. Отсюда не следует, что содержимое обычной ВМ автоматически скрыто от администратора физического хоста. Требования к защите от самого хоста относятся к другому набору механизмов и допущений.
AMD описывает семейство SEV как дополнительные средства защиты гостевой памяти и состояния, с различиями между поколениями и расширениями. Конфиденциальность, целостность, аттестация, доступность и защита ввода-вывода — отдельные свойства. Нельзя переносить обещание одного механизма на все возможные каналы обмена, все устройства или любую угрозу только по наличию общего названия технологии.
В результате полезно представлять виртуальную машину как систему договорённостей, поддержанных аппаратурой. CPU обеспечивает контролируемое исполнение, таблицы задают адресные границы, планировщик делит время, а устройства имеют собственный путь. Понимание этих слоёв объясняет и высокую скорость подходящей нагрузки, и реальные издержки. Оно позволяет выбирать конфигурацию по задаче, сохраняя ясные границы каждого вывода.
Официальные первичные источники
- Intel — Intel 64 and IA-32 Architectures Software Developer Manuals: архитектурные определения VMX, управления памятью и событиями; разделы системного программирования.
- Linux Kernel — The x86 KVM shadow MMU: адресные пространства, аппаратный перевод и условия больших отображений.
- OASIS — Virtual I/O Device, virtio 1.3: опубликованный документ Committee Specification Draft 01, очереди и модель паравиртуальных устройств.
- Linux Kernel — VFIO: изоляция DMA, назначение устройств и аппаратные группы.
- Linux Kernel — Running nested guests with KVM: уровни L0/L1/L2 и границы вложенной виртуализации.
- Microsoft — Hyper-V Architecture: пример конкретной организации гипервизора и разделов.
- AMD — Secure Encrypted Virtualization: дополнительные свойства конфиденциальных машин и различия расширений.