Чиплеты и NUMA: почему расположение ядер и памяти влияет на скорость
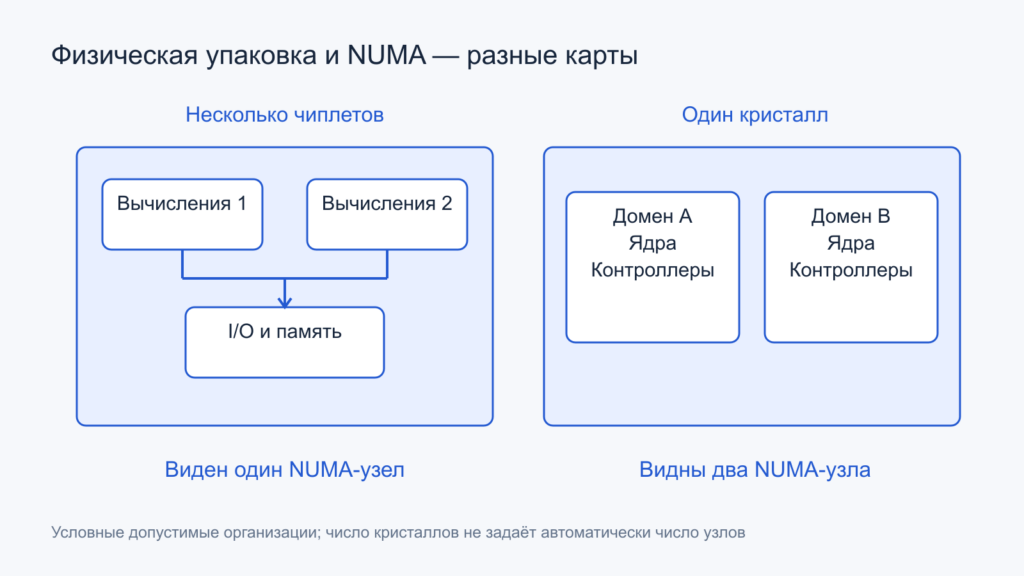
Несколько чиплетов могут представляться одним доменом, а один кристалл — несколькими. Рисунок не описывает конкретную платформу. Открыть иллюстрацию в полном размере.
Многопоточная задача использует все доступные ядра, но после изменения размещения потоков работает быстрее при тех же частотах. Другой процессор состоит из нескольких кристаллов, а ОС показывает один NUMA-узел. На двухсокетном сервере перенос потока не переносит автоматически его гигабайты памяти. Эти случаи связаны с топологией: путь к данным зависит от того, где находятся вычисления, страницы и общие ресурсы.
Чиплеты описывают физическую организацию процессора, NUMA — неравномерность доступа и её представление системе. Между ними есть связь, но нет равенства. Для объяснения производительности нужны как минимум три карты: кристаллы и межсоединения, группы кэшей, узлы памяти и процессоров, которые видит ОС. Затем к этим картам добавляют реальное размещение работы приложения.
Содержание статьи
- Что меняет разделение процессора на кристаллы
- NUMA: общие адреса, разные пути к памяти
- Кэшовая близость и локальность DRAM — разные уровни
- Один сокет может представляться несколькими узлами
- Локальный и удалённый запрос: цена зависит от направления
- Полоса удалённого пути может закончиться раньше памяти
- Память размещается, когда появляются физические страницы
- Affinity потоков и политика памяти должны согласовываться
- Политики локальности, привязки и чередования
- Баланс работы иногда важнее идеальной близости
- Общие изменяемые данные создают межузловой обмен
- Перенос страниц сохраняет адрес, но требует работы
- Виртуальная машина добавляет ещё одну карту
- Ввод-вывод тоже имеет локальность
- Как проверить гипотезу о локальности
- Официальные источники
- Читайте также
Что меняет разделение процессора на кристаллы
В чиплетной конструкции функции распределяются между несколькими кристаллами внутри общей системы корпуса. На одном могут находиться вычислительные ядра, на другом — ввод-вывод и контроллеры памяти, на третьем — дополнительный кэш. Разные функции способны использовать разные технологические процессы. Но число чиплетов не определяет автоматически скорость готового процессора.
Обмен через межкристальное соединение имеет собственные задержку, полосу и энергетическую цену. Это не означает, что чиплетный CPU обязательно проиграет монолитному: важны весь проект, количество ресурсов, кэши и характер нагрузки. Нельзя оценить полезный результат по одной геометрической границе, не проследив фактический путь данных.
В монолитном кристалле расстояния и общий обмен тоже не бесплатны. Разные группы ядер способны иметь разные кэшовые и контроллерные пути. Следовательно, противопоставление «один кристалл — одинаковый доступ» и «несколько кристаллов — обязательно NUMA» неверно в обе стороны. Физическая упаковка и программная модель решают разные задачи.
Чиплеты также не обязаны совпадать по назначению. Вычислительный кристалл и I/O-кристалл нельзя считать двумя равными процессорами. Дополнительный кристалл кэша не создаёт новый набор ядер. Даже внутри одного семейства количество активных блоков и конфигурации различаются, поэтому рисунок корпуса не заменяет документацию точной модели.
NUMA: общие адреса, разные пути к памяти
Non-Uniform Memory Access означает, что стоимость доступа к памяти зависит от расположения инициатора и целевой области. Процесс может видеть единое адресное пространство, хотя физические страницы относятся к разным узлам. «Удалённая» память при этом остаётся обычной адресуемой памятью системы, а не файлом на соседнем компьютере.
Классический пример — несколько процессорных сокетов со своими контроллерами DRAM. Ядро обращается к локальной памяти через ближайший контроллер, а к памяти другого сокета — через межпроцессорную связь и удалённый контроллер. Добавляются этапы и возможная конкуренция за общий канал. NUMA может существовать и внутри одного сокета.
Microsoft описывает NUMA как организацию с разной близостью процессоров и памяти и средствами предоставления этой топологии приложениям. Представление может быть сложнее простой пары «CPU плюс RAM»: встречаются узлы без процессоров, разные типы памяти и более подробные отношения близости.
Один видимый NUMA-узел не доказывает равенство всех задержек между ядрами и кэшами. Он означает определённое представление локальности памяти. Аналогично несколько видимых узлов не позволяют восстановить число физических кристаллов простым подсчётом. Прошивка и конфигурация способны менять доступную ОС группировку.
Кэшовая близость и локальность DRAM — разные уровни
Два потока могут разделять близкий общий кэш, но обращаться к страницам на удалённом узле DRAM. Другие потоки могут иметь локальную память, но общаться через более дорогую кэшовую границу. Для задачи с повторным использованием небольших данных важен первый путь, для большого потокового массива — другой. Одно слово «локально» без указания ресурса неполно.
Ядра, потоки SMT, группы последнего уровня кэша, сокеты и NUMA-узлы составляют разные уровни топологии. Номера логических CPU не обязаны отражать физическое соседство. Последовательные номера узлов также не гарантируют меньшую дистанцию. Приложение должно получать реальные отношения из документированных интерфейсов, а не угадывать их по индексам.
В семейной терминологии AMD используются CCD и CCX, но их состав менялся. В обзоре EPYC 7003 описаны вычислительные CCD, общий I/O-кристалл и соответствующая организация кэша поколения Zen 3. Эти названия и размеры нельзя без проверки переносить на все Ryzen, EPYC и последующие поколения.
Практический вывод не требует запоминать только фирменные сокращения. Нужно установить, какие ядра разделяют последний кэш, где находятся контроллеры памяти и как устроен путь между группами. Тогда изменения конфигурации объясняются через доступные ресурсы, а не через предположение, что любой CCD обязан быть отдельным NUMA-узлом.
Один сокет может представляться несколькими узлами
Для определённых EPYC 7003 настройка NPS задаёт NUMA Nodes Per Socket. В описанной AMD организации NPS1 представляет один домен на сокет с соответствующим чередованием каналов, NPS4 — четыре домена с иной группировкой контроллеров. Число физических сокетов от этого не меняется. Это семейный пример, а не универсальный переключатель для любого CPU.
Руководство AMD по EPYC 7003 и RHEL отдельно рассматривает NPS и представление LLC как NUMA. В указанной конфигурации с восемью CCD количество видимых доменов может зависеть и от дополнительного режима представления кэшей. Одно изменение группировки не следует выдавать за появление новых контроллеров или памяти.
Такие режимы меняют возможности размещения и ожидания ОС, а иногда также чередование физических каналов. Поэтому их нельзя считать косметическим переименованием узлов. Но и правило «больше узлов всегда быстрее» не работает: NUMA-осведомлённая нагрузка и приложение, не управляющее размещением, могут реагировать по-разному.
В этой статье не предлагается готовый режим прошивки. Сначала изучают опубликованную топологию конкретной платформы и характер задачи. Настройка, полезная для изолированных независимых работников, может оказаться неудобной для общей структуры данных, которую постоянно меняют все ядра.
Локальный и удалённый запрос: цена зависит от направления
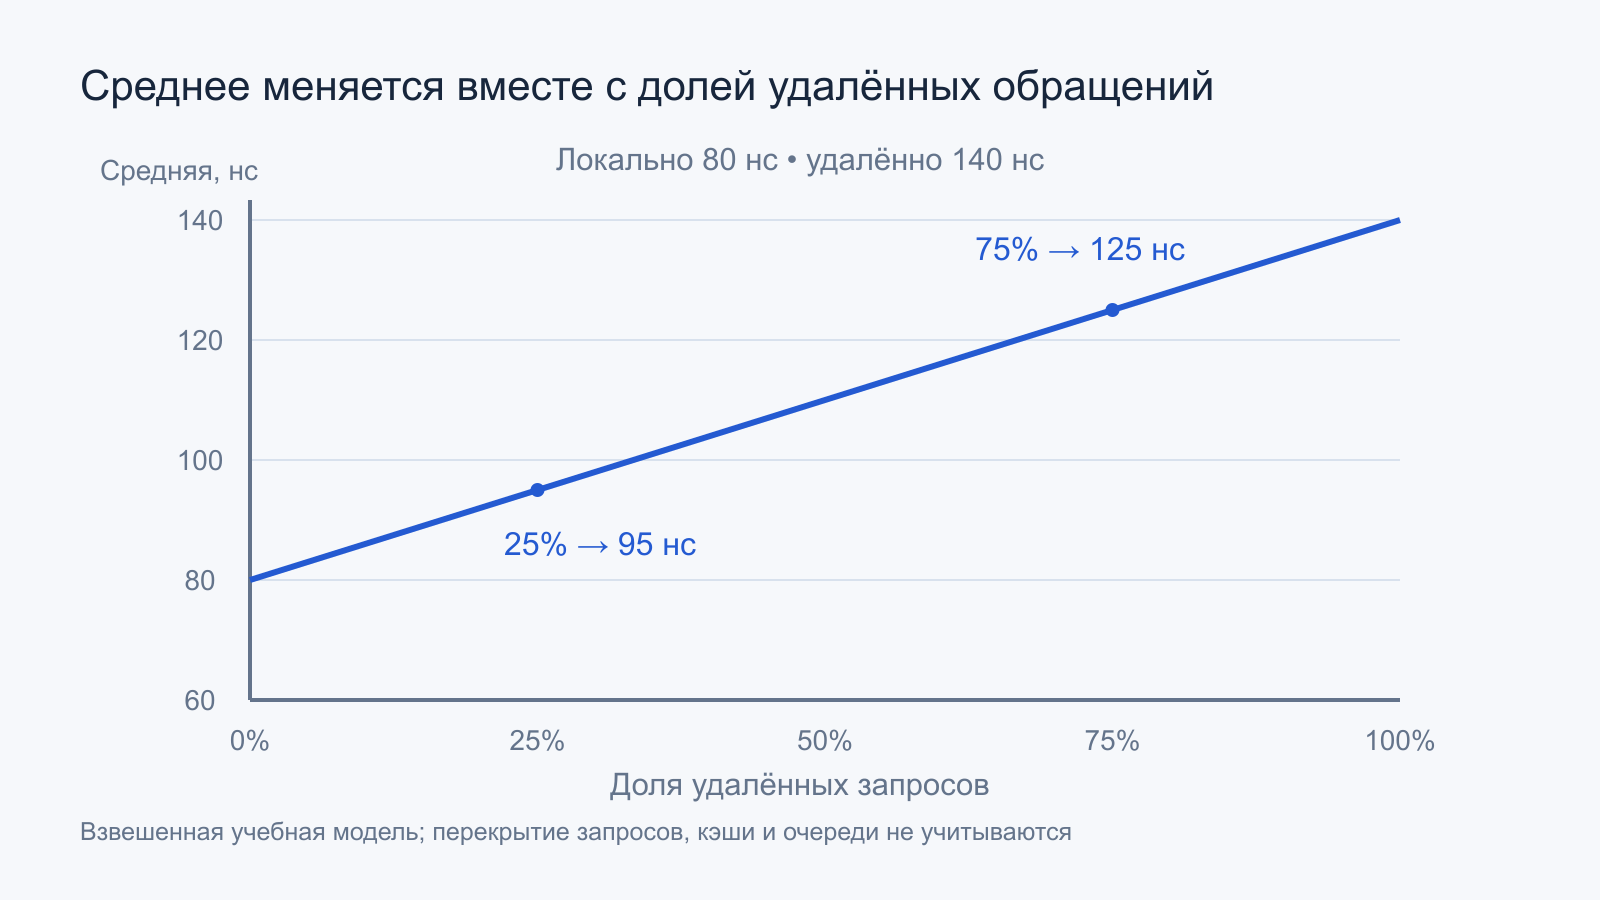
На учебной системе ядро узла A получает локальные данные за 80 нс, а данные узла B — за 140 нс при заданных условиях. Дополнительное время может включать межузловой путь и другие этапы. Эти числа не относятся к конкретной платформе и не заменяют измерение под нагрузкой.
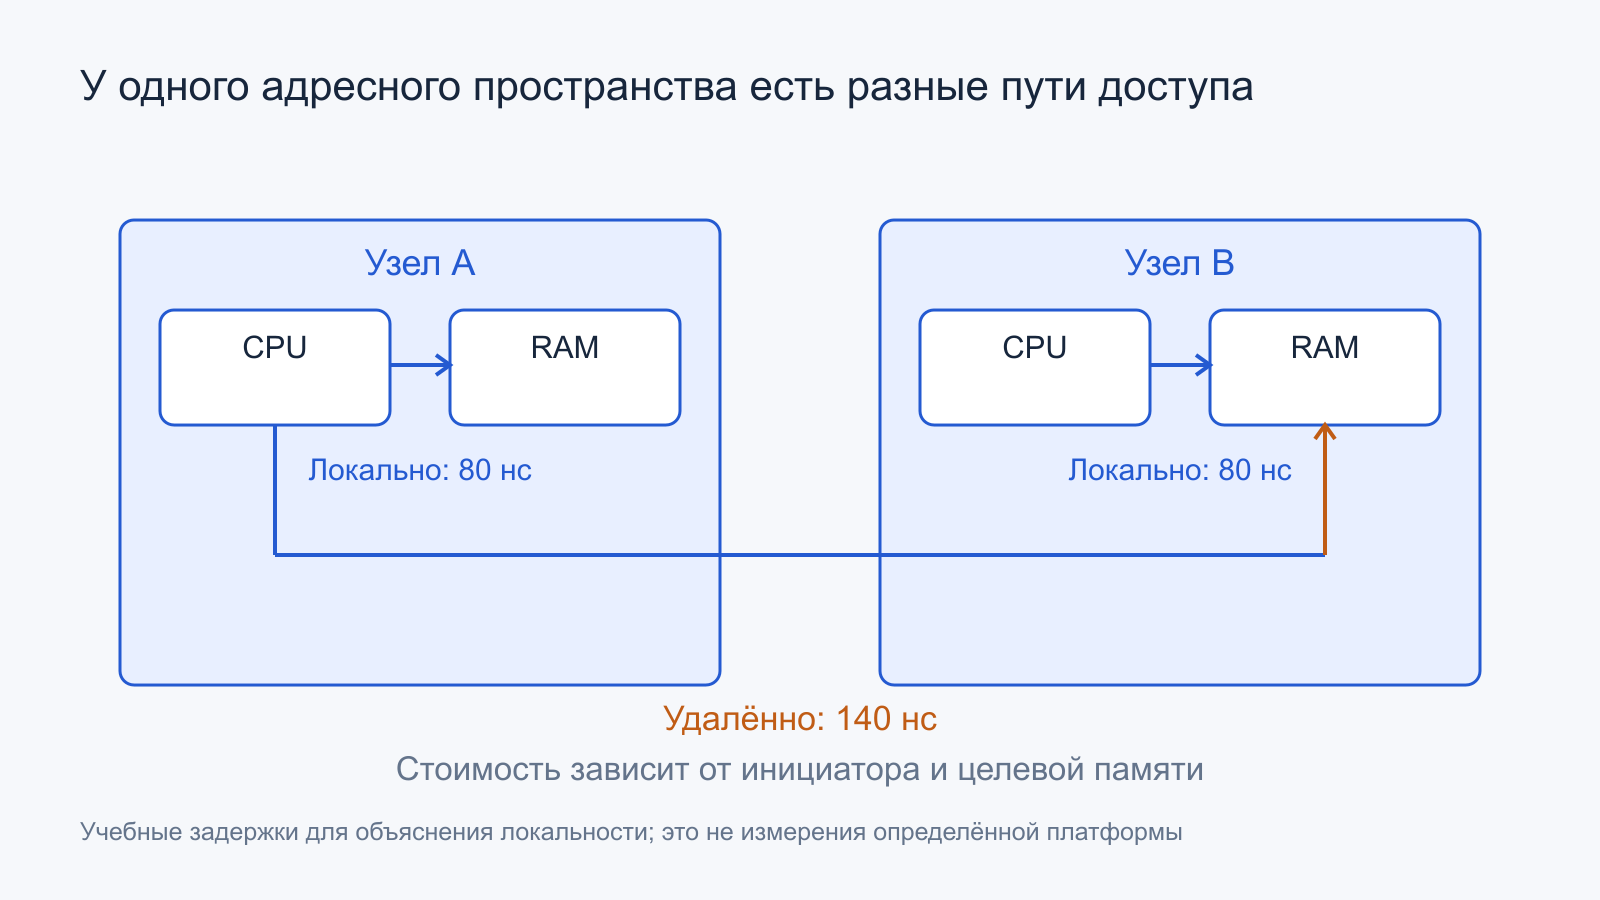
Если 75% запросов локальные и 25% удалённые, взвешенное среднее равно 0,75 × 80 + 0,25 × 140 = 95 нс. При 75% удалённых оно вырастет до 125 нс. Для миллиона строго последовательных зависимых обращений получаются 95 и 125 мс в модели без других затрат. Разница около 31,6% не требует изменения частоты ядра.
Такую среднюю задержку нельзя умножать на все загрузки любой программы. Независимые запросы перекрываются, данные попадают в кэши, а высокая нагрузка меняет очередь и сами задержки. Взвешивание полезно для понимания чувствительности к локальности, пока известны границы модели и структура зависимостей.
Расстояния, предоставляемые прошивкой, могут быть относительными оценками, а не наносекундами. Значение 20 рядом с 10 не обязательно означает измеренные 20 и 10 нс. Матрица близости помогает сравнивать узлы; фактическая стоимость зависит от типа операции, направления, нагрузки и аппаратуры.
Полоса удалённого пути может закончиться раньше памяти
У каждой группы DRAM есть своя доступная полоса, а межузловое соединение создаёт дополнительную общую границу. Если много ядер обращается к памяти одного удалённого узла, они нагружают и этот контроллер, и соответствующий канал обмена. Сумма свободной полосы всей системы не обещает доступ к ней из одной точки.
Учебный восходящий путь переносит 32 ГБ/с полезных данных в одном направлении. Две группы требуют по 20 ГБ/с удалённого чтения, то есть 40 ГБ/с. Такой спрос не поместится в выбранный канал, даже если удалённая DRAM отдельно способна обслужить больше. Дополнительный когерентный обмен может уменьшить доступную долю полезного трафика.
Одновременные направления тоже рассматривают отдельно по возможностям конкретного межсоединения. Нельзя автоматически сложить полнодуплексную величину и отдать всю сумму одному потоку чтения. А низкая средняя загрузка канала за секунду способна скрыть короткие насыщенные интервалы, важные для задержки отдельного этапа.
Локальность помогает убрать лишние переходы, но не отменяет предел локального контроллера. Разместить всё на одном узле иногда означает перегрузить его память, оставив другие каналы свободными. Для некоторых потоковых задач распределение данных оказывается полезнее минимизации каждой отдельной удалённой операции.
Память размещается, когда появляются физические страницы
Получение виртуального диапазона не всегда означает немедленное выделение всей физической RAM. При первом реальном использовании страниц ОС применяет действующую политику и доступные ресурсы. Поэтому поток, который инициализирует большой массив, способен определить его начальное физическое размещение сильнее, чем поток, позже выполняющий основную обработку.
Выражение first touch удобно, но не является универсальным правилом «первый прочитавший байт владеет памятью». Важны запись или чтение, общая нулевая страница, файловое отображение, большие страницы, уже существующие данные и политика ОС. Для ясного учебного примера далее предполагаются новые частные страницы, выделяемые при инициализирующей записи.
Linux NUMA Memory Policy разделяет системную, потоковую и региональную политику, а также объясняет применение к новым выделениям. Изменение политики само по себе не обещает мгновенного перемещения ранее размещённых страниц. Требования и области действия нужно проверять для конкретного механизма.
Почему последовательная инициализация может мешать параллельной работе
Пусть учебный массив 1 ГиБ обрабатывают четыре работника по 256 МиБ: двое на узле A, двое на B. Если один поток на A заранее записал весь массив при локальной политике, все страницы могут оказаться на A. Тогда работники B будут обращаться удалённо к своей половине массива, хотя деление вычислений выглядит равномерным.
При согласованной параллельной инициализации каждый работник может впервые записать свой участок там, где будет его обрабатывать. В модели половина страниц окажется на A, половина на B. Локальными становятся и вычисления, и данные. Но результат требует сохранения размещения работников и допуска политики; один только вызов многопоточной обработки этого не гарантирует.
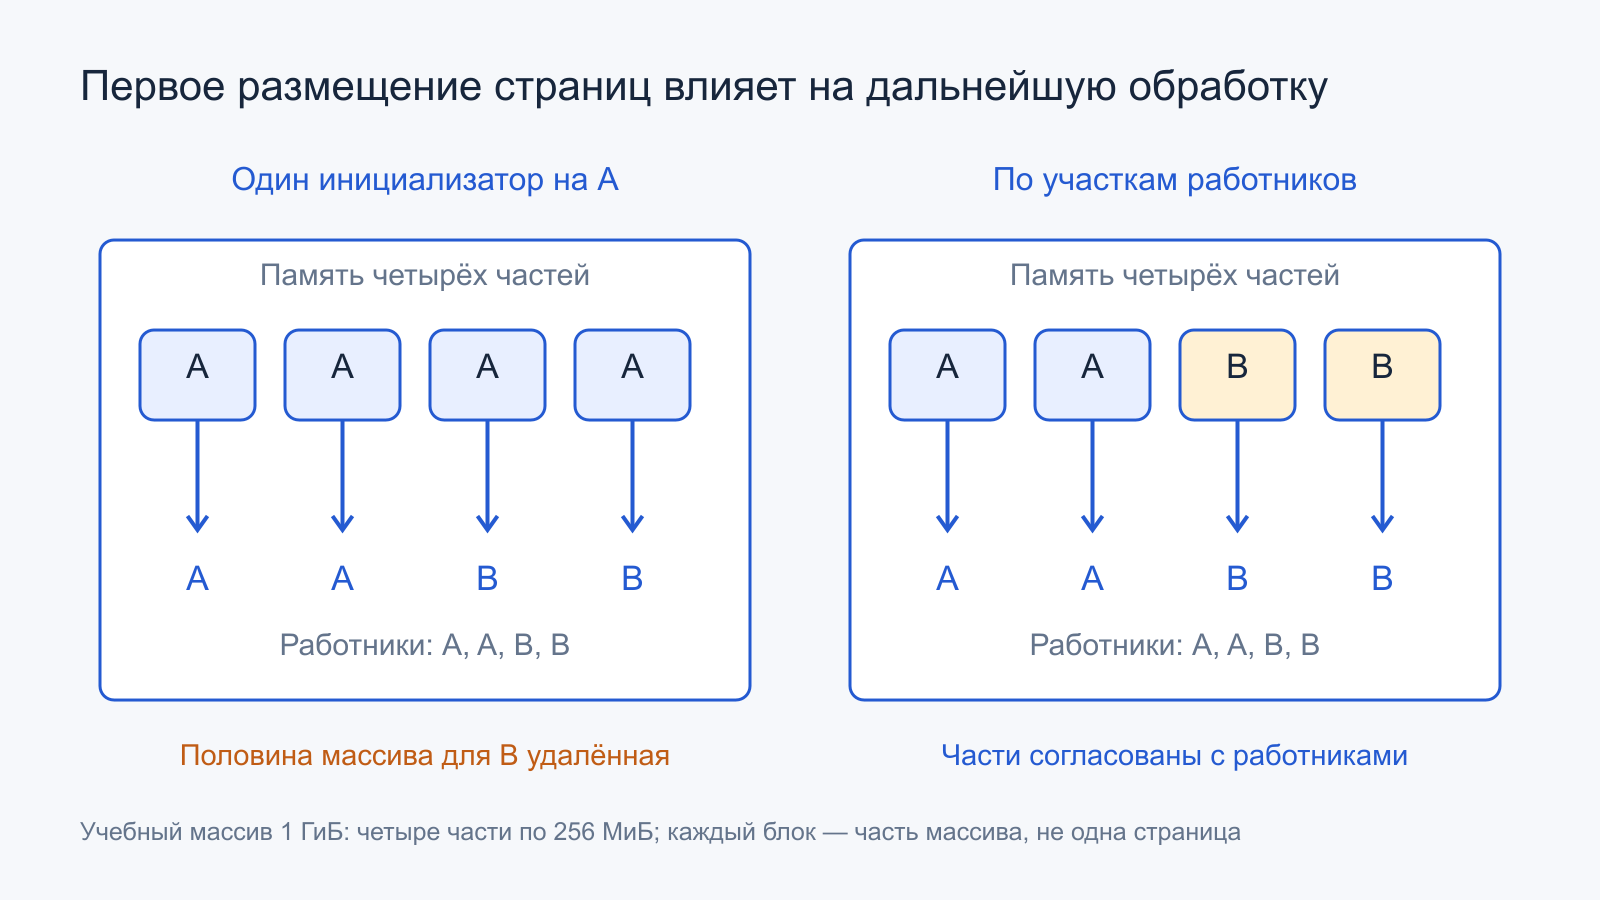
При страницах по 4 КиБ весь 1 ГиБ содержит 262 144 страницы, а участок 256 МиБ — 65 536. Граница распределения проходит по страницам, не по произвольному элементу массива. Если несколько работников впервые трогают одну страницу или ОС применяет крупную страницу, простая схема «по своему байту» может дать другой результат.
Affinity потоков и политика памяти должны согласовываться
Закрепление потока ограничивает, где он исполняется; политика памяти определяет, откуда берутся страницы при соответствующих выделениях. Это разные действия. Если закрепить работника на B, сохранив массив на A, локальность может ухудшиться. Если распределить страницы и затем свободно перемещать работников, начальное преимущество тоже может исчезнуть.
Open MPI рассматривает процессорную и память-зависимую affinity совместно. Для приложений с обменом важна также близость участников друг к другу. Но жёсткое закрепление при избытке работников и недостатке вычислительных ресурсов способно ухудшить расписание. Affinity — инструмент выражения структуры задачи, а не универсальная кнопка ускорения.
Планировщик решает и другие задачи: балансирует очередь, учитывает приоритеты, доступные ядра и общую активность. Сохранить горячий кэш полезно, но оставить поток долго ждать свободного ядра может быть хуже. Поэтому факт миграции не доказывает ошибку ОС. Правильность оценивают по результату и стоимости всего этапа.
Также нужно различать миграцию потока и миграцию страниц. Первое меняет исполнителя в расписании, второе требует операций с физической памятью. Они могут происходить раздельно и на разных временных масштабах. Большой массив не переезжает вместе с контекстом потока за одну короткую операцию.
Политики локальности, привязки и чередования
Локальное выделение стремится разместить новые страницы ближе к выполняющему потоку, если условия это позволяют. Предпочтительный узел допускает оговорённый резервный выбор. Более строгая привязка ограничивает допустимое множество, а чередование распределяет страницы между узлами по определённому правилу. Точная семантика задаётся ОС и областью политики.
Чередование полезно, когда нужна полоса нескольких контроллеров и запросы достаточно распределены. Для потока на одном узле часть обращений станет удалённой, зато общий контроллер перестанет быть единственной точкой нагрузки. Для зависимой структуры с небольшой рабочей областью такое распределение может оказаться хуже компактной локальности.
При недостатке свободной локальной памяти поведение зависит от политики: возможен выбор другого узла или невозможность удовлетворить запрос в заданных границах. Поэтому суммарный объём свободной RAM не описывает доступность памяти в каждом домене. Ограничения контейнера или административной группы также могут сузить допустимое множество.
Не существует одной политики для общего кэша, огромной базы данных и независимых пакетных работников. Сначала определяют, какие данные разделяются, кем и как часто меняются. Затем выбирают распределение, которое уменьшает наиболее дорогую часть пути без создания нового перегруженного узла.
Локальная ёмкость отличается от общей свободной памяти
В учебной системе на A свободно 2 ГиБ, на B — 62 ГиБ. Суммарные 64 ГиБ не позволяют немедленно разместить новый буфер 8 ГиБ целиком в текущем свободном запасе A. Потребуется другое размещение, освобождение памяти или иное действие в рамках политики. Закрепление всех работников на A не создаст недостающие локальные страницы.
Это объясняет, почему одинаковая нагрузка при другой предыстории памяти способна получить иную долю удалённых обращений. Система после перезапуска и система с длительно работающими соседними задачами могут различаться по доступности узлов. Для сравнения фиксируют не только общий расход RAM, но и распределение по доменам, не превращая учебные числа в гарантию поведения конкретного аллокатора.
Баланс работы иногда важнее идеальной близости
Предположим, две учебные группы одинаковой производительности обрабатывают независимые части. На A приходится 90 единиц работы, на B — 10, каждая группа выполняет одну единицу за миллисекунду. Полное время равно 90 мс. Идеальное равномерное деление тех же 100 единиц дало бы 50 мс без расходов перераспределения.
Если более равномерное распределение требует удалённого доступа и увеличивает длинный этап до 70 мс, оно всё ещё быстрее исходных 90 мс. Это условный пример компромисса, а не измерение NUMA-системы. Он показывает, почему минимальный remote-процент не является самостоятельной целью и почему планировщик иногда оправданно переносит работу через границу узла.
Практическое разбиение ищет устойчивый баланс вычислений, памяти и обмена. Крупные независимые порции удобно держать локальными, а редкие общие этапы выполнять отдельно. Но если стоимость порций заранее неизвестна, жёсткое закрепление может создать простой одних исполнителей при перегрузке других. Локальность и гибкость расписания оцениваются вместе по времени всей задачи.
Общие изменяемые данные создают межузловой обмен
Когерентность позволяет ядрам видеть согласованные данные, но поддержание этого свойства требует сообщений и передачи прав на строки. Когда потоки разных узлов часто изменяют одну и ту же строку, локальность одной страницы не делает все записи локальными. Право изменения и актуальное содержимое продолжают переходить между участниками.
Ложное совместное использование усиливает эффект: разные счётчики могут находиться в одной строке, хотя логически независимы. На многосокетной системе цена такой конкуренции способна включать межузловой путь. Разделение локальных накопителей и более редкое объединение результатов иногда уменьшает обмен сильнее, чем простое перемещение страницы.
Однако репликация данных тоже имеет цену. Для общих только читаемых структур можно держать копии ближе к потребителям, но потребуется дополнительная память и согласованное обновление при изменениях. Для часто изменяемой общей структуры копии не отменяют необходимость синхронизации. Топология подсказывает компромисс, а не универсальную замену алгоритму.
Особенно важно различать домашний узел страницы и место нахождения свежей строки в кэше. Обращение к странице удалённого узла может обслужиться ближе при наличии нужной копии, а локальная страница может требовать когерентного обмена с другим ядром. Процент remote DRAM относится к выбранным аппаратным событиям, а не ко всем обращениям программы вообще.
Перенос страниц сохраняет адрес, но требует работы
ОС способна переместить физическое содержимое на другой узел, сохранив виртуальный адрес процесса. Нужно подготовить новую страницу, согласовать доступ, перенести данные и обновить отображения. Некоторые страницы могут быть временно или постоянно непригодны для переноса, например из-за действующего удержания другим участником. Успех нельзя считать мгновенным и безусловным.
Документация Linux Page Migration описывает смену физического положения при сохранении виртуального представления и несколько этапов согласования. Это фундаментальное отличие от переноса потока. Автоматические механизмы балансировки, если они доступны и включены, тоже расходуют ресурсы и реагируют на наблюдаемую историю.
Учебная нижняя оценка копирования 1 ГиБ при эффективном темпе переноса полезного содержимого 10 ГБ/с равна примерно 107,4 мс. Здесь гигабайт в секунду десятичный, а гигабайт исходного объёма двоичный. Под темпом уже понимается завершённое копирование данных, поэтому повторно удваивать время за чтение и запись в этой формуле нельзя.
Дополнительные расходы могут увеличить полную цену. Если принять её в другой условной модели равной 120 мс, а экономию на каждом последующем зависимом обращении — 30 нс, перенос окупится примерно после четырёх миллионов таких обращений. При коротком оставшемся этапе его стоимость может не вернуться.
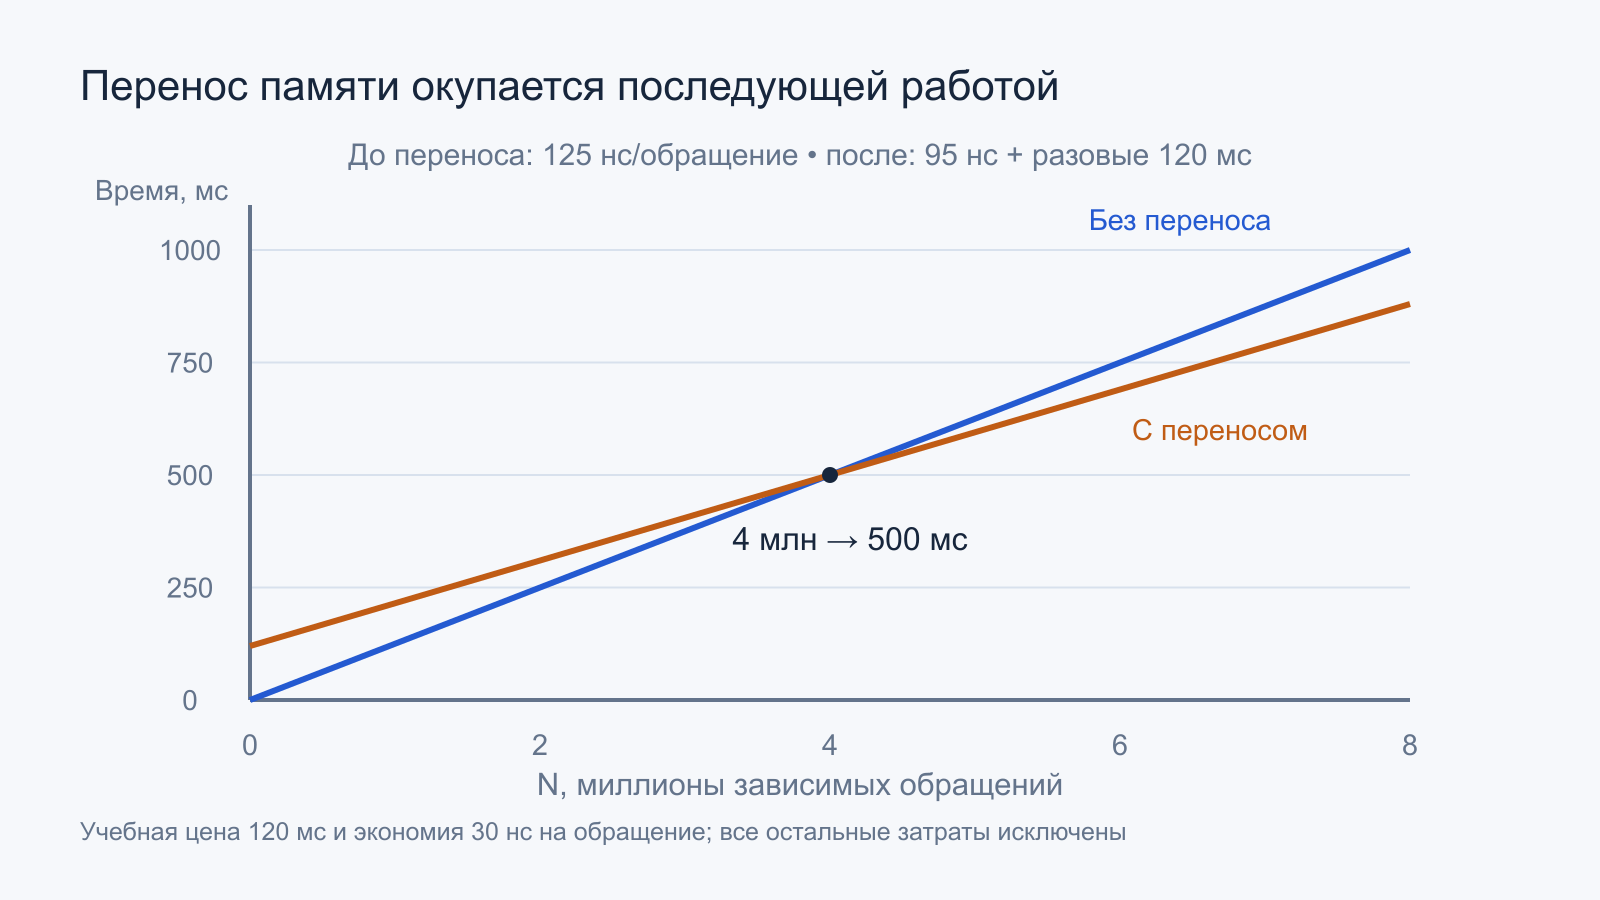
Частая смена владельца данных способна вызвать невыгодное движение туда и обратно. Поэтому автоматике и приложению важно учитывать устойчивость размещения, а не реагировать на каждое краткое изменение. Большая страница дополнительно связывает судьбу многих соседних данных: перенос ради одной горячей части затрагивает больший объём.
Виртуальная машина добавляет ещё одну карту
Гость видит виртуальные процессоры и виртуальные NUMA-узлы, которые гипервизор отображает на физическую систему. Хорошая локальность внутри гостя не доказывает локальность физической памяти хоста. Распределение vCPU, физические страницы и доступные ресурсы должны согласовываться на обоих уровнях.
Изменение конфигурации, давление памяти и другие виртуальные машины способны изменить исходные условия. Слишком крупная виртуальная группа может пересекать аппаратные границы, даже если приложение предполагает близость. Но и слишком подробная искусственная топология не обязана помочь программе, не умеющей её использовать. Анализ требует фактической карты хоста и гостя.
Ввод-вывод тоже имеет локальность
PCIe-контроллер устройства связан с определённой частью платформы. DMA-буфер, обработчик очереди и поток приложения могут находиться на разных узлах. Поэтому путь сетевого пакета или результата ускорителя зависит не только от места вычислений. Нужно совместно рассматривать устройство, память и обработку завершения.
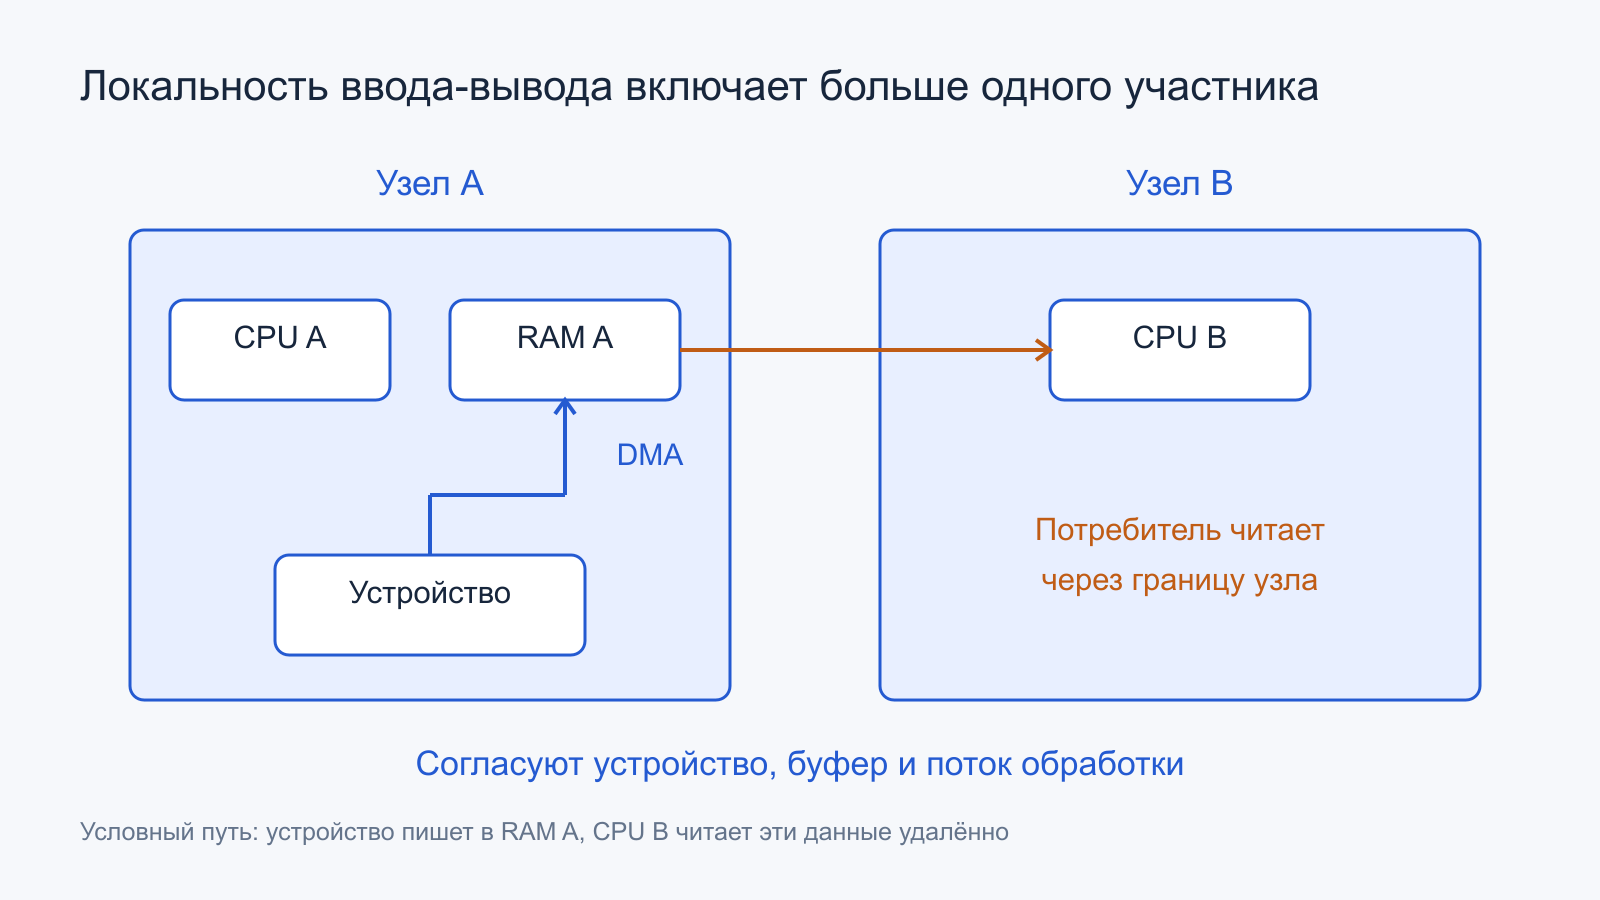
Если карта подключена к узлу A, буфер находится на A, а потребитель на B, последующее чтение способно пересечь межузловую границу. Перемещение буфера на B может изменить уже маршрут записи устройством. Решение выбирают по преобладающему трафику, аппаратной топологии и поддержке стека, а не по правилу «всегда ближе к CPU».
Для нескольких очередей можно согласовать обработку и области данных с соответствующими работниками, но конкретные механизмы определяются драйвером и ОС. Пользовательское приложение не всегда управляет всеми промежуточными буферами. Обещать локальность всего пути по одной настройке affinity было бы слишком сильным выводом.
Как проверить гипотезу о локальности
Сначала получают реальную топологию: группы кэшей, логические CPU, NUMA-узлы, память и устройства. Затем фиксируют политику размещения и выясняют, где уже находятся страницы. Изменение будущей политики без контроля существующих данных создаёт ложный опыт: команда выглядит новой, а физическая картина остаётся прежней.
Сравнивают время одной и той же работы, распределение обращений и нагрузку на общие пути. Отдельно рассматривают начальную инициализацию, прогрев кэшей и длительный этап. Для задачи с большим потоком важна полоса, для зависимой цепочки — задержка, для общей очереди — синхронизация и кэшовый обмен.
Контролируемый учебный опыт меняет одно размещение, сохраняя число потоков и данные. Но после изменения нужно проверить частоты, нагрузку соседних процессов и давление памяти: они способны изменить результат независимо от NUMA. Отдельный высокий remote-процент не доказывает, что именно он ограничивает полное время приложения.
- Чиплеты, сокеты, общие кэши и NUMA-узлы различены.
- Понятны расположение потоков и физическое размещение страниц.
- Инициализация и основная обработка согласованы с политикой памяти.
- Латентность отделена от полосы и общей конкуренции за канал.
- Учтены цена синхронизации и движение изменяемых строк.
- Перенос страниц имеет конечную стоимость и срок окупаемости.
- Для ввода-вывода и виртуализации проверены дополнительные уровни карты.
Локальность — это согласование вычислений и данных во времени. Физические чиплеты создают возможности и ограничения, а ОС и приложение определяют, как ими воспользоваться. Когда каждый важный запрос связан с понятным маршрутом, различия производительности объясняются через конкретную работу системы, сохраняя границы учебных моделей.
Официальные источники
- AMD — Overview of EPYC 7003 Series Processors Microarchitecture: CCD, I/O-кристалл и семейная NUMA-топология.
- AMD — RHEL Tuning Guide for EPYC 7003: NPS и представление LLC как NUMA.
- Microsoft — NUMA Architecture: узлы, память и программное представление топологии.
- Linux Kernel Documentation — NUMA Memory Policy: области действия и режимы распределения.
- Linux Kernel Documentation — Page Migration: перенос физических страниц и согласование отображений.
- Open MPI — Processor and Memory Affinity: совместное размещение вычислений и данных.