Когерентность кэшей: MESI, false sharing и цена обмена между ядрами
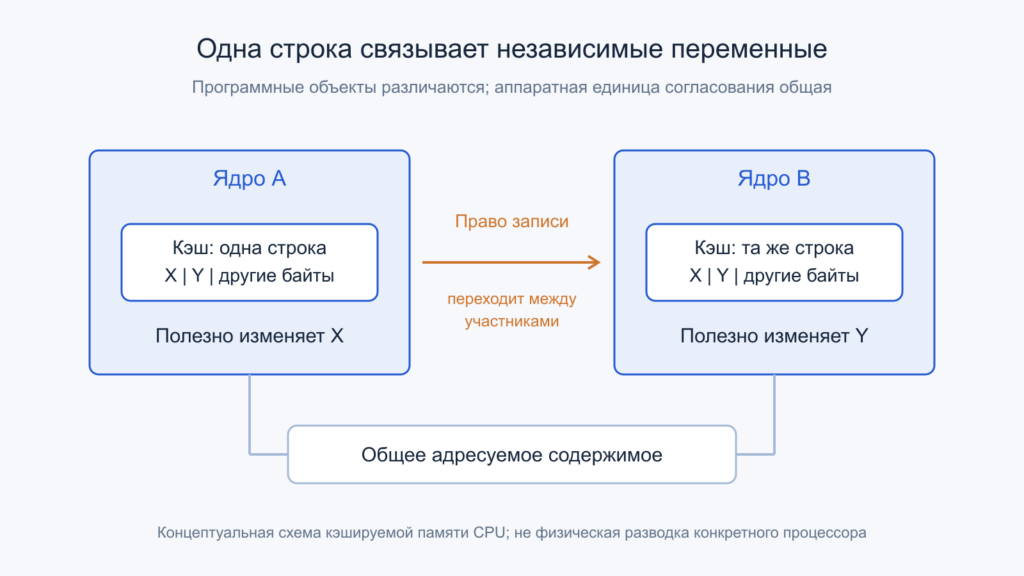
Программные счётчики независимы, но относятся к общей единице когерентности. Передача владения не обязана проходить через DRAM. Открыть иллюстрацию в полном размере.
Два потока увеличивают разные счётчики, не используют общий замок и почти не обращаются к оперативной памяти. Тем не менее добавление второго ядра способно замедлить работу. Причина бывает в том, что разные переменные оказались внутри одной строки кэша: программе они принадлежат независимо, а аппаратуре приходится согласовывать право изменять весь участок. Разберём, какую задачу решает когерентность, как читать состояния MESI и почему передача нескольких полезных байтов между ядрами может стоить значительно больше локальной арифметики. Все задержки и размеры в расчётных сценариях ниже условны; это модели причин, а не результаты испытаний конкретного процессора.
Содержание статьи
- Общая память не означает единственную физическую копию
- Почему единицей согласования служит строка
- Четыре состояния MESI: что именно они обещают
- Несколько читателей могут обходиться без постоянного трафика
- Запись требует права, а не обязательной немедленной выгрузки
- Один учебный обмен: разные переменные, одна строка
- Snoop и directory: как найти других участников
- Почему общий L3 не устраняет все конфликты
- Когерентность не заменяет порядок памяти и синхронизацию
- Атомарные счётчики: правильный результат тоже имеет цену
- False sharing бывает и между записью и чтением
- Выравнивание начала и шаг массива проверяются вместе
- Численная модель: важна частота передачи владения
- Изменение алгоритма иногда полезнее padding
- Как подтвердить причину без выдуманной точности
- Практический порядок разбора
- Первичные источники
- Читайте также
Общая память не означает единственную физическую копию
Ядра работают с общей адресуемой памятью, но держат нужное содержимое в своих кэшах. Если ядро A изменило значение, а ядро B продолжает пользоваться старой копией, обычная модель совместной работы нарушается. Когерентность обеспечивает согласование копий одного адресуемого содержимого: запрос другого участника должен получить допустимое актуальное значение, а конкурирующие изменения — разрешиться предусмотренным образом. Это обязанность аппаратной системы для соответствующей когерентной области, а не фоновая периодическая сверка всей RAM.
При этом содержимое DRAM не обязано обновляться после каждой инструкции записи. В системе с write-back свежие данные некоторое время находятся в изменённой строке кэша. Другой участник может получить их через когерентный путь, пока оперативная память ещё содержит прежнее представление. Поэтому «общее значение» и «последние байты уже записаны в микросхемы памяти» — разные утверждения. Свежесть определяется всей согласованной иерархией, включая владельца изменённой копии.
Здесь рассматривается обычная кэшируемая память CPU. Отображения устройств, некогерентный DMA и специальные типы памяти имеют дополнительные правила. Нельзя переносить рассуждение о двух ядрах на произвольную периферию только потому, что у буфера есть адрес. Прикладной программе эти различия обычно скрывает ОС, а драйвер обязан пользоваться предусмотренными средствами платформы.
Почему единицей согласования служит строка
Аппаратура хранит теги и состояния не для каждой переменной языка, а для блоков фиксированной гранулярности. В дальнейшем используем учебную строку 64 байта, распространённую во многих процессорах; размер необходимо уточнять для архитектуры. Восемь соседних восьмибайтных счётчиков могут занять один такой блок. Получая право записи одного счётчика, ядро затрагивает состояние остальных байтов той же строки, хотя содержимое соседних объектов менять не собирается.
Для адреса A и размера L начало строки вычисляется как floor(A / L) × L. Если L = 64, адреса 0x1000 и 0x1008 относятся к строке 0x1000–0x103F. Адрес 0x1040 начинает следующую. Это проверка расположения, а не гарантия производительности: ещё нужно знать, какие потоки обращаются к этим байтам и насколько часто. Само соседство без конкурирующих изменений не создаёт постоянного обмена владением.
Гранулярность объясняет одновременно пользу и цену кэширования. Один перенос приносит несколько будущих элементов массива, уменьшает число служебных тегов и использует пространственную локальность. Но тот же блок объединяет независимые данные с точки зрения когерентности. Уменьшать или увеличивать эту единицу без последствий нельзя: изменяются объём метаданных, трафик, возможности предвыборки и аппаратная сложность.
Четыре состояния MESI: что именно они обещают
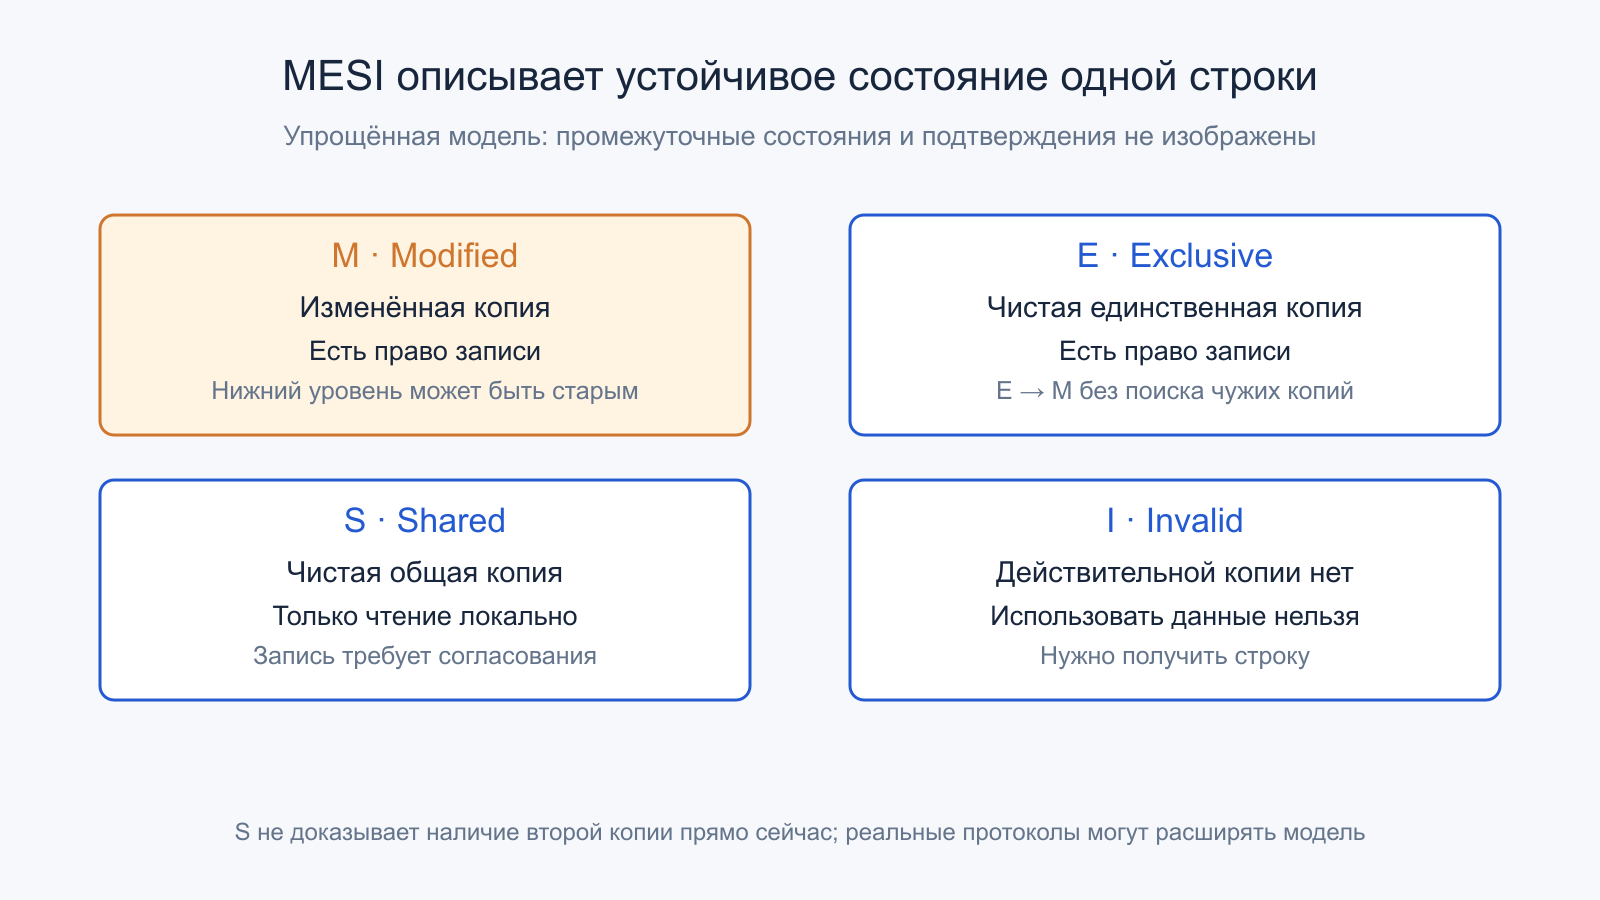
MESI удобно изучать как упрощённый протокол устойчивых состояний одной строки. Modified означает, что у данного участника находится изменённая эксклюзивная копия; нижележащее представление может быть старым. Exclusive — чистая копия с исключительным владением в рассматриваемой группе кэшей. Shared — чистая копия, не дающая права изменять её без дополнительного согласования. Invalid означает, что содержимое этой позиции нельзя использовать как действительные данные нужной строки.
Слово Shared не гарантирует, что прямо сейчас существуют две копии. Другие участники могли незаметно вытеснить свои чистые экземпляры, а оставшийся кэш сохранил состояние S. Это разрешённое консервативное знание. E, напротив, позволяет безопасно перейти к записи без запроса на аннулирование чужих копий. «Чистая» здесь относится к согласованности с нужным нижним уровнем модели, а не к отсутствию обращений программы.
Четыре буквы описывают результат, но не все промежуточные действия. Пока идут запросы и подтверждения, реальная машина использует переходные состояния, очереди и механизмы разрешения конфликтов. Нельзя считать диаграмму MESI полной схемой контроллера конкретного CPU. В документации Arm приведён MESI для определённых MPCore, а в Intel QPI описано расширение MESIF; названия протоколов следует связывать с реализацией.
Несколько читателей могут обходиться без постоянного трафика
Пусть только ядро A прочитало строку, которой больше ни у кого нет. Упрощённая модель допускает E. После чтения ядром B обе копии могут стать S. Дальнейшие чтения A и B при попаданиях обслуживаются локально: когерентность не требует заново доставлять строку при каждом выражении программы. Поэтому общий неизменяемый справочник способен эффективно использоваться многими ядрами после начального заполнения кэшей.
Если рабочий набор велик, строки вытесняются и приходится снова получать данные. Это уже не обязательно конфликт владения: причиной может быть ёмкость, ассоциативность или поток других обращений. Повышение счётчика промахов само по себе не разделяет эти причины. Нужны адреса, характер доступа и доступные события производительности. Даже настоящее совместное чтение может ограничиваться пропускной способностью заполнения, когда каждый поток постоянно идёт дальше.
Полезное инженерное различие — «много потоков используют одни данные» и «много потоков вынуждают изменять состояние одних строк». Первый вариант может давать хорошую локальность. Во втором аппаратура постоянно организует передачу прав, аннулирование и ответы. Поэтому простое слово shared в описании структуры ещё ничего не говорит о цене её использования.
Запись требует права, а не обязательной немедленной выгрузки
Если строка уже в M, несколько локальных записей могут оставаться в том же состоянии. Переход E → M также обходится без поиска других копий в базовой модели. Если же строка находится в S, нужно получить исключительное право и сделать конкурирующие копии недействительными. При отсутствии строки запрос может одновременно организовать получение её содержимого и владения; для такого пути часто используют термин Read For Ownership.
Пока согласование не завершено, процессор способен подготовить запись в буфере и продолжать другую независимую работу в допустимых пределах. Поэтому время исполнения одной инструкции store не равно длительности всего когерентного обмена. Но буферы конечны, зависимости накапливаются, а следующий участник может ждать результат. Длинная последовательность конфликтующих обращений постепенно делает скрытую задержку видимой всему приложению.
Неверно утверждать, что каждая запись обязательно отправляет 64 байта в DRAM, или что каждая смена владельца требует полного обхода оперативной памяти. Куда идут данные, зависит от иерархии и состояния. Содержимое может передаваться между кэшами через внутреннюю сеть; служебные запросы и подтверждения тоже занимают ресурсы. Размер строки не является точным размером любого пакета протокола.
Один учебный обмен: разные переменные, одна строка
В одной условной строке находятся X = 10 и Y = 20. A читает X и получает E, затем записывает X = 11, переходя в M. Теперь B читает Y. Ему нужны только свои восемь байт, но запрос относится ко всей строке. Система обеспечивает актуальное содержимое, включая X = 11; в упрощённом MESI обе стороны после согласования располагают S. Затем B записывает Y = 21: A теряет действительную копию, B получает M.
При следующей записи A в X право снова потребуется передать. При этом ни один участник не намерен использовать переменную другого. Аппаратура всё же обязана сохранять оба изменения: итог не должен внезапно вернуть X к 10 или Y к 20. Протокол решает эту задачу правильно, а задержки являются ценой выбранного размещения. Когерентность здесь не сломалась — именно её корректная работа обнаружила лишнюю связь.
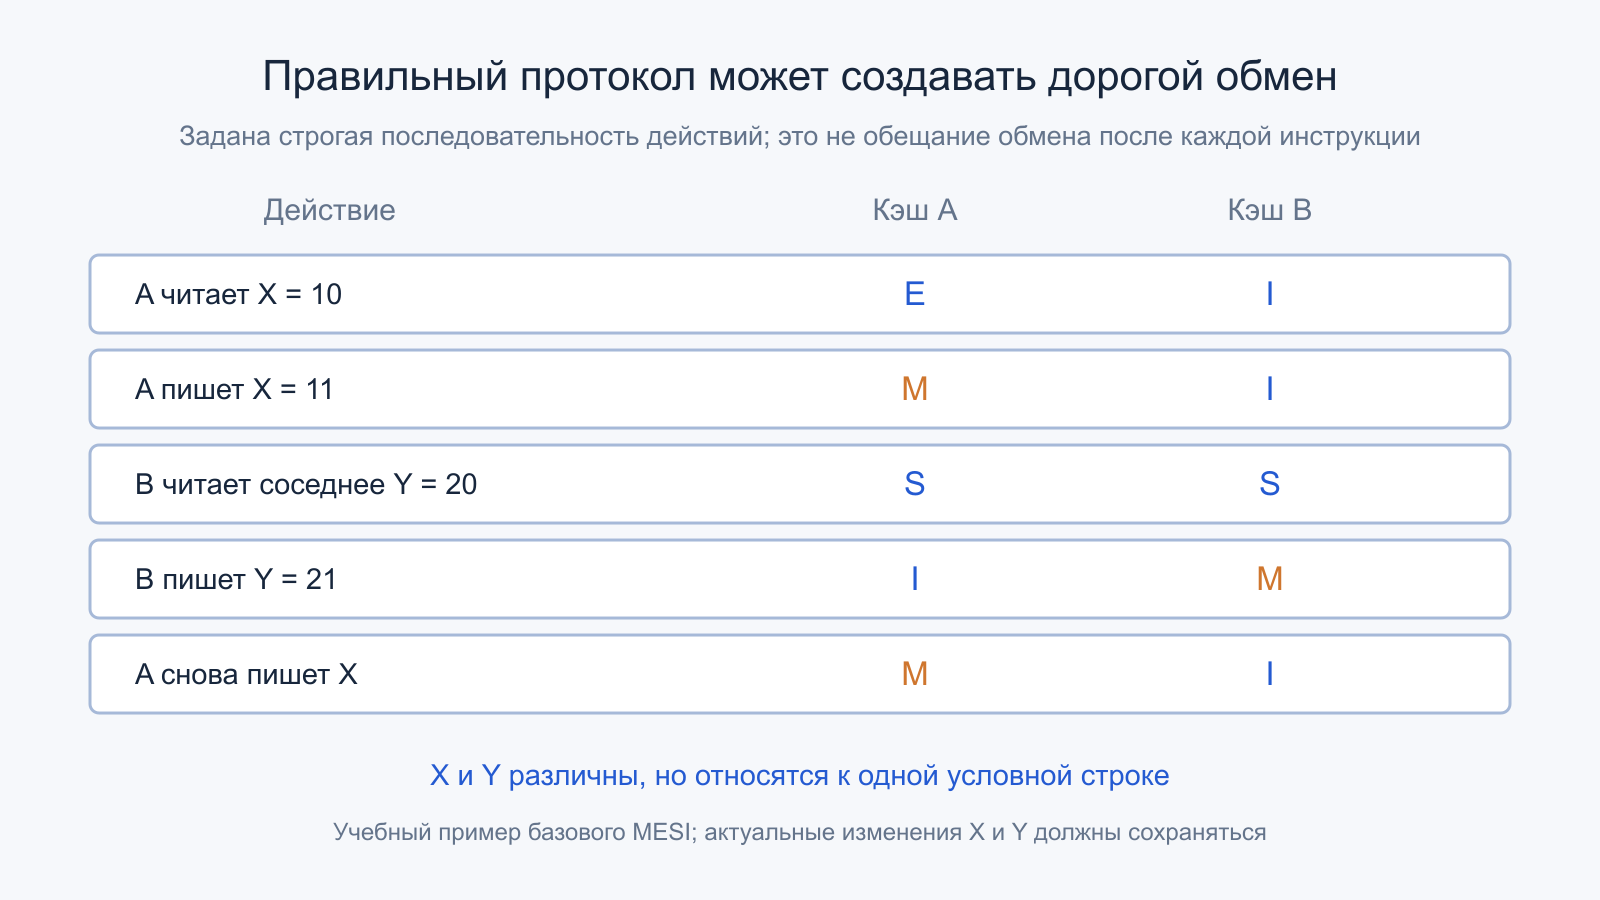
В реальности соседние инструкции могут группироваться, один поток временно опережает другой, а состояние меняется реже, чем количество записей. Поэтому нельзя по этому рассказу объявлять обязательный обмен после каждого инкремента. Чтобы получить строгую последовательность «A, затем B», потребовалась бы отдельная синхронизация, которая сама имеет цену. Учебная схема выделяет механизм конфликта, сохраняя это ограничение.
Snoop и directory: как найти других участников
Один способ обнаружить копии — отправлять запросы наблюдения, snoop, соответствующим кэшам. Другой — использовать сведения каталога о возможных держателях и владельце. Реальные системы сочетают несколько приёмов, фильтруют ненужные запросы и располагают домашние агенты по внутренней топологии. Простая картинка общей шины не описывает буквально многокристальный сервер, хотя полезно показывает необходимость арбитража.
Чем больше участников и расстояний, тем существеннее цена поиска и подтверждений. Запрос к соседнему ядру, переход через другой кристалл и межсокетный путь могут иметь разные задержки. Но из размера расстояния на рисунке нельзя получить наносекунды. На результат влияют маршрут, загруженность, состояние каталогов, тип ответа и частоты соответствующих доменов. Число ядер является лишь частью описания.
MESIF добавляет роль участника, который может переслать общую чистую копию; это не разрешение нескольким ядрам одновременно держать независимые изменённые версии одного содержимого. Другие семейства используют дополнительные состояния и правила. Для понимания программы важнее устойчивое свойство: совместное чтение допускается, а конфликт изменения согласуется. Учебный MESI объясняет этот обмен, не заменяя архитектурное руководство.
Почему общий L3 не устраняет все конфликты
Выражение «у ядер общий последний уровень кэша» иногда воспринимают как отсутствие отдельных копий. В действительности приватные уровни продолжают обслуживать свои попадания, а общий уровень участвует в более широкой иерархии. Когда другой исполнитель собирается изменить строку, нужно разобраться с существующими копиями независимо от того, есть ли её представление в LLC. Общая ёмкость помогает удержать рабочий набор, но не отменяет права владения и обмен управляющими сообщениями.
Политика включения также решает отдельную задачу. В описанной Intel архитектуре включительный LLC хранит сведения, позволяющие установить наличие строки у внутренних ядер. Это облегчает фильтрацию запросов наблюдения. Из этого нельзя заключить, что любая актуальная изменённая копия постоянно продублирована в DRAM или что все будущие семейства обязаны использовать ту же организацию. Наличие тега, наличие полезных байтов и актуальность конкретной копии нужно различать.
Названия inclusive, exclusive и non-inclusive относятся к отношениям между уровнями, а буква E в MESI — к состоянию строки в протоколе владения. Похожее слово не делает эти понятия взаимозаменяемыми. Иерархия может менять правила размещения и вытеснения, сохраняя корректный общий обмен. Когда обсуждают цену промаха, необходимо выяснить не только номер уровня, но и возможный источник ответа: нижний кэш, другой участник или контроллер памяти.
Отдельный слой — соответствие программных потоков физической структуре. Два логических процессора с одновременной многопоточностью способны разделять часть ресурсов одного ядра. Два физических ядра обладают другим набором приватных блоков. Поэтому переход от двух потоков на одном ядре к двум ядрам меняет одновременно доступные исполнительные ресурсы, конкуренцию и возможные пути данных. Разницу времени такого опыта нельзя целиком объявлять ценой когерентности.
При диагностике сохраняют карту размещения исполнителей и повторяют контролируемые варианты. Сначала определяют, какие ресурсы участники действительно разделяют, затем смотрят на адреса и события обмена. Если ОС переносила поток, измерение дополнительно включает прогрев нового локального состояния. Привязка сама по себе не исправляет алгоритм и может ухудшить распределение нагрузки, но помогает объяснить конкретный опыт. Вывод должен относиться к измеренной топологии и работе, а не ко всем процессорам с таким же количеством ядер.
Когерентность не заменяет порядок памяти и синхронизацию
Согласованность одной строки не задаёт автоматически необходимый порядок разных обращений. Допустим, поток готовит массив, затем публикует флаг готовности. Другой поток читает флаг и собирается использовать массив. Корректность зависит от правил языка, компилятора и архитектуры, а также от выбранной связи публикации. Просто разместить флаг в когерентной памяти недостаточно для доказательства, что все предшествующие действия увидены нужным образом.
В прикладном коде такую связь выражают средствами языка: замками, атомарными операциями с подходящими порядками, готовыми очередями и другими проверенными конструкциями. Release/acquire имеет смысл в согласованной схеме, где чтение действительно наблюдает соответствующую публикацию. Расстановка барьеров «побольше» не является универсальным доказательством. Linux отдельно документирует свои гарантии; их нельзя механически приравнивать ко всем правилам C++ или Java.
Когерентность также не превращает составное действие «прочитать, увеличить, записать» в неделимую операцию. Два потока могут потерять обновление без подходящей атомарности. Это ошибка алгоритма, отличная от false sharing. Обсуждать стоимость размещения имеет смысл после того, как программа уже корректно синхронизирована и не содержит запрещённых гонок данных.
Атомарные счётчики: правильный результат тоже имеет цену
Общий атомарный счётчик решает задачу согласованного обновления одного объекта. Но все участники по-прежнему конкурируют за возможность его изменить. При высокой частоте операций строка становится точкой сериализации. Даже ослабленный порядок атомарной операции не отменяет её неделимость и необходимость владения. Поэтому замена сильного порядка на relaxed не обещает устранить ограничение, если основная причина — одно общее место записи.
Обычные выровненные атомарные операции с кэшируемой памятью не следует описывать как обязательную блокировку всей внешней шины. Условия и способы реализации зависят от инструкции и платформы; пересечение границ и особые типы памяти требуют отдельных оговорок. Для инженерного вывода достаточно не путать локальную арифметику с конкурентным изменением общей строки. Обе операции могут выглядеть как один инкремент в исходном коде и иметь разный аппаратный путь.
Если каждому потоку действительно нужен свой счётчик, разные атомарные объекты устраняют логическую конкуренцию за один результат. Однако расположенные рядом объекты способны сохранить аппаратную конкуренцию за строку. Это переход от true sharing к false sharing: правильность уже независима, а размещение ещё связывает работу.
False sharing бывает и между записью и чтением
Классический пример — два часто изменяемых счётчика разных потоков. Но достаточно одного писателя и читателей соседнего неизменяемого поля. Например, служебная статистика и параметры обработки помещены вместе. Каждый новый цикл записи статистики может лишать читателей локальной копии параметров. Они не интересуются статистикой, но вынуждены снова получать строку. Поэтому искать только два конкурирующих store недостаточно.
Обратная ситуация тоже важна: два поля рядом не обязательно мешают друг другу заметно. Если обновление происходит раз в минуту, а основная обработка длится секунды, аппаратные расходы могут оказаться несущественными. Плотная упаковка сохраняет память и облегчает последовательное чтение. Вынос каждого байта на отдельную строку без измерений иногда ухудшает общую задачу сильнее, чем редкие инвалидации.
False sharing следует определять через сочетание адресного размещения и временного поведения. Нужны разные полезные данные, общая когерентная единица и хотя бы одна запись в пересекающейся активности. Один лишь большой объём чтения, общий объект в языке или промах L1 ещё не доказывают именно этот механизм.
Выравнивание начала и шаг массива проверяются вместе
Учебный массив из 32 счётчиков по 8 байт занимает 256 байт. При выровненном начале и строке 64 байта это четыре строки. Если каждый счётчик выделить в отдельный 64-байтный элемент, размер станет 2048 байт — в восемь раз больше. Для миллиона элементов идеальная разница составляет 8 и 64 МБ до прочих накладных расходов. Помимо RAM меняется число затрагиваемых страниц и заполнение кэшей.
Одного размера элемента 64 байта недостаточно: массив может начинаться с середины строки. При смещении начала на 32 байта каждый такой элемент пересекает границу, а соседние элементы делят строку. Нужно проверить и выравнивание базы, и шаг, и фактические смещения горячих полей. Пересечение полного элемента вместе с padding само по себе ещё не доказывает false sharing. Если реально обновляется только одно восьмибайтное поле в начале каждого элемента с шагом 64 байта, эти горячие поля остаются в разных строках даже при таком сдвиге базы; проверять нужно фактически затрагиваемые байты. Размер структуры может измениться из-за внутренних отступов, наследования или требований ABI; его определяют для реальной сборки.
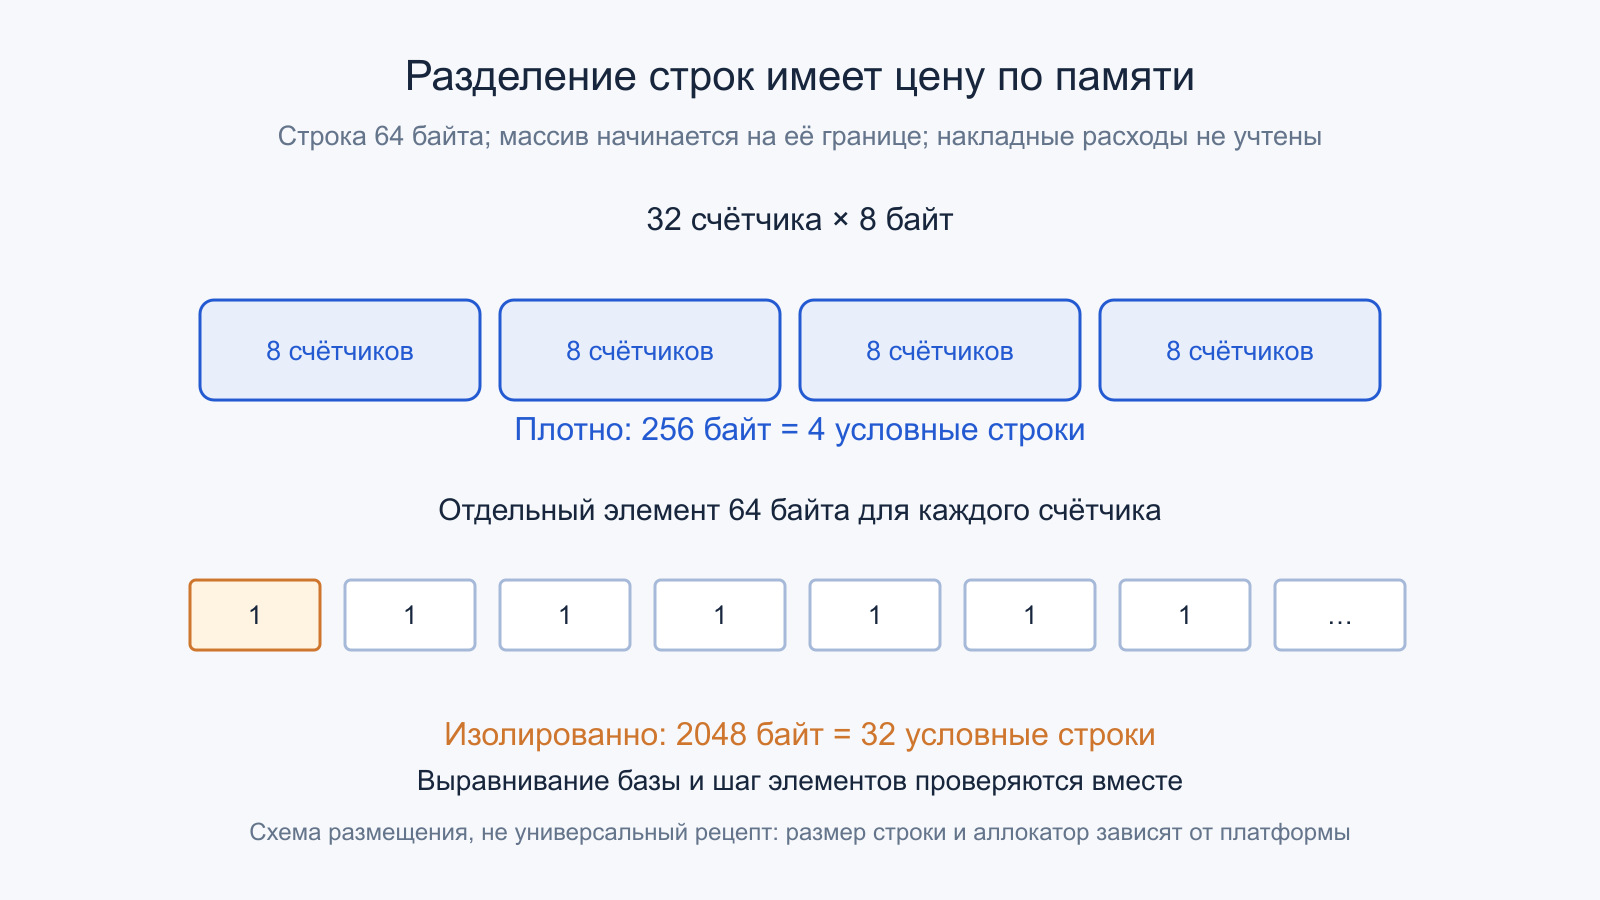
Правильное размещение следует выражать предусмотренными средствами языка и аллокатора, а затем проверять. Магическое число 64 не является переносимой спецификацией всех машин. Изоляция по более крупной единице иногда нужна по условиям платформы, но увеличивает цену. Полезно документировать, какие поля принадлежат одному исполнителю и почему между группами оставлено пространство.
Численная модель: важна частота передачи владения
Предположим, полезное локальное обновление занимает 2 нс, а передача права между исполнителями — 80 нс. Это заданные учебные числа без претензии на CPU. Пусть после каждого пакета из b обновлений всегда происходит одна такая передача, участки не перекрываются, прочими расходами пренебрегаем. Тогда пакет занимает 80 + 2b нс, а темп полезных обновлений равен b / (80 + 2b) операций за наносекунду.
Для b = 1 получаем около 12,20 миллиона обновлений в секунду. Для b = 8 — 83,33 миллиона, для b = 64 — 307,69 миллиона, для b = 256 — 432,43 миллиона. Предел этой модели при больших пакетах составляет 500 миллионов, поскольку остаются 2 нс на обновление. Рост объясняется амортизацией одного обмена, а не ускорением арифметического устройства.
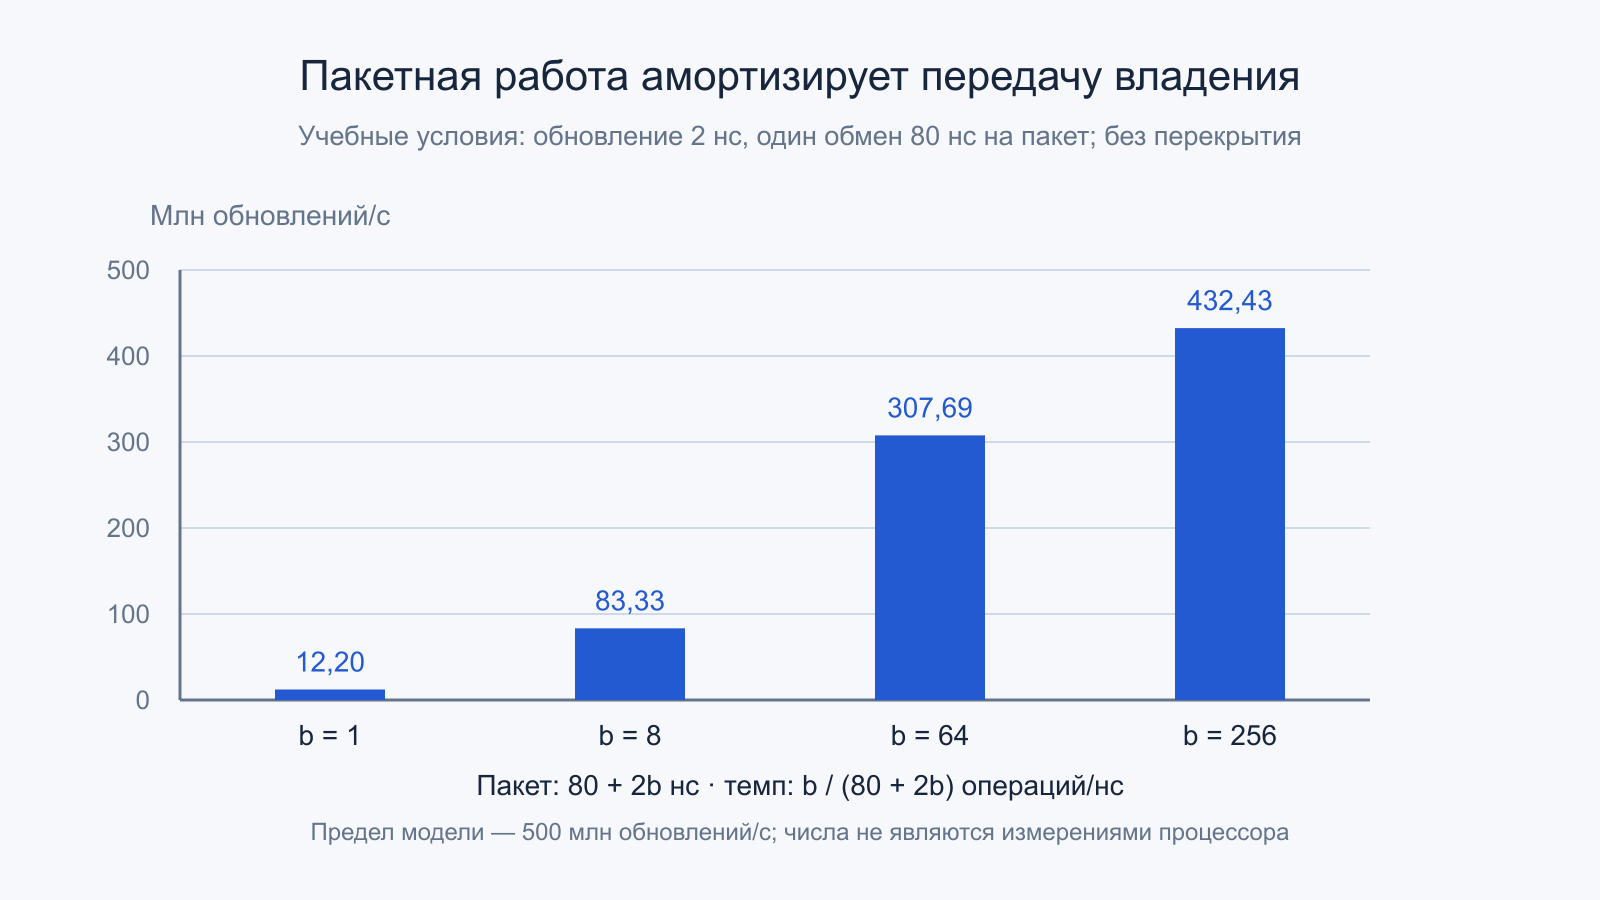
Модель нельзя превращать в прогноз бенчмарка: настоящие операции перекрываются, частоты меняются, а пакет может увеличить ожидание другой стороны. Зато она показывает, почему сокращение числа публикаций иногда полезнее уменьшения нескольких инструкций внутри цикла. Для выбора размера пакета нужны требования к свежести результата, допустимой задержке и запасу буферов, а не только максимальный поток.
Изменение алгоритма иногда полезнее padding
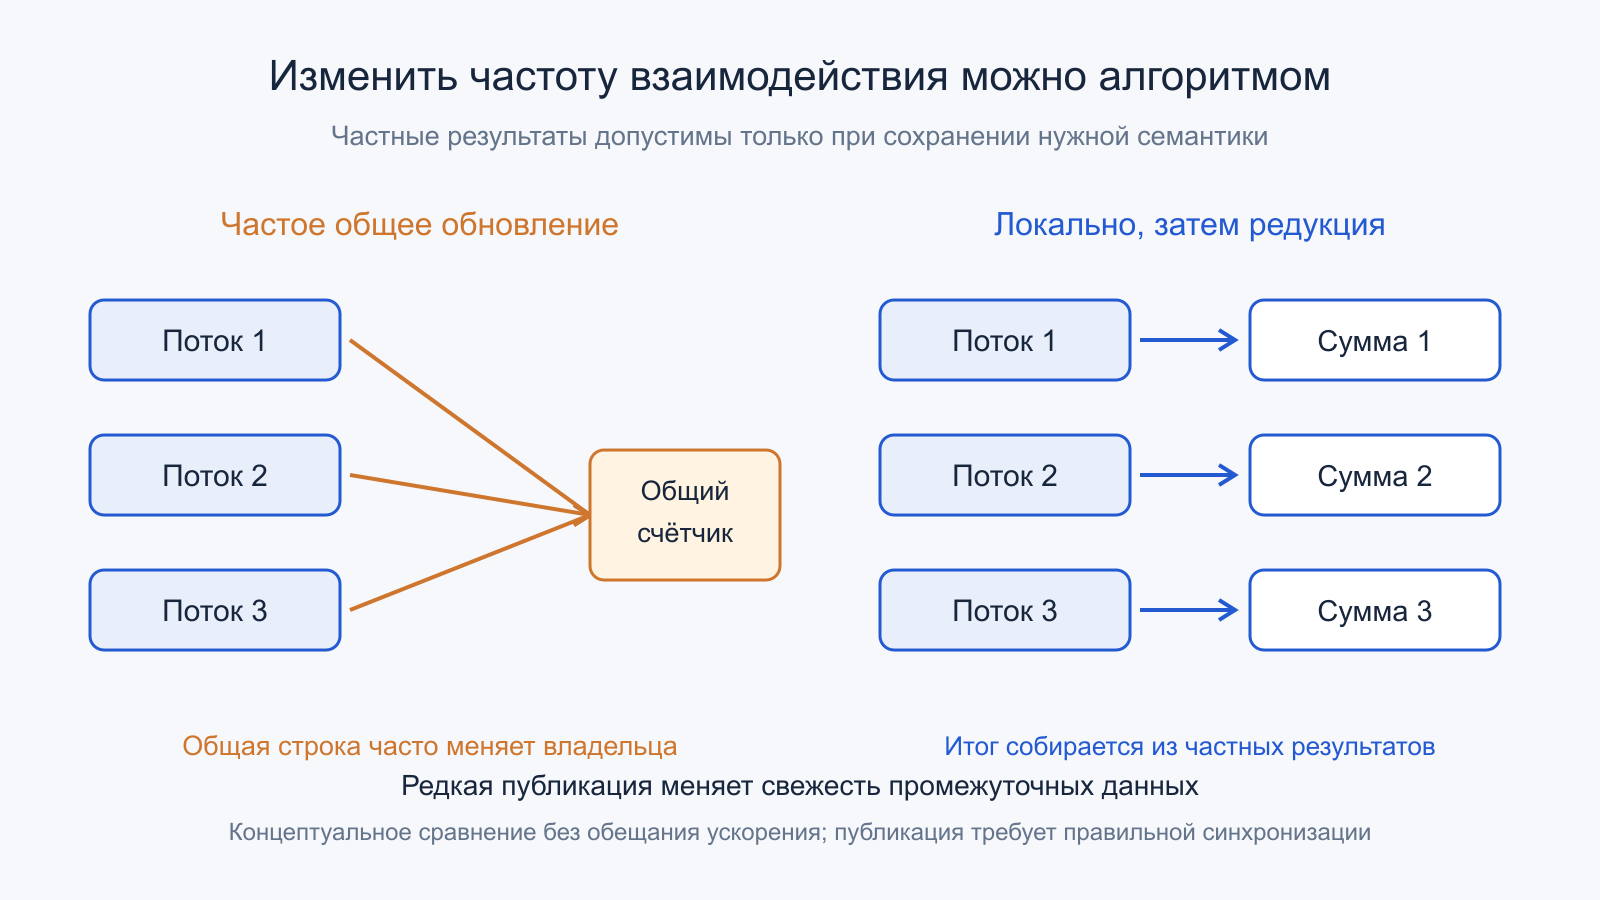
Если итог нужен только после обработки, поток может накапливать частичную сумму локально и публиковать её один раз. Затем выполняется редукция. Вместо миллионов конкурентных обновлений остаются отдельные результаты. Но это меняет семантику наблюдения промежуточного состояния: мониторинг перестаёт видеть каждое событие немедленно. Для финансового счётчика, номера последовательности или ограничителя ресурсов такая замена требует отдельного доказательства.
Другой приём — разделить владение рабочими диапазонами. При последовательной обработке массива каждому потоку выдают крупный непрерывный участок с учётом границ строк, а не чередующиеся соседние элементы. Передача готового блока через очередь тогда происходит реже, чем обмен после каждого элемента. Если потребитель должен читать ещё изменяемую область, необходим правильный протокол публикации: крупный блок сам по себе не устраняет гонку.
Общие управляющие переменные, позиции очереди и статистику полезно рассматривать отдельно от полезной нагрузки. Иногда они продолжают обмениваться строками, когда сами данные уже хорошо разделены. С другой стороны, их небольшая остаточная стоимость может быть приемлемой. Цель — ускорить законченную задачу при прежней корректности, а не добиться отсутствия любых когерентных сообщений.
Как подтвердить причину без выдуманной точности
Начинают с воспроизводимой нагрузки и общего времени полезной работы. Затем выясняют, какие потоки и адреса оказываются горячими. Средства вроде perf c2c и анализа памяти VTune помогают сопоставлять события обмена с отдельными строками; инструменты просмотра раскладки связывают смещения с полями. Доступность и трактовка событий зависят от CPU, ОС и версии инструмента. Отсутствие нужного счётчика не доказывает отсутствие проблемы.
Событие HITM или дорогой доступ к чужому изменённому содержимому указывает на взаимодействие, но не всегда на false sharing. Если все потоки обновляют один объект, это настоящее совместное использование. Если они обращаются к разным смещениям одной строки, гипотеза ложного совместного использования сильнее. Также проверяют миграцию потоков, конкуренцию за память и количество выполненной работы: похожая потеря масштабирования имеет несколько причин.
После одной контролируемой правки сравнивают прежнюю и новую раскладку, время, поток, задержку и расход памяти. Проверяют несколько повторов и ту же семантику результата. Ускорение только искусственного цикла не гарантирует выигрыш приложения: реальная работа может ограничиваться другим участком. Публиковать наносекунды без методики, частоты и условий было бы ложной точностью.
Практический порядок разбора
Сначала отделяют корректность от производительности. Проверяют синхронизацию и владение объектами, затем устанавливают размер когерентной единицы и фактическую раскладку. После этого сопоставляют горячие обращения разных исполнителей. Если проблема подтверждается, выбирают между разделением полей, локальным накоплением, пакетной передачей и изменением распределения работы. Каждый вариант сохраняет свои ограничения по памяти, задержке и свежести данных.
- Определить, какой общий результат действительно необходим и как часто он должен становиться видимым.
- Проверить смещения, выравнивание базы и шаг элементов, не полагаясь на внешний вид структуры.
- Разделить true sharing, false sharing, обычные промахи и ограничения пропускной способности.
- Сопоставить адреса и исполнителей с доступными аппаратными событиями.
- Изменить один механизм и повторно проверить законченную задачу, корректность и расход памяти.
Когерентность делает частные кэши пригодными для общей памяти, а её цена зависит от характера взаимодействия. Быстрее всего обычно проходит работа, которую ядро долго выполняет над принадлежащими ему данными. Обмен остаётся необходимым, но его полезно делать осмысленным: передавать готовый результат с нужной частотой, а не заставлять независимые поля случайно спорить за одну строку.
Первичные источники
MESI рассматривается как объясняющая модель. Архитектурные примеры источников относятся к указанным семействам; численные сценарии статьи заданы отдельно и не заимствованы из чужих измерений.
- Arm — Application Note 228: Implementing DMA on ARM SMP Systems, описание MESI для ARM11 MPCore и Cortex-A9 MPCore.
- Intel — Optimization Reference Manual, Volume 2, 2023: владение строкой, RFO и буферы записей в описанных архитектурах.
- Intel Technology Journal, Volume 14, Issue 3: QPI, агенты когерентности и MESIF.
- Linux Kernel — False Sharing: характер обращений, анализ раскладки и ограничения исправлений.
- Linux Kernel — Memory Barriers: различие когерентности, порядка и гарантий синхронизации.
- Intel VTune Profiler — False Sharing: пример диагностики смещений и выравнивания массива.
Комментарии