Почему процессор меняет частоту: DVFS, Boost, P-states, C-states и энергетический бюджет
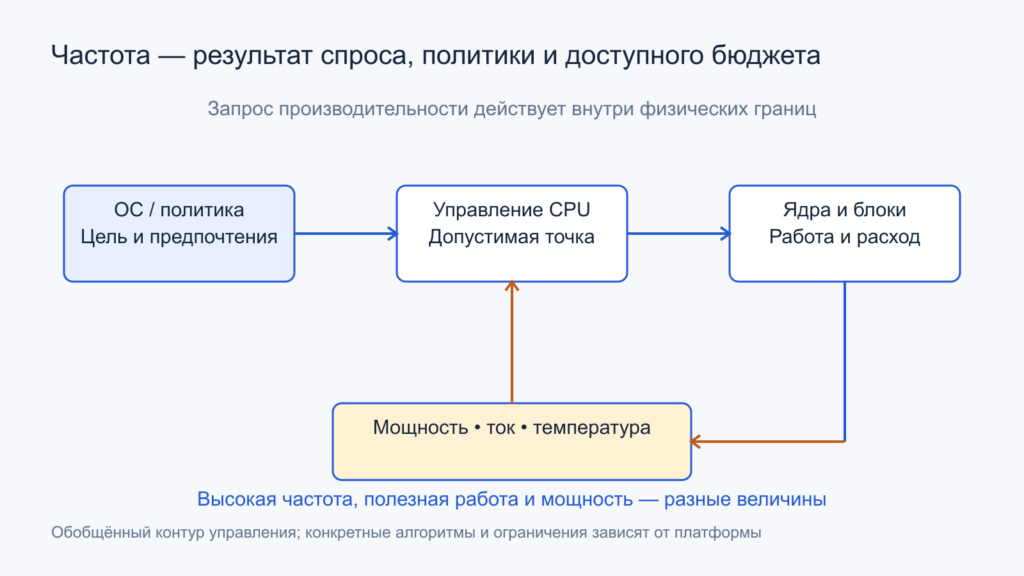
Обобщённый контур показывает различие запроса, допустимой рабочей точки и результата; он не задаёт единый алгоритм Boost для всех CPU. Открыть иллюстрацию в полном размере.
Процессор показывает высокую частоту почти без нагрузки, а при длительном расчёте снижает её. Два средства мониторинга сообщают разные гигагерцы. После изменения режима питания задача стала отзывчивее, но закончилась почти за то же время. Такие наблюдения нельзя объяснить одним правилом «CPU разгоняется, когда занят»: у системы несколько контуров управления, несколько видов простоя и несколько способов считать частоту.
DVFS, Boost, P-states и C-states относятся к разным аспектам работы. Одни механизмы выбирают производительность активного ядра, другие уменьшают расход в паузах, третьи ограничивают общий энергетический и тепловой режим. Чтобы понимать результат, нужно связать запрос программы, решение ОС, возможности аппаратуры и границу конкретного измерения. Название технологии само по себе такой связи не задаёт.
Содержание статьи
- Частота описывает такты, а не законченные задачи
- DVFS выбирает рабочую точку активной аппаратуры
- P-states и C-states отвечают на разные вопросы
- Современный запрос производительности не всегда является запросом мегагерц
- Boost использует доступный запас, а не создаёт бесплатные такты
- Мощность динамической логики нелинейно связана с частотой
- Какая часть задачи действительно ускоряется
- Показание частоты зависит от способа измерения
- Простой выгоден только при подходящей паузе
- Race to idle: закончить быстрее не всегда экономнее
- Ограничение мощности не является простым таймером Boost
- Общий бюджет связывает соседние блоки
- Реакция управления и гистерезис
- Предпочтение, нижний предел и гарантированный результат
- Как анализировать изменение частоты
- Официальные источники
- Читайте также
Частота описывает такты, а не законченные задачи
Тактовая частота показывает темп соответствующего аппаратного домена. Она не равна числу полезных операций приложения за секунду. На каждом такте ядро может выполнять несколько независимых действий, ждать зависимые данные или обслуживать внутреннюю работу. Одно и то же значение гигагерц совместимо с разным временем завершения программы.
Современный процессор содержит несколько доменов тактирования и питания. Ядра, контроллеры, межсоединения и встроенная графика не обязаны работать на одной частоте. Даже частоты разных ядер могут различаться. Поле «CPU clock» в утилите следует связывать с конкретным объектом, а не со всем корпусом как с одним осциллятором.
Скорость приложения зависит от того, сколько времени находится на критическом пути вычислений, памяти и синхронизации. Поэтому повышение частоты не обязано пропорционально сократить время. Это особенно заметно, когда следующий шаг ждёт ответ устройства, данные DRAM или завершение другого потока. Дополнительные такты не создают отсутствующий результат.
Частота также не является непосредственным измерением мощности. При том же темпе тактов один код активно переключает широкий набор вычислителей, другой преимущественно ждёт. Полезно рассматривать вместе законченные задачи, длительность, активность и потребление. Один максимальный гигагерц не описывает энергоэффективность или устойчивую производительность.
DVFS выбирает рабочую точку активной аппаратуры
Dynamic Voltage and Frequency Scaling связывает изменение напряжения и частоты с требуемой производительностью и ограничениями. Для работы на более высокой частоте логические пути должны успевать завершаться в более короткий период. Допустимый режим зависит от аппаратной реализации, температуры, экземпляра кристалла и предусмотренных производителем границ.
Напряжение и частота не меняются произвольно и независимо. Аппаратные механизмы согласуют переходы так, чтобы сохранять корректность в поддерживаемых условиях. Пользовательская программа обычно не управляет каждой физической фазой такого перехода. ОС задаёт цели или ограничения через интерфейс, а значительная часть быстрого выбора может происходить внутри процессора.
Документация Linux CPU Performance Scaling разделяет инфраструктуру, алгоритмы выбора и драйвер аппаратного управления. Это пример конкретного программного стека, а не описание каждой ОС. Важен общий принцип: наблюдаемый режим является результатом нескольких участников, а не только текущего процента загрузки.
Более высокая рабочая точка расширяет доступную вычислительную способность, но не гарантирует её полезное использование. Если очередь работы пуста, аппаратуре нечего ускорять. Если задача упирается в другой участок, выигрыш ограничен. Система должна выбирать не просто максимум, а сочетание реакции, времени исполнения и энергетических условий.
P-states и C-states отвечают на разные вопросы
В классической терминологии P-state описывает рабочую производительность активного CPU, связанную с частотой и напряжением. C-state относится к состоянию простоя, когда выполнение программы приостановлено. Переход в сон не является просто ещё одной более низкой частотой полезного исполнения: часть аппаратуры может перестать тактироваться или питаться.
C0 обычно обозначает активное состояние в этой терминологии. Выбор производительности внутри активной работы и решение прекратить исполнение на время паузы находятся на разных осях. Их нельзя свести к одному упорядоченному списку от «быстро» до «медленно».
Нумерация и точное содержание состояний зависят от архитектуры. Нельзя универсально утверждать, что любой C3 отключает определённый кэш, а любой C6 имеет фиксированную задержку выхода. У ОС могут быть собственные описания состояний, отображаемые на возможности данной платформы. Название — часть интерфейса, а не полный электрический чертёж.
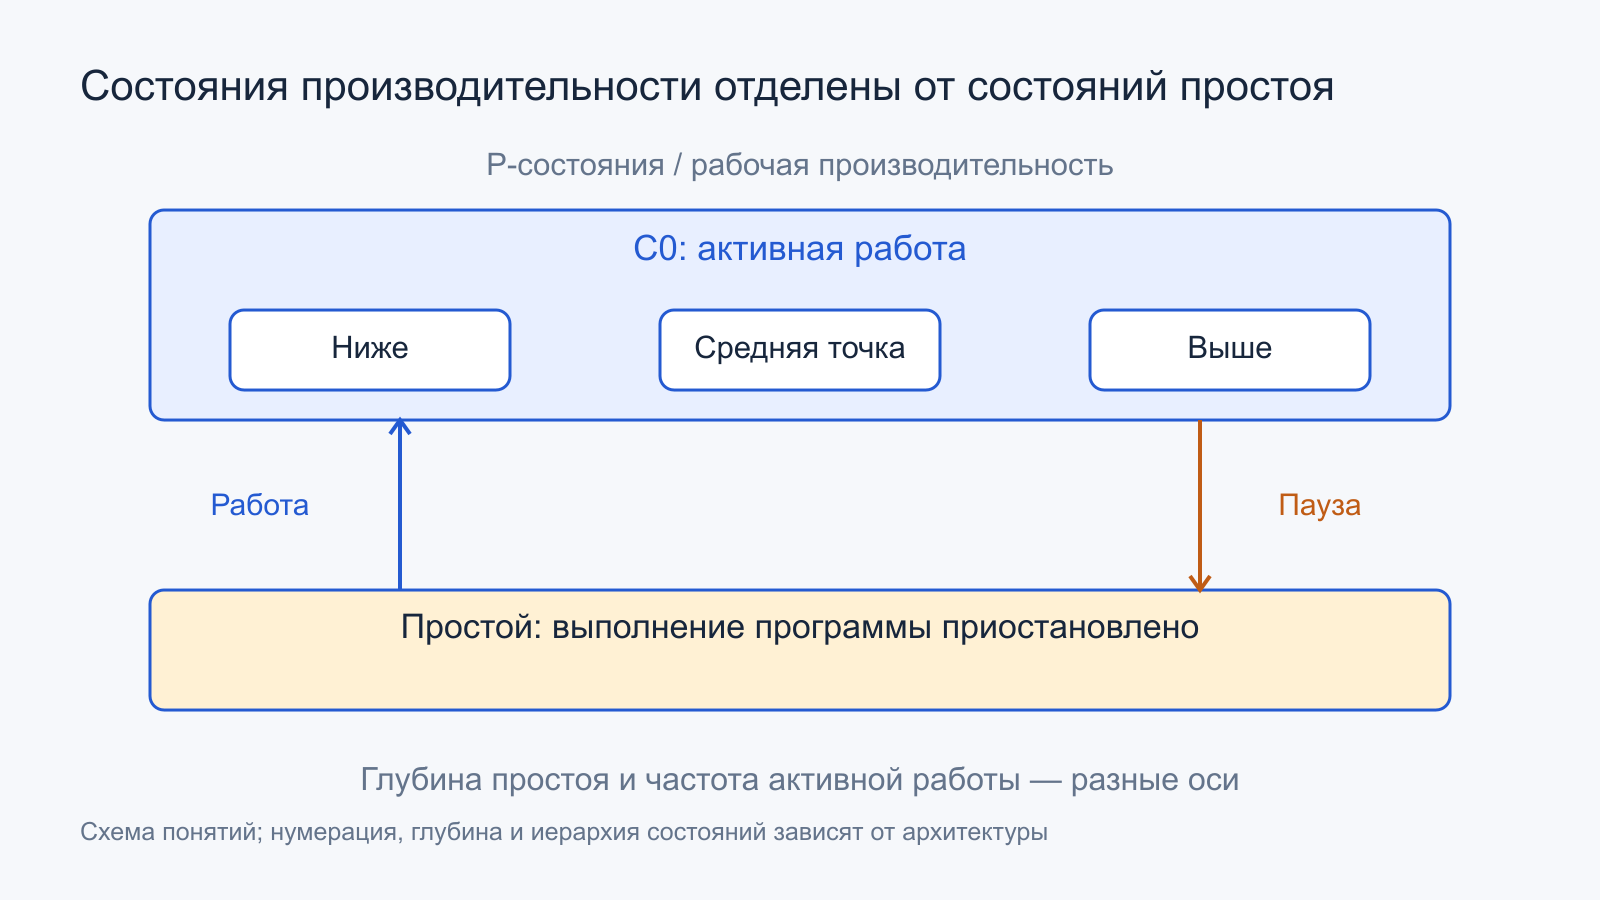
Логический CPU, физическое ядро, кластер и корпус могут иметь разные условия простоя. Для глубокого состояния общего блока иногда нужно, чтобы все его участники выполнили необходимые условия. Один активный поток или регулярная фоновая работа способны не дать всему корпусу перейти в глубокий сон, хотя большая часть ядер простаивает.
Linux CPU Idle Time Management объясняет эту иерархию и выбор с учётом задержки выхода и целевой длительности пребывания. Поэтому маленький общий процент загрузки ещё не доказывает низкое потребление. Значение имеет то, насколько паузы длинны, непрерывны и пригодны для конкретного состояния.
Современный запрос производительности не всегда является запросом мегагерц
Аппаратно управляемые интерфейсы позволяют ОС передать диапазон, предпочтение производительности или энергии и другие ограничения. Процессор выбирает рабочую точку быстрее, чем её подробно отслеживает обычный пользовательский мониторинг. Запрошенный предел, текущая оценка и фактически полученный режим при этом имеют разный смысл.
У поддерживаемых Intel-платформ механизм HWP и работа драйвера описаны в документации intel_pstate. Активный и пассивный режимы драйвера используют разные варианты взаимодействия с политикой ОС. Одинаковое название governor не обязательно означает одинаковый алгоритм на каждой системе и версии стека.
В документации amd-pstate CPPC использует абстрактную безразмерную шкалу производительности. Её значения нельзя читать как непосредственную частоту или как линейную скорость любой программы. Семейные особенности и доступные режимы определяются аппаратурой, прошивкой и поддержкой драйвера.
Таким образом, «ОС попросила максимум» не означает, что ядро обязано непрерывно держать рекламный пик. Запрос действует внутри допустимых границ. И наоборот, адаптивное управление не обязано долго ждать, пока программа полностью загрузит все ядра: короткая срочная работа тоже может получить высокий рабочий режим.
Boost использует доступный запас, а не создаёт бесплатные такты
Boost обычно позволяет активной части CPU работать выше определённой номинальной точки, пока это допускают ограничения. Учитываются доступная мощность, ток, температура, число и тип активных блоков и другие внутренние условия. Названия Intel Turbo Boost и решений AMD относятся к конкретным реализациям; единого универсального алгоритма для всех процессоров нет.
Intel описывает Turbo Boost как динамический выбор в пределах условий конкретного процессора. Максимальная частота относится к оговорённому режиму. Её нельзя умножить на все ядра и получить обещанную постоянную производительность корпуса. Возможность краткого пика не определяет длительный многопоточный результат.
Меньшее число активных ядер способно оставить больше общего бюджета каждому участнику. При полной нагрузке мощность распределяется иначе. Одновременно меняются конкуренция за память и температура. Поэтому снижение частоты при включении остальных потоков может быть штатным следствием общей рабочей точки, а не признаком того, что отдельное ядро стало неисправным.
Более высокая температура не является единственной возможной причиной ограничения. CPU может достигнуть электрического или мощностного предела раньше теплового. Улучшение охлаждения тогда не обязано вернуть максимальную частоту. Для объяснения нужны сведения о действующем ограничении, а не только сравнение текущей температуры с предполагаемой нормой.
Мощность динамической логики нелинейно связана с частотой
Грубая модель динамической мощности имеет вид Pdyn ≈ α × C × V² × f. Коэффициент α описывает переключательную активность, C — эффективную ёмкость, V — напряжение, f — частоту. Это не полная модель CPU: остаются утечки, разные домены и потери других частей системы.
Учебное сравнение: частота выросла на 20%, а напряжение условно изменилось с 1,0 до 1,1 в одинаковых единицах. При прежних α и C отношение динамических мощностей равно 1,1² × 1,2 = 1,452. Получается рост на 45,2%, а не на 20%. Числа объясняют зависимость и не задают допустимое напряжение реального CPU.
Если одинаковая вычислительная работа действительно ускоряется ровно в 1,2 раза, её динамическая энергия в такой модели вырастет в 1,452/1,2 = 1,21 раза. Но сокращение времени может уменьшить другие расходы, в том числе фоновые и утечки. Поэтому из формулы V² нельзя сразу вывести оптимальный режим всей системы.
Переключательная активность различается у нагрузок. Векторный расчёт может выполнять больше полезной работы при меньшей частоте и большей мощности, чем простой скалярный код. Семейные частотные правила для определённых инструкций также различаются. Утверждение «меньше гигагерц — обязательно меньше производительности» в таких сравнениях особенно ненадёжно.
Какая часть задачи действительно ускоряется
Пусть в учебном исходном времени 60% приходится на работу, которая идеально масштабируется с частотой ядра, а 40% остаются неизменными. При росте частоты на 20% относительное время равно 0,60/1,20 + 0,40 = 0,90. Ускорение составляет примерно 1,111 раза, то есть 11,1%, несмотря на дополнительные 20% тактов.
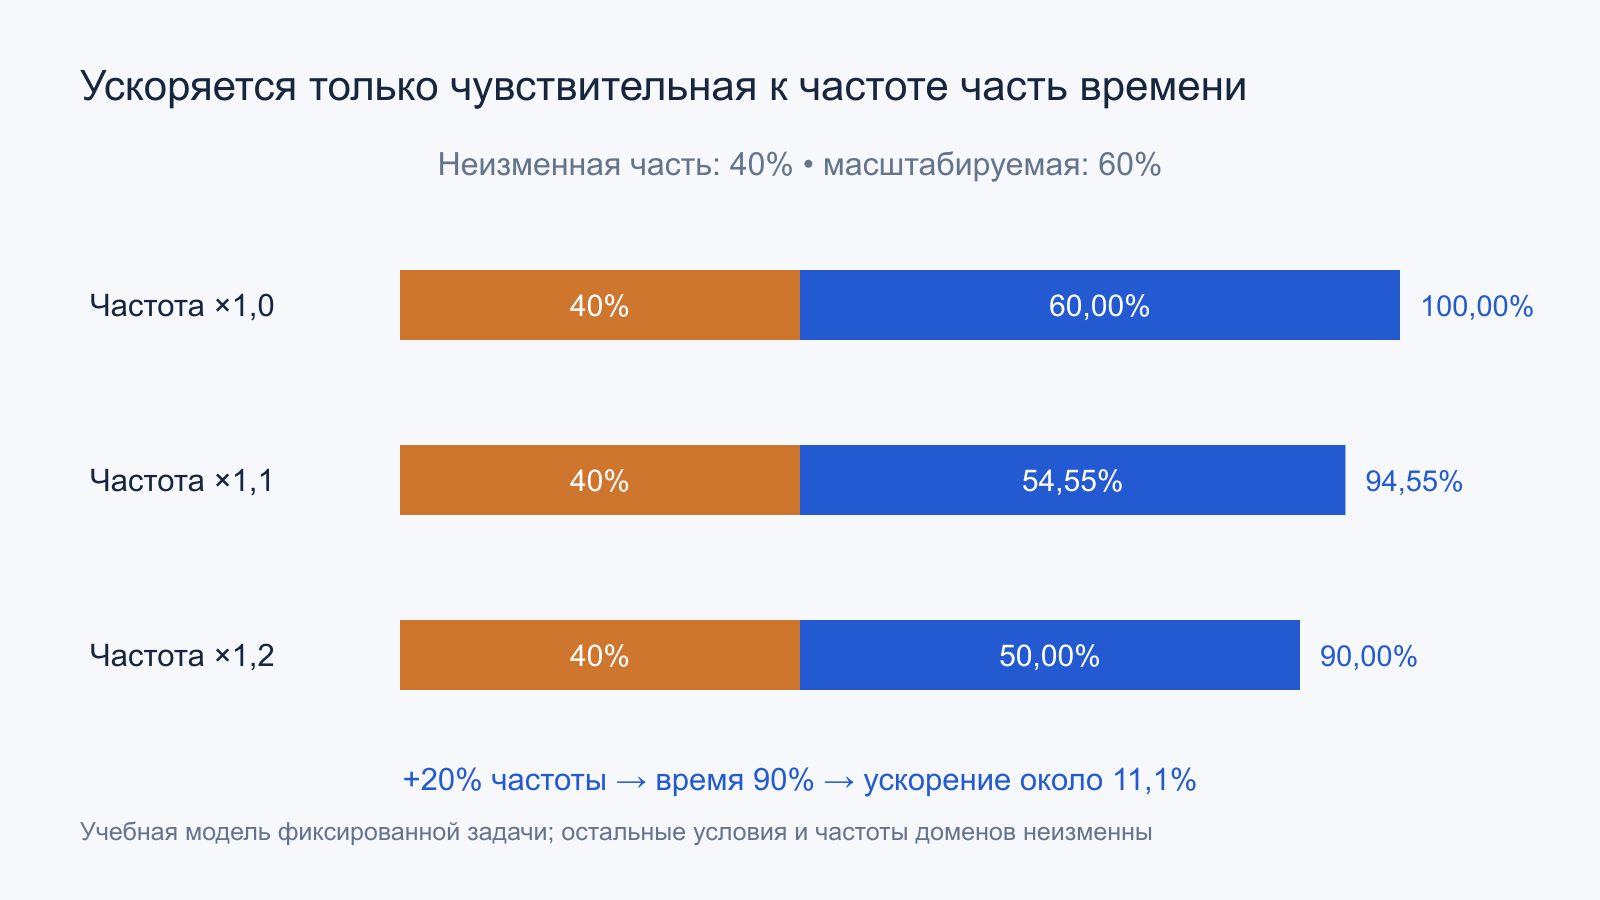
Если неизменная часть занимает 80%, результат будет скромнее: 0,20/1,20 + 0,80 ≈ 0,9667, ускорение около 3,45%. Это не прогноз конкретной программы. Модель предполагает независимую от частоты остальную часть, хотя на практике изменение режима CPU способно влиять и на другие узлы.
Дополнительный поток тоже не равен пропорциональному росту полезной работы. Он может ускорить независимый этап и одновременно увеличить общий расход мощности, снизив частоту других ядер. Итог зависит от графа задачи и общих ресурсов. Поэтому сравнение «один поток на высоком Boost» и «все потоки на меньшей частоте» требует времени всей задачи, а не только гигагерц.
Показание частоты зависит от способа измерения
Утилита может показывать целевую частоту, оценку по текущему множителю, усреднение аппаратных счётчиков или значение для последнего активного интервала. Эти величины не обязаны совпадать. Ядро может кратко проснуться, выполнить работу на высокой частоте и большую часть периода наблюдения не исполнять инструкции.
Учебный счётчик насчитал 150 миллионов соответствующих тактов за окно 100 мс. Если активное время составило 50 мс, средняя частота по активности равна 3 ГГц. Если те же такты разделить на все 100 мс, получится 1,5 ГГц. Разница возникла из-за знаменателя, а не из-за противоречия измерений.
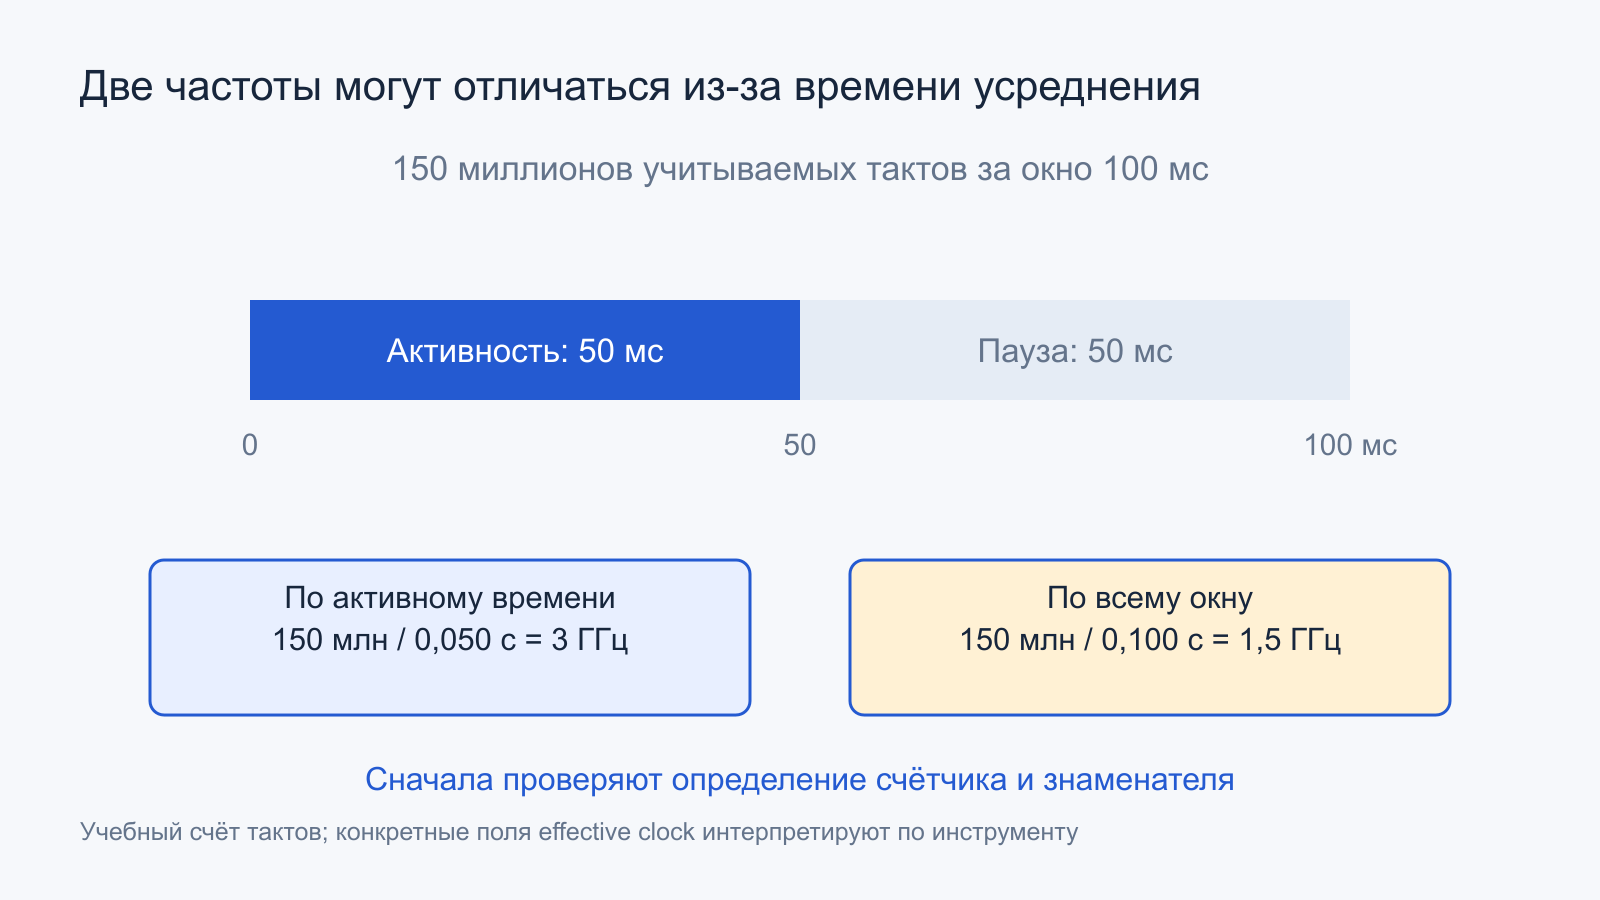
В реальной телеметрии нужно проверять определение effective clock и используемые счётчики. Отдельные механизмы пауз и управления способны дополнительно разделять запрошенную и достигнутую активность. Нельзя любое расхождение автоматически объявлять перегревом или специальным дефектом: сначала сопоставляют одинаковые объекты и интервалы.
Быстрое переключение также плохо видно редкими опросами. Значение раз в секунду может случайно застать короткий Boost или показать сглаженный результат. Максимум за минуту не говорит, сколько времени CPU его удерживал. Для анализа важны распределение и длительность состояний, а не только крайняя точка.
Опорный таймер не обязан замедляться вместе с ядром
Системе нужен устойчивый отсчёт времени независимо от текущего режима исполнения. Некоторые архитектуры предоставляют опорные счётчики, темп которых не равен меняющейся частоте ядра. Поэтому число тиков такого таймера нельзя безусловно объявить числом рабочих тактов CPU. Конкретные свойства проверяются по архитектуре и выбранному средству измерения.
Аналогично время выполнения потока, календарная длительность и аппаратное активное время имеют разные границы. Поток может быть вытеснен, ждать ОС или устройство. Для оценки частоты и производительности нужно знать, какое время использует метрика. Красивое совпадение единиц «циклы/секунда» не исправляет неверно выбранный числитель.
Простой выгоден только при подходящей паузе
Глубокое состояние обычно экономит больше мощности, но требует затрат на вход и выход и имеет задержку пробуждения. Система оценивает, достаточно ли времени она предположительно проведёт в нём. Пробуждение через очень короткий промежуток может не окупить переход и ухудшить время ответа.
Учебная оценка: более глубокий режим экономит 0,8 Вт, а дополнительные энергетические затраты перехода составляют 200 мкДж. При игнорировании длительности самих переходов точка окупаемости равна 200 мкДж / 0,8 Вт = 250 мкс. Пауза меньше этого времени не даст энергетического выигрыша в такой модели.
Если задержка выхода условно равна 40 мкс, энергетической окупаемости недостаточно: срочная задача может иметь меньший допустимый запас ответа. Реальные числа зависят от состояния и платформы. Target residency и exit latency — разные характеристики, и алгоритм простоя учитывает их совместно с прогнозом ближайшего события.
Регулярные таймеры и фоновые пробуждения могут дробить большой общий простой на множество коротких окон. CPU загружен мало, но не получает длинной паузы для глубокого общего состояния. Поэтому уменьшение фоновых событий иногда меняет расход сильнее, чем снижение частоты во время редкой полезной работы.
Race to idle: закончить быстрее не всегда экономнее
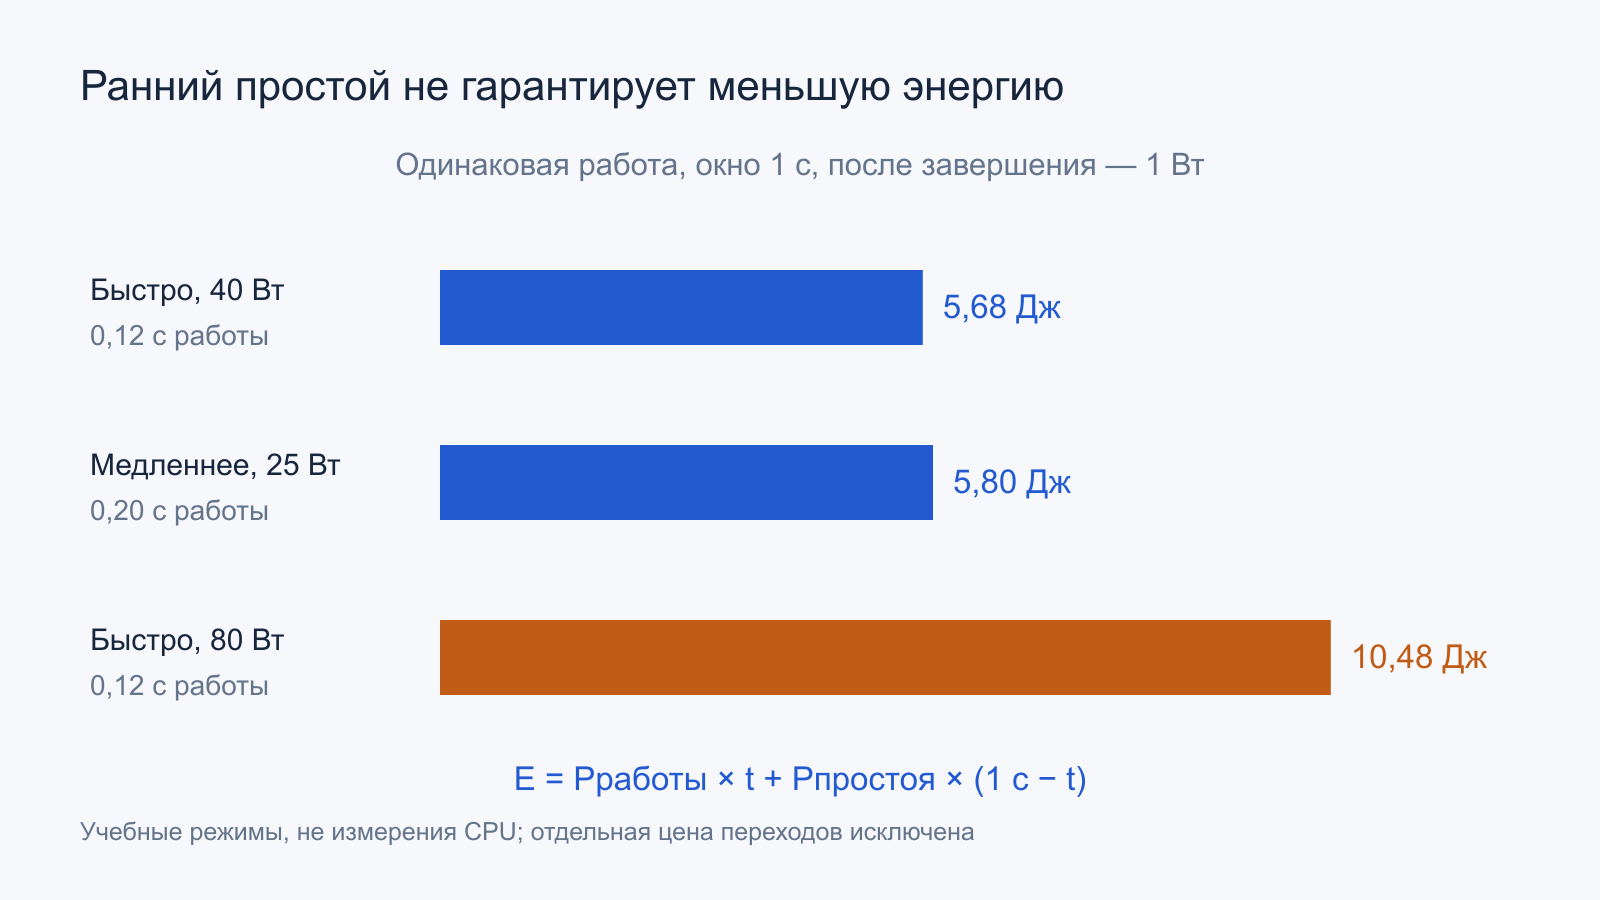
Если задачу выполнить быстро, процессор раньше получит возможность перейти в экономичный режим. Это основа идеи race to idle. Но высокая рабочая точка может слишком сильно увеличить мощность. Сравнивать нужно энергию на одинаковую работу в одинаковом временном окне, включая оставшуюся паузу.
В учебном окне 1 с быстрый вариант работает 0,12 с при 40 Вт, затем 0,88 с потребляет 1 Вт. Энергия равна 4,8 + 0,88 = 5,68 Дж. Более медленный вариант работает 0,20 с при 25 Вт и оставшиеся 0,80 с при 1 Вт: 5 + 0,8 = 5,8 Дж. Здесь быстрое завершение даёт небольшой энергетический выигрыш.
Если быстрый вариант потребовал бы 80 Вт при тех же 0,12 с, результат стал бы 9,6 + 0,88 = 10,48 Дж. Ранний простой уже не компенсировал бы расход. Это не три измерения CPU и не рекомендация мощности: предположены одинаковый результат, заданные длительности и отсутствие отдельной цены переходов.
Граница всей системы способна изменить вывод. Пока CPU работает, дисплей, память, накопитель и другие узлы тоже расходуют энергию. Для короткой операции с фиксированным временем включения экрана вклад отличается от длительного вычисления, после которого компьютер сразу выключается. Сначала определяют, какая энергия действительно интересует пользователя.
Ограничение мощности не является простым таймером Boost
Аппаратное управление может учитывать мощность на разных интервалах, электрические условия и накопленное состояние. Конкретные лимиты и названия зависят от семейства. Нельзя универсально трактовать параметр времени как обещание «ровно столько секунд максимальной частоты при любой задаче».
После лёгкой паузы и после непрерывного расчёта стартовые условия различаются. Температура, активность соседних блоков и история бюджета могут быть другими. Поэтому два запуска одной программы способны начать с разных рабочих точек без изменения её кода. Для повторяемого сравнения фиксируют предысторию и длительность.
Устойчивый режим важен отдельно от краткого пика. На длинной задаче система может прийти к пределу мощности, температуры или другому ограничению. На короткой ответ определяется также скоростью реакции и пробуждением. Один тест не характеризует автоматически оба режима, даже если в обоих случаях наблюдается одно имя CPU.
Общий бюджет связывает соседние блоки
В корпусе могут одновременно работать ядра, встроенная графика, контроллер памяти и другие части. Их потребление не всегда независимо в рамках общего ограничения. Активность GPU или интерфейсов может уменьшить доступный запас процессорным ядрам, даже если сами ядра выполняют прежнюю задачу.
На гибридной системе разные типы ядер имеют разные рабочие возможности и частоты. Усреднить их гигагерцы без учёта числа активных потоков и выполненной работы — значит потерять смысл. Перемещение потока между типами ядер меняет не только частоту, но и микроархитектурные условия, кэши и доступный общий бюджет.
Изолированная частота одного ядра поэтому не является характеристикой всей многопоточной программы. А небольшая загрузка части ядер не доказывает наличие свободного бюджета у всех остальных. Для анализа нужны топология, распределение работы и сведения о реально ограничивающем ресурсе.
Реакция управления и гистерезис
Оценка спроса не является идеальным знанием будущего. Алгоритмы наблюдают прошлую активность, учитывают сигналы планировщика и пытаются выбрать полезный режим на ближайшее время. Фильтрация и гистерезис помогают избегать лишних переключений, но влияют на отклик коротких всплесков.
Слишком медленная реакция может увеличить задержку первой части задачи. Избыточно агрессивная — чаще включать дорогой режим ради небольшого объёма работы. Универсальной политики для фонового пакетного расчёта, интерактивного интерфейса и жёсткого ограничения энергии нет. Названия «экономичный» и «производительный» описывают предпочтения, а не отменяют физические границы.
Также необходимо различать управление производительностью и управление температурой. Оба могут изменить частоту, но получают разные входные сигналы и имеют разные цели. По одному графику частоты нельзя надёжно определить, какой контур принял решение. Нужны события нагрузки, мощности, температуры и доступная информация о причинах ограничения.
Цена реакции заметна в короткой задаче
Учебная работа требует четырёх миллионов тактов и не имеет иных ожиданий. При постоянных 4 ГГц она заняла бы 1 мс. Если первые 200 мкс проходят при 2 ГГц, выполнены только 0,4 миллиона тактов. Оставшиеся 3,6 миллиона при 4 ГГц требуют ещё 0,9 мс. Полное время получится 1,1 мс.
В этом специально простом примере задержка выросла на 10%, хотя почти вся работа затем выполнялась на высокой частоте. Средняя частота по завершённой активной работе составляет около 3,64 ГГц. Один опрос, сделанный в конце, мог бы показать 4 ГГц и скрыть причину разницы. Для длинной задачи тот же начальный участок имел бы гораздо меньшую относительную цену.
Реальная реакция включает несколько контуров, а программа не обязана выполнять постоянное число тактов при изменении частоты: ожидания памяти ведут себя иначе. Модель не задаёт скорость перехода реального CPU. Она объясняет, почему время первой реакции и устойчивый темп измеряют отдельно.
Предпочтение, нижний предел и гарантированный результат
Минимальный запрошенный уровень производительности может означать стремление не выбирать слишком низкую активную точку. Он не обязательно запрещает простой, когда исполнять нечего. Максимальный запрошенный уровень ограничивает выбор, но не является обещанием держать именно его. Общие аппаратные условия всё равно действуют.
Предпочтение энергии или производительности тоже не является жёстким временем выполнения. Оно помогает алгоритму разрешать компромисс в пределах возможностей. Два приложения с одинаковым предпочтением могут получить разные частоты из-за активности, числа потоков и доступного бюджета. Точное значение параметра определяется интерфейсом данной платформы.
Высокая частота при маленькой загрузке иногда отражает короткий срочный этап, а оставшаяся часть окна проходит в простое. Возможен и другой случай: фоновый поток часто просыпается или опрашивает состояние, не создавая большой пользовательской работы. По одной частотной цифре эти варианты не различить. Нужны активное время, причины пробуждений и энергия за согласованный интервал.
Само частое наблюдение способно влиять на состояние системы: сбор телеметрии создаёт обращения и пробуждения. Обычно это не запрещает измерение, но важно при исследовании очень малого расхода в простое. Сравнивают одинаковую методику и учитывают активность измерительного средства, чтобы не приписать его влияние процессорному алгоритму.
Как анализировать изменение частоты
Сначала задают вопрос: интересует время ответа, устойчивый темп или энергия на задачу. Затем фиксируют программу, данные, число потоков, режим питания и длительность. Отдельно отмечают холодный старт, прогретую систему и фоновые события. Изменение нескольких условий одновременно не позволяет связать результат с одной политикой.
Сравнивают запрошенный режим, достигнутую частоту с известным определением, долю активности и время законченной работы. Если частота выросла, а задача почти не ускорилась, проверяют память и ожидания. Если время улучшилось при сходной средней частоте, возможны другое размещение работы, меньше пауз или иная реакция на короткие этапы.
Отчёт сохраняет длительность окна и правило усреднения. Без них две одинаковые цифры частоты могут относиться к разным состояниям, а разница в результате — оставаться полностью скрытой.
Защиты и штатные ограничения сохраняют. Изучение DVFS не требует произвольного изменения напряжений, отключения теплового управления или неподтверждённых режимов. Материал объясняет работу системы, а не предлагает универсальную настройку для любой платы и любого экземпляра процессора.
- Частота отделена от полезной работы и общего темпа задачи.
- P-states описаны отдельно от C-states и иерархии простоя.
- У метрики частоты известны объект, числитель и временной знаменатель.
- Boost связан с конкретной архитектурой и действующими ограничениями.
- Мощность и энергия считаются в одинаковых границах.
- Цена пробуждения и длительность паузы включены в объяснение.
- Краткий всплеск не выдан за длительную рабочую точку.
Процессор меняет частоту, потому что меняются спрос, доступный запас и цена активного режима. Понятный результат получается, когда выбор производительности, простой и измерение выполненной работы рассматриваются совместно. Тогда гигагерцы остаются полезной характеристикой режима, сохраняя свой настоящий смысл и границы.
Официальные источники
- Linux Kernel Documentation — CPU Performance Scaling: уровни программного управления и рабочие состояния.
- Linux Kernel Documentation — CPU Idle Time Management: иерархия простоя, задержка выхода и целевая длительность.
- Linux Kernel Documentation — intel_pstate: HWP и режимы драйвера поддерживаемых Intel-платформ.
- Linux Kernel Documentation — amd-pstate: CPPC и абстрактные запросы производительности.
- Intel — What Is Intel Turbo Boost Technology: динамический режим и зависимость от доступного запаса.