Как работает современный процессор: ядра, конвейер, кэш и реальные ограничения производительности
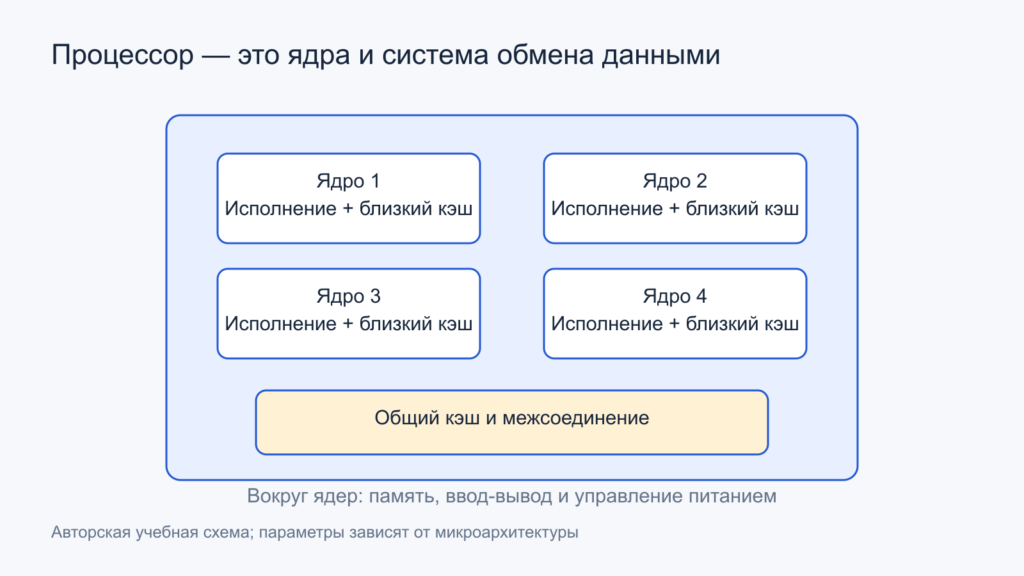
Ядра работают в системе общих ресурсов; расположение и состав блоков зависят от конкретного процессора. Открыть иллюстрацию в полном размере.
У двух процессоров одинаковая частота, но одна задача завершается заметно быстрее. Добавление ядер ускоряет рендеринг, почти не меняет время открытия документа и иногда ухудшает задержку отдельного этапа. При этом загрузка CPU может показывать далеко не 100%. Эти наблюдения не противоречат друг другу: процессор выполняет работу через несколько взаимосвязанных систем, и ограничивать результат может любая из них.
Современное производительное ядро — не один вычислитель, который поочерёдно исполняет команды. Оно предсказывает будущий путь программы, подготавливает операции, ищет независимую работу, обслуживает обращения к памяти и сохраняет правильный порядок видимых результатов. В статье рассматривается общая модель таких ядер; конкретные размеры очередей, ширина блоков и устройство кэша зависят от микроархитектуры.
Содержание статьи
- Архитектура команд, микроархитектура и готовый процессор
- Как команда проходит через ядро
- Что даёт выполнение вне очереди
- Предсказание переходов: вычислять до полной уверенности
- Кэш уменьшает расстояние до данных
- Задержка памяти и её пропускная способность — разные ограничения
- Виртуальные адреса добавляют ещё один уровень работы
- IPC имеет смысл только вместе с работой и условиями
- Векторные блоки ускоряют подходящую работу
- Ядра, программные потоки и SMT
- Общие данные создают отдельную цену
- Разные типы ядер и динамическая частота
- Как определить, что ограничивает конкретную задачу
- Что следует проверять в любом объяснении производительности
- Официальные источники
- Читайте также
Архитектура команд, микроархитектура и готовый процессор
Архитектура системы команд, или ISA, задаёт программно видимые правила: инструкции, регистры, результаты операций, исключения и модель работы с памятью. Она описывает, что должен получить корректный код. Микроархитектура определяет, какими внутренними блоками это достигается. Один программный результат можно получить через разные конвейеры, очереди и исполнительные устройства.
Arm объясняет архитектуру как договор между программой и аппаратной реализацией. Из этого не следует одинаковая скорость всех процессоров с совместимой ISA. Одна реализация экономит площадь и энергию, другая обрабатывает больше независимых операций и хранит больше данных рядом с ядром. Обе могут правильно исполнять одну программу.
Наконец, готовый CPU включает не только ядра. В нём или рядом с ними находятся контроллер памяти, межсоединения, общие кэши, блоки ввода-вывода, управление питанием, иногда графика и специализированные ускорители. Организация по отдельным кристаллам тоже влияет на путь данных. Поэтому сравнивать процессоры исключительно по названию ISA столь же неполно, как сравнивать системы только по числу ядер.
Как команда проходит через ядро
Упрощённый путь начинается с выборки инструкций по адресу текущего исполнения. Декодирование превращает их в форму, удобную внутренним блокам. У многих процессоров сложная инструкция может распадаться на несколько микроопераций; другие инструкции могут обрабатываться совместно. Число команд исходного кода, машинных инструкций и внутренних операций поэтому не обязано совпадать.
Далее ядро распределяет внутренние ресурсы, отслеживает зависимости, выбирает готовые операции и отправляет их на выполнение. Результат арифметики может появиться раньше результата предыдущего чтения памяти. Однако архитектурно видимое завершение организовано так, чтобы программа получала предусмотренное поведение, включая корректные исключения. Схема с одним прямоугольником «исполнение» скрывает большую часть этой работы.
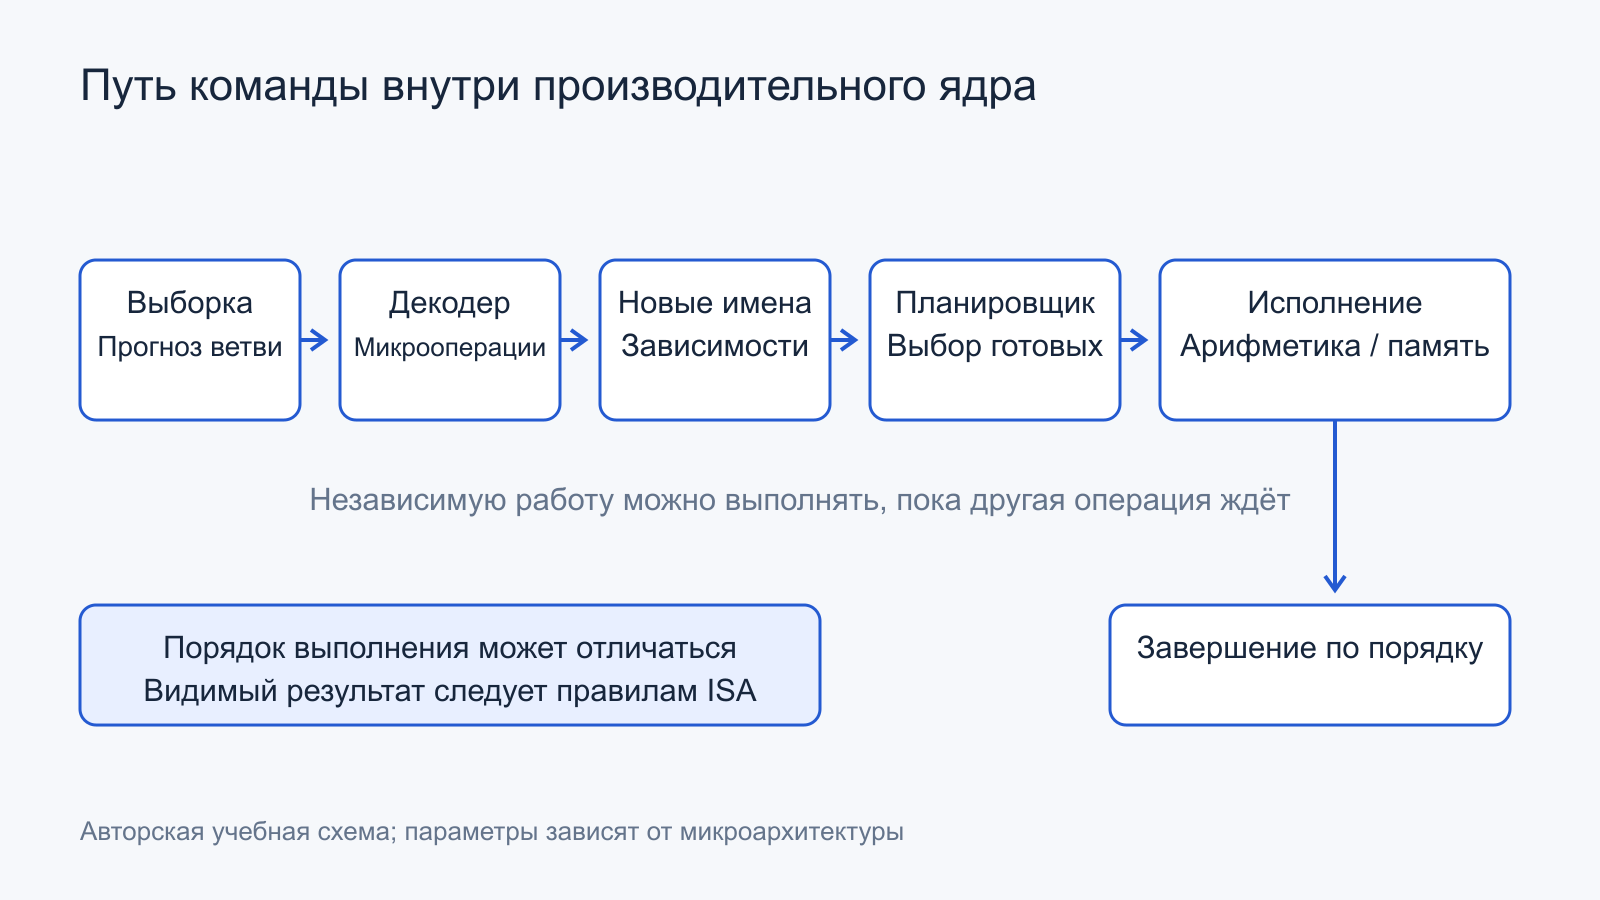
Конвейер позволяет разным операциям одновременно находиться на разных этапах. Это увеличивает пропускную способность, но не делает прохождение одной зависимой операции мгновенным. Более глубокий конвейер тоже не является самостоятельным достоинством: он помогает распределить работу по коротким этапам, одновременно усложняя управление и увеличивая цену некоторых остановок.
Задержка операции и темп выдачи результатов
Представим учебный исполнительный блок: результат операции готов через четыре такта, но новую независимую операцию блок принимает каждый такт. Его задержка равна четырём тактам, а установившийся темп — одному результату за такт. Если следующая операция требует предыдущий результат, этот темп недостижим: цепочка должна ждать данные.
Для восьми независимых операций в такой идеальной модели время от начала первой до готовности последней составит 4 + 7 = 11 тактов. Для восьми строго зависимых — 8 × 4 = 32 такта. Это не характеристика конкретной инструкции и не полный расчёт ядра: здесь исключены выборка, очередь, записи результатов и конкуренция. Пример показывает, почему одинаковое количество арифметики может занимать разное время.
Руководства по оптимизации поэтому отдельно публикуют latency и throughput. В официальном разделе Intel эти данные привязаны к определённым процессорам и типам ядер. Перенос числа из таблицы одного поколения на любое устройство с той же инструкцией способен полностью исказить оценку.
Что даёт выполнение вне очереди
В последовательности «прочитать A; вычислить B; прочитать C; сложить результаты» часть действий может не зависеть от остальных. Ядро с выполнением вне очереди ищет такую готовую работу в ограниченном окне. Пока одна загрузка ожидает данные, другая арифметика иногда продолжает исполняться. Программа сохраняет требуемый результат, а внутреннее расписание меняется.
Переименование регистров помогает отделить настоящие зависимости данных от повторного использования одного архитектурного имени. Если две независимые команды записывают регистр в разные моменты программы, им могут соответствовать разные внутренние физические регистры. Это освобождает возможности параллельного исполнения, но не устраняет зависимость, когда результат первой действительно нужен второй.
Окно поиска конечно. Очереди, физические регистры, буферы загрузок и записей могут заполниться раньше, чем придут данные из памяти. Зависимая цепочка адресов особенно неудобна: адрес следующего узла списка становится известен только после чтения предыдущего. Дополнительные арифметические блоки здесь не создают отсутствующую информацию.
В руководстве Arm Neoverse N2 по PMU отдельно рассматриваются спекулятивные и архитектурно исполненные инструкции. Это полезное различие для измерений: часть внутренней работы могла не войти в итоговый путь программы. Счётчик с похожим названием нельзя интерпретировать без определения события.
Предсказание переходов: вычислять до полной уверенности
Условный переход выбирает дальнейший адрес. Если ждать его окончательного результата перед каждой выборкой, часть конвейера простаивает. Предсказатель пытается заранее определить направление и цель, опираясь на историю. При успехе ядро уже подготовило полезные операции. При ошибке работа неверного пути отменяется и выборка перенаправляется.
Цена ошибки не сводится к одной фиксированной задержке на все программы. Значение имеют конкретное ядро, положение перехода, доступность правильных инструкций, незавершённая работа и состояние памяти. Число ступеней в популярной картинке конвейера не позволяет точно вывести штраф перехода в реальном процессоре.
Учебная оценка: на 1000 инструкций приходится 200 переходов, ошибочными оказываются 5%, условная неперекрываемая цена ошибки — 12 тактов. Получается 200 × 0,05 × 12 = 120 дополнительных тактов. При исходных 500 тактах это увеличение до 620, то есть на 24%. Реальные задержки могут перекрываться, поэтому пример объясняет чувствительность, а не предсказывает время программы.
Удалить все переходы тоже не всегда выгодно. Безусловное вычисление обоих вариантов может добавить обращения к памяти и дорогую арифметику. Хорошо предсказуемая проверка иногда дешевле такой замены. Важны распределение входных данных и критический путь, а не правило «ветвления всегда медленные».
Кэш уменьшает расстояние до данных
Регистры обслуживают небольшое число текущих значений. Кэши хранят недавно использованные инструкции и данные более крупными блоками — строками. У распространённых настольных CPU строка часто равна 64 байтам, но размер проверяют по архитектуре. Дальнейшие расчёты используют именно условную строку 64 байта.
L1 обычно расположен ближе всего к ядру и имеет небольшую ёмкость; следующие уровни дают больше места при иных задержках и пропускной способности. Состав и совместное использование L2 и L3 различаются. Кэш последнего уровня может обслуживать группу ядер, а не весь CPU одинаковым способом. Название уровня не является универсальной гарантией конкретного времени доступа.
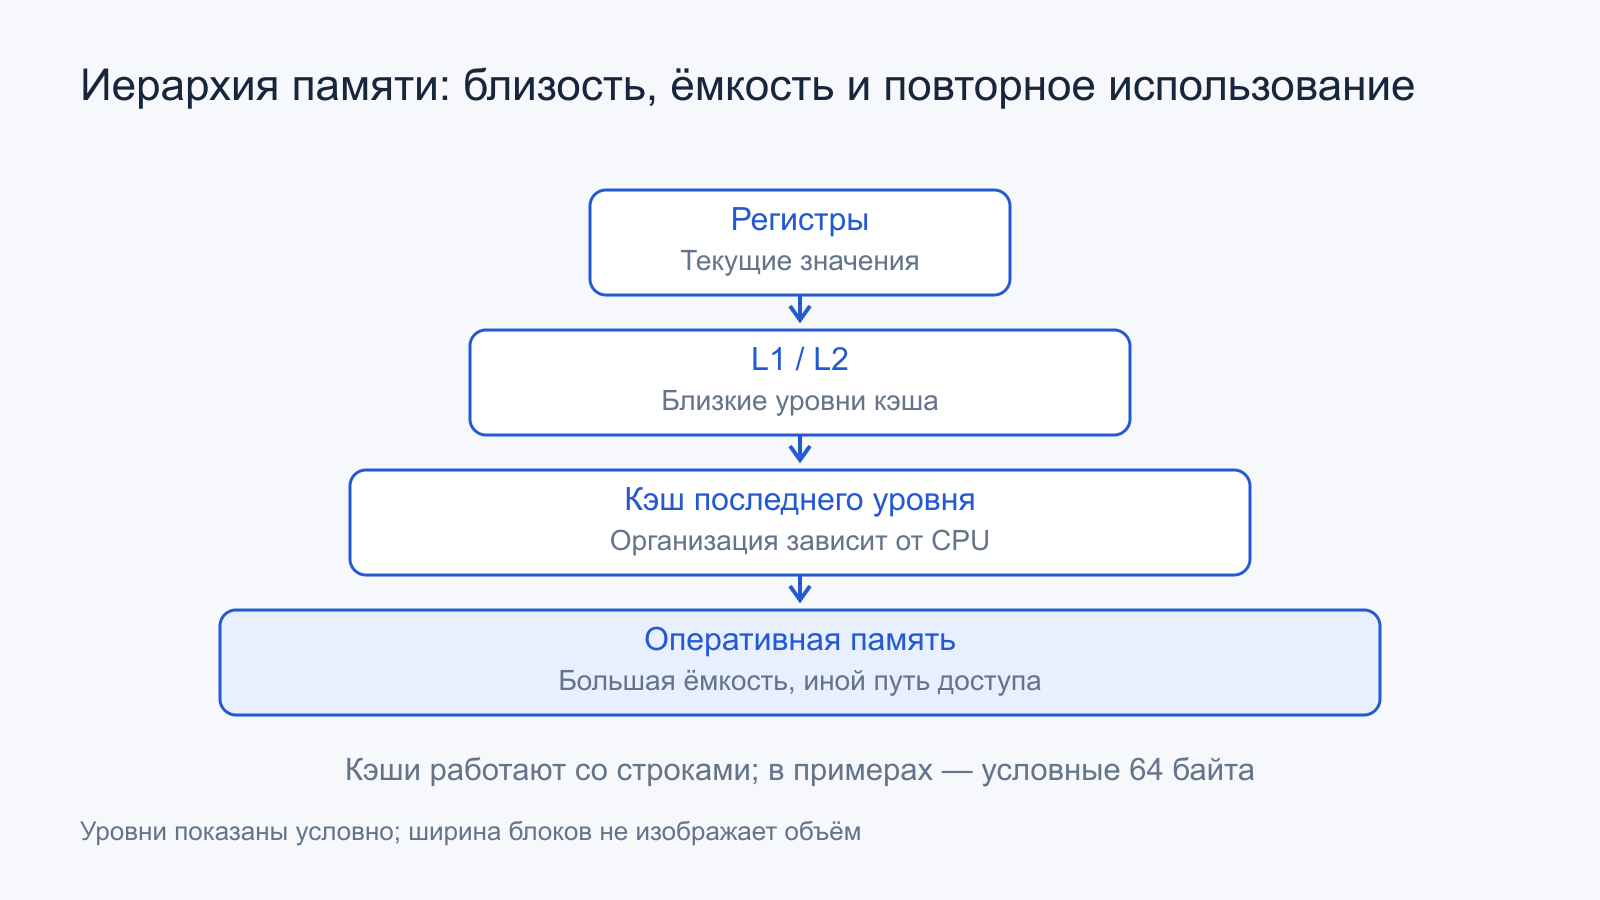
Промах не означает, что вся иерархия обязательно последовательно простаивает до DRAM. Проверки, передачи и запросы могут перекрываться; данные иногда приходят от другого ядра или через механизмы когерентности. Но концептуально полезно различать локальное попадание и обращение за пределы близкого кэша: у них разная стоимость и разная нагрузка на общие ресурсы.
Рабочий набор, локальность и бесполезно прочитанные байты
Рабочий набор — данные, которые программа активно использует на рассматриваемом участке. Общий размер файла может быть огромным, а текущий набор — небольшим. И наоборот, маленькая программа способна случайно обращаться к большому пространству. Для кэша важнее поведение доступа, чем размер исполняемого файла на диске.
Если из каждой новой строки 64 байта используется только одно восьмибайтовое значение, полезная доля переданных данных в простой модели равна 8/64 = 12,5%. При последовательном чтении всех восьми значений строка используется целиком. Реальные контроллеры и предварительная выборка меняют детали, но разница объясняет преимущество компактного размещения взаимосвязанных полей.
Вычисление над плитками матрицы позволяет повторно использовать уже загруженный участок вместо непрерывного вытеснения данных. Однако «уместилось по сумме байтов» ещё не гарантирует идеальные попадания: учитываются ассоциативность, адресное отображение, код и другие потоки. Ёмкость кэша — необходимая часть описания, но не модель всех конфликтов.
Задержка памяти и её пропускная способность — разные ограничения
Задержка показывает время ожидания отдельного запроса, а пропускная способность — объём данных за время при достаточном числе запросов. Одно зависимое чтение может долго ждать, хотя память способна передавать десятки гигабайт в секунду при потоке независимых обращений. Быстрая широкая шина не превращает цепочку указателей в непрерывный поток.
Для учебной памяти с задержкой 80 нс при строго одном незавершённом чтении строки 64 байта верхняя оценка темпа составит 64/80 нс = 0,8 ГБ/с. Это далеко от условной полосы 40 ГБ/с. Чтобы поддерживать 40 ГБ/с при таком времени обслуживания, в модели нужно держать в пути примерно 40 × 10⁹ × 80 × 10⁻⁹ = 3200 байт, то есть 50 строк.
Число 50 не является требованием к конкретному буферу ядра: в тракте работают разные очереди, несколько ядер и предвыборка, а задержка зависит от нагрузки. Расчёт связывает объём одновременно обслуживаемых запросов с полосой. Он объясняет, почему независимость обращений иногда важнее ещё нескольких процентов частоты CPU.
Предварительная выборка пытается доставить данные до явного запроса программы. Она особенно полезна при распознаваемом направлении доступа, но ошибочный прогноз расходует полосу и место. Руководство AMD Ryzen Processor Software Optimization рассматривает локальность и разделение ресурсов на конкретных примерах. Его рекомендации применяют с учётом поколения и характера программы.
Почему средняя задержка не равна времени каждой операции
Рассмотрим ещё одну условную модель с тремя окончательными исходами запроса: 95% обслуживаются за 1 нс, 4% за 5 нс, 1% за 80 нс. Времена здесь полные, а группы взаимоисключающие. Взвешенное среднее равно 0,95 × 1 + 0,04 × 5 + 0,01 × 80 = 1,95 нс. Один процент дорогих обращений добавил 0,8 нс к среднему.
Такой расчёт полезен для оценки чувствительности к редким промахам, но им нельзя просто умножить все загрузки программы. Независимые запросы перекрываются, а зависимые могут попасть на критический путь. Кроме того, очередь при высокой нагрузке меняет сами времена обслуживания. Нужны одновременно сведения о частоте событий и об их месте в последовательности работы.
Отсюда следует отличие средней скорости от редких долгих задержек. Интерактивное приложение может иметь хорошее среднее время кадра и неприятные отдельные остановки. Среднее число промахов за минуту способно скрыть короткий участок с плохой локальностью. Для таких задач полезно смотреть распределение длительностей и связывать длинные события с конкретным этапом.
Виртуальные адреса добавляют ещё один уровень работы
Обычная программа обращается к виртуальным адресам. Процессор должен связать их с физической памятью и проверить права доступа. Для ускорения преобразований служит TLB — кэш трансляций страниц. Его содержимое и назначение отличаются от кэша строк данных: попадание в один не означает попадание в другой.
При отсутствии нужной трансляции может потребоваться обход таблиц страниц. Он сам порождает обращения к памяти, часть которых ускоряется кэшами. Поэтому длинная задержка чтения иногда связана не только с получением строки данных, но и с подготовкой её адреса. При виртуализации добавляются дополнительные правила преобразования, зависящие от платформы.
Учебный пример покрытия: 512 записей TLB для страниц по 4 КиБ соответствуют 2 МиБ адресного пространства, если каждая запись описывает отдельную такую страницу. Это не спецификация реального CPU: разные типы страниц могут обслуживаться разными структурами, а ассоциативность ограничивает отображение. Покрытие объясняет, почему количество активно используемых страниц может иметь значение независимо от суммы полезных байтов.
Большие страницы способны уменьшить число требуемых трансляций, но требуют поддержки ОС и подходящего размещения. Они не увеличивают физическую пропускную способность DRAM и не устраняют настоящие зависимости. Правильный вывод после измерения — исследовать адресное поведение; автоматическая замена всех страниц на большие не является универсальной оптимизацией.
IPC имеет смысл только вместе с работой и условиями
IPC обычно означает число завершённых машинных инструкций на такт в выбранном измерении. Это не постоянный паспортный коэффициент процессора. Один и тот же CPU покажет разные значения в плотной арифметике, обработке ветвистого кода и ожидании памяти. Разные способы подсчёта тактов и инструкций также требуют осторожности.
В упрощённом случае время CPU равно N/(IPC × f), где N — число исполненных инструкций, f — частота. Для 1,2 миллиарда инструкций, IPC 2 и 3 ГГц получается 0,20 с. При IPC 1,5 и 4 ГГц — те же 0,20 с. Частоты разные, а средняя скорость завершения инструкций в этой модели одинакова.
Но даже произведение IPC на частоту не сравнивает полезную работу между произвольными программами. Векторная инструкция может обработать несколько элементов, другая программа выполнит больше скалярных инструкций. Новый алгоритм способен уменьшить N и одновременно снизить IPC, завершив задачу быстрее. Сравнивают время одного результата при одинаковой корректности, а счётчики используют для объяснения.
Векторные блоки ускоряют подходящую работу
SIMD объединяет обработку нескольких элементов одной инструкцией. Если операция над четырьмя числами заменяет четыре скалярные операции, потенциально уменьшается объём управляющей работы. Фактическая выгода зависит от ширины блока, доступных инструкций, размещения данных и возможности загрузить их с нужным темпом.
Условный расчёт пика: два блока выполняют по одной 256-битной FMA за такт, каждый вектор содержит восемь чисел FP32. Считая умножение и сложение двумя операциями, получаем 2 × 8 × 2 = 32 FLOP/такт. При 3 ГГц это 96 GFLOP/s. Предполагаются нужные блоки, независимые данные и поддержание частоты; это потолок модели, а не обещание приложению.
Если алгоритм на каждый загруженный байт делает две операции, а доступная полоса равна 20 ГБ/с, поток ограничен примерно 40 GFLOP/s независимо от арифметического потолка 96. Увеличение повторного использования данных меняет эту границу. Так появляется полезная связь между вычислительной интенсивностью алгоритма и устройством памяти.
Ядра, программные потоки и SMT
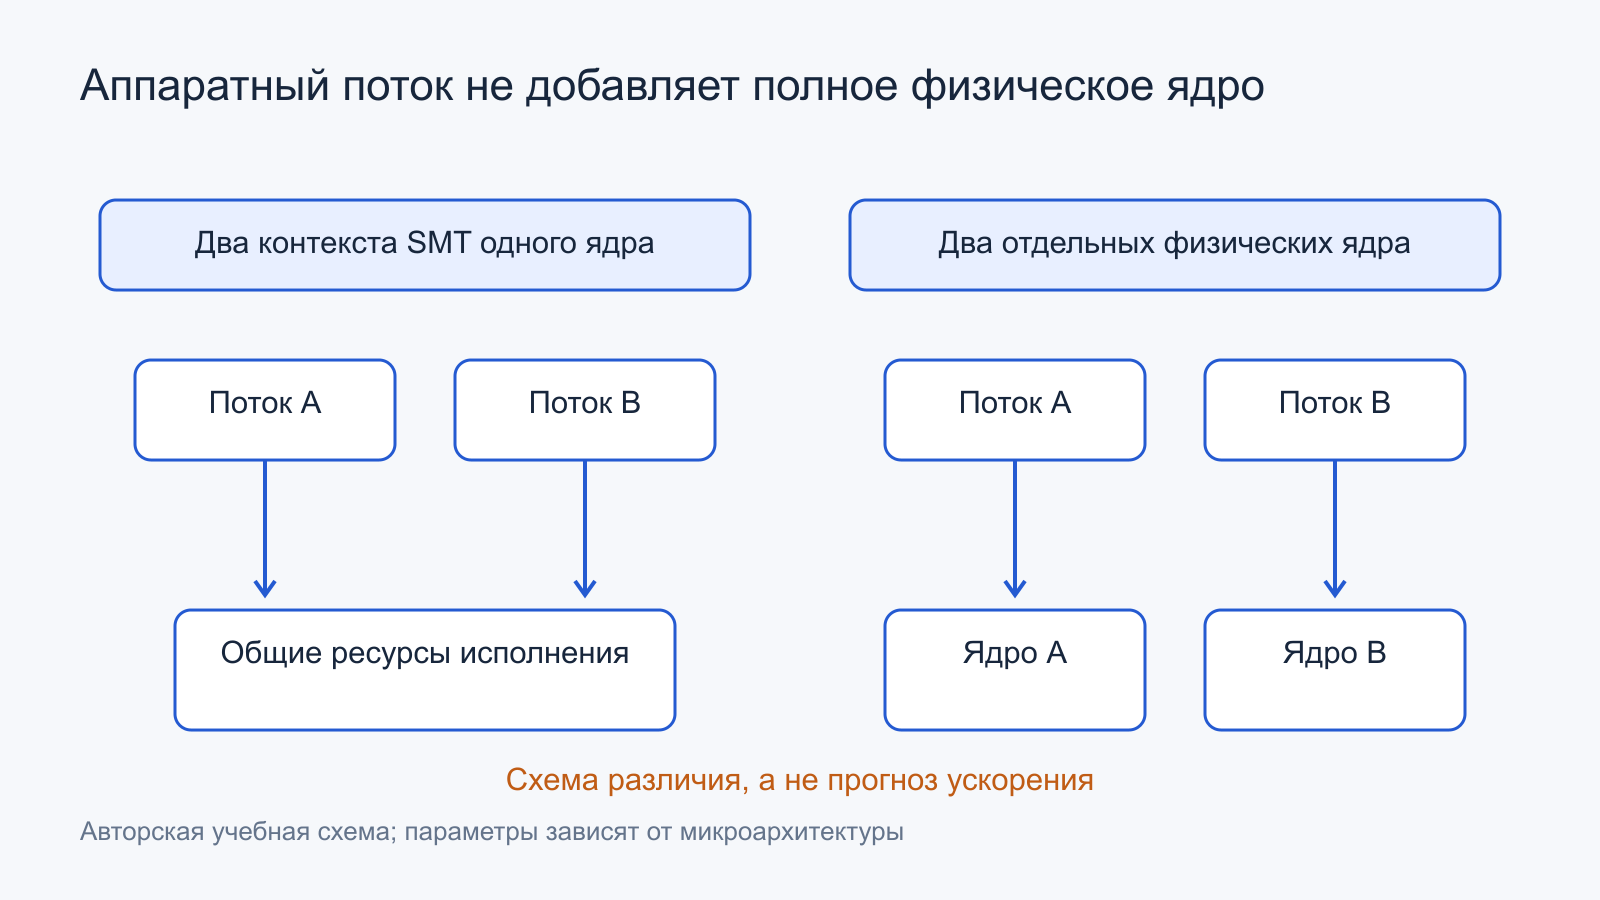
Программный поток — последовательность работы, которую планирует операционная система. Физическое ядро — аппаратные ресурсы исполнения. SMT позволяет ядру обслуживать несколько аппаратных контекстов и заполнять часть простаивающих ресурсов работой другого потока. При этом декодирование, исполнительные устройства или кэши могут оставаться общими.
Два аппаратных потока поэтому не равны двум полным ядрам. Если первый уже насыщает нужный блок или память, второй не удвоит результат и может усилить конкуренцию. Если первый часто ждёт и оставляет ресурсы свободными, общий темп способен вырасти. Для чувствительной к задержке работы и для пакетной обработки итог бывает разным.
Многоядерность требует независимых частей программы. Разделение большого массива на фрагменты обычно проще, чем ускорение длинной последовательности решений, где каждое зависит от предыдущего. Дополнительно нужны синхронизация, передача задач и распределение данных. Нулевая цена этих действий — удобное допущение для оценки потолка, но плохое описание реального приложения.
Численный предел распараллеливания
Пусть 80% исходного времени можно идеально распределить, а 20% остаются последовательными. На восьми одинаковых ядрах относительное время равно 0,20 + 0,80/8 = 0,30, ускорение — около 3,33 раза. На шестнадцати время 0,25 и ускорение 4 раза. Даже бесконечное число ядер в этой модели не даст более пятикратного ускорения.
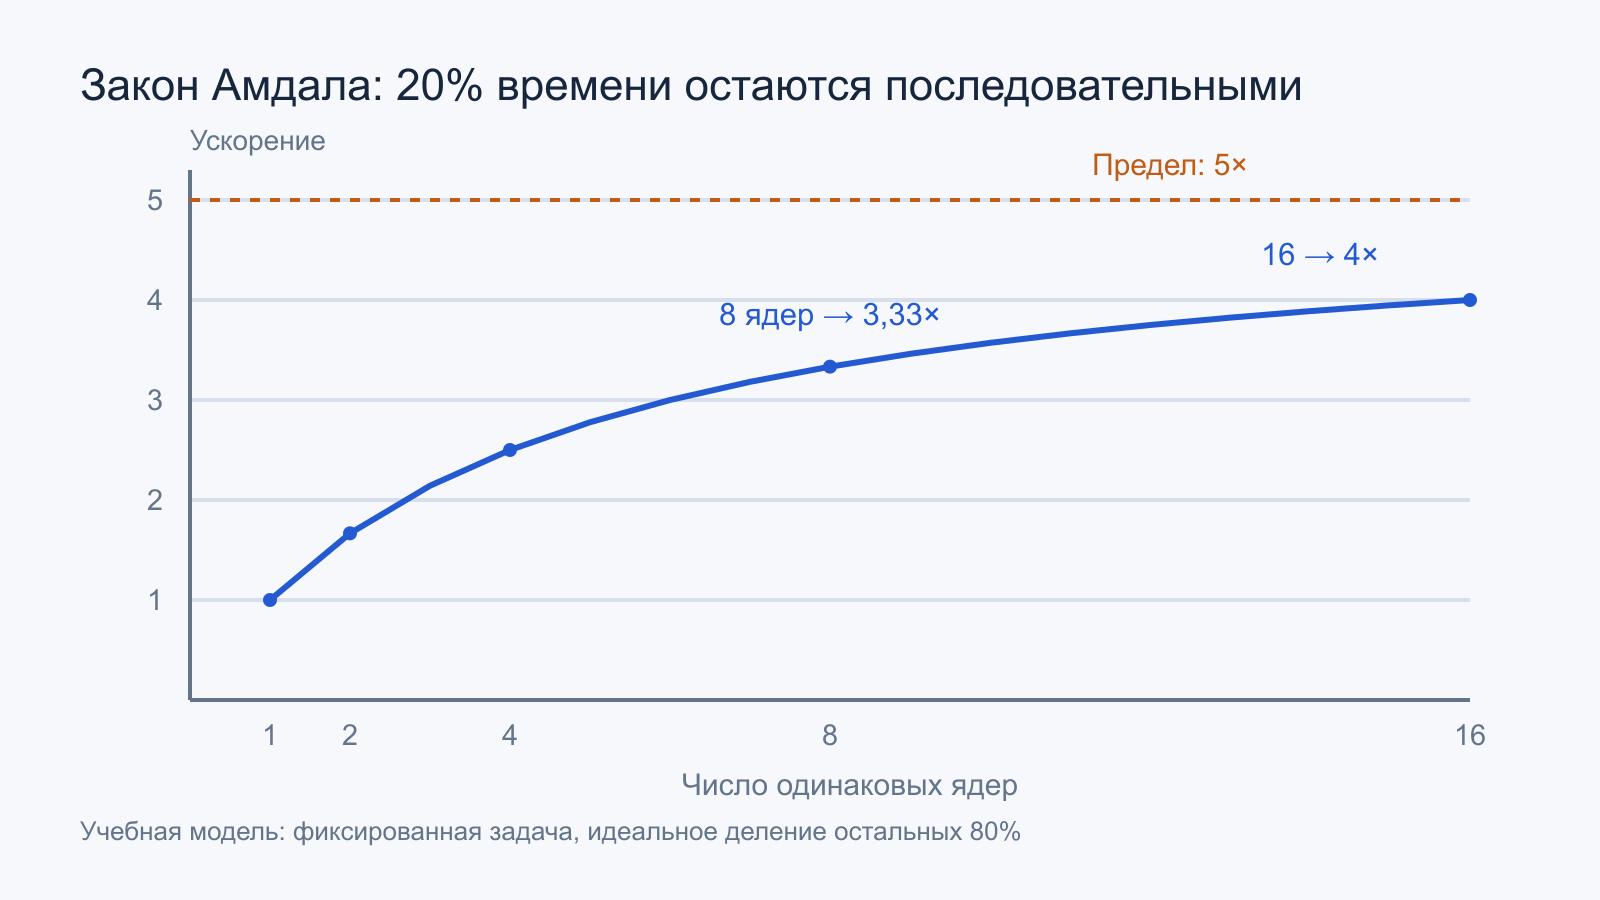
Это форма закона Амдала для фиксированной задачи. Если увеличить сам объём параллельной работы, соотношение этапов изменится. Практический вывод конкретнее лозунга «программы плохо используют ядра»: нужно знать, сколько времени занимают последовательная часть, ожидание и обслуживание параллельных задач.
Общие данные создают отдельную цену
Когерентность поддерживает согласованность копий данных в кэшах ядер. Это не означает мгновенный общий доступ без обмена. Когда разные ядра по очереди изменяют одну строку, право записи и актуальные данные могут перемещаться между ними. Частая синхронизация способна превратить быстрые локальные операции в поток межъядерных сообщений.
Особый случай — ложное совместное использование. Два потока меняют разные счётчики, но счётчики лежат в одной строке кэша. На уровне программы конфликта переменных нет; на уровне передачи строки конкуренция существует. Разнести независимые горячие данные иногда полезнее, чем повышать тактовую частоту.
При нескольких кристаллах или сокетах добавляется неодинаковая близость памяти и кэшей. Перенос потока между ядрами меняет доступность прогретых данных; не каждый общий кэш одинаково доступен каждому ядру. Это причина изучать топологию и размещение работы, а не объявлять любую миграцию ошибкой планировщика.
Разные типы ядер и динамическая частота
Производительные и экономичные ядра могут различаться шириной исполнения, кэшами и рабочими частотами. Сумма «всех ядер» не эквивалентна такому же числу одинаковых больших ядер. Планировщик учитывает доступные сведения о нагрузке, приоритетах и состоянии платформы; его решение связано также с энергией и отзывчивостью системы.
Материалы Intel по гибридной архитектуре описывают это на примере определённых поколений. Нельзя переносить их конкретные сочетания P/E-ядер и аппаратных потоков на любой последующий CPU. Для анализа важны точная модель, ОС и вид работы, а не только слово hybrid.
Частота тоже меняется: несколько активных ядер, векторная нагрузка, температура, лимит мощности и политика платформы создают разные режимы. Высокая кратковременная частота одного ядра не обещает такую же частоту всех ядер на длительном расчёте. Сравнение должно учитывать устойчивое время выполнения после выхода системы в рабочее состояние.
Динамическая мощность грубо связана с C × V² × f, но реальный CPU включает утечки и множество независимо активных блоков. Увеличение частоты часто требует напряжения и потому обходится дороже линейного роста энергии. Эту зависимость используют для понимания ограничений, а не для расчёта безопасного напряжения или настройки защит.
Как определить, что ограничивает конкретную задачу
Сначала задают измеримый результат: время кадра, компиляции, обработки блока или ответа на запрос. Затем фиксируют входные данные, версии программы и режим питания. Нельзя объединять первый запуск с чтением с диска и повторный запуск с прогретым кэшем в одну неописанную цифру. Измерение должно отвечать одному вопросу.
Полезно менять одну характеристику нагрузки. Если увеличение числа потоков перестало помогать, проверяют последовательный этап, синхронизацию и полосу памяти. Если компактный набор данных ускоряет код, исследуют локальность. Если время сильно зависит от распределения входных значений, важны ветвления и зависимости. Такие опыты направляют анализ, но сами по себе не называют единственную причину.
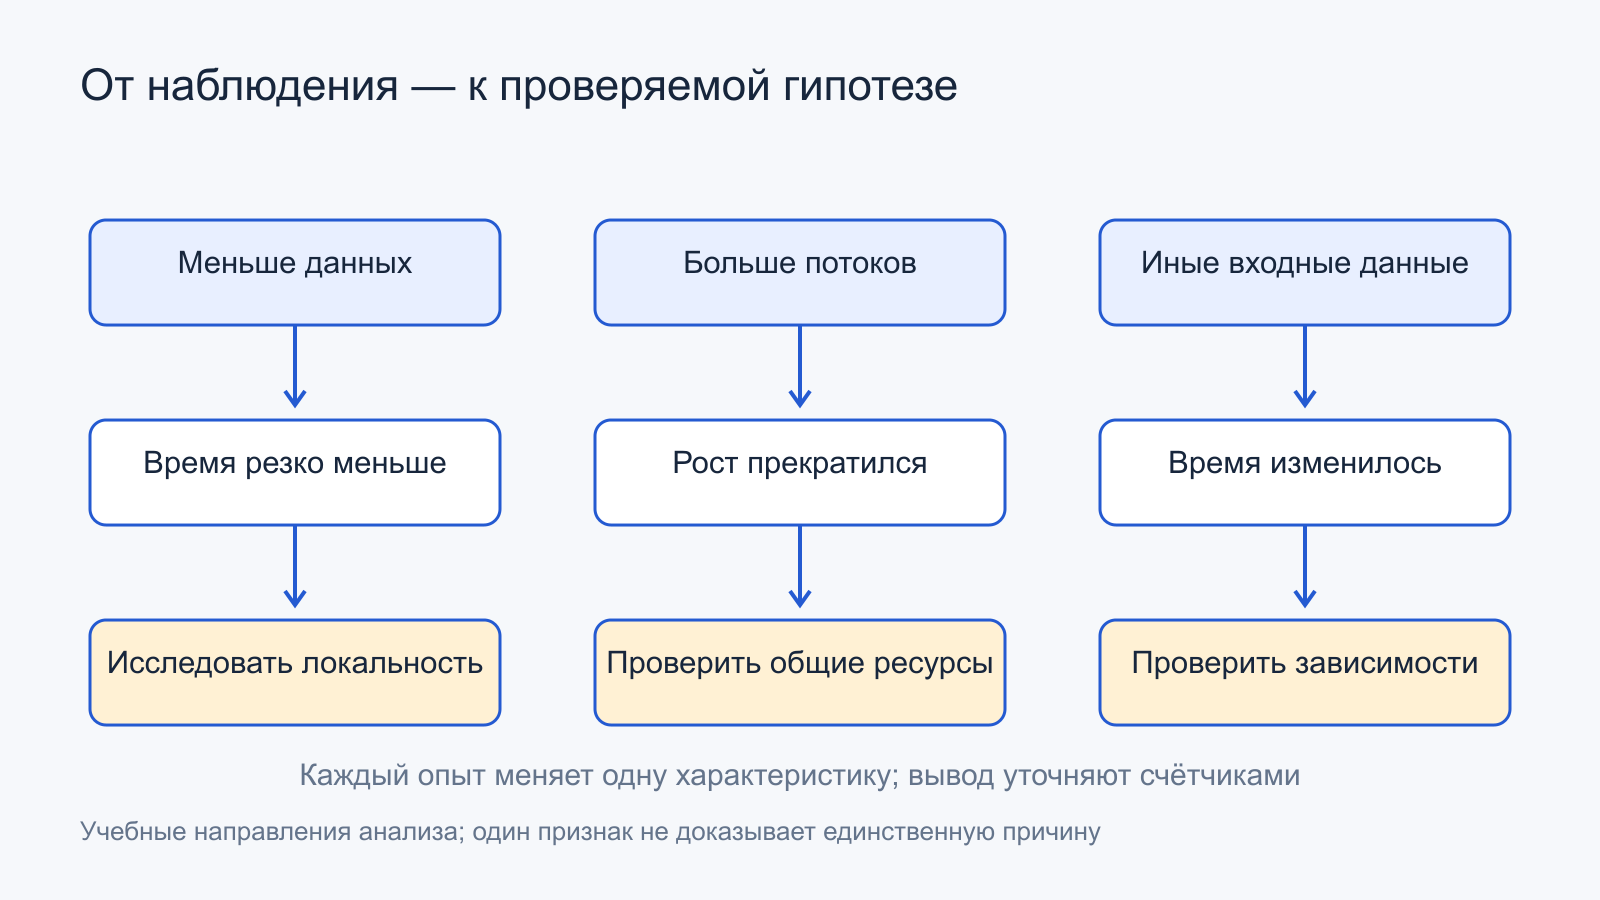
Аппаратные счётчики уточняют гипотезу: завершённые инструкции, промахи, ожидание памяти, ошибки предсказания, занятость определённых блоков. События имеют ограничения, иногда пересчитываются через выборку и мультиплексирование. Большой процент в отчёте не всегда является независимой долей времени, которую можно прямо сложить с соседними процентами.
Общая загрузка CPU особенно неоднозначна. Один занятый поток на многоядерной системе может определять всю задержку при небольшом суммарном проценте. Поток может числиться выполняющимся и ожидать данные внутри ядра. И наоборот, приложение может ждать диск, сеть или GPU и почти не занимать процессор. Сначала устанавливают этап ожидания, затем обсуждают вычислительные блоки.
Что следует проверять в любом объяснении производительности
- Сравнивается одинаковая полезная работа, а не только инструкции или гигагерцы.
- Названы конкретные типы ядер, ISA и микроархитектура.
- Задержка операции отделена от темпа независимых операций.
- Учтены рабочий набор, зависимости и число незавершённых обращений.
- Аппаратные потоки не выданы за отдельные физические ядра.
- Масштабирование связано с последовательной частью и общими ресурсами.
- Зафиксированы длительность нагрузки, частота, питание и условия измерения.
Понимание процессора начинается с пути конкретной работы: какие данные нужны следующей операции, когда они доступны и какой ресурс должен их обработать. Тогда ядра, конвейер и кэш становятся связанными механизмами, а различия между задачами получают проверяемое объяснение.
Официальные источники
- Arm — Architecture: различие архитектурного договора и аппаратной реализации.
- Intel — Intel 64 and IA-32 Architectures Optimization: руководства по микроархитектурам, задержкам и пропускной способности.
- Arm — Neoverse N2 PMU Guide: исполнение, завершение и интерпретация аппаратных событий на примере N2.
- AMD — Ryzen Processor Software Optimization, GDC 2023: кэши, локальность, SMT и профилирование на определённых поколениях Ryzen.
- Intel — Performance Hybrid Architecture: организация и программное использование разных типов ядер.
Комментарии