DDR5 в системе: каналы, ранги, тайминги и обучение памяти
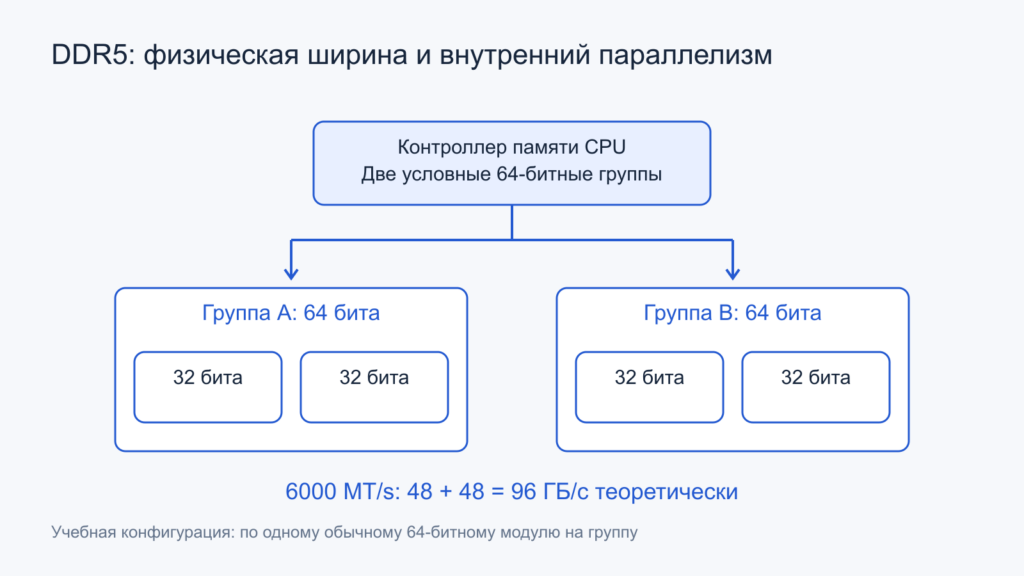
Для учебной конфигурации при 6000 MT/s полезная теоретическая полоса составляет 48 ГБ/с на группу и 96 ГБ/с суммарно. Открыть иллюстрацию в полном размере.
У памяти указано DDR5-6000, программа показывает около 3000 МГц, а диагностическая утилита сообщает о четырёх 32-битных каналах на обычной двухканальной платформе. При первом запуске компьютер долго готовит память, а четыре модуля иногда работают на меньшей скорости, чем два. Все эти особенности объясняются организацией DDR5, если последовательно разделить физическую ширину, тактирование, внутренний параллелизм и настройку интерфейса.
Здесь рассматривается работа DDR5 как подсистемы компьютера. Главные примеры относятся к обычному модулю с 64 битами полезных данных; серверные модули с внешним ECC и другие форматы оговариваются отдельно. Конкретные возможности определяются контроллером процессора, платой, типом модуля и прошивкой. Цифры из учебных моделей не являются результатами испытания определённого комплекта.
Содержание статьи
- От запроса процессора до ячеек DRAM
- Что на самом деле означает DDR5-6000
- Два субканала дают больше гибкости, сохраняя суммарную ширину
- Пакетная передача и 16n-prefetch
- Ранг не является каналом
- Банки и группы банков создают внутренний параллелизм
- CAS Latency: число тактов нужно перевести во время
- Что добавляют tRCD, tRP и состояние строки
- Обновление ячеек и смешанные потоки
- Зачем память обучается при запуске
- SPD, профили и фактически установленный режим
- On-die ECC и защита всей подсистемы
- Полоса теста зависит от того, какие байты считают
- Как читать характеристики без неверных выводов
- Официальные источники
- Читайте также
От запроса процессора до ячеек DRAM
Ядро обычно получает данные из кэшей. До оперативной памяти доходят запросы, которые нельзя обслужить ближе, а также поток записей и другие обращения системы. Контроллер памяти преобразует эти запросы в последовательность команд DRAM. Он учитывает адреса, состояние банков, очереди чтения и записи, ограничения таймингов и необходимость обновления содержимого.
Микросхема DRAM состоит из массивов ячеек, банков и схем доступа. Для чтения сначала открывают нужную строку: её содержимое связывается с усилителями считывания, образующими буфер открытой строки. Затем команда чтения выбирает нужную часть данных. Переход к другой строке того же банка требует дополнительных действий и времени.
Эту организацию не следует представлять как произвольный доступ к каждому байту за один такт. Внешний интерфейс передаёт данные пакетами, а внутри действуют ограничения последовательности команд. Высокая скорость выводов полезна, но не отменяет времени активации, закрытия строки и обновления ячеек. Контроллер пытается спрятать часть этих интервалов за полезной работой других банков.
Что на самом деле означает DDR5-6000
6000 MT/s — шесть миллиардов передач в секунду на каждой линии данных. Буква M означает миллион, T — передачу. Это не шесть миллиардов полных циклов тактового сигнала: DDR передаёт данные на обоих его фронтах. Для такого режима частота соответствующего такта составляет 3000 МГц, а период tCK — примерно 0,333 нс.
Удобные формулы: fCK, МГц = R, MT/s / 2 и tCK, нс = 2000 / R, MT/s. Для DDR5-4800 получается 2400 МГц и около 0,417 нс, для DDR5-6400 — 3200 МГц и 0,3125 нс. Удвоение здесь связано с передачей по двум фронтам, а не с дополнительными каналами.
Kingston отдельно объясняет разницу между отображаемой частотой DRAM и скоростью MT/s. Но в системе существуют и другие частоты: контроллера памяти, внутренней связи CPU и отдельных участков PHY. Их режимы и соотношения зависят от платформы. Нельзя любое число с подписью MHz автоматически удваивать и выдавать за скорость установленной памяти.
Два субканала дают больше гибкости, сохраняя суммарную ширину
У распространённого небуферизованного DDR5-модуля 64 бита полезной шины разделены на два независимо обслуживаемых 32-битных субканала. Это помогает контроллеру распределять запросы и уменьшает минимальный участок интерфейса, занятый одной передачей. Однако сумма остаётся 32 + 32 = 64 бита. Само разделение не превращает один модуль в 128-битное подключение.
У обычной платформы с двумя 64-битными группами памяти суммарно получаются четыре 32-битных субканала, если обе группы заполнены подходящим образом. Отсюда возможна надпись «4 × 32-bit» в утилите. Сравнивать её напрямую с «quad channel» другой платформы нельзя: там это могут быть четыре группы по 64 бита, то есть вдвое большая полезная ширина.
У модулей с внешними проверочными битами физическая ширина больше полезной. Например, соответствующая организация DDR5 ECC может иметь два субканала по 40 бит: по 32 для данных и дополнительные биты защиты. Эти дополнительные разряды не прибавляют пользовательскую полосу так, как ещё один канал данных. Описание конкретного RDIMM или другого модуля важнее общего названия DDR5.
Обзор DDR5 Kingston показывает разделение субканалов и отличие on-die ECC. Его ранние примеры помогают понять принцип, но не задают предельные скорости всех последующих изделий. В этой статье арифметика ширины относится к явно указанной организации, а не ко всем возможным DDR5-форматам.
Как правильно посчитать полосу
Теоретическая полоса данных равна скорости передач, умноженной на полезную ширину и делённой на восемь бит в байте. Для 6000 MT/s и 64 бит это 6000 × 10⁶ × 64/8 = 48 × 10⁹ байт/с, или 48 ГБ/с. Две такие независимые группы дают 96 ГБ/с теоретически. Здесь используются десятичные гигабайты.
Тот же результат можно получить по субканалам: каждый 32-битный при 6000 MT/s даёт 24 ГБ/с, четыре вместе — 96. Складывать сначала четыре субканала, а потом ещё умножать на два из-за слова DDR — ошибка. Два фронта уже учтены в исходных 6000 MT/s.
Это потолок интерфейса данных при подходящем потоке, а не гарантированная скорость приложения. Команды, развороты между чтением и записью, обновление ячеек, конфликты банков и недостаток запросов уменьшают эффективность. Более того, шина данных не передаёт независимые полные потоки чтения и записи одновременно: смешанную нагрузку нельзя описать простым сложением двух паспортных полос.
Почему четыре разъёма не означают четыре канала
На распространённой двухканальной настольной плате четыре разъёма позволяют установить по два модуля на каждую группу интерфейса. Второй модуль не добавляет к этой группе ещё одну независимую 64-битную шину процессора. Возникает другая конфигурация заполнения существующих каналов. Обозначения 1DPC и 2DPC говорят о числе DIMM на канал, а не о количестве самих каналов.
Дополнительные соединения меняют ёмкостную нагрузку и условия распространения сигналов. Топология проводников, размещение разъёмов, число рангов и характеристики модулей влияют на доступный электрический запас. Поэтому режим, подтверждённый для одного DIMM на канал, не обязан поддерживаться с двумя. Это ограничение подсистемы, даже когда каждый модуль по отдельности соответствует своей спецификации.
Названия и рекомендуемая последовательность заполнения разъёмов задаются руководством платы. По цвету пластика или геометрической близости к CPU нельзя вывести универсальное правило. Для понимания конкретной конфигурации полезна её схема: какие разъёмы относятся к одной группе, сколько модулей и рангов подключено и в каком режиме работает контроллер.
Пакетная передача и 16n-prefetch
У DDR5 увеличена обычная длина пакета: BL16 означает 16 передач данных на выводах за один пакет. Для субканала шириной 32 бита это 16 × 32/8 = 64 байта. Таким образом, один субканал может передать распространённый размер строки кэша без необходимости занять оба субканала одной такой передачей.
При 6000 MT/s сами 16 передач занимают 16/(6 × 10⁹) с, то есть около 2,67 нс. Это длительность данных на интерфейсе в выбранной модели, а не полное время от запроса CPU до получения строки. Перед первым элементом пакета уже могли пройти очередь, активация и CAS-задержка; после него возможны другие ограничения.
16n-prefetch описывает внутреннюю организацию доставки нескольких порций данных к внешнему интерфейсу. Это не то же самое, что предвыборка процессором будущих строк кэша. Сходство слова prefetch не делает два механизма одинаковыми: один относится к устройству DRAM, другой — к прогнозированию обращений программы.
Micron перечисляет BL16, 16n-prefetch, банковую организацию и режимы обучения в описании DDR5. У стандарта и конкретных микросхем есть дополнительные режимы, поэтому BL16 здесь используется как основной объясняющий пример, а не как утверждение о любой возможной транзакции.
Ранг не является каналом
Ранг — выбираемый набор микросхем, который предоставляет требуемые разряды данных в рамках организации модуля. Запись 1R или 2R сообщает число рангов; x8 или x16 рядом с ней обычно относится к ширине отдельного DRAM-компонента. Эти обозначения отвечают на другие вопросы, чем число каналов контроллера.
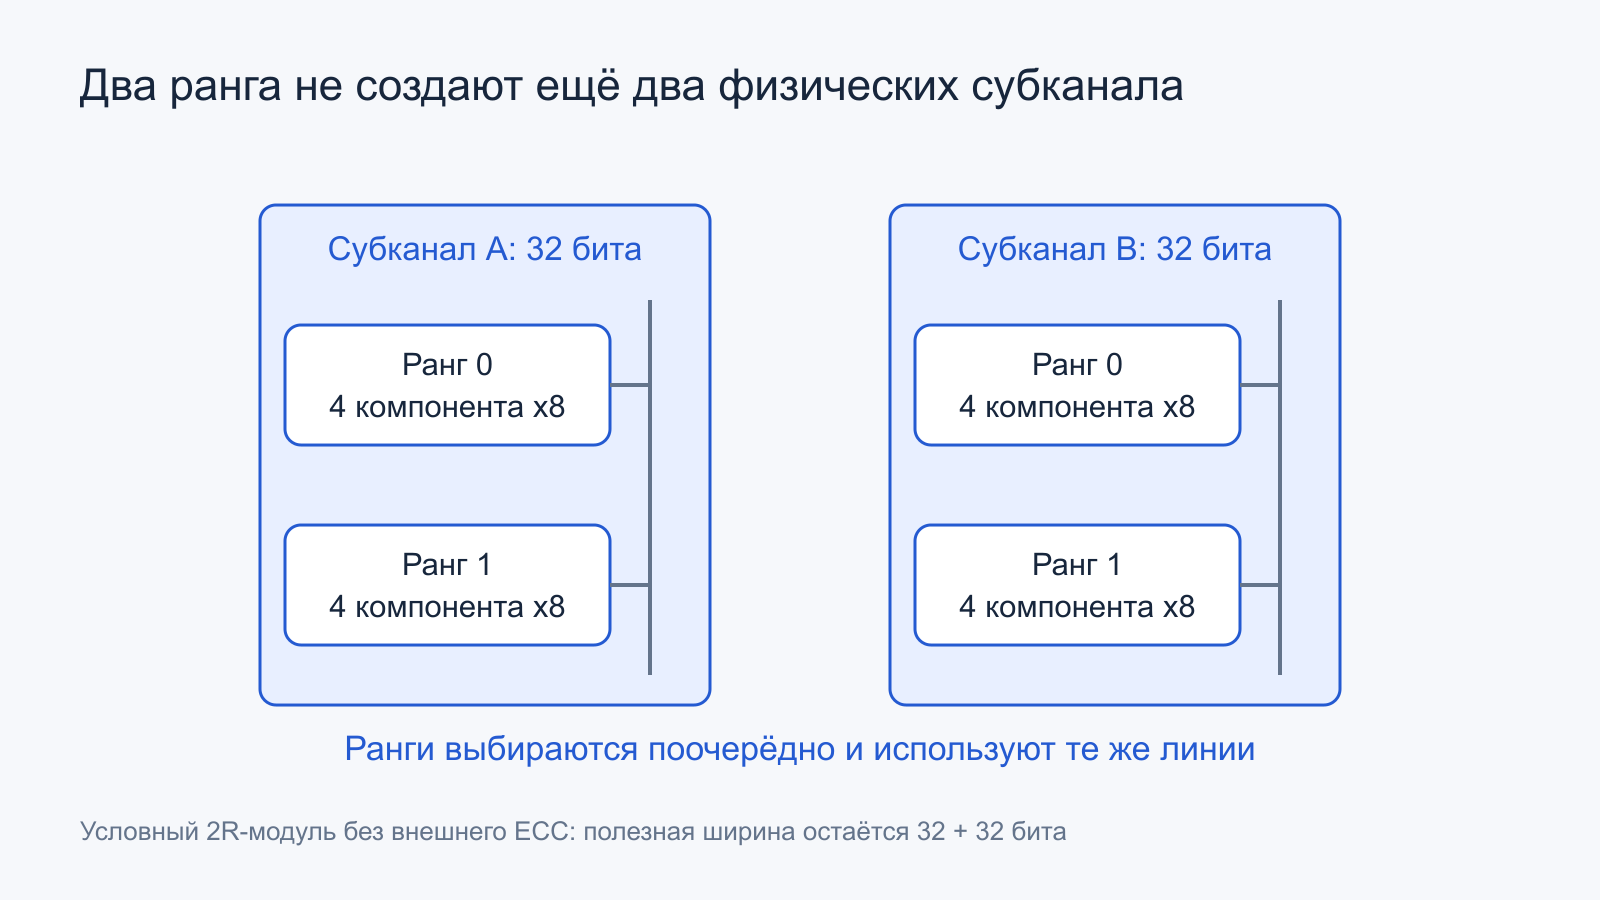
В обычном 64-битном DDR5-модуле с компонентами x8 один набор из восьми микросхем даёт 64 бита полезной ширины: по четыре x8-компонента на каждый 32-битный субканал. Если каждая микросхема имеет плотность 16 Гбит, её объём составляет 2 ГБ, а восемь вместе дают 16 ГБ. Это пример организации без внешних ECC-разрядов и без дополнительных особенностей упаковки.
При двух рангах больше наборов хранения используют те же физические линии субканалов в разные моменты. Можно подготовить работу одного ранга, пока другой ограничен внутренним ожиданием, но одновременно добавить ещё 64 независимые линии данных таким способом нельзя. Число внешних проводников не увеличивается из-за надписи 2R.
Ранг также не равен стороне платы. Микросхемы могут быть размещены с одной или двух сторон, а корпус может содержать несколько кристаллов. По внешнему виду без документации нельзя надёжно восстановить организацию. Емкость модуля тоже не задаёт ранг однозначно: более плотные компоненты позволяют получить другой объём при прежнем числе наборов.
Почему дополнительные ранги могут помогать и мешать
Несколько рангов дают контроллеру больше вариантов расписания запросов. Если один набор занят определённым внутренним действием, другой иногда способен обслуживать полезную работу. Это помогает загрузить общую шину в подходящем сценарии. Выигрыш зависит от адресного распределения и политики контроллера, поэтому его нельзя выразить постоянным процентом для всех приложений.
Одновременно меняются электрическая нагрузка и ограничения подключения. Больше модулей или рангов может потребовать другого поддерживаемого режима скорости. Получается реальный компромисс между ёмкостью, возможностями чередования и частотой интерфейса. Нельзя заранее объявить 2R всегда быстрее 1R или четыре модуля всегда быстрее двух.
Банки и группы банков создают внутренний параллелизм
Внутри микросхемы несколько банков могут находиться в разных состояниях. Пока один банк подготавливает строку, контроллер иногда обращается к другому. Группы банков организуют общие внутренние ресурсы и ограничения интервалов между командами. Поэтому одинаковое количество переданных байтов может достигаться с разным темпом при разных адресах.
В таблице Micron для определённых DDR5-компонентов x4/x8 плотностью 16–64 Гбит указаны восемь групп по четыре банка, всего 32. Для соответствующих x16-компонентов организация другая. Число «32 банка» нельзя автоматически приписать каждому DDR5-изделию, модулю и рангу без уточнения типа микросхемы.
Последовательные запросы в уже открытую строку могут оказаться удобнее конфликтующих запросов к разным строкам одного банка. Но реальные адреса программы распределяются контроллером между каналами, субканалами, рангами и банками по платформенным правилам. Простая соседняя переменная в виртуальной памяти не даёт пользователю полной карты физической организации.
На практике важны не только число банков и рангов, но и достаточное количество независимых запросов. Если программа читает связанный список и каждый следующий адрес узнаёт из предыдущего узла, внутренний параллелизм памяти может оставаться почти незадействованным. Расширение возможностей DRAM не устраняет зависимость алгоритма.
CAS Latency: число тактов нужно перевести во время
CL описывает определённый интервал между командой чтения и началом выдачи данных при заданных условиях. Это число тактов памяти, а не тактов ядра процессора. Для перевода в наносекунды используют tCL = CL × 2000 / R, где R выражена в MT/s.
Условные DDR5-6000 CL36 дают 36 × 2000/6000 = 12 нс. DDR5-6400 CL40 дают 12,5 нс. Второй режим имеет более высокую скорость передач, но его CAS-интервал немного длиннее. При этом он всё ещё способен дать большую полосу в потоковой задаче. Один набор чисел описывает несколько разных свойств.
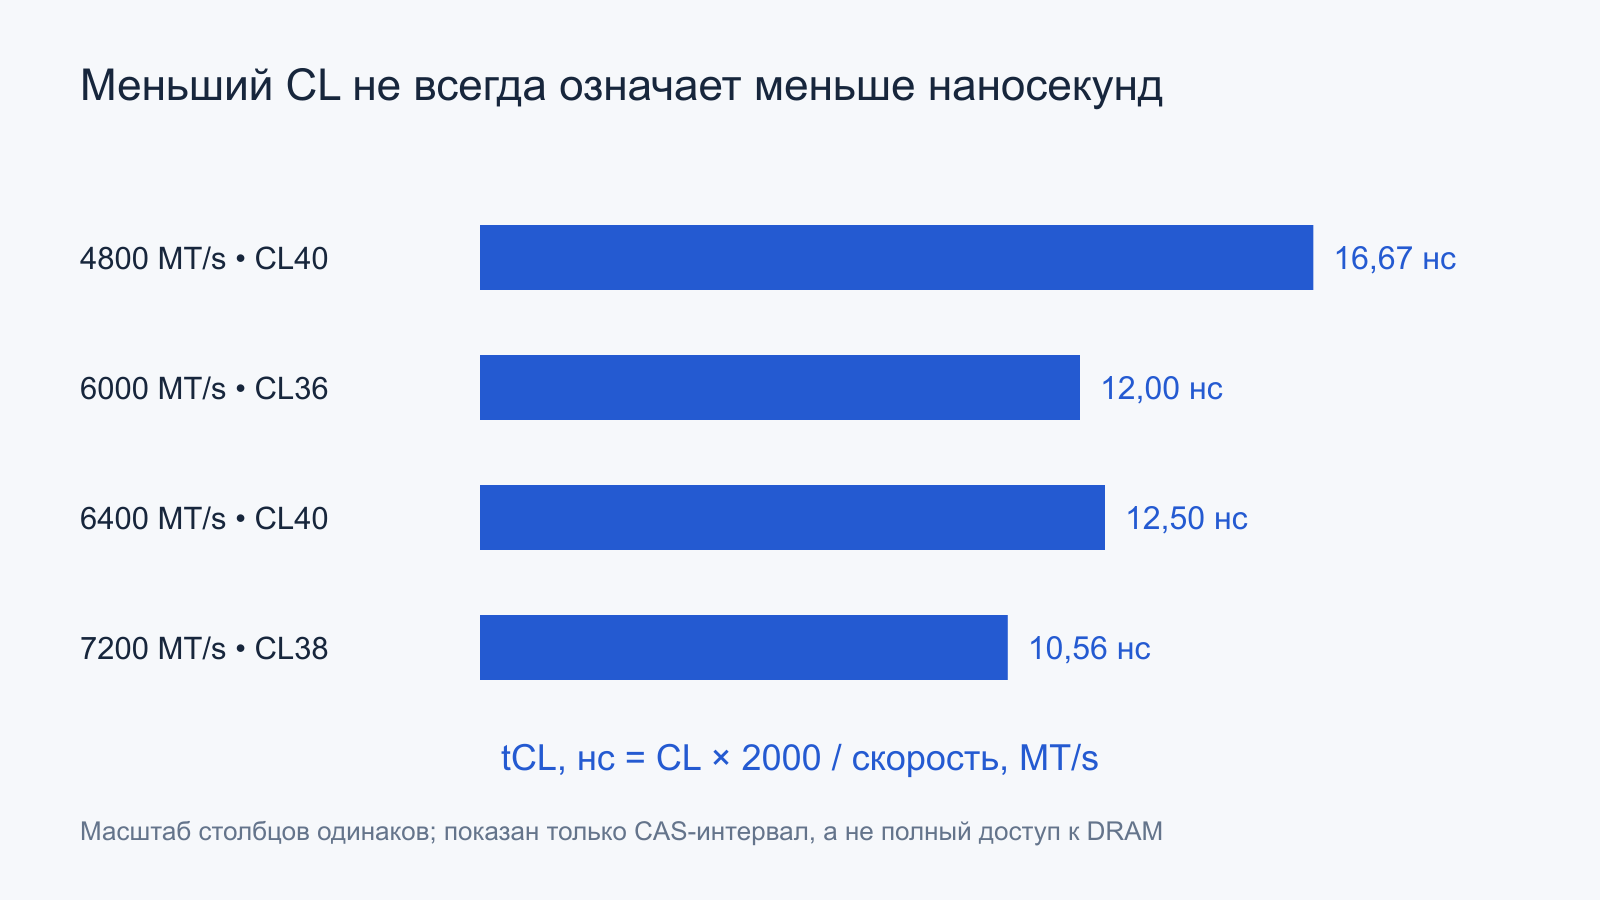
Для сравнения, DDR5-4800 CL40 соответствуют приблизительно 16,67 нс. Нельзя сравнить просто CL36 и CL40, не зная скорости. Нельзя и превратить полученные 12 нс в «полную задержку оперативной памяти»: очередь контроллера, выбор банка, другие тайминги, путь через CPU и ожидание передачи сюда не включены.
Подобный перевод применим к таймингу, выраженному в соответствующих тактах, но часть параметров определяется минимальным временем или сочетанием ограничений. При чтении спецификации проверяют единицы и условия. Автоматическое умножение любой настройки BIOS на tCK может дать неверный результат.
Что добавляют tRCD, tRP и состояние строки
Для уже открытой нужной строки чтение начинается с подходящей команды READ. Для закрытого банка сначала требуется ACT, после которой выдерживается интервал tRCD до обращения к столбцу. Если открыта другая строка, может понадобиться PRECHARGE и ожидание tRP перед новой активацией. Другие ограничения тоже должны быть соблюдены.
Учебный режим: 6000 MT/s, CL36, tRCD40 и tRP40. Один такт длится треть наносекунды. Соответственно, CL занимает 12 нс, а каждый из двух других интервалов — около 13,33 нс. Для разрешённого чтения из открытой строки упрощённая цепочка даёт 12 нс; с активацией закрытой — 25,33 нс; с предварительным закрытием другой — 38,67 нс.
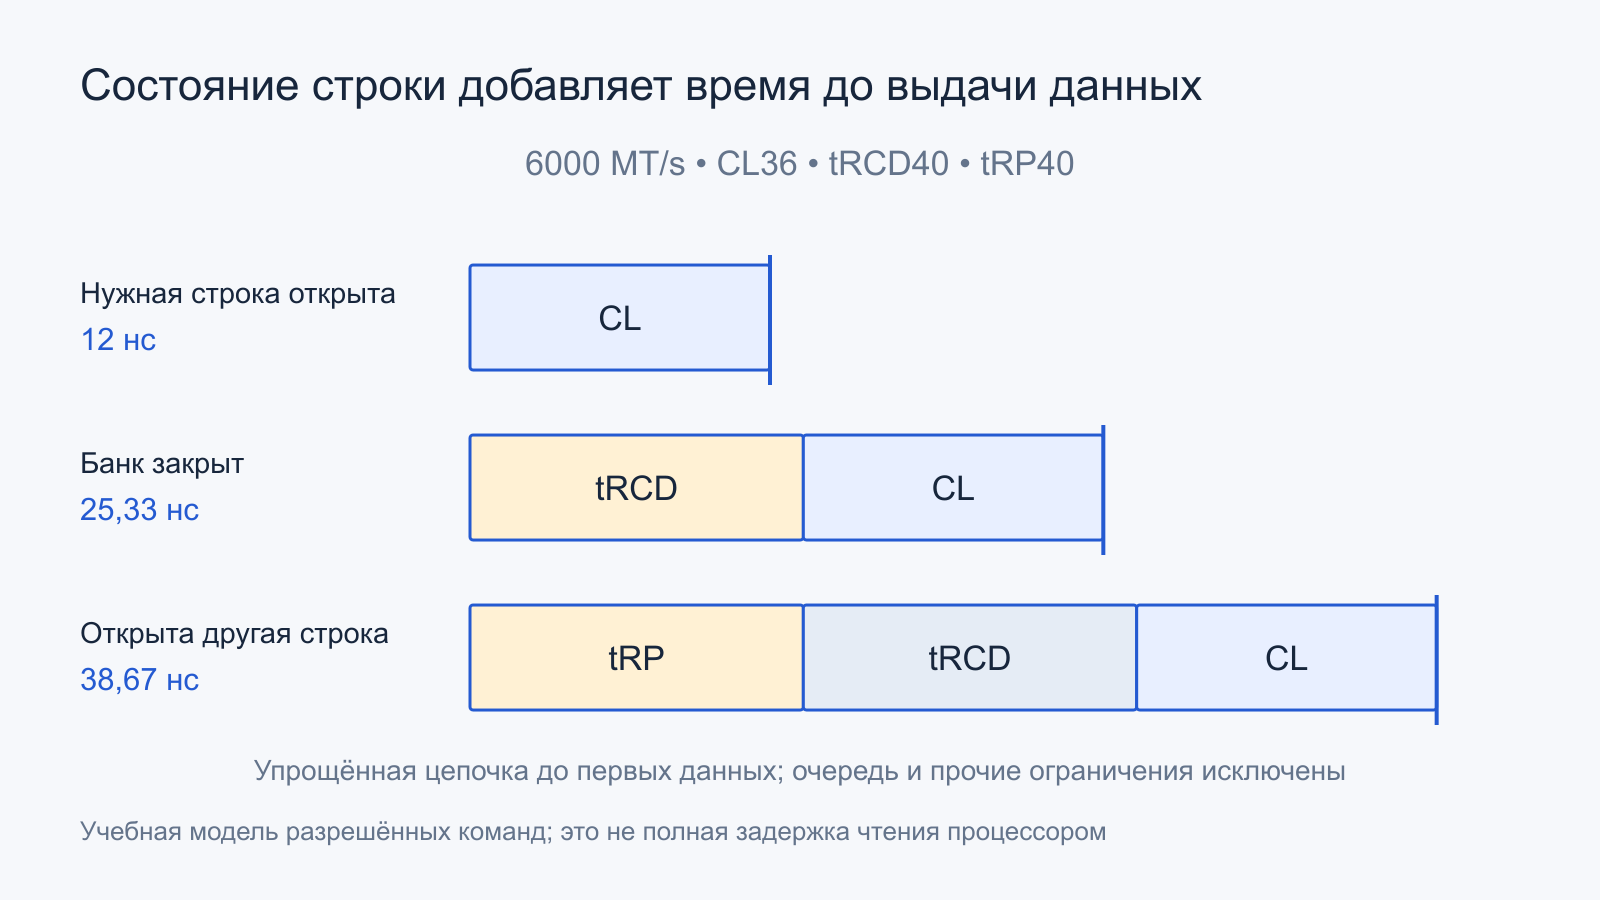
Это сумма выбранных интервалов в специально упрощённом случае, а не три гарантированные задержки CPU. В частности, прежнюю строку нельзя закрывать до выполнения ограничений её активности, а очередь запросов может добавить ожидание. Контроллер иногда заранее выполняет подготовку или обслуживает другие банки. Модель нужна, чтобы увидеть происхождение дополнительных интервалов.
tRAS ограничивает время активности строки, tRFC связан с выполнением обновления, интервалы между группами команд ограничивают темп. Настройка только четырёх популярных чисел не описывает всю память. Большая таблица таймингов существует из-за разных физических действий и общих ресурсов, а не ради усложнения интерфейса пользователя.
Обновление ячеек и смешанные потоки
DRAM должна периодически восстанавливать заряд ячеек. Обновление занимает ресурсы, которые на этот момент недоступны обычным обращениям. DDR5 имеет более гибкие варианты обновления, позволяющие в предусмотренных условиях сохранять доступ к другим участкам. Но полностью бесплатным refresh от этого не становится.
Температура, плотность микросхем и поддерживаемый режим могут менять условия обновления. Поэтому бессмысленно объяснять разницу любых двух комплектов единственным CL. Редкая длительная пауза и средняя потоковая полоса — разные стороны работы, на которые влияют разные параметры контроллера и DRAM.
Переход между чтением и записью тоже требует расписания. Контроллер может накапливать записи и выполнять их группами, уменьшая число разворотов направления. Это повышает эффективность, но меняет ожидание отдельных запросов. Измерение только чтения не предсказывает поведение того же массива при интенсивном перемешивании чтений и записей.
Зачем память обучается при запуске
На высокой скорости идеальный момент выборки данных зависит от задержек проводников, микросхем, конкретного монтажа и режима. У приёмника должно оставаться окно, где уровень и момент считывания определяются уверенно. Обучение помогает подобрать временные положения, опорные уровни и другие поддерживаемые параметры интерфейса.
Контроллер использует известные последовательности и предусмотренные процедуры, проверяет диапазоны настроек и выбирает рабочее положение с запасом. В DDR5 предусмотрены, среди прочего, обучение командного интерфейса, улучшенные режимы write leveling и шаблоны чтения. Точный набор этапов определяется аппаратурой и прошивкой; единого времени обучения для всех компьютеров нет.
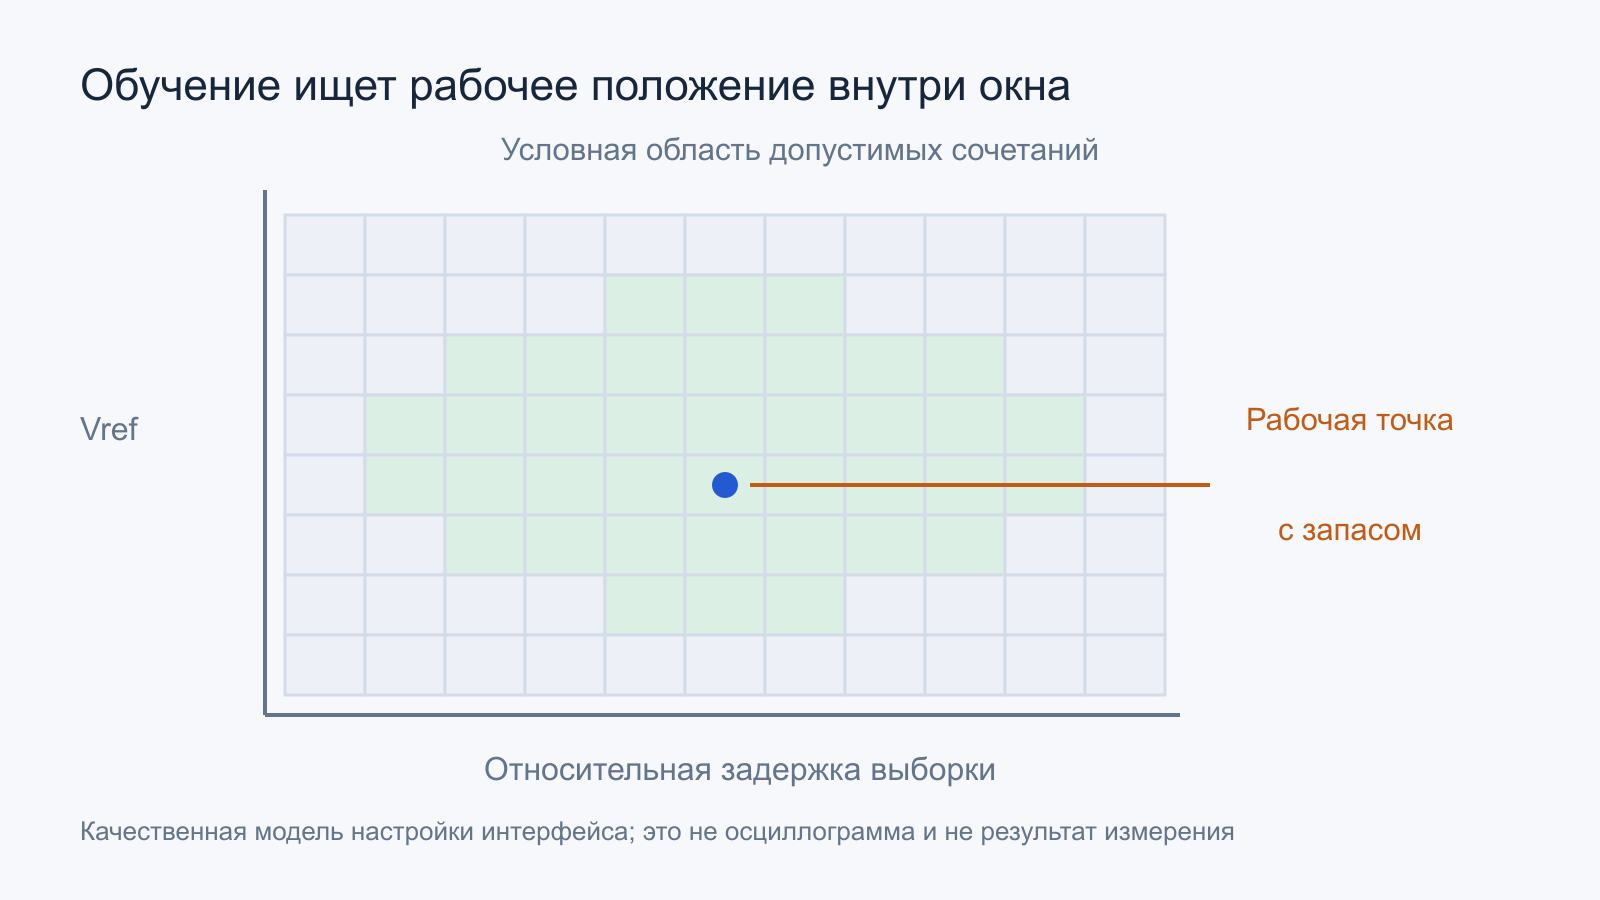
Сохранение найденных параметров способно сократить следующий запуск, но пригодность сохранённого состояния зависит от платформы и условий. Изменение состава памяти или некоторых настроек может вызвать повторную подготовку. Короткий запуск после сохранения параметров не означает отсутствия обучения в архитектуре; длительный первый запуск не доказывает неисправность.
Обучение не создаёт произвольную физическую совместимость. Если у интерфейса недостаточно электрического запаса в выбранном режиме, подбор настроек имеет предел. Успешное завершение также не равно доказательству безошибочной работы при любой температуре и нагрузке. Начальная подготовка и последующая эксплуатационная устойчивость — связанные, но разные проверки.
SPD, профили и фактически установленный режим
Данные SPD описывают модуль и поддерживаемые параметры, которые использует прошивка. Дополнительный профиль может задавать сочетание скорости, таймингов и напряжений. Запись профиля на модуле означает наличие описанного режима, но его применение требует совместимости всей системы. Установка модуля сама по себе не гарантирует активацию самого высокого указанного режима.
Показательный документ — спецификация Kingston KF572C38RW-16. В нём отдельно приведены стандартный режим SPD DDR5-4800 и дополнительные профили, включая DDR5-7200. Это конкретное изделие, а не рекомендация напряжения или обещание такой скорости любой плате. Пример объясняет различие маркировки, сохранённых наборов параметров и реально выбранного режима.
Автоматические настройки могут зависеть от модели CPU и числа модулей на канал. Таблицы правил заполнения Kingston показывают, почему официальные скорости рассматривают вместе с процессором, ранговостью и конфигурацией. Максимальная цифра в общем описании семейства не обязательно относится к заполнению всех разъёмов.
Отдельно проверяют отношение частот контроллера и памяти. Более высокая скорость интерфейса при другом режиме контроллера способна увеличить часть задержек, хотя полоса вырастет. Поэтому поиск «единственной лучшей частоты DDR5» без конкретного CPU, состава модулей и нагрузки лишён инженерного смысла.
On-die ECC и защита всей подсистемы
On-die ECC выполняет коррекцию внутри микросхемы DRAM. Он помогает работе плотного массива, но не превращает любой DDR5-модуль в системную ECC-память с защитой всего пути данных. Ошибка на внешнем участке между DRAM и контроллером относится к другой области. Дополнительные механизмы обнаружения также нельзя автоматически приравнять к исправлению любой ошибки.
Для системного ECC нужны поддержка контроллера, соответствующая организация модуля, разводка и программно доступный режим платформы. Внешние проверочные разряды не отнимают смысл on-die ECC: механизмы защищают разные участки и могут применяться совместно. Надпись «ECC inside» без указания области защиты мало говорит о возможностях компьютера.
Полоса теста зависит от того, какие байты считают
Результат «копирование 1 ГБ» может означать объём полезного результата, хотя через память должны пройти и исходные данные, и запись копии. В упрощённой модели потоковому копированию нужны минимум 1 ГБ чтения и 1 ГБ записи. При общей доступной полосе 48 ГБ/с эти 2 ГБ заняли бы не менее 2/48 с, то есть около 41,67 мс.
Если для обычной записи приходится предварительно получать строки назначения, трафик может вырасти. В условном варианте с дополнительным 1 ГБ чтения получается 3/48 с, или 62,5 мс. Реальная организация записи, состояние кэшей, размер массива и применение специальных потоковых операций меняют картину. Поэтому эти числа показывают способ учёта, а не время копирования в определённой ОС.
Когда программа сообщает полезные гигабайты в секунду, их нельзя без проверки сравнивать с суммой всех чтений и записей на шине. Часть работы могла пройти в кэшах, а часть — добавить невидимые пользователю перемещения. Методика измерения должна объяснять, какой объём находится в числителе и какие этапы вошли во время.
Как читать характеристики без неверных выводов
Предположим, две учебные конфигурации имеют одинаковую ёмкость, но одна обеспечивает 48 ГБ/с теоретической полосы, другая — 96. Для большого потока это существенная разница потолков. Если же приложение почти всё время использует кэш и читает DRAM редко, двукратный рост внешней полосы не обещает двукратного ускорения.
Иной сценарий — много независимых запросов к большому набору данных. Здесь могут проявиться полоса, банковое чередование и очереди контроллера. Для зависимой цепочки чтений важнее задержка и возможность заранее получить адрес. При недостаточной ёмкости добавляется совсем другой эффект: обращение к более медленному хранилищу. Эти случаи нельзя свести к соревнованию CL.
Полезная последовательность чтения спецификации начинается с организации и заканчивается задачей: сколько полезных бит подключено, с какой скоростью они передаются, какие интервалы действуют до данных и может ли программа заполнить этот тракт. Тогда особенности DDR5 становятся понятной системой ограничений, а не набором противоречивых цифр.
- MT/s отделены от тактовой частоты, а наносекунды посчитаны через tCK.
- Субканалы, каналы платформы, ранги и стороны модуля не смешаны.
- Полоса вычислена по полезной ширине без повторного удвоения DDR.
- CL не назван полной задержкой доступа процессора к памяти.
- Учтены состояние строки, банки, обновление и смешанные обращения.
- Профиль модуля отделён от реально применённого режима платформы.
- Обучение и on-die ECC описаны в пределах их назначения.
Официальные источники
- Micron — DDR5 SDRAM: структура банков, BL16, 16n-prefetch и поддерживаемые механизмы интерфейса.
- Kingston — DDR5 Memory Standard: два субканала, организация модуля и область on-die ECC.
- Kingston — Performance/Gaming Memory Support: различие MT/s и частоты DRAM, параметры памяти.
- Kingston — Memory Population Rules: поддерживаемые режимы при разных процессорах, модулях и заполнении.
- Kingston — KF572C38RW-16 Memory Module Specifications: пример отдельного описания SPD и дополнительных профилей.
Комментарии