CXL: расширение, совместное использование и объединение памяти
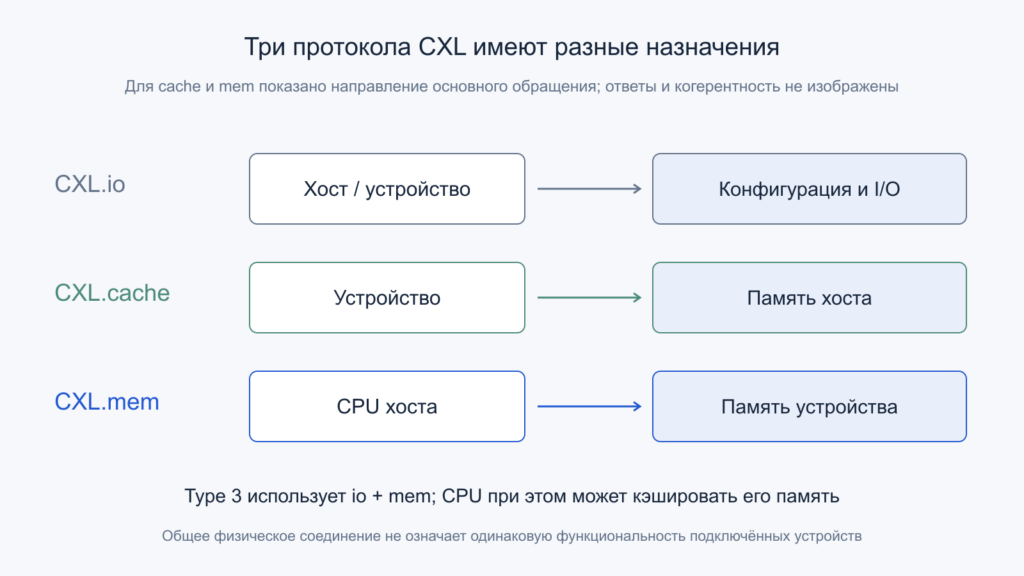
CXL.cache обслуживает согласованный доступ устройства к памяти хоста, CXL.mem — доступ CPU к памяти устройства. Ответы и служебный обмен на схеме опущены. Открыть иллюстрацию в полном размере.
CXL меняет привычную границу сервера: часть оперативной памяти может находиться за последовательным соединением, а её ёмкость — распределяться между вычислительными узлами. Но три похожих обещания, «добавить память», «собрать пул» и «дать нескольким процессорам общие данные», требуют разных возможностей. Наличие разъёма PCIe или карты с DRAM не доказывает поддержку любого из этих сценариев.
Состояние стандартов и публичных реализаций сверено на 26 октября 2026 года. Уже опубликованная спецификация CXL 4.0 рассматривается отдельно от возможностей конкретного контроллера, процессора, прошивки и ОС. Все числа ниже, кроме явно привязанных к документам параметров стандарта, заданы для учебных моделей. Это не испытания сервера владельца сайта и не прогноз скорости определённого изделия.
Содержание статьи
- Что действительно добавляет CXL к последовательному соединению
- CXL.io, CXL.cache и CXL.mem направлены на разные задачи
- Опубликованный CXL 4.0 не превращает старый сервер в новую платформу
- Расширение ёмкости начинается с адресной области одного хоста
- HDM-декодеры связывают адрес хоста с памятью устройства
- Pooling распределяет ресурс, а sharing разделяет данные
- Логическое устройство не равно отдельному физическому каналу
- Пул экономит резерв только при подходящем распределении спроса
- Согласованность требует отслеживать кэшированные копии
- Общая физическая память не задаёт одинаковые указатели процессов
- Ложное разделение переносит цену когерентности на соседние данные
- Латентность и полоса создают разные пределы
- Коммутируемая память ограничивается общими путями и очередями
- Linux предоставляет разные способы использовать CXL-ёмкость
- Данные о производительности помогают размещению, но не заменяют измерение
- Миграция страниц окупается после достаточного повторного использования
- Динамическая ёмкость требует безопасного изменения владения
- RAS и безопасность сохраняют область ответственности каждого уровня
- Как отделить работающую реализацию от обещанного сценария
- Официальные первичные источники
- Читайте также
Что действительно добавляет CXL к последовательному соединению
Обычный ввод-вывод позволяет устройству выполнять передачу блоков и сообщать о завершении. Для доступа к дополнительной памяти процессору нужны другие отношения: загрузка и сохранение по адресам, согласованность кэшированных копий, обработка ошибок и понятный жизненный цикл области. CXL объединяет такие механизмы с конфигурированием устройств, используя физическую основу PCI Express. Общая электрическая база не делает протоколы взаимозаменяемыми.
Процессорная инструкция чтения может получить данные из собственной кэш-памяти, из локальной DRAM или из памяти устройства. Для программы адрес остаётся адресом памяти, однако маршрут и его стоимость различаются. Прозрачность обращения не означает одинаковую задержку. Если алгоритм постоянно следует цепочке указателей, более длинный путь проявится иначе, чем при большом независимом потоке.
Это расширяет варианты построения системы, но не отменяет контроллеры и программное управление. Сервер должен обнаружить устройство, описать адресные окна, назначить ресурсы и предоставить память подходящему потребителю. Ошибка на любом этапе способна оставить физически подключённую ёмкость недоступной. Поэтому полноценное подтверждение работоспособности включает адресуемую область и её корректное использование, а не только успешное обучение линии.
CXL.io, CXL.cache и CXL.mem направлены на разные задачи
Документация Linux о протоколах и типах устройств различает три составляющие. CXL.io обеспечивает базовые операции конфигурирования и ввода-вывода. CXL.cache даёт устройству возможность согласованно обращаться к памяти хоста и кэшировать её. CXL.mem обеспечивает обращения процессора к памяти устройства. У двух последних похожие слова, но различается сторона, инициирующая основное взаимодействие с соответствующей памятью.
Type 1 использует io и cache, не предоставляя host-managed device memory. Type 2 добавляет устройство с собственной памятью и соответствующее взаимодействие mem. Type 3 — типичный расширитель памяти с io и mem. Его отсутствие CXL.cache не запрещает CPU кэшировать содержимое подключённой памяти: именно это недоразумение возникает при буквальном чтении названия cache без понимания направления.
Представим ускоритель, читающий таблицу хоста, и процессор, читающий массив на расширителе. В первом случае важен путь cache, во втором mem. Если оба устройства физически стоят на одинаковых линиях, их функциональность всё равно различна. Перед обсуждением скорости полезно составить карту инициаторов, владельцев памяти и поддержанных протоколов. Без неё легко ожидать от простой карты ёмкости возможностей когерентного ускорителя.
Опубликованный CXL 4.0 не превращает старый сервер в новую платформу
Консорциум выпустил CXL 4.0 18 ноября 2025 года. В релизе указаны переход от 64 к 128 GT/s, bundled ports, изменения RAS и поддержка более длинного канала с предусмотренными ретаймерами. Это статус утверждённой спецификации. Он не подтверждает, что любой доступный в продаже сервер уже реализует новую скорость или весь набор необязательных возможностей.
Обратная совместимость сохраняет возможность согласованного обмена при подходящей комбинации партнёров, но не добавляет старому кристаллу отсутствующую логику. Фактический результат определяется пересечением возможностей обоих концов и промежуточных компонентов. Пониженная скорость и ограниченный сценарий использования могут быть корректной работой совместимой системы, а не неисправностью нового устройства.
Разъяснение CXL 4.0 за январь 2026 года связывает объединение портов с конкретными типами устройств и архитектурными условиями. Поэтому нельзя представить bundled ports универсальным программным сложением любых двух расширителей памяти. Для проекта нужна таблица поддержанных возможностей платформы, а также подтверждение реализации выбранного режима, независимое от даты выпуска стандарта.
Расширение ёмкости начинается с адресной области одного хоста
Простейший сценарий — добавить процессору память устройства Type 3. У хоста появляются дополнительные физические адреса, за которыми находится удалённый контроллер и его носитель. Такая память может быть энергозависимой; слово CXL само по себе не обещает сохранения данных после выключения. Поддержка постоянной памяти является отдельным свойством устройства и стека, а не следствием последовательного подключения.
Ёмкость полезна, когда рабочий набор иначе не помещается и приложение вынуждено переходить к гораздо более дорогому маршруту. Однако все страницы не обязаны иметь одинаковую частоту использования. При разумном размещении горячие структуры остаются в локальной DRAM, а менее востребованные занимают дополнительный уровень. Если же самые частые зависимые обращения случайно попадут на медленный маршрут, увеличение общей ёмкости способно ухудшить время задачи, уже помещавшейся локально.
Поэтому оценка начинается с двух разных вопросов: хватает ли адресуемых байтов и насколько чувствительна работа к стоимости обращения. Первый проверяется размером реального рабочего набора, второй — распределением доступов и независимостью запросов. Один показатель заполнения памяти не отвечает на оба. Кроме того, место под служебные структуры и ограничения размещения способны уменьшать доступный приложению объём относительно суммы физических микросхем.
HDM-декодеры связывают адрес хоста с памятью устройства
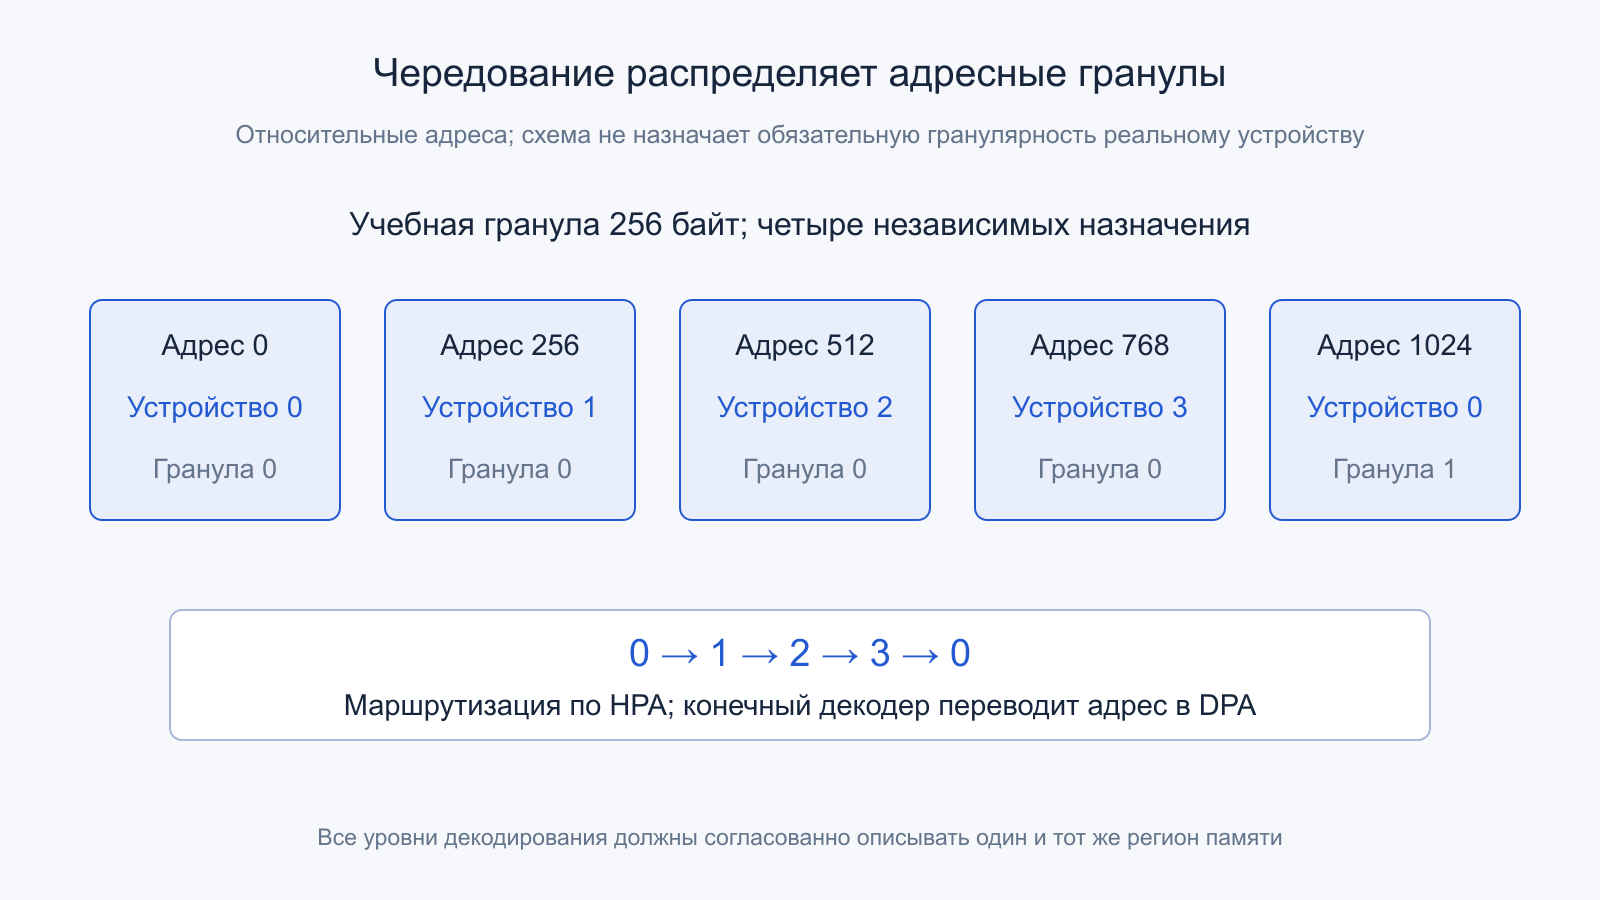
Описание CXL Driver Operation показывает иерархию root, switch и endpoint decoder. На маршруте нужно выбрать правильное назначение адреса, а на конечном устройстве сопоставить host physical address с device physical address. Это не один программный указатель, напрямую переданный микросхеме DRAM: разные границы имеют собственные адресные пространства и правила.
В учебном четырёхстороннем чередовании гранула равна 256 байтам. Последовательные гранулы с относительными адресами 0, 256, 512 и 768 направляются четырём устройствам. Адрес 1024 снова попадает в первое, но уже в его следующую гранулу. Рисунок объясняет распределение полосы и ёмкости; он не утверждает, что такая гранулярность является обязательной настройкой любого CXL-региона.
Совместимость настроек проверяют по всей иерархии. Если один уровень считает адрес частью другого диапазона или использует иное чередование, подключённые физические байты не складываются в правильную область. Возможности драйвера тоже ограничивают допустимые конфигурации. Параметр из новой спецификации нельзя автоматически считать реализованным в установленной версии ядра. Здесь особенно важны конкретная версия ПО и итоговое состояние региона.
Pooling распределяет ресурс, а sharing разделяет данные
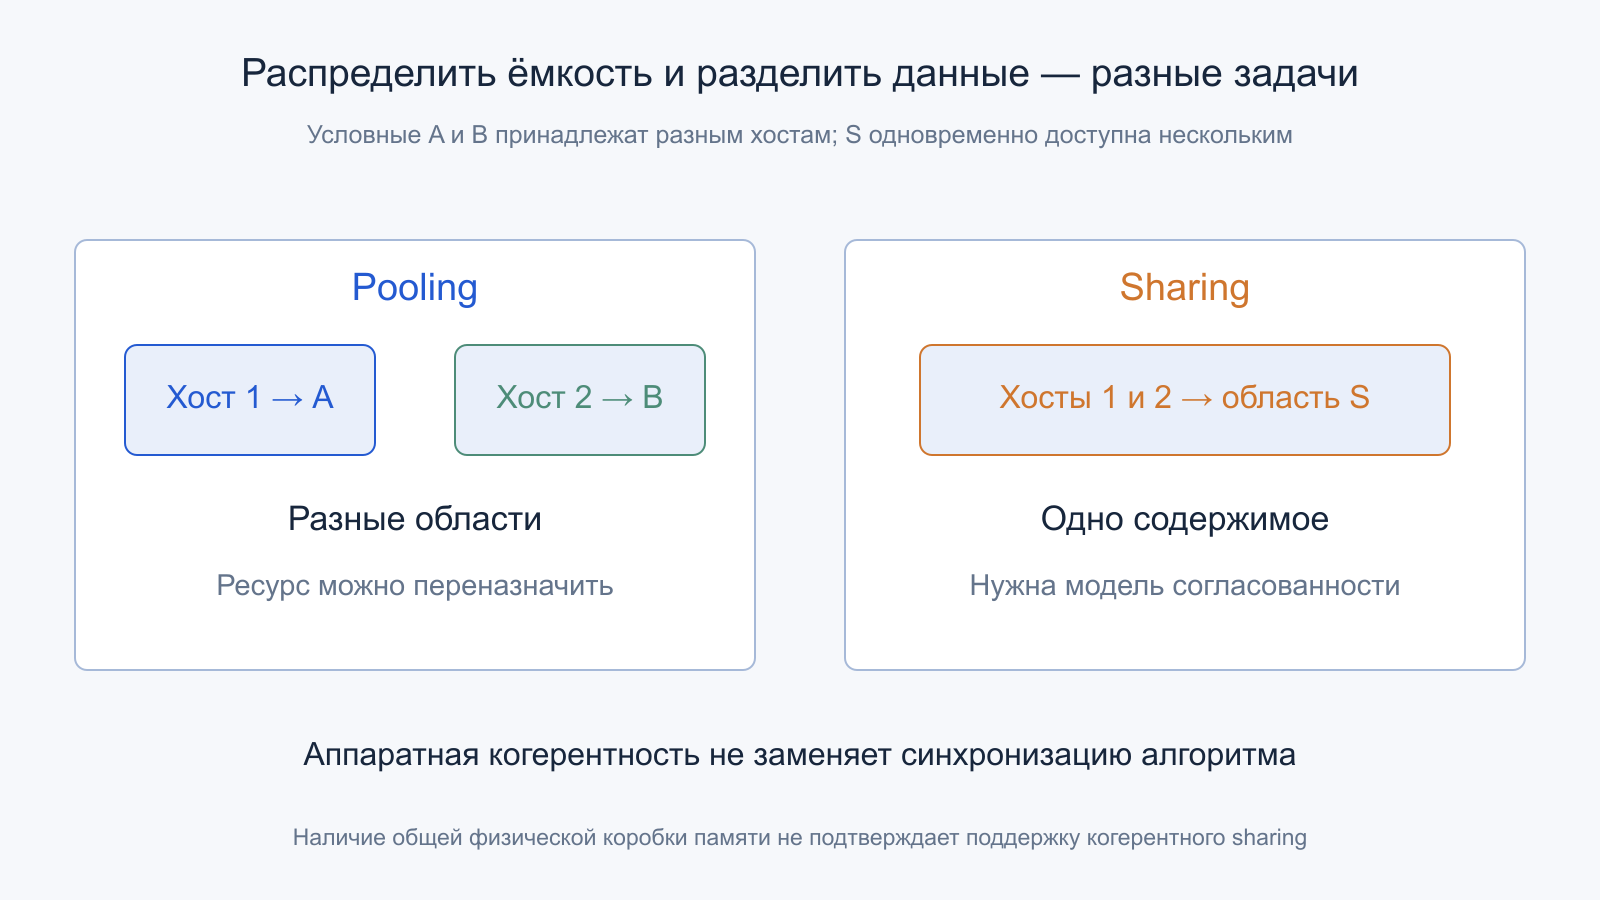
При pooling несколько хостов используют общий запас ёмкости, но выделенная область может принадлежать одному хосту в данный момент. Позднее её можно переназначить другому после предусмотренного освобождения. При sharing несколько хостов получают доступ к одному содержимому одновременно, с требуемой моделью согласованности. Совпадение общей физической коробки не делает эти отношения одинаковыми.
Официальный white paper CXL 3.0 отдельно описывает развитие pooling из CXL 2.0 и добавление sharing. Для пользователя различие принципиально: распределить серверу дополнительные гигабайты проще, чем предоставить приложениям на разных узлах корректную общую структуру данных. Второй сценарий затрагивает кэшированные копии, права доступа и программную синхронизацию.
В условном пуле из двух областей A и B первый сервер может владеть A, второй — B. Это ещё не общая таблица, которую оба изменяют по одному адресу. Для sharing таблицы понадобятся поддержка соответствующей аппаратной модели и согласованный контракт программ. Даже аппаратная когерентность не превращает две несинхронизированные записи в правильный алгоритм обновления счётчика: атомарность сложной операции и её порядок остаются отдельными требованиями.
Логическое устройство не равно отдельному физическому каналу
Один физический компонент способен представлять несколько логических устройств. Каждое получает собственное назначение и видимую хосту конфигурацию, но часть аппаратных средств остаётся общей. Это удобный способ разделять ёмкость без обязательного выделения каждому серверу целой карты. При этом количество логических представлений нельзя считать количеством независимых PHY или контроллеров DRAM.
Ответы консорциума о CXL 2.0 pooling отдельно разбирают MLD, общий физический путь и распределение полосы. Параметры относятся к указанной версии и типам компонентов. Поэтому перед построением пула проверяют не только максимальное число привязок, но и то, как общий ресурс обслуживает их одновременно.
В учебном устройстве два логических раздела могут иметь по 256 ГиБ, но делить один путь 40 ГБ/с. Если первый поток занимает 30 ГБ/с, второму не гарантированы собственные 40. Даже равные размеры разделов не задают равные приоритеты. Раздельная адресация, предел ёмкости и договорённость о производительности — три самостоятельных свойства, которые следует явно описать при проектировании и проверить при конкурирующей нагрузке.
Пул экономит резерв только при подходящем распределении спроса
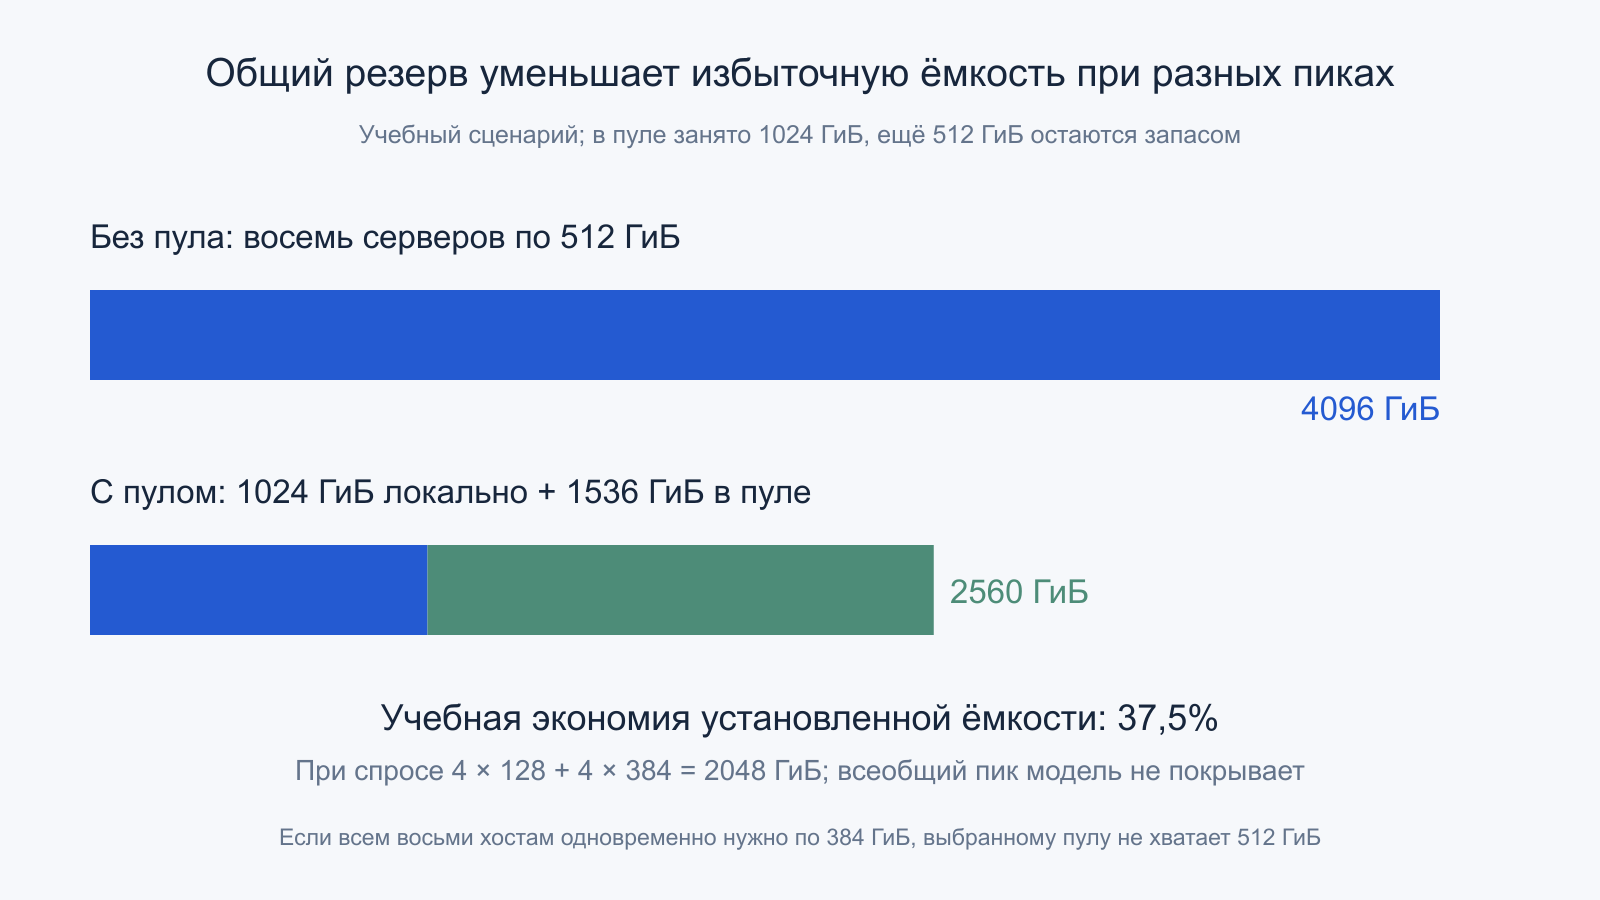
Рассмотрим восемь условных серверов, которым без пула установили по 512 ГиБ: всего 4096 ГиБ. В выбранный момент четырём нужно по 128 ГиБ, ещё четырём по 384 ГиБ, то есть суммарно 2048 ГиБ. Пусть альтернативная конструкция имеет по 128 ГиБ локально и общий дополнительный пул 1536 ГиБ. Общая установленная ёмкость тогда равна 2560 ГиБ, на 37,5% меньше исходной.
Из пула в этом состоянии заняты 1024 ГиБ: четырём тяжёлым хостам добавлено по 256. Оставшиеся 512 ГиБ являются запасом. Экономия появилась за счёт общего резерва при несовпадении индивидуальных максимумов, а не благодаря сжатию DRAM или созданию виртуальных физических байтов. Такое планирование требует наблюдать совместное распределение нагрузки, включая пики и корреляции между задачами.
Если одновременно всем восьми понадобится по 384 ГиБ, потребуется уже 2048 ГиБ сверх локальной памяти. Условному пулу не хватит 512 ГиБ. Следовательно, показанная экономия не гарантирует обслуживание любого сочетания спроса. Нужны политика допуска, резерв, предсказуемая реакция на нехватку и оценка ущерба от отказа. Именно эти условия превращают арифметику утилизации в практически пригодный план.
Согласованность требует отслеживать кэшированные копии
Память может хранить основное содержимое, пока один или несколько процессоров держат строки в кэшах. Для корректной записи нужно соблюсти правила владения и исключить использование устаревшей копии. Когерентный обмен отвечает на этот вопрос на аппаратном уровне. Он не означает, что любое чтение обязательно немедленно идёт в физическую DRAM: попадание в кэш остаётся полезной частью системы.
Разъяснения CXL 3.0 о GFAM указывают на back-invalidate со стороны устройства и собственную ответственность устройства за соответствующую функцию. Коммутатор не становится универсальным владельцем всех сведений о копиях только потому, что через него проходят пакеты. Конкретная архитектура должна определить, где находятся каталог и механизм координации.
Каталог, сообщения и ожидание ответов расходуют ресурсы. Часто читаемые неизменяемые данные могут эффективно использовать локальные копии, тогда как интенсивно изменяемая общая строка требует передачи владения. Следовательно, «общая память» не означает одинаковую цену чтения и конкурентной записи. Для архитектуры программы важно не только сколько данных разделяется, но и кто, как часто и с каким взаимным порядком их изменяет.
Общая физическая память не задаёт одинаковые указатели процессов
Два процесса могут отобразить одну область в разные виртуальные адреса. Если первый запишет внутрь обычный указатель своего адресного пространства, второй не обязан получить пригодную ссылку. Когерентная передача сохранит записанные биты, но не изменит таблицы страниц другого процесса и не придаст этим битам одинаковый смысл. Поэтому формат разделяемых структур данных необходимо проектировать отдельно от аппаратного транспорта.
Один вариант учебного представления — хранить смещение относительно начала общей области. При базе первого процесса 0x10000000 и смещении 0x200 адрес будет 0x10000200; при базе второго 0x70000000 тот же объект окажется по 0x70000200. Сохраняется смещение, а не равенство абсолютных виртуальных адресов. Реальная реализация дополнительно проверяет границы, права доступа, выравнивание и время жизни объекта.
Также требуется определить публикацию нового объекта: в какой момент другой участник может читать его поля, чем выражается завершение и кто отвечает за освобождение. Наличие общего массива байтов не устраняет гонки и обращение к уже освобождённой памяти. Эти вопросы остаются существенными даже при идеальном канале без задержек и ошибок; распределённый маршрут лишь делает цену неудачного протокола заметнее.
Ложное разделение переносит цену когерентности на соседние данные
Два независимых восьмибайтных счётчика могут находиться внутри одной условной 64-байтной кэш-строки. Если разные хосты часто изменяют каждый свой счётчик, конфликт возникает на общей единице когерентности. На уровне алгоритма значения не связаны, однако аппаратуре приходится согласовывать владение более крупной областью. Этот эффект называют false sharing, и увеличение числа участников способно усилить его.
В учебной оценке десять миллионов передач одной полной 64-байтной строки в секунду означают 640 МБ/с содержимого строк. Изменяемые восемь байт на событие дают только 80 МБ/с логических обновлений. Управляющие сообщения и остальные расходы исключены, а модель не устанавливает достижимое число передач владения. Она лишь показывает, почему полезные байты счётчика не равны цене обмена.
Разнесение независимых изменяемых полей по подходящим границам способно убрать часть конфликтов, но увеличивает рабочий набор. Для некоторых структур выгоднее локальное накопление с редким объединением результатов. Решение зависит от требований видимости и допустимой задержки. Полезно анализировать реальные разделяемые строки и атомарные операции, прежде чем объяснять медленную программу недостатком пиковой полосы CXL.
Латентность и полоса создают разные пределы
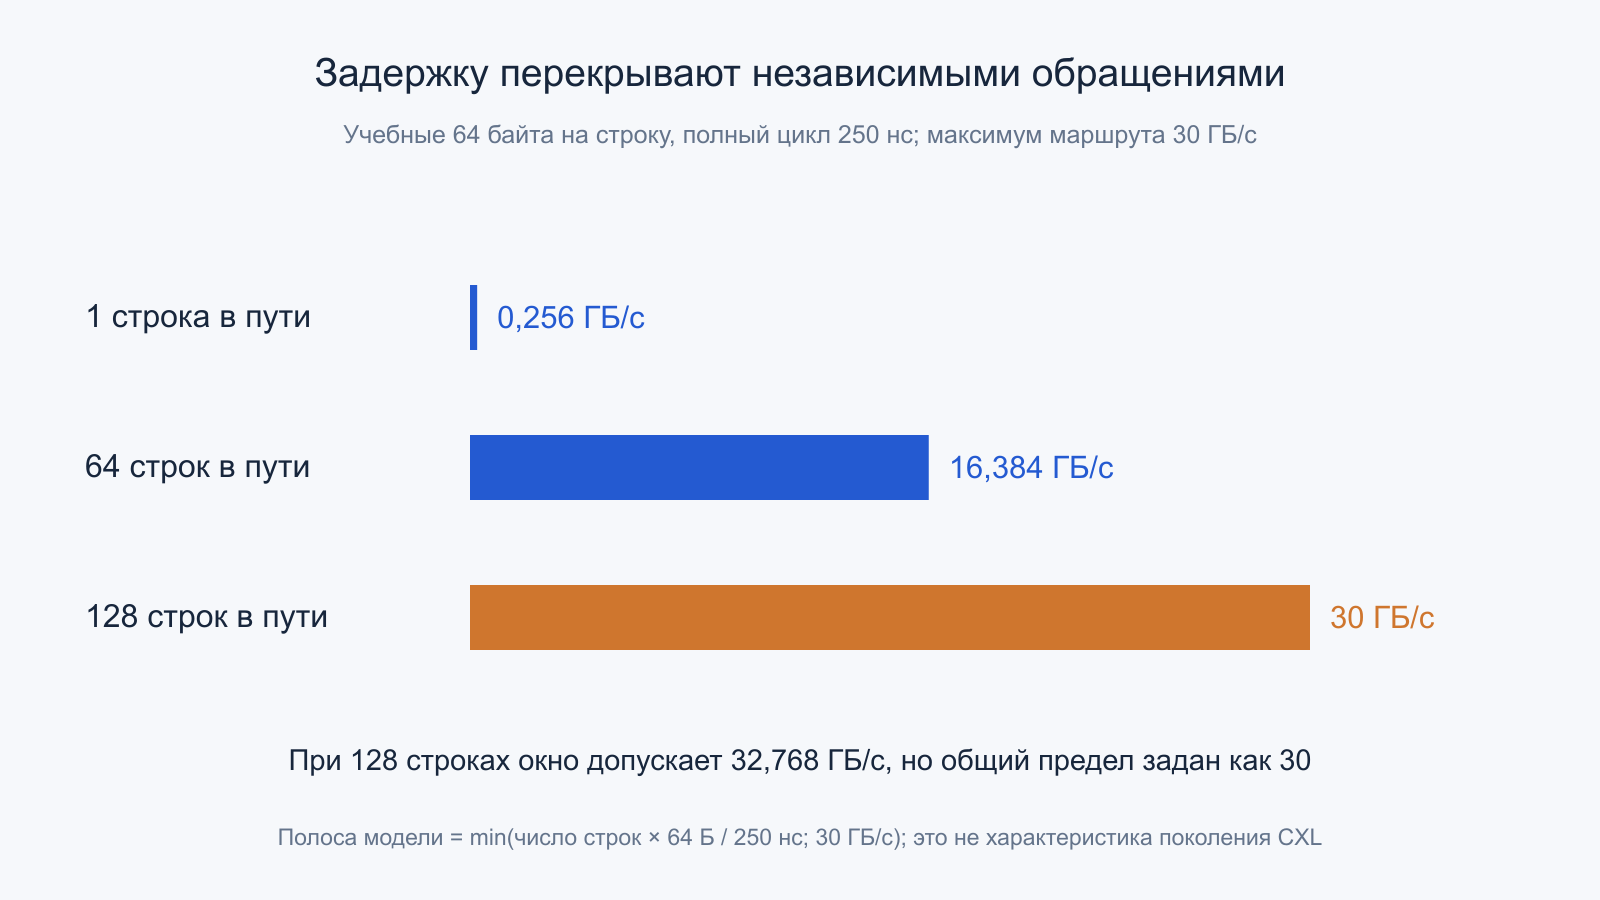
Зададим задержку полного обращения к дополнительной памяти 250 нс и полезную строку 64 байта. При одном зависимом запросе деление даёт всего 256 МБ/с. При 64 независимых строках в пути та же модель допускает 16,384 ГБ/с, при 128 —32,768 ГБ/с. Если эффективная граница маршрута дополнительно ограничена 30 ГБ/с, последняя оценка будет ограничена именно ею.
Эти числа не характеризуют поколение CXL: задержка и доступная полоса заданы произвольно. Для высокоскоростной передачи требуется достаточно одновременно обслуживаемых полезных данных. Зависимая цепочка указателей не получает нужную независимость от одного увеличения лимита очереди. Наоборот, поток по множеству массивов способен перекрывать ожидание, пока не упрётся в общую связь, память или получателя.
Также важно назвать границу времени. Полный доступ CPU включает локальные проверки, маршрут, устройство и возвращение данных. Задержка одного PHY или коммутатора является только частью. Заявление производителя о неизменной задержке определённого протокольного механизма не обещает одинаковой задержки всей системы при удвоении скорости. Сопоставлять следует одинаково определённые операции в устойчивом режиме.
Коммутируемая память ограничивается общими путями и очередями
Несколько устройств могут иметь отдельные нисходящие соединения и общий восходящий путь к хосту. Если каждое способно отдать по 20 ГБ/с, четыре устройства не гарантируют 80 ГБ/с процессору через участок с пределом 40 ГБ/с. Это обычное ограничение общей границы. Чередование полезно распределяет обращения, но не создаёт дополнительной физической полосы на уже насыщенном участке.
При конкурентной нагрузке возникает распределение очередей. Средняя задержка одного хоста способна зависеть от поведения соседнего, даже если выделенные области памяти не пересекаются. Изоляция адресов не означает изоляцию производительности. Для предсказуемого обслуживания нужны правила арбитража, управление загрузкой и проверка задержек при одновременной работе нескольких потребителей.
Дополнительный переход также создаёт отказную границу и усложняет наблюдение. Простой одиночный опыт не показывает поведение при сбое устройства, перегрузке общего канала или смене конфигурации. В содержательном протоколе фиксируют полную топологию, конкурирующие потоки и распределение времени ответа. Карта физического маршрута помогает отличить нехватку памяти на конечном устройстве от очереди в промежуточном звене.
Linux предоставляет разные способы использовать CXL-ёмкость
Описание DAX-драйвера показывает две принципиальные возможности: представить область через устройство DAX для прямого отображения или включить её в управляемую ядром память через механизм hotplug. Эти пути решают разные задачи размещения. Наличие файла устройства не означает автоматического добавления той же области ко всем обычным выделениям процесса.
Ручное управление позволяет приложению осознанно выбирать, какие данные размещать в дополнительной памяти. Включение в обычный распределитель упрощает использование, но делает особенно важной политику NUMA и уровней памяти. Также требуются служебные описатели страниц, корректное время жизни отображений и поддержка выбранной конфигурации в ядре. Прозрачность кода не устраняет эти расходы.
Документация описывает конкретную реализацию Linux, поэтому её нельзя объявить обязательным внутренним устройством Windows или любой прошивки. Для воспроизводимого результата записывают версию ядра, режим области, состав NUMA-узлов и способ распределения страниц приложением. Проверять нужно фактическое размещение рабочего набора, иначе опыт может всё время обращаться к локальному кэшу или DRAM и ничего не сказать о CXL-пути.
Данные о производительности помогают размещению, но не заменяют измерение
Документ о CXL access coordinates объясняет использование сведений ACPI и CDAT для построения характеристик доступа. Они помогают описать путь от процессора к области памяти, включая устройства, отсутствовавшие на раннем этапе загрузки. Однако заявленная координата не является универсальным временем каждой будущей инструкции: очередь, кэширование и реальная нагрузка меняют наблюдение.
В учебном двухуровневом случае локальный доступ занимает 100 нс, дополнительный —250 нс. Если доля последних равна 10%, простое средневзвешенное время составляет 115 нс; при 50% —175 нс; при 90% —235 нс. Здесь обращения не перекрываются, а остальные эффекты исключены. Распределение горячих данных важнее одной доли установленной ёмкости.
В частности, половина физических страниц на дополнительном уровне может обслуживать лишь десятую часть обращений или, наоборот, почти все. Поэтому процент размещённых байтов не следует подставлять вместо процента доступа без проверки. Данные о задержках и полосе полезны для начальной политики, а её результат оценивают по времени полезной задачи и доступным счётчикам в согласованном эксперименте.
Миграция страниц окупается после достаточного повторного использования
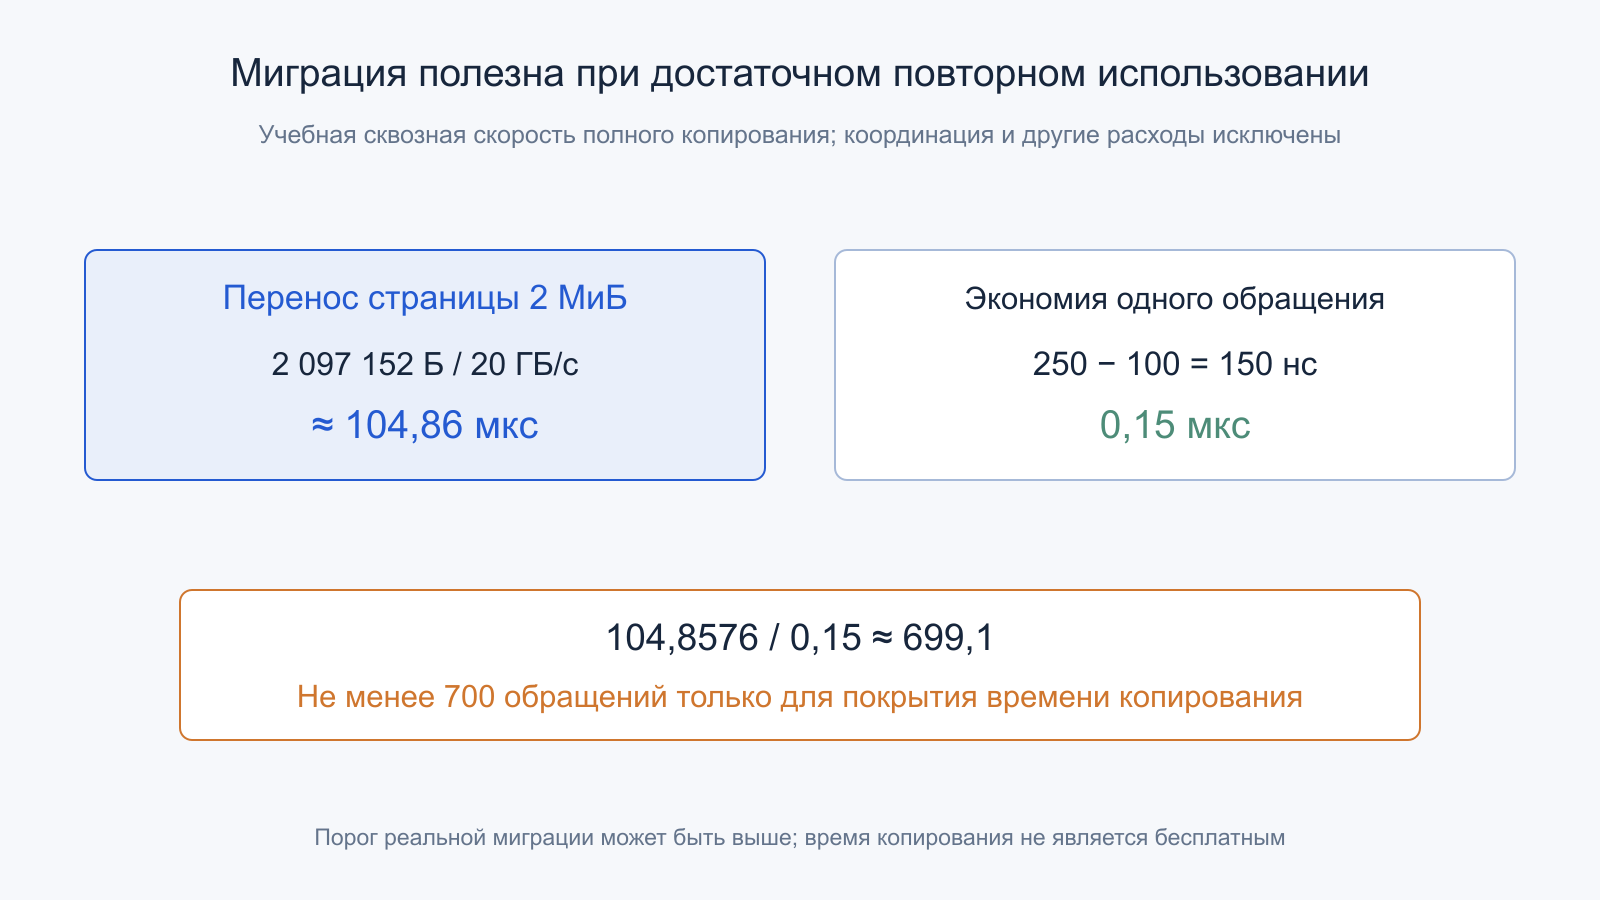
Перенести страницу на быстрый уровень тоже стоит времени и полосы. Пусть учебная страница имеет размер 2 МиБ, а измеренный для модели эффективный темп её полного копирования задан как 20 ГБ/с. Перемещение занимает не менее 104,86 мкс. Это сквозная скорость выбранной операции копирования; повторное удвоение числа байтов в этой формуле не требуется.
Если каждое последующее зависимое обращение экономит 150 нс, чисто арифметический порог составляет примерно 699,1 обращения: понадобится не менее 700. Реальная миграция дополнительно меняет отображения и требует координации, поэтому достижимая граница может быть выше. Если страница будет прочитана лишь несколько раз, её перенос способен стоить дороже сохранения на прежнем уровне.
Политика должна учитывать длительность горячей фазы и риск колебаний. Частое перемещение туда и обратно расходует общий ресурс и может вытеснять действительно востребованные страницы. Идеальный прогноз будущих обращений отсутствует, поэтому полезны устойчивые правила и наблюдение за ошибками классификации. Миграция — отдельная работа системы, а не бесплатный побочный эффект наличия второго уровня памяти.
Динамическая ёмкость требует безопасного изменения владения
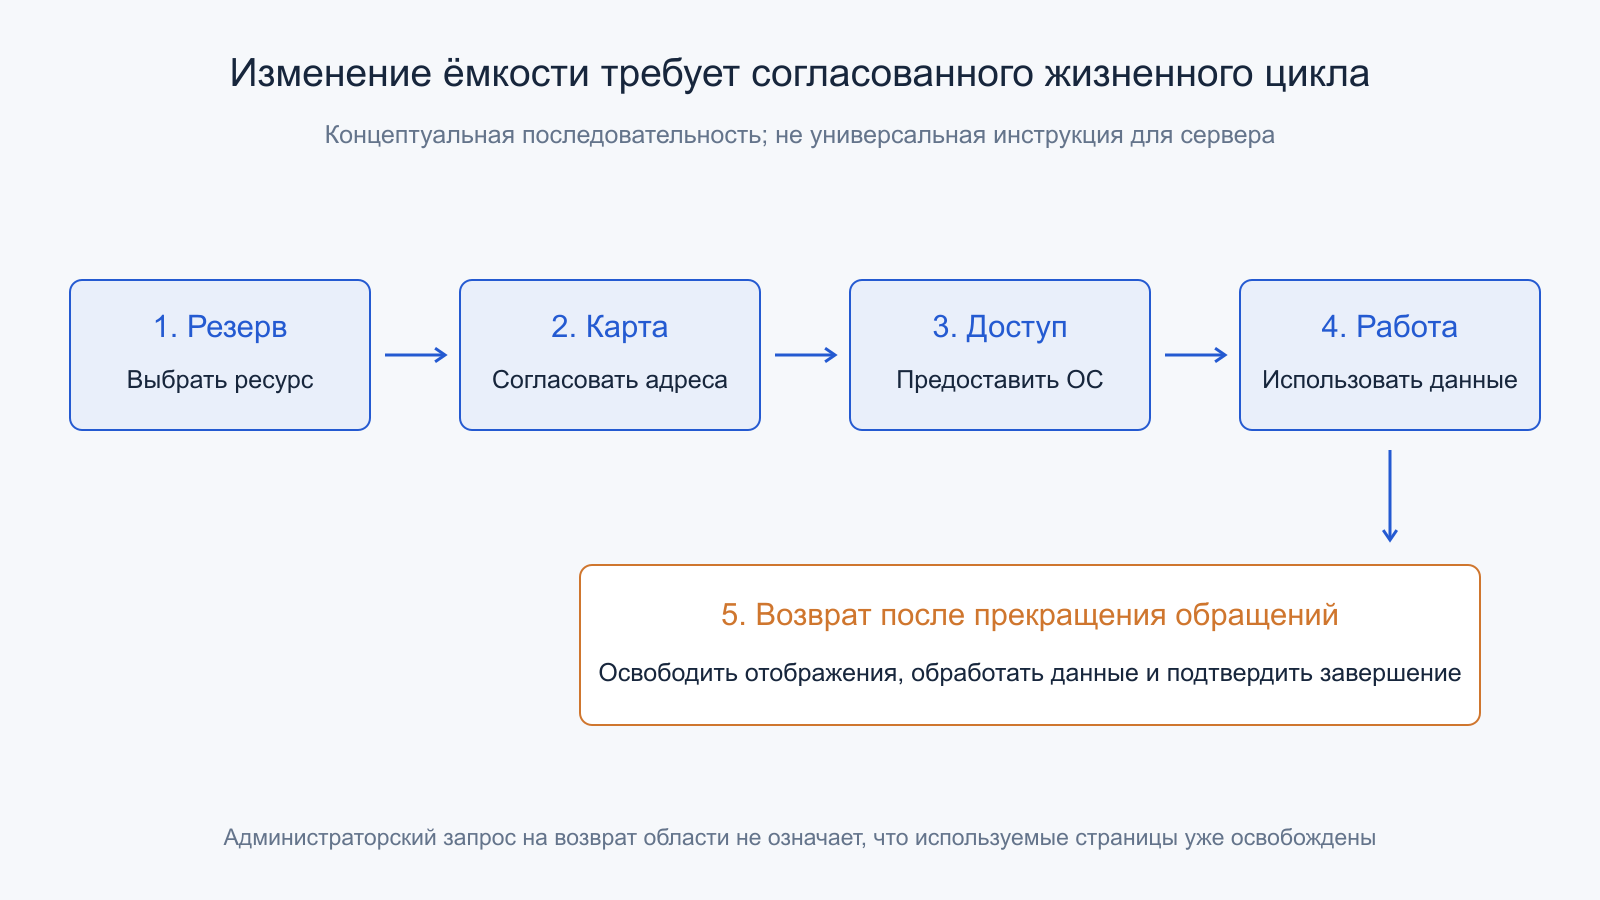
Возможность предоставить или вернуть часть ёмкости не означает разрешения отключить используемую память в произвольный момент. Перед возвратом необходимо исключить дальнейшие обращения, убрать отображения и обработать данные, которые должны сохраниться. Закреплённые страницы и внешние пользователи буферов способны мешать освобождению. Администраторский запрос и его успешное завершение являются разными событиями.
Управление фабрикой, механизм устройства и ОС совместно меняют допустимое использование области. В учебной последовательности сначала резервируется новый ресурс, затем согласуется карта, область становится доступной, используется и только после остановки новых обращений освобождается. Если один шаг не подтверждён, следующий не следует считать автоматически безопасным. Такое описание показывает необходимые отношения, не предлагая универсальную команду для действующего сервера.
Возврат ёмкости также имеет границу конфиденциальности: следующий получатель не должен получить чужие остаточные данные вопреки политике. Доступность адреса, очистка содержимого и право управлять устройством требуют отдельных механизмов. Шифрование соединения само по себе не заменяет контроль распределения, а наличие Fabric Manager не доказывает правильность политики каждого хоста. Эти условия проверяют для выбранной реализации.
RAS и безопасность сохраняют область ответственности каждого уровня
Ошибки могут возникнуть в DRAM, контроллере, соединении или конфигурации адресов. ECC определённого массива, проверка передачи и сообщение о повреждённом содержимом защищают разные границы. Нельзя объявить всю распределённую память безошибочной по наличию одного механизма коррекции. Важны обнаружение, локализация, уведомление потребителя и предусмотренная реакция, включая случаи, когда данные восстановить невозможно.
Возросшая общая ёмкость и число участников увеличивают значение наблюдаемости. Нужно знать, какой хост использовал проблемный диапазон, какие страницы затронуты и допустимо ли продолжение работы. Повтор обмена не чинит неисправную ячейку, а перезапуск не восстанавливает автоматически утраченное состояние приложения. Поэтому сценарии отказа должны входить в архитектуру сервиса до расширения пула.
Сходным образом различают защиту передаваемых данных, права на адресные диапазоны и полномочия управления фабрикой. Установленный защищённый линк не является доказательством того, что область выделена правильному арендатору. Для инженерной приёмки нужны согласованные требования и наблюдаемые проверки каждой границы. Название новой версии стандарта не заменяет такую оценку конкретного устройства и программной конфигурации.
Как отделить работающую реализацию от обещанного сценария
Каталог Microchip отдельно перечисляет поколения CXL-контроллеров, а также OMI-изделия: не каждый последовательный контроллер памяти является CXL. Сообщение Samsung от июня 2024 года описывает проверку CMM-D в определённой инфраструктуре. Это подтверждение объявленной совместимости в указанной конфигурации, а не доказательство серийной доступности CXL 4.0 с аппаратным sharing у любого заказчика.
Для собственного выбора запрашивают точные версии протокола, поддержанные режимы, процессоры, прошивки, ОС и матрицу совместимости. Стандарт, демонстрационный стенд, инженерный образец и поставляемое изделие записывают отдельно. Публичный показ передачи данных доказывает меньше, чем длительный опыт с реальной нагрузкой, конкурентным доступом и предусмотренными отказами. Заявленные производителем преимущества требуют своей области применимости.
Полезный итог оценки — не максимальное число гигабайтов, а подтверждённый сценарий: дополнительная ёмкость, управляемый пул либо корректная общая память. Для каждого фиксируют топологию, размещение данных, полезную полосу, задержки, поведение при нехватке и способ восстановления. Именно эта связка показывает, удалось ли убрать ограничение приложения и какой новый компромисс появился взамен.
Официальные первичные источники
- CXL Consortium — выпуск CXL 4.0, 18.11.2025.
- CXL Consortium — CXL 4.0 Webinar Q&A, январь 2026.
- CXL Consortium — CXL 3.0 White Paper.
- CXL Consortium — CXL 3.0 Q&A: GFAM и back-invalidate.
- Linux Kernel — Devices and Protocols.
- Linux Kernel — CXL Driver Operation.
- Linux Kernel — DAX Driver Operation.
- Linux Kernel — CXL Access Coordinates Computation.
- Microchip — Smart Memory Controllers.
- Samsung — проверка CMM-D в инфраструктуре Red Hat.
- CXL Consortium — CXL 2.0 Memory Pooling Q&A, MLD и общие ресурсы.