DPU и SmartNIC: что происходит после разгрузки сетевой карты
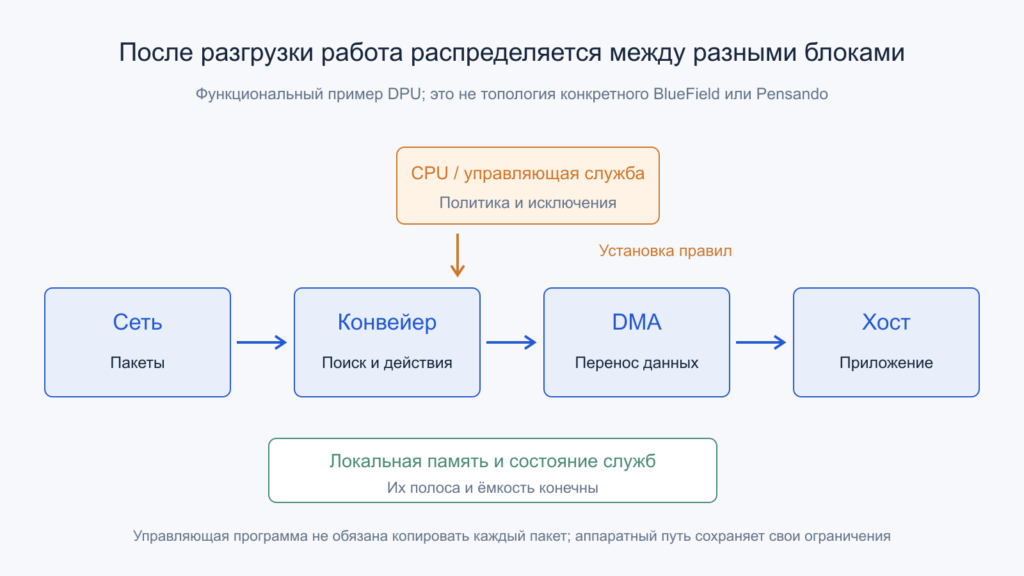
Функциональный пример. Место исполнения и поддержка функций зависят от архитектуры и конфигурации конкретного DPU. Открыть иллюстрацию в полном размере.
Когда сетевую обработку переносят с серверного процессора на DPU, работа не исчезает. Пакеты всё равно нужно разобрать, сопоставить с состоянием соединений, проверить по политике, переместить в память и передать приложению. Меняются место исполнения и распределение обязанностей: часть задач выполняет программируемый конвейер, часть — специализированные ускорители, часть — собственные процессорные ядра сетевой подсистемы.
Разберём этот путь на архитектурных примерах BlueField и AMD Pensando, включая публичные сведения о поколениях на 26 октября 2026 года. Названия продуктов не объединяются в одно вымышленное устройство. Все численные сценарии условные и не являются измерениями оборудования владельца сайта.
Содержание статьи
- DPU и SmartNIC не задают единую микроархитектуру
- Что изменилось в публичных поколениях к осени 2026 года
- Плоскость управления принимает решения, плоскость данных исполняет
- Аппаратный конвейер имеет конечные таблицы и действия
- Поток новых соединений нагружает другую часть устройства
- Почему встроенные CPU не заменяют пакетные ускорители
- Локальная память хранит не только пакеты
- DMA переносит данные без копирования инструкциями CPU
- Адрес CPU, адрес DMA и право доступа различаются
- Дополнительная промежуточная память может съесть выигрыш
- Сетевые порты и связь с хостом ограничивают разные потоки
- RDMA убирает часть обработки, сохраняя организационную работу
- Задержка пути складывается иначе, чем пиковые скорости блоков
- Независимое управление полезно только при проверенной границе доверия
- Виртуальные функции и representors не означают программный проход всех пакетов
- Шифрование и хранение делят ресурсы с сетью
- Новое хранение контекста не становится локальной HBM
- Энергетический выигрыш считают вместе с заменяемой сетевой картой
- После разгрузки появляется ещё одна управляемая система
- Официальные первичные источники
- Читайте также
DPU и SmartNIC не задают единую микроархитектуру
SmartNIC обычно называют сетевой адаптер с расширяемой обработкой, но набор возможностей под этим названием различается. Устройство может содержать программируемый пакетный конвейер, FPGA, собственные CPU, локальную память и фиксированные ускорители в разных сочетаниях. DPU подчёркивает более широкую роль процессора инфраструктуры: сеть, безопасность, хранение и управление. Универсальной таблицы обязательных блоков для каждого такого названия нет.
Поэтому сравнение начинается с пути конкретной функции. Где выполняются правила виртуальной сети? Кто устанавливает соединение? Где хранится таблица состояний? Кто обрабатывает исключение? Два изделия с одинаковой скоростью порта могут давать совершенно разную нагрузку на хост и иметь разные границы доверия. Число встроенных ядер само по себе не раскрывает этот договор.
Серверный CPU остаётся исполнителем приложения и части взаимодействия с устройством. Разгрузка может уменьшить его инфраструктурную работу, освободить ядра для полезного сервиса и отделить администрирование от арендатора. Но это результат правильно построенного программного пути, а не автоматическое следствие установки платы. Без используемой поддержки новое устройство способно работать как обычный сетевой адаптер.
Что изменилось в публичных поколениях к осени 2026 года
В материале NVIDIA от 24 августа 2026 года BlueField-4 описан через 64-ядерный Grace, LPDDR5X, интерфейс PCIe Gen6, встроенные ускорители и сеть до 800 Гбит/с. Это характеристики конкретной архитектуры, а не требования к любому DPU. Разные исполняемые службы могут использовать эти ресурсы неодинаково.
Стадия готовности тоже требует даты. Анонс октября 2025 года говорил об ожидаемой ранней доступности в 2026 году. В сообщении 16 марта 2026 года NVIDIA уже заявила полное производство семи новых чипов платформы, включая BlueField-4. Производство кристалла не является подтверждением наличия любой готовой системы у любого поставщика.
Паспорт AMD Pensando Salina показывает другой вариант: программируемые сервисы, локальная DDR5, PCIe Gen5 и конфигурации сетевых портов, включая два 400GE. Количество физических портов нельзя механически превращать в гарантированную скорость каждой комбинации сложных услуг. Для неё нужны условия конкретного конвейера и реализации.
Плоскость управления принимает решения, плоскость данных исполняет
Control plane определяет, какие сети существуют, кому разрешён доступ, куда направлять трафик и какие ресурсы выделены. Data plane применяет эти решения к проходящим пакетам. Перенос управляющей программы на встроенный CPU не требует, чтобы этот CPU последовательно обрабатывал каждый байт пользовательского потока. Это важнейшее различие внутри DPU.
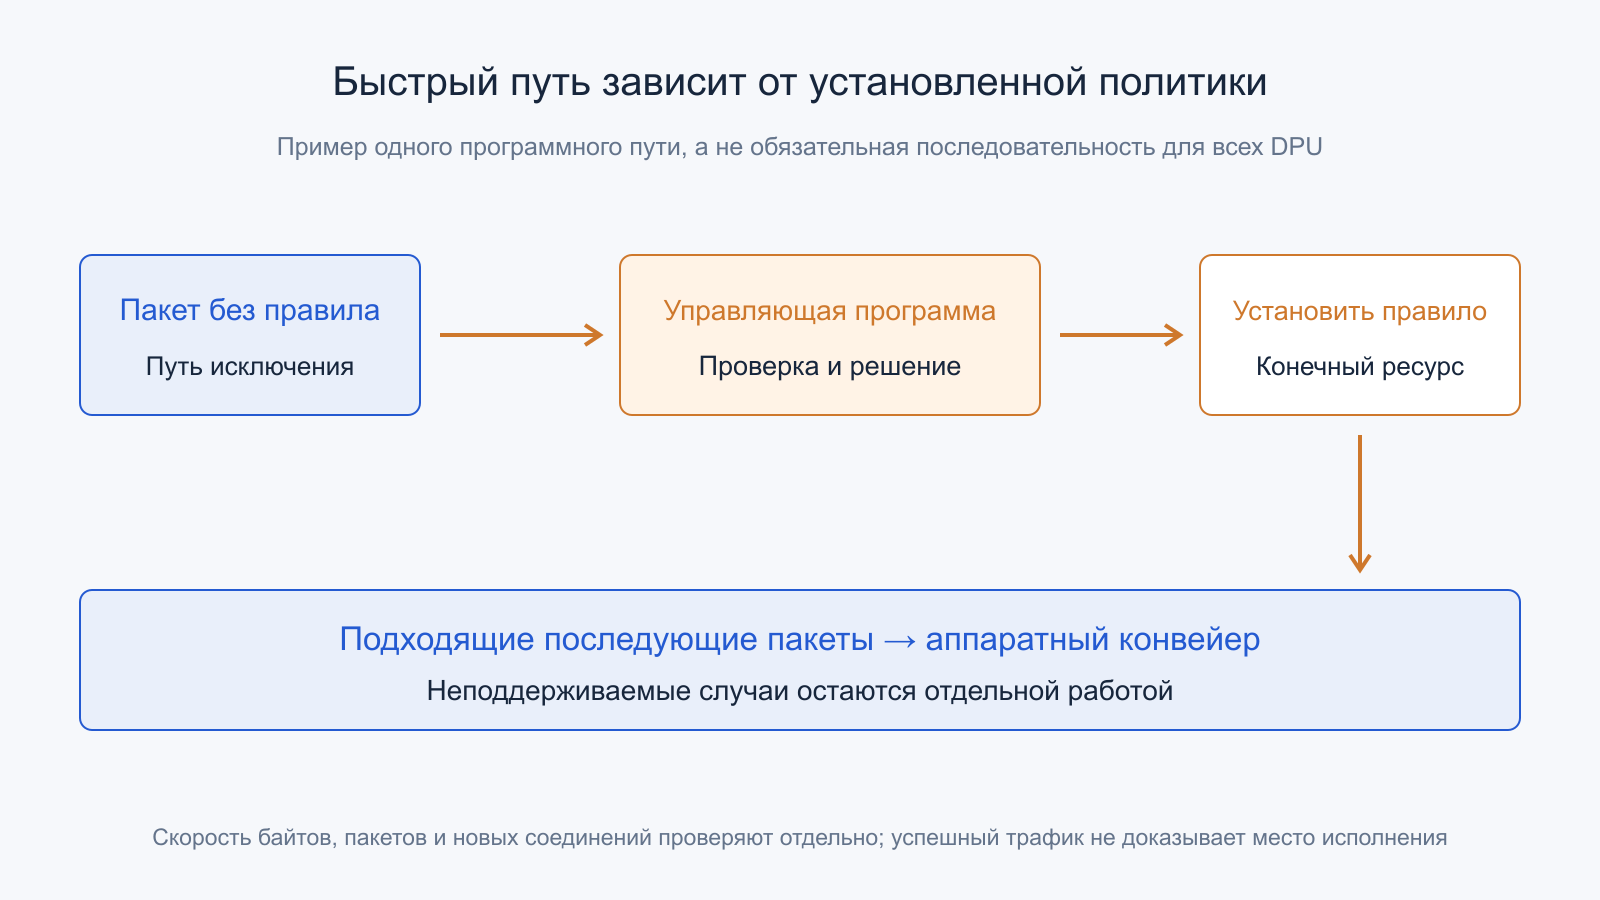
Например, программа создаёт правило для потока, а аппаратный конвейер сопоставляет последующие пакеты с установленным ключом и выполняет действие. Отдельно могут работать криптографический блок, механизм DMA и очереди передачи. Управляющий процесс наблюдает состояние, обновляет политику и разбирает случаи, которые не удалось обработать выбранным быстрым путём.
Границы конкретны. Не все протоколы и действия поддерживаются аппаратурой; не всякое состояние удобно выразить таблицей. Некоторые пакеты остаются программной работой. Поэтому содержательное описание разгрузки называет и быстрый путь, и путь исключений. Фраза «всё обрабатывает DPU» скрывает именно тот переход, который способен ограничить скорость при изменении характера трафика.
Аппаратный конвейер имеет конечные таблицы и действия
Пакет разбирается на поля, после чего поиск выбирает правило и действие: изменить заголовок, добавить или убрать туннель, назначить очередь, передать другому этапу. DOCA Flow 3.5 описывает цепочки pipes с условиями совпадения, мониторингом и действиями. Это интерфейс конкретного семейства устройств, а не универсальная программа для всех SmartNIC.
Ресурсы таблиц, ключей, счётчиков и состояний конечны. Сложное правило может потребовать больше записей или другого типа поиска, чем простое совпадение нескольких полей. Поэтому число «миллионов потоков» без формата правил и активных функций мало говорит о вместимости реальной политики. Сочетание туннелей, наблюдения и состояния способно изменить расход аппаратных ресурсов.
При нехватке места важен предусмотренный результат: отказ установки, программное обслуживание, удаление старых записей или другая документированная политика. Нельзя подразумевать, что аппаратная таблица бесконечно растёт вместе с RAM. Само попадание пакета в правильный порт также не доказывает выполнение всех задуманных действий. Нужны проверки правил и соответствующие счётчики.
Поток новых соединений нагружает другую часть устройства
Долгое соединение способно передать огромный объём через уже установленный быстрый путь. Миллионы коротких соединений требуют постоянно создавать и удалять состояние. Поэтому гигабиты в секунду, пакеты в секунду и новые соединения в секунду — разные измерения. Высокий результат первого теста не подтверждает высокий результат двух остальных.
В учебном сценарии на установку состояния требуется 20 мкс процессорного времени, а появляется 100000 новых потоков в секунду. Произведение равно двум процессорным секундам за одну секунду наблюдения. Даже без дополнительной работы это требует ресурса двух полностью занятых условных ядер. Здесь 20 мкс — именно время работы CPU, а не просто задержка асинхронного запроса к аппаратуре.
Если измеряется только интервал от запроса до готовности правила, такой пересчёт в ядра уже недопустим: часть ожидания может перекрываться. Также требуется учитывать пакеты до установки, повторные попытки и очистку состояния. Профиль новых соединений нужно сохранять рядом с объёмом полезных данных, иначе оценка control plane оказывается оторванной от реальной нагрузки.
Почему встроенные CPU не заменяют пакетные ускорители
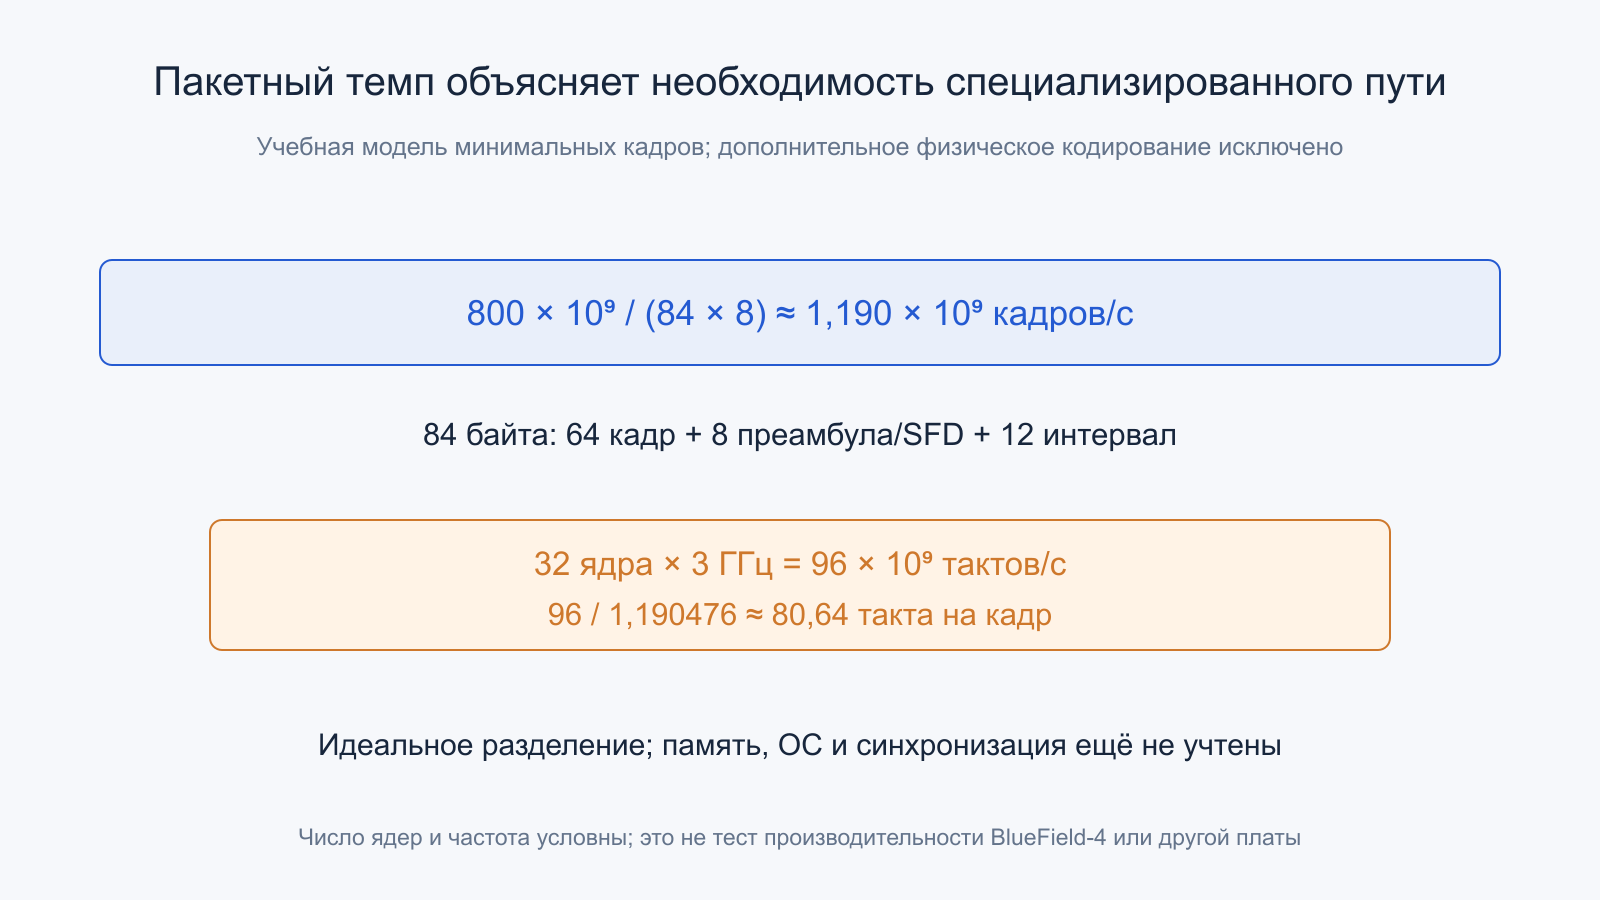
При условных 800 Гбит/с минимальный Ethernet-кадр размером 64 байта занимает на линии ещё преамбулу с начальным разделителем и межкадровый интервал. При модели 64+8+12 = 84 байта получается примерно 1,190 миллиарда кадров в секунду. Дополнительное физическое кодирование здесь исключено. Это предел выбранной модели потока, а не полезные байты приложения и не универсальный тест DPU.
Пусть задача распределена между 32 условными ядрами по 3 ГГц. Совокупные 96 миллиардов тактов в секунду при таком темпе оставляют около 80,64 такта на кадр при идеальном разделении. Из этого бюджета ещё ничего не потрачено на память, синхронизацию и управление. Поэтому произвольный сложный программный код нельзя приравнять к аппаратной обработке на скорости линии.
Крупные пакеты меняют отношение байтов к числу событий, а служебные заголовки и размер учитываемого кадра меняют расчёт. Для сравнения всегда называют границу. Одинаковая физическая полоса может соответствовать разной нагрузке поиска, очередей и счётчиков. Специализированные блоки нужны именно для регулярной работы с этим большим потоком событий.
Локальная память хранит не только пакеты
Собственная DRAM DPU обслуживает управляющие программы, таблицы потоков, очереди, буферы и состояние служб. Десять миллионов учебных записей по 128 байт требуют 1,28 десятичных ГБ ещё до индексов, выравнивания и резервирования. Наличие большого объёма памяти не означает, что вся она доступна одной таблице или что случайный поиск имеет последовательную скорость DRAM.
В модели двух чтений по 64 байта на каждый из 1,190 миллиарда пакетов получается около 152,38 ГБ/с чтения. Запись счётчиков, промахи и пакеты здесь не включены. Такой расчёт показывает возможную цену состояния, а не утверждает организацию конкретного чипа. Реальный поиск может использовать специализированную память, кэширование, иные ключи и аппаратные структуры.
Число потоков, локальность и частота обновления определяют характер доступа. Несколько длинных соединений способны хорошо использовать кэш; большой изменяющийся набор ключей — значительно хуже. Поэтому паспортная полоса локальной памяти и допустимый объём состояния описывают разные ограничения. Их нельзя заменить одной общей цифрой «DPU имеет столько-то гигабайтов RAM».
DMA переносит данные без копирования инструкциями CPU
Direct Memory Access позволяет аппаратуре читать и записывать согласованные области памяти. CPU подготавливает необходимые описания и права, после чего двигатель переноса выполняет работу. Это уменьшает необходимость копировать каждый байт обычными инструкциями, но не устраняет обмен с памятью, занятие интерфейса и расходы подготовки операции.
DOCA DMA предоставляет аппаратный перенос между поддерживаемыми буферами локальной и доступной хостовой памяти. Нужно проверить совместимые области, размеры, доступ устройства и завершение работы. Выход функции отправки асинхронной задачи не означает готовность результата. Буфер нельзя освобождать или произвольно менять, пока устройство ещё использует его.
Важна и организация небольших запросов. Одна крупная операция распределяет фиксированные затраты иначе, чем тысячи маленьких. Объединение повышает эффективность, но может добавить ожидание и сложность жизненного цикла. Поэтому ускоритель DMA сравнивают на нужных размерах и глубине работы, сохраняя одинаковую границу готовности данных для их реального потребителя.
Адрес CPU, адрес DMA и право доступа различаются
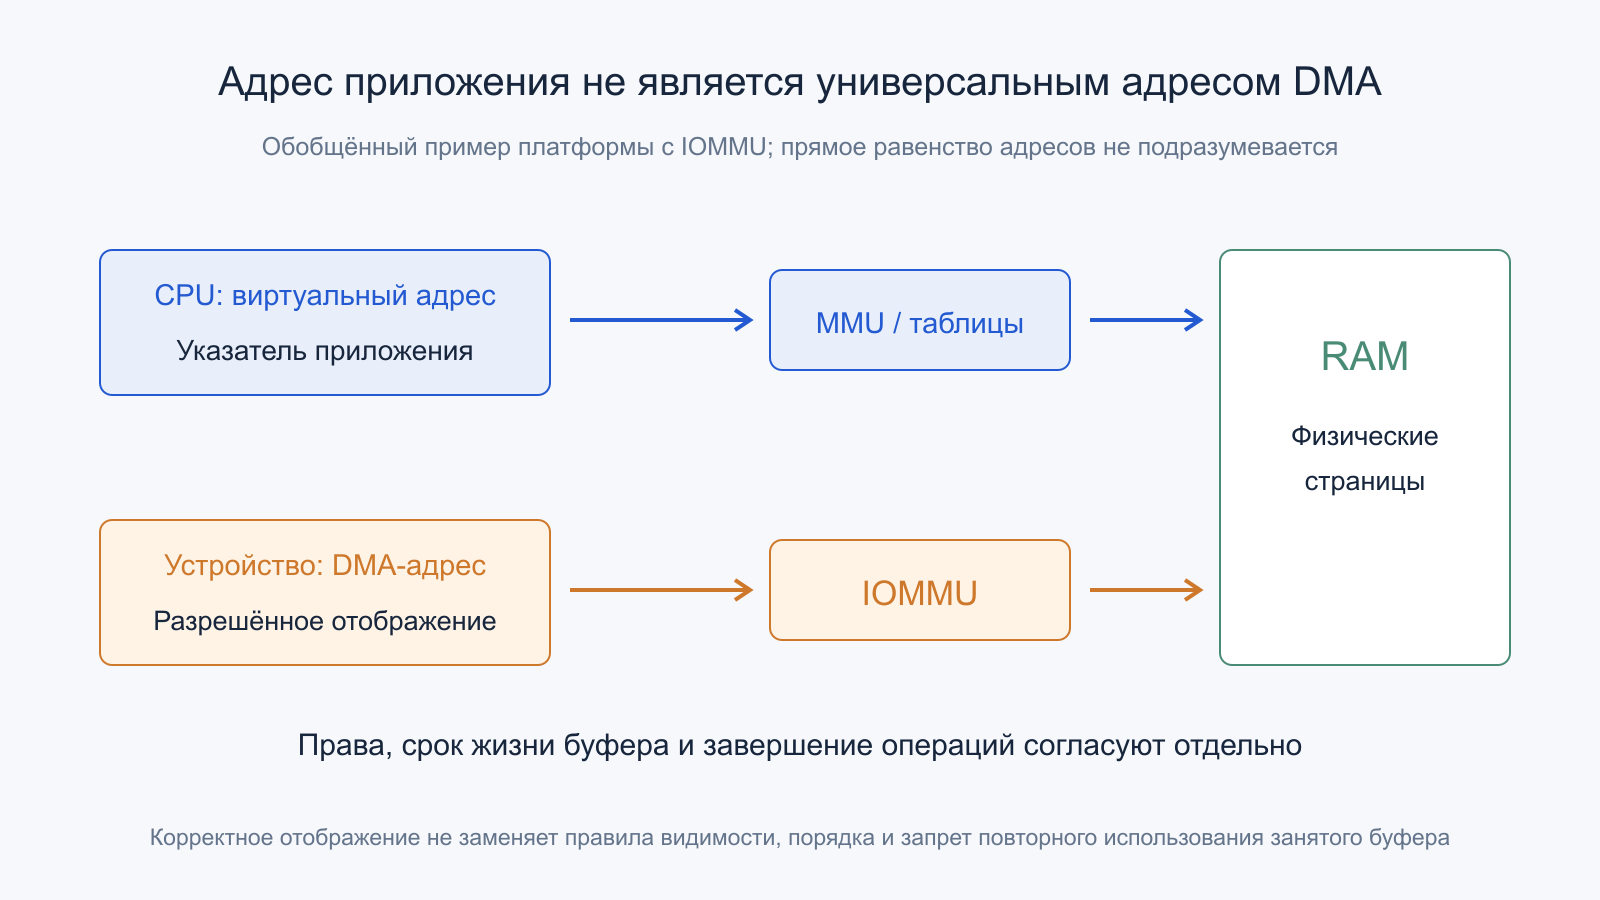
Виртуальный указатель приложения нельзя автоматически передать устройству как универсальный адрес. В руководстве Linux по DMA mapping отдельно описаны виртуальные, физические и используемые устройством адреса. IOMMU может преобразовывать адрес устройства в разрешённую область физической памяти. Конкретное отображение создаётся предусмотренным программным путём.
Для изоляции важно, какие страницы доступны конкретной функции и на какой срок. Устаревшее отображение после повторного использования памяти способно нарушить и корректность, и границу доверия. Поэтому регистрация, снятие доступа, завершение незаконченных операций и изменение владельца должны образовывать согласованный протокол. Наличие IOMMU не исправляет автоматически все ошибки управления такими ресурсами.
Когерентность и порядок также зависят от платформы и API. Нужно обеспечить видимость содержимого буфера и описателя в правильной последовательности. Отдельная область памяти DPU не становится обычным кэшем хостового CPU только потому, что обе находятся внутри сервера. При обсуждении результата называют участвующие адресные пространства и предусмотренные действия синхронизации.
Дополнительная промежуточная память может съесть выигрыш
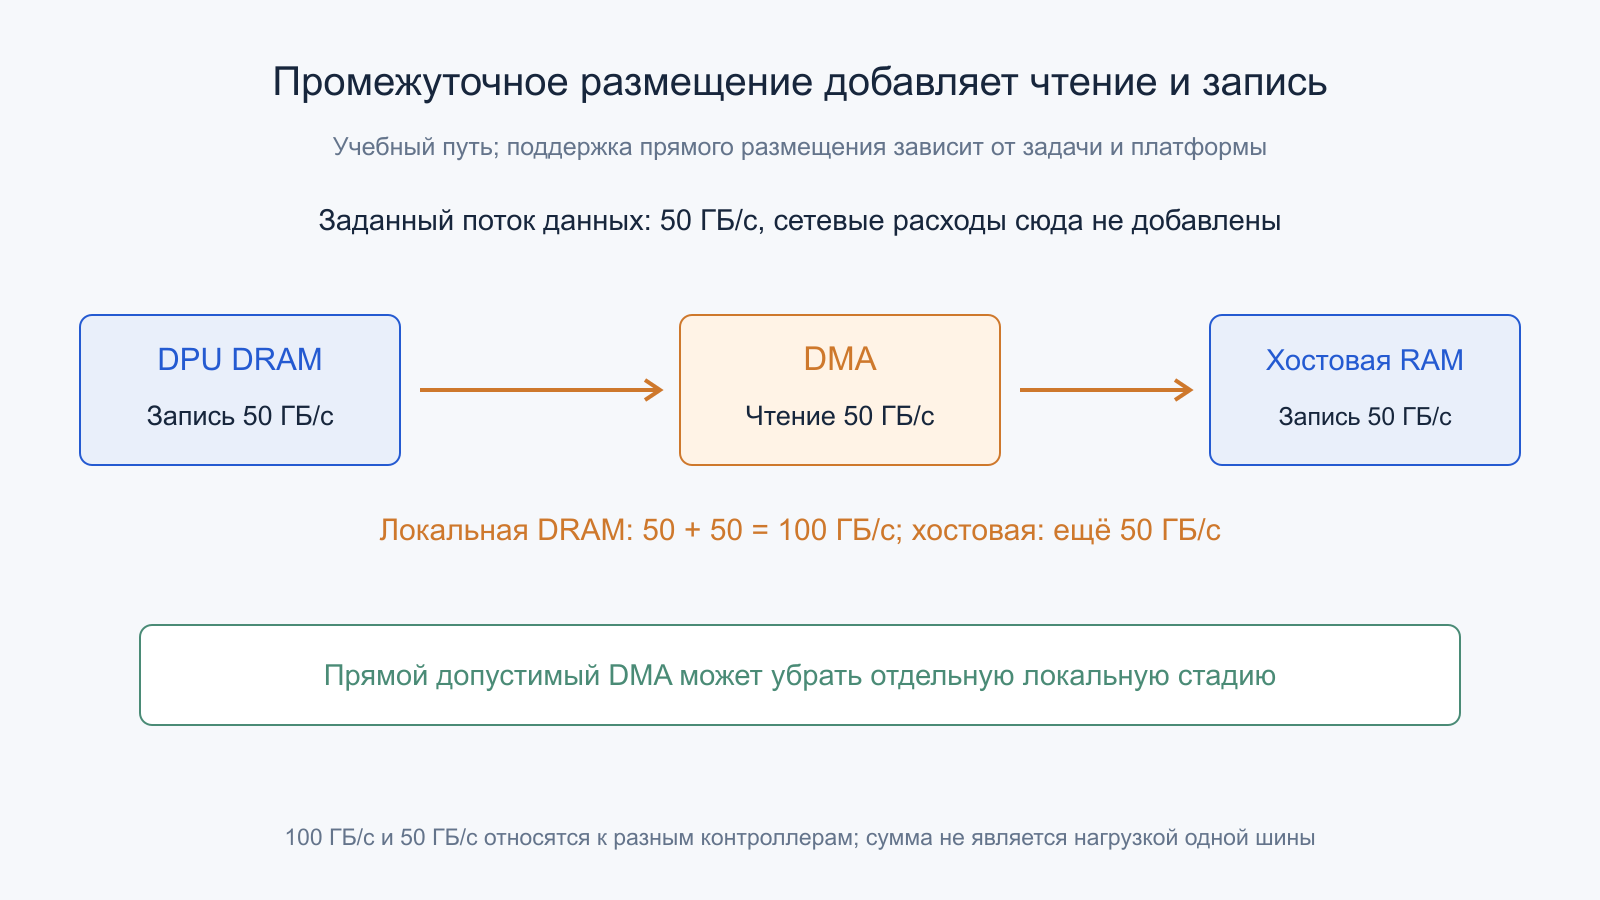
Зададим учебный поток данных 50 ГБ/с через рассматриваемый участок памяти; это эквивалент 400 Гбит/с самих данных без добавления сетевых расходов. Если байты сначала записываются в локальную DRAM DPU, а затем полностью считываются для DMA в хост, локальный контроллер обслуживает около 100 ГБ/с этих двух действий. Хостовая память дополнительно принимает 50 ГБ/с записи.
Эти величины относятся к разным контроллерам, поэтому их нельзя выдавать за 150 ГБ/с на одной шине. Прямое размещение в разрешённый хостовый буфер способно убрать отдельную локальную стадию, если такой путь поддерживается задачей. Но запись данных в конечную память и перенос по физическому интерфейсу всё равно остаются. Удаление копии не означает отсутствия движения данных.
Некоторым службам промежуточный буфер нужен для преобразования, проверки или изменения порядка. Тогда его стоимость может быть оправданна. Задача проектирования — понять фактическую последовательность, а не требовать абстрактного zero-copy любой ценой. В отчёте полезно нарисовать каждое чтение и запись: такая схема часто объясняет предел быстрее, чем общий процент загрузки процессора.
Сетевые порты и связь с хостом ограничивают разные потоки
Сетевые 800 Гбит/с дают 100 ГБ/с физического темпа в выбранном направлении до расходов протокола. Для учебной связи PCIe Gen5 x16 после одного кодирования 128b/130b получается примерно 63,02 ГБ/с в одном направлении, ещё до пакетов и прочих расходов. Такой путь не перенесёт весь односторонний входной сетевой поток в хост без дополнительных условий.
Из этого не следует бесполезность двух быстрых портов. Часть данных может направляться между сетевыми портами, обрабатываться локально или использовать другие поддерживаемые связи. Разные поколения DPU предлагают разные конфигурации, включая более новый хостовый интерфейс. Нужно сопоставлять топологию конкретной платы с тем, куда действительно идут байты.
Полный дуплекс также требует аккуратного счёта. Два направления PCIe не образуют удвоенную одностороннюю полосу, а сумма максимальных скоростей портов не становится скоростью одного приложения. Сетевой транспорт, DMA, память и обработка образуют несколько границ. На каждой считают собственный поток и только затем ищут участок, который ограничивает весь сценарий.
RDMA убирает часть обработки, сохраняя организационную работу
Remote Direct Memory Access позволяет выполнять поддерживаемые операции с заранее подготовленной памятью удалённого участника без обычного программного копирования каждого блока на принимающем CPU. Но до передачи нужно создать соединения и очереди, предоставить права, зарегистрировать области и согласовать формат данных. После неё приложению всё равно требуется использовать результат и обрабатывать ошибки.
DOCA RDMA описывает соответствующий API и поддерживаемые операции. Односторонняя запись и обмен сообщениями имеют разную семантику уведомления. Завершение одной операции нельзя произвольно трактовать как подтверждение обработки удалённым приложением. Для законченного сервиса нужен собственный протокол владения и согласованности поверх выбранных гарантий транспорта.
RoCE использует Ethernet-сеть со своими очередями и управлением перегрузкой. Возможность RDMA не означает, что конкуренция за порты, повторные передачи или память исчезли. Аналогично доступ к GPU-памяти требует поддержки всего пути. Рекламное «CPU bypass» относится к определённой стадии данных, а не к отсутствию CPU в настройке, управлении, восстановлении и работе приложения.
Задержка пути складывается иначе, чем пиковые скорости блоков
Максимальные скорости отдельных ускорителей описывают установившийся поток, но конкретный запрос должен пройти зависимые стадии. В учебном последовательном пути подготовка занимает 5 мкс, транспорт —2 мкс, обработка —3 мкс, а получение результата —4 мкс. Сумма составляет 14 мкс без очереди. Наличие блока с временем работы 3 мкс не превращает весь сервис в трёхмикросекундный.
При непрерывном потоке стадии могут перекрываться для разных запросов. Тогда пропускную способность определяет наиболее ограниченный ресурс, а задержку отдельного запроса —его собственный путь вместе с ожиданием. Складывать процентили отдельных стадий как гарантированный процентиль всей системы нельзя: их распределения и зависимость существенны. Для полного времени нужны наблюдения на соответствующих начальной и конечной границах.
Пакетная отправка команд уменьшает фиксированную работу на один запрос, но требует накопить пакет или дождаться таймера. Такая политика способна повысить поток и одновременно ухудшить время ответа редкого запроса. Поэтому выбор глубины очереди и размера пакета связан с требованиями приложения. Универсальное значение, оптимальное для любого DPU и любой смеси служб, из архитектурной схемы не выводится.
Независимое управление полезно только при проверенной границе доверия
Собственный CPU и операционная система позволяют управлять инфраструктурой отдельно от пользовательского хоста. Но DPU может быть настроен в разных режимах. Документация BlueField 3.5 различает NIC mode, DPU mode и ограниченный Zero Trust mode. Название DPU mode само по себе не означает запрета всех действий внешнего администратора.
Для изоляции нужно определить владельца портов и правил, права изменения прошивки, доступ к управляющим интерфейсам и восстановлению. Политика должна сохраняться при перезагрузке хоста и корректно применяться при смене арендатора. Ошибка управления способна открыть путь, который аппаратный конвейер затем очень быстро обслужит. Скорость не заменяет правильность авторизации.
Отдельного внимания требует выдача удалённых ключей доступа к памяти. Они разрешают определённую операцию над определённой областью, но не являются полноценным описанием прав приложения на объект. При смене владельца буфера нужно завершить или отменить старую работу и отозвать доступ в предусмотренном порядке. Сетевая политика, права памяти и логика сервиса должны согласовываться; правильность только одного уровня не доказывает правильности всей цепочки.
В описании BlueField Astra 2026 года управление ConnectX-9 отделено от пользовательского хоста через специальные связи с BlueField-4. Это системная архитектура конкретной платформы. Её нельзя автоматически приписать любой комбинации DPU и SuperNIC, соединённых обычным PCIe-разъёмом.
Виртуальные функции и representors не означают программный проход всех пакетов
SR-IOV позволяет предоставлять виртуализированные функции устройства разным потребителям. Виртуальный коммутатор управляет связями между ними и внешними портами. Представляющие интерфейсы, representors, дают программному слою точки управления и наблюдения. Однако наличие такого интерфейса не доказывает, что каждый байт постоянно копируется через стек ОС управляющего CPU.
При поддерживаемой разгрузке правило устанавливается в аппаратный коммутатор, и соответствующий поток идёт быстрым путём. Пакет без нужного правила или с неподдерживаемым действием может потребовать другого обслуживания. Конкретная начальная обработка и переход к разгрузке зависят от программного стека. Нельзя объявлять обязательную одинаковую последовательность для всех виртуальных коммутаторов.
Для проверки сопоставляют конфигурацию с фактическими счётчиками аппаратного и программного путей. Работающее соединение подтверждает доступность, но не место исполнения. Полезны изменения CPU-нагрузки, число исключений и применённые правила при одинаковом трафике. Один сетевой тест без такой привязки может измерить совсем другой путь, чем тот, ради которого приобретали DPU.
Шифрование и хранение делят ресурсы с сетью
Фиксированный криптографический блок способен выполнять нужный алгоритм эффективнее общего CPU. Но к нему ещё нужно доставить данные, предоставить ключи и обработать состояние соединений. Паспортная скорость одной функции не гарантирует такую же скорость любой их цепочки. Маленькие сообщения, частая смена ключей и дополнительные проверки создают другой профиль нагрузки.
Паспорт Salina, например, перечисляет сетевые, защитные и NVMe-oF-функции. Этот список описывает возможности платформы; он не является таблицей одновременного максимума всех действий. Для конкретного проекта требуется проверить состав конвейера, форматы, размеры объектов и поддерживаемый режим. Сжатие также не гарантирует уменьшения любого потока: результат зависит от данных.
Путь к SSD добавляет очереди хранения, метаданные и требования к фиксации. Ускорение передачи NVMe-oF не превращает завершение сети в подтверждение долговечности данных на NAND. Поэтому разгрузку хранения оценивают на уровне законченной операции с нужными гарантиями, сохраняя границы транспорта, контроллера и самого приложения.
Новое хранение контекста не становится локальной HBM
Развитие DPU связано и с разделением памяти и хранения между узлами AI-системы. В платформенных сообщениях 2026 года BlueField-4 используется для обслуживания контекста и ускоренного доступа к данным. Цель — доставлять нужное состояние вычислителю эффективнее, согласовав сеть, хранение и инфраструктурную обработку. Это более широкий сценарий, чем разгрузка обычного сетевого стека сервера.
Но удалённый контекст на SSD не приобретает задержку и полосу локальной HBM по одному названию «расширение памяти». Между ними остаются индексы, очереди, сетевой транспорт и физическое чтение. Повторное использование часто нужных данных может помочь системе, однако полезность определяется долей попаданий, размером объектов, конкурентной нагрузкой и последовательностью зависимостей.
Нужно различать произведённый чип, опубликованную эталонную архитектуру, демонстрацию и поставляемую партнёром систему. Даже реальная поставка одной конфигурации не подтверждает её результат для другой модели и длины контекста. При оценке сохраняют конкретный программный путь и качество результата, а не переносят коэффициент из презентации на любой AI-сервис.
Энергетический выигрыш считают вместе с заменяемой сетевой картой
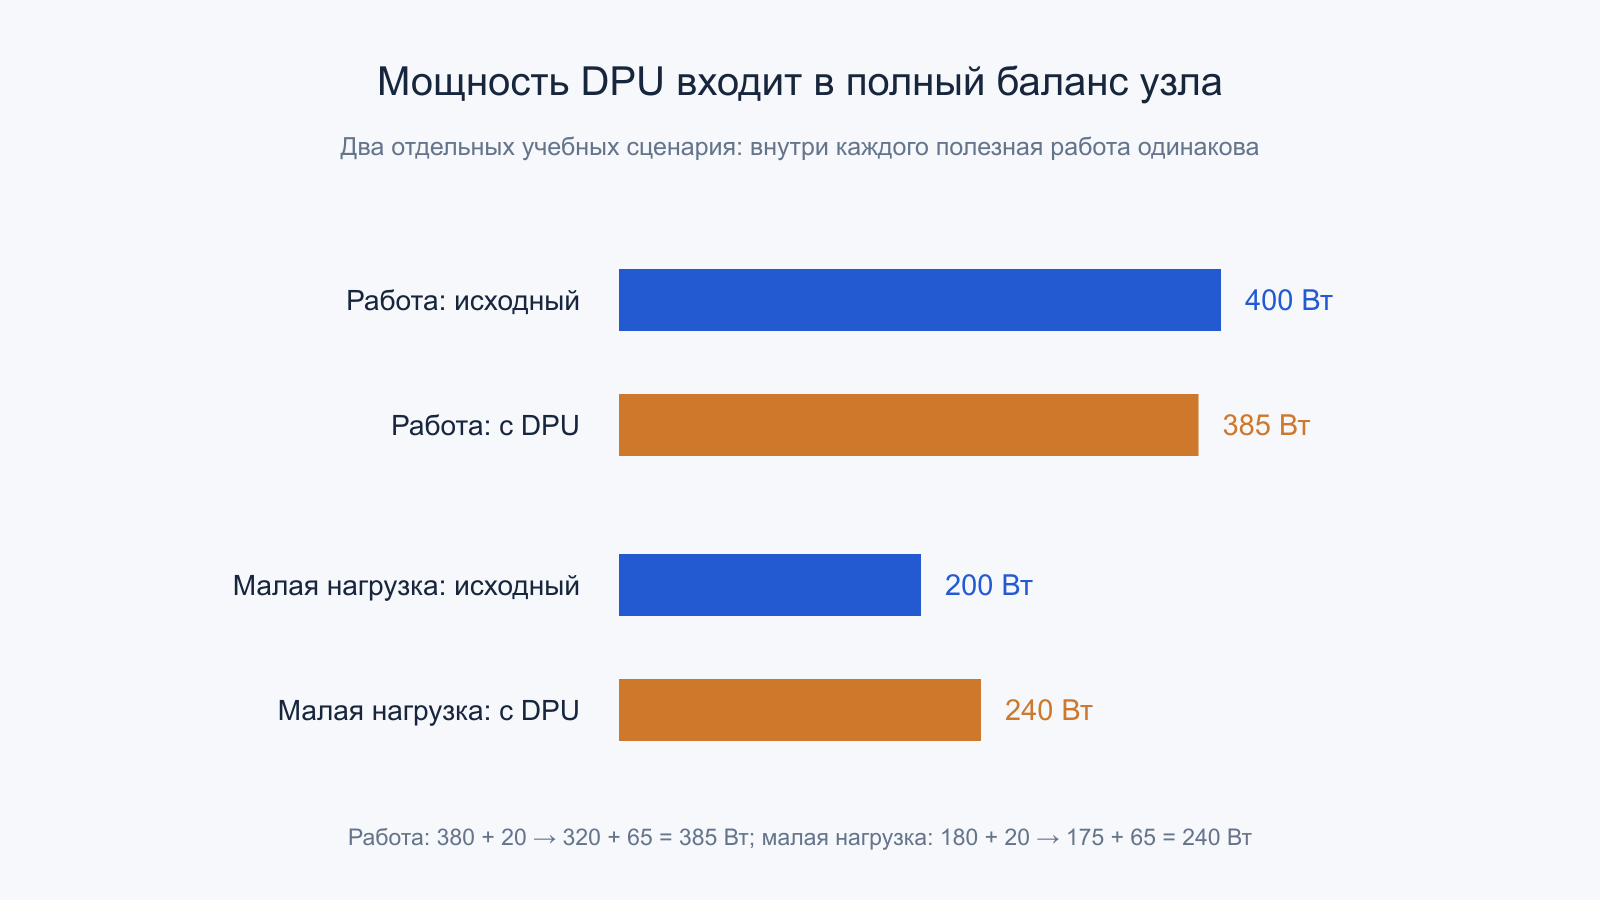
В учебном исходном сервере хост потребляет 380 Вт, обычный NIC —20 Вт, вместе 400 Вт. После переноса той же работы хост требует 320 Вт, а DPU —65 Вт: всего 385 Вт. Экономия составляет 15 Вт, или 3,75%. Сравнение только уменьшения мощности CPU на 60 Вт завысило бы полезный эффект.
При миллионе одинаковых завершённых запросов в секунду это 0,4 мДж против 0,385 мДж на запрос в выбранной границе. При малой нагрузке картина может измениться. Если исходный хост требует 180 Вт плюс прежние 20 Вт NIC, а новый —175 Вт плюс 65 Вт DPU, получается 200 против 240 Вт. Эти числа условны и не характеризуют реальные платы.
Охлаждение и питание за пределами измеряемого узла здесь не включены. Корректное сравнение требует одинаковой полезной работы, задержки и качества сервиса. Освобождённые CPU-ядра имеют экономический смысл, но не всегда выражаются немедленным снижением ваттов. Иногда выигрыш состоит в большей работе на том же сервере; это следует измерять отдельным сценарием.
После разгрузки появляется ещё одна управляемая система
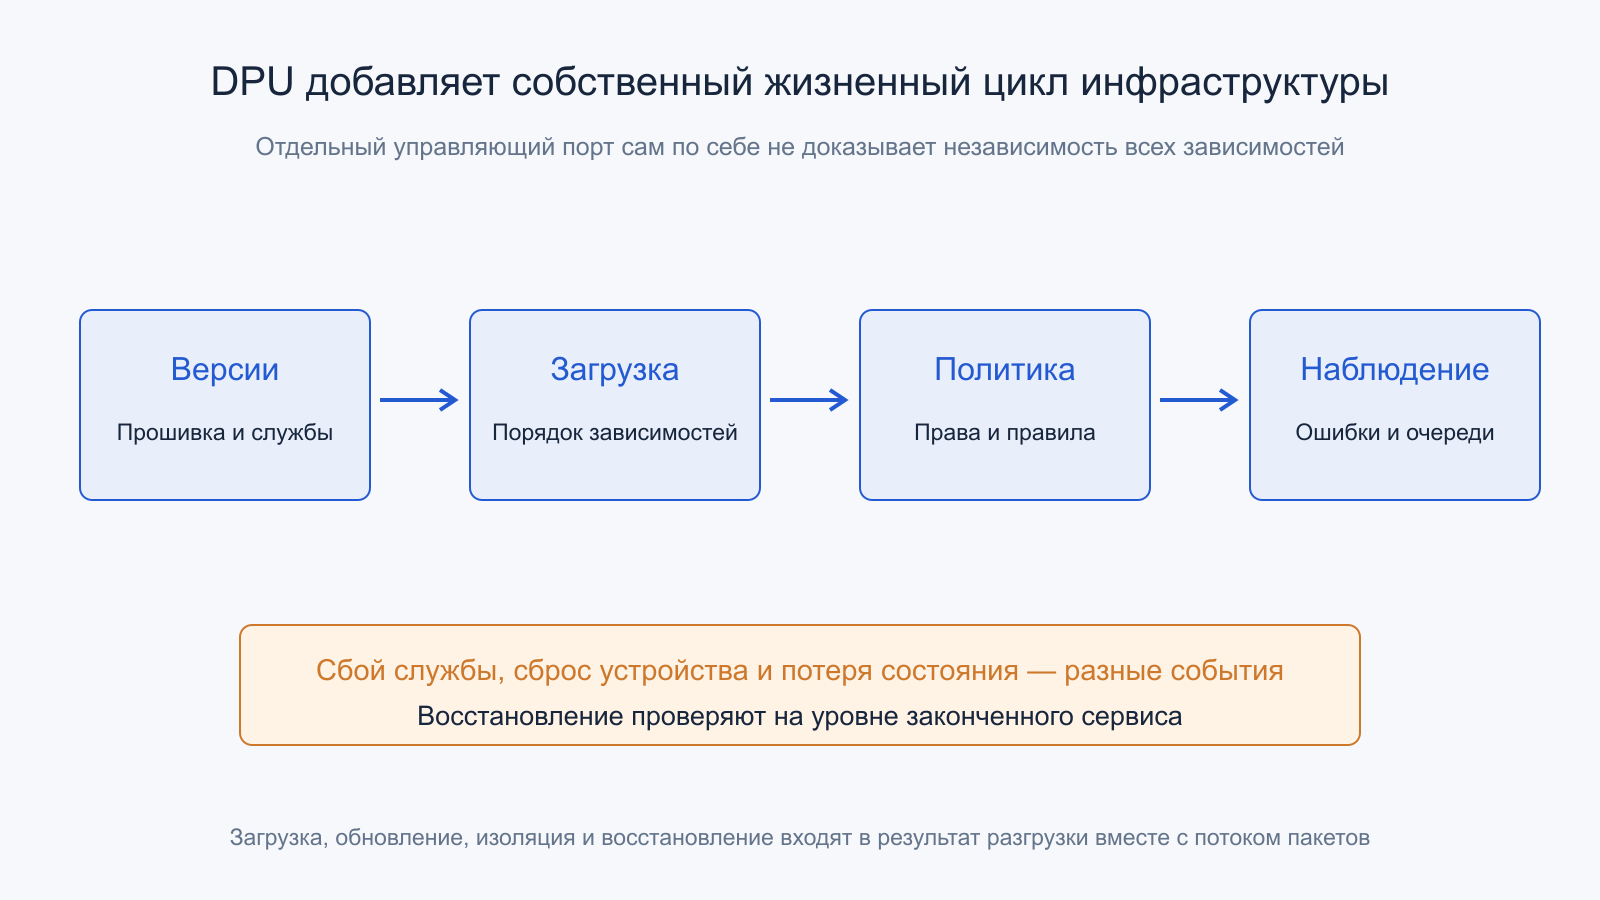
DPU имеет прошивку, программный стек, память, службы и собственный жизненный цикл. Обновление, наблюдение и восстановление становятся частью эксплуатации сервера. Если важная функция перенесена на DPU, её отказ может повлиять на доступность сети или хранения даже при исправном основном CPU. Поэтому нужен определённый порядок загрузки и понятная реакция на недоступность управляющей службы.
Нужно также проверить совместимость версий и способность сохранить либо восстановить состояние. Перезапуск правила, потеря таблицы соединений и полный сброс платы имеют разные последствия для активного трафика. Наличие резервного пути не означает автоматической бесшовности. Поведение определяется конкретной архитектурой и должно подтверждаться испытаниями завершённого сервиса.
Управляющая связь должна оставаться доступной и при проблеме пользовательского пути, когда это предусмотрено проектом. Иначе ошибка конфигурации может одновременно нарушить сервис и лишить администратора способа его восстановить. Но отдельный порт сам по себе ещё не гарантирует независимость: важны питание, владельцы, программные службы и зависимости загрузки. Документированный план восстановления относится к законченной платформе, а не только к сетевому чипу.
Содержательный результат разгрузки включает место исполнения каждой стадии, объём переносов, ресурсы памяти, новые соединения, распределение задержек, изоляцию и мощность. Тогда DPU оценивается как самостоятельный инфраструктурный процессор с реальными пределами. Он способен убрать значительную работу с хоста, но сохраняет необходимость доставлять данные, управлять состоянием и поддерживать весь путь исправным.
Официальные первичные источники
- NVIDIA — BlueField-4 и Scale-In, август 2026.
- NVIDIA — анонс BlueField-4, октябрь 2025.
- NVIDIA — производство чипов платформы Vera Rubin, март 2026.
- AMD — Pensando Salina Product Brief.
- NVIDIA DOCA 3.5 — Flow.
- NVIDIA DOCA 3.5 — DMA.
- NVIDIA DOCA 3.5 — RDMA.
- NVIDIA DOCA 3.5 — режимы BlueField.
- Linux — Dynamic DMA Mapping Guide.
- NVIDIA — BlueField Astra, январь 2026.
Комментарии