Нейронные ускорители в ПК: NPU, матричные блоки, TOPS и память
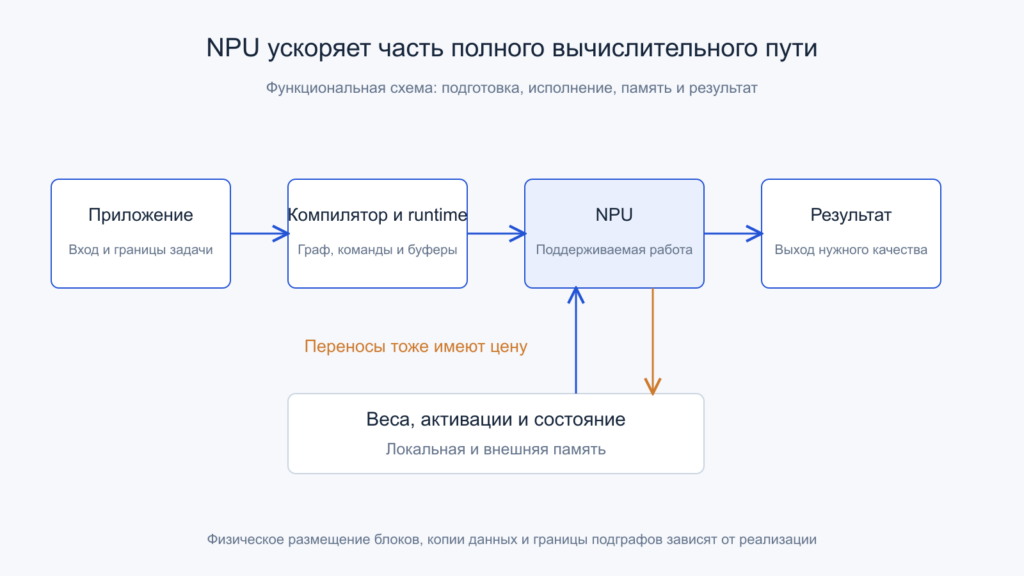
Вычислительный блок обслуживает поддерживаемую часть графа; подготовка, переносы и получение результата входят в полный путь. Открыть иллюстрацию в полном размере.
В характеристиках компьютера появилась ещё одна большая цифра — производительность нейронного ускорителя в TOPS. При этом одна модель быстро обрабатывает изображение, другая не запускается на NPU, а третья использует его лишь частично. Чтобы разобраться в таких различиях, нужно проследить не название блока, а путь вычислительного графа: какие операции выполняются, где лежат данные, с какой точностью идёт расчёт и что входит в измеренное время.
Ниже рассматриваются принципы специализированных ускорителей вывода нейросетей. Архитектурные примеры привязаны к конкретным документам; GPU, встроенный NPU и серверный TPU не объявляются одинаковыми устройствами. Все численные сценарии статьи заданы для обучения и не являются результатами испытаний оборудования владельца сайта.
Содержание статьи
- Что именно ускоряет NPU
- Между файлом модели и аппаратурой находится компилятор
- Откуда берутся операции в матричном произведении
- Матричный блок полезен благодаря повторному использованию данных
- Локальная память не отменяет внешнюю
- Учебная граница: вычисления или перенос
- Размер пакета меняет цену одних и тех же весов
- Точность входа, вычисления и результата — разные характеристики
- Квантование меняет численную задачу
- Накопитель и выходная обработка тоже занимают аппаратные ресурсы
- Разреженность имеет структуру и цену
- Один неподдерживаемый участок способен изменить итог
- Пропускная способность и ожидание пользователя растут по-разному
- Несколько очередей не создают бесконечную параллельность
- Почему генерация текста не сводится к одной цифре TOPS
- Энергию нужно измерять на выбранной границе
- Как провести содержательное измерение
- Какие вопросы задавать вместо сравнения одних TOPS
- Первичные источники и границы примеров
- Читайте также
Что именно ускоряет NPU
Нейросеть при исполнении представляет собой последовательность преобразований чисел. Среди них встречаются матричные произведения, свёртки, нормализация, нелинейные функции, перестановки, выбор элементов и работа с состоянием. Часть операций хорошо подходит для регулярной параллельной обработки. Для неё выгодно выделить специализированные вычислительные блоки, поддерживаемые управлением и системой памяти.
Название NPU не задаёт единую обязательную микроархитектуру. У разных проектов различаются поддерживаемые операции, размеры локальных буферов, типы данных, способы управления и связь с системой. Ускоритель может быть частью процессорного корпуса, отдельным компонентом либо IP-блоком внутри SoC. Поэтому одинаковая аббревиатура не доказывает взаимозаменяемость моделей и программ.
Специализация позволяет тратить меньше аппаратных ресурсов на универсальное управление, но взамен ограничивает допустимую работу. CPU сохраняет гибкость для разветвлённого кода и обслуживания системы. GPU объединяет широкую программируемость с массовым параллелизмом. NPU выбирает собственный компромисс. Полезный вопрос — какая часть конкретной задачи действительно попадает на этот путь.
Между файлом модели и аппаратурой находится компилятор
Файл модели хранит описание вычислений и параметры, а не готовую последовательность импульсов для матричного блока. Программный стек анализирует граф, проверяет типы и размеры, выбирает допустимые реализации и размещение промежуточных данных. Он может объединять соседние операции, менять внутренний формат и заранее готовить команды для устройства.
Поддержка названия операции ещё не означает поддержку любой её формы. Значение имеют размерности, порядок осей, типы данных и ограничения выбранной версии драйвера или компилятора. В документации NPU-плагина OpenVINO 2025, например, отдельно описаны поддерживаемые режимы и ограничения форм; эти сведения относятся именно к указанному программному стеку.
Время первой подготовки и время повторного исполнения также различаются. Компиляция способна занять заметно больше одного вывода, а кэширование уменьшает повторные расходы при совместимых условиях. Сравнивать холодный старт одной системы с прогретым исполнением другой некорректно. При измерении нужно заранее определить, интересует запуск приложения или установившаяся обработка потока.
Откуда берутся операции в матричном произведении
Для произведения A размером M×K и B размером K×N каждый элемент результата получается накоплением K произведений. В принятом здесь соглашении одно умножение с накоплением, MAC, считается двумя арифметическими операциями. Тогда объём основной работы равен приблизительно 2MNK. Не учитываются смещения, преобразования и остальные операции графа.
В руководстве NVIDIA по матричному умножению используется такая же система счёта для соответствующей задачи. Но TOPS сам по себе не сообщает размер операндов, точность накопления и способ учёта разреженности. Сначала следует прочитать определение показателя, а затем сравнивать числа с одинаковым смыслом.
Учебное произведение двух матриц 1024×1024 содержит 1 073 741 824 MAC, или 2 147 483 648 операций по выбранному соглашению. Это количество работы, а не скорость. Деление на секунды даёт операции в секунду; смешение этих величин создаёт бессмысленное сравнение. Число команд программы тоже не обязано совпадать с количеством учитываемых арифметических действий.
Матричный блок полезен благодаря повторному использованию данных
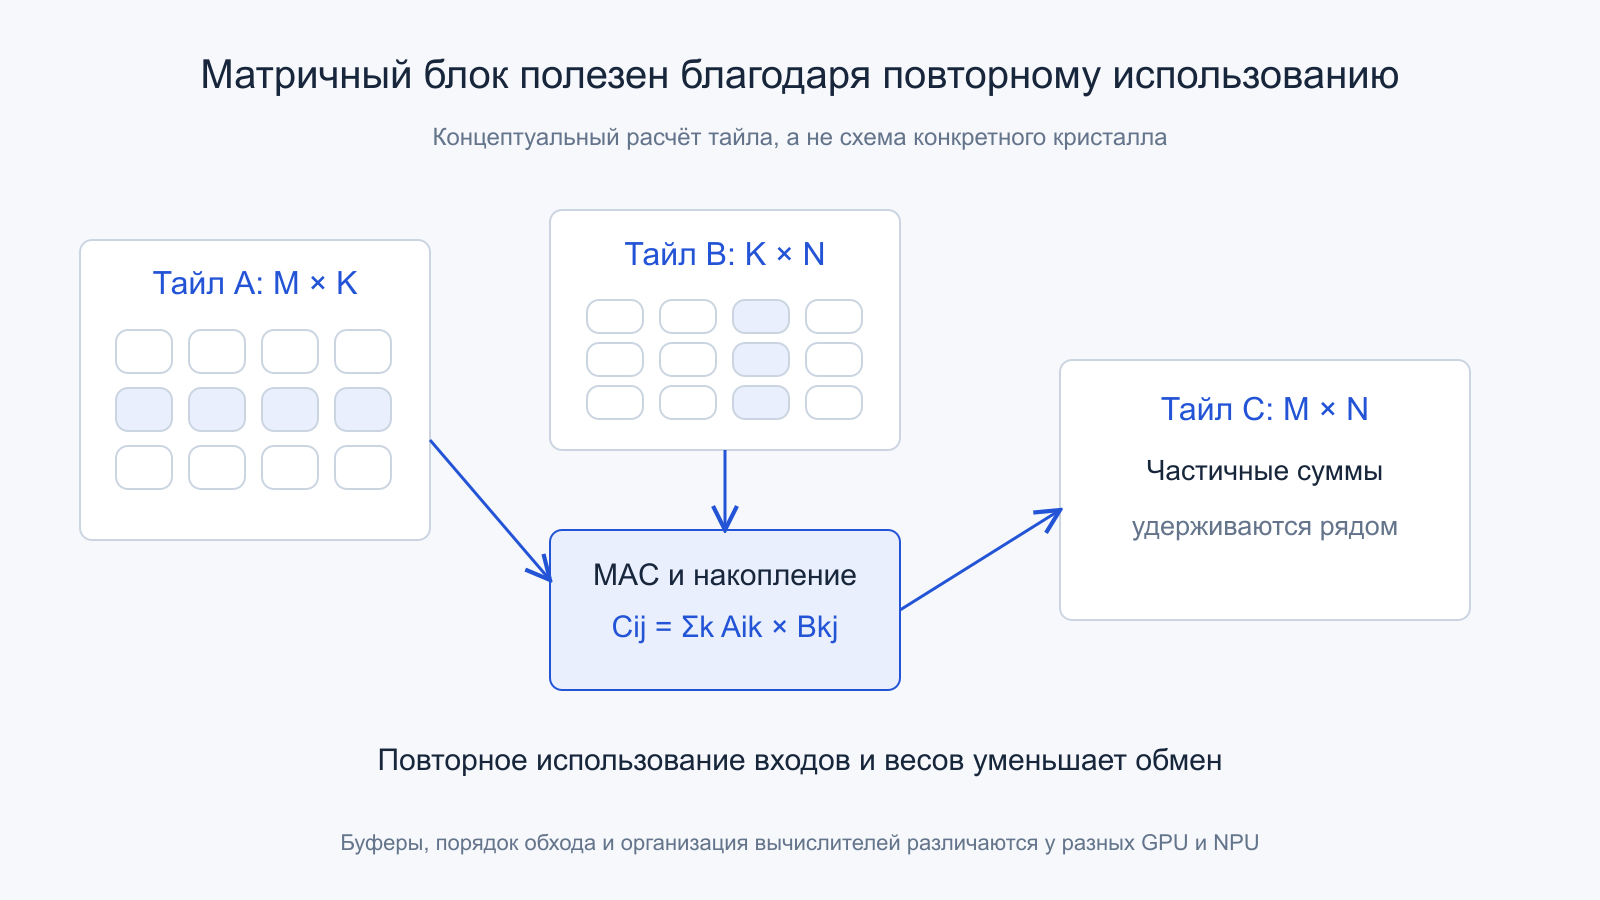
Если для каждого умножения заново переносить оба операнда из внешней памяти, вычислительные элементы будут простаивать в ожидании данных. Поэтому расчёт разбивают на участки, тайлы. Загруженный фрагмент входа или весов используют для нескольких результатов, а частичные суммы некоторое время удерживают рядом с вычислениями. Выигрыш связан не только с числом умножителей.
Конкретный пример дан в Arm Ethos-U85 Technical Overview, Issue 03: документ различает управление, DMA, MAC, декодирование весов и выходную обработку. Это полезная иллюстрация распределения функций внутри NPU, но её конфигурацию нельзя автоматически переносить на любой ускоритель ноутбука или видеокарты.
Массив вычислителей может использовать разные схемы движения данных. Систолическая организация — один известный вариант, а не определение любого NPU. Работа о первом серверном TPU, опубликованная в 2017 году, показывает исторический пример специализации. Из него следует изучать принцип организации, сохраняя различие поколений и классов устройств.
Локальная память не отменяет внешнюю
Регистры, буферы накопления, локальная SRAM, системная DRAM и память отдельного устройства имеют разные ёмкость и стоимость доступа. В небольшом локальном пространстве удобно удерживать текущие тайлы, но вся модель или длинное состояние могут туда не помещаться. Тогда часть данных приходится постоянно приносить с более далёкого уровня. Объём локального хранения влияет на частоту таких перемещений.
Следует различать хранение весов, текущих активаций, промежуточных результатов и состояния между запросами. Небольшой файл весов не гарантирует небольшой рабочий набор. При другой форме входа или глубине очереди одновременно живыми оказываются дополнительные тензоры. Реальный пик памяти определяется графиком их существования, выбранными форматами и повторным использованием областей.
DMA уменьшает необходимость программно копировать каждое число силами CPU, но перенос сохраняет свою полосу, задержку и энергозатраты. Общая системная память также не обещает бесплатного обмена. Устройства конкурируют за контроллер и каналы, а доступность одного физического буфера не устраняет требования к согласованности и моменту его использования.
У короткого формата есть и дополнительные данные. В учебной матрице из 1 048 576 однобайтных весов хранятся ещё 1024 четырёхбайтных масштаба и столько же четырёхбайтных смещений. Вместе они добавляют 8192 байта, около 0,78% к 1 МиБ весов. Но это оценка только заданных массивов: команды, выравнивание, распаковка и промежуточные области здесь не посчитаны. Нельзя определять полный расход памяти по одному числу бит на вес.
Учебная граница: вычисления или перенос
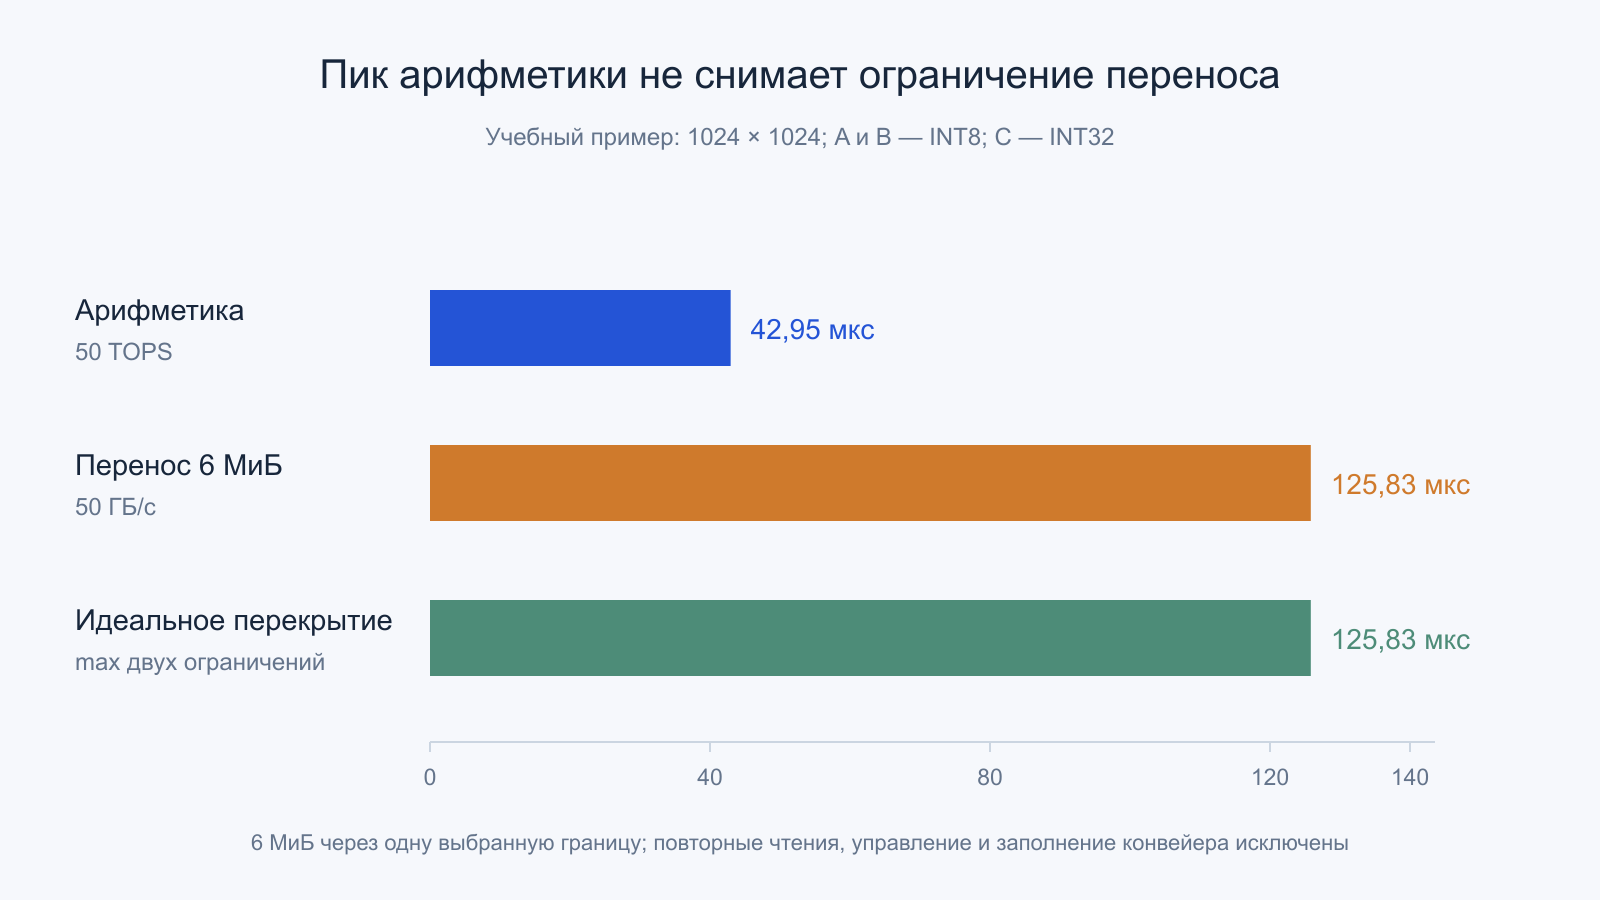
Возьмём то же произведение 1024×1024. Пусть A и B хранятся по одному байту на элемент, а результат C записывается четырьмя байтами на элемент. При идеальном однократном чтении входов и однократной записи выхода через выбранную границу проходят 6 МиБ, то есть 6 291 456 байт. Старый C не читается; повторные переносы тайлов исключены из модели.
Зададим пик 50 триллионов операций в секунду и постоянную полезную полосу 50 миллиардов байт в секунду. Арифметическая нижняя оценка равна примерно 42,95 мкс, а оценка переноса —125,83 мкс. Даже мгновенное управление не позволит завершить выбранный обмен быстрее его собственного ограничения. При идеальном перекрытии этапов граница составляет максимум этих двух чисел, а не их сумму.
Это частный расчёт по принципу анализа ограничений, изложенному в исходной работе Roofline. Он не предсказывает измеренную задержку: реальные переносы, конфликты, заполнение и опустошение конвейера добавляют расходы. Также нельзя незаметно подставить полосу SRAM вместо DRAM, оставив прежнее число байтов на другой границе.
Размер пакета меняет цену одних и тех же весов
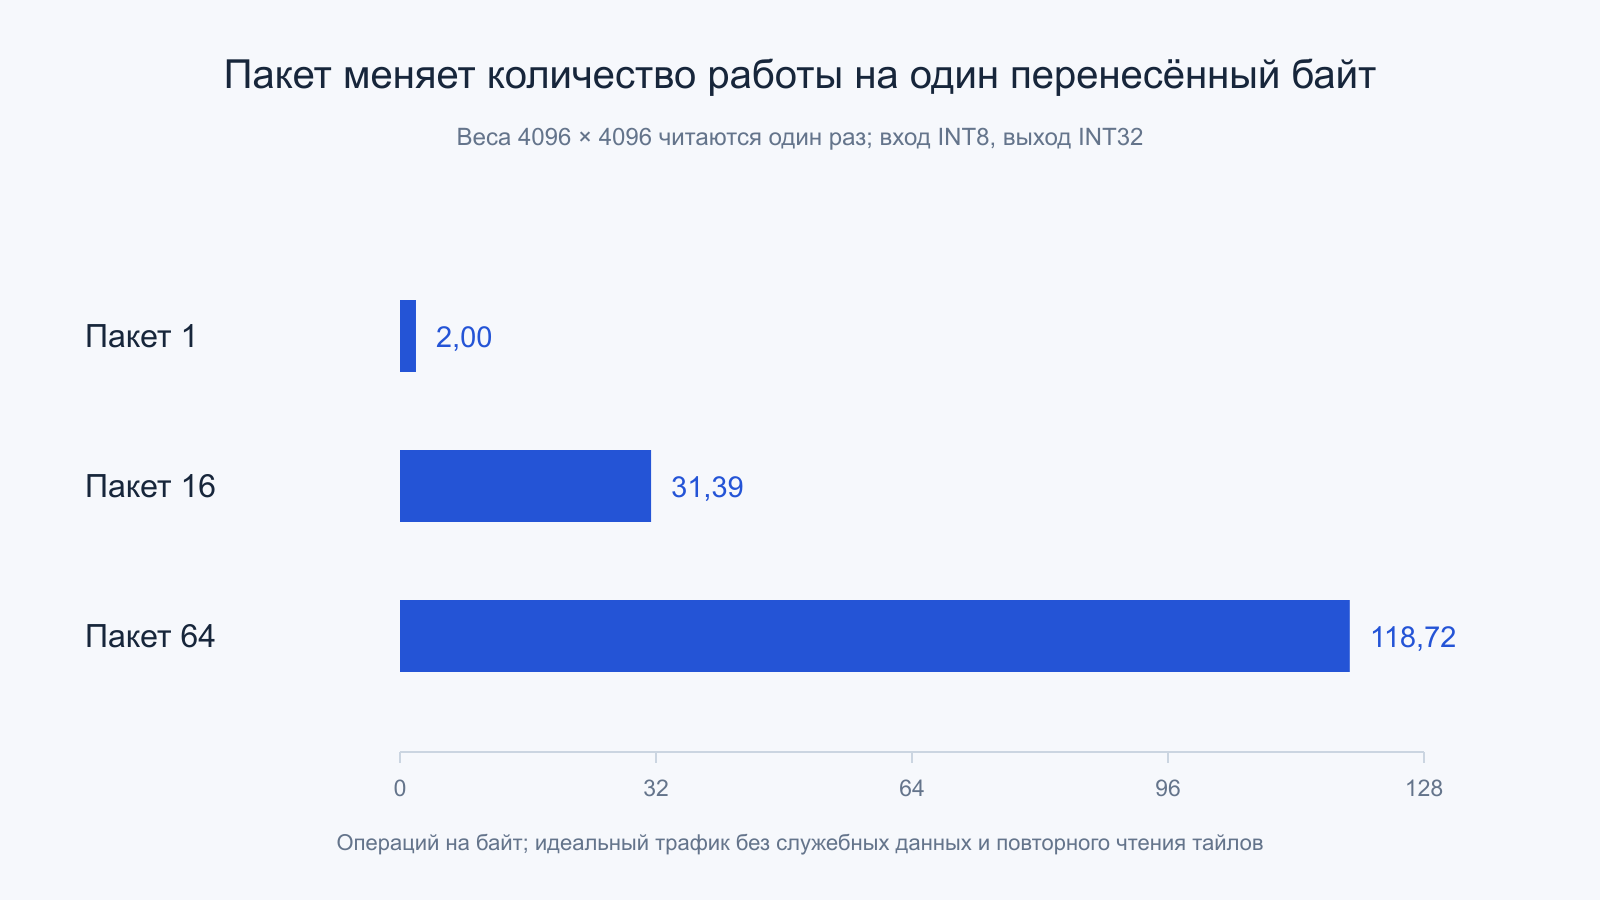
Рассмотрим матрицу весов 4096×4096 с однобайтными элементами. Она занимает 16 МиБ. Для одного входного вектора нужны ещё 4096 байт, а четырёхбайтный выход занимает 16 384 байта. Работа составляет 33 554 432 операции, идеальный трафик —16 797 696 байт. Получается около 2 операций на перенесённый байт.
Если одновременно обработать 16 векторов и в модели прочитать веса только один раз, работа возрастает до 536 870 912 операций при трафике 17 104 896 байт: примерно 31,39 операции на байт. Для пакета из 64 векторов соответствующее отношение составляет около 118,72. Здесь входы однобайтные, выходы четырёхбайтные, все служебные данные и дополнительные чтения исключены.
Увеличение объясняется повторным использованием весов, а не появлением более быстрой памяти. В реальном устройстве тайлы могут перечитываться, ёмкости и параллелизма может не хватить, а большой пакет способен ухудшить размещение. Поэтому эта последовательность показывает механизм, сохраняя обязательность измерения. Она не является обещанием одинакового ускорения любого графа.
Имеет значение и заполнение последних тайлов. Если условная реализация округляет каждую из трёх размерностей произведения с 1000 до 1024 и действительно вычисляет все дополненные позиции, число действий увеличивается в отношении (1024/1000)³, примерно на 7,37%. Это отдельная учебная организация, а не свойство любого NPU. Маскирование, специализированные хвостовые ядра или другая раскладка могут изменить цену. Логическая форма входа ещё не сообщает объём внутренней работы.
Точность входа, вычисления и результата — разные характеристики
INT8, FP16, BF16 и другие обозначения относятся к представлению чисел, но одной подписи рядом с TOPS недостаточно. Нужно узнать типы обоих операндов, накопителя и выходного тензора. Произведения коротких целых могут накапливаться в более широком целом, а затем снова масштабироваться. Это другой путь, чем последовательность операций с плавающей точкой той же номинальной длины.
Четырёхбитное хранение весов не доказывает четырёхбитный расчёт всех операций. Возможны распаковка, преобразование в другой формат, дополнительные масштабы и смешанные участки. Уменьшение файла снижает один вид трафика, но не автоматически все расходы. Описание формата модели и журнал реально выбранных аппаратных реализаций отвечают на разные вопросы.
В документации TensorRT 11.4 о форматах тензоров отдельно рассматриваются интерфейсные форматы и внутреннее размещение. При обсуждении собственного устройства аналогично фиксируют его версии и условия. Нельзя переносить таблицу GPU на произвольный NPU лишь потому, что оба выполняют нейросети.
Квантование меняет численную задачу
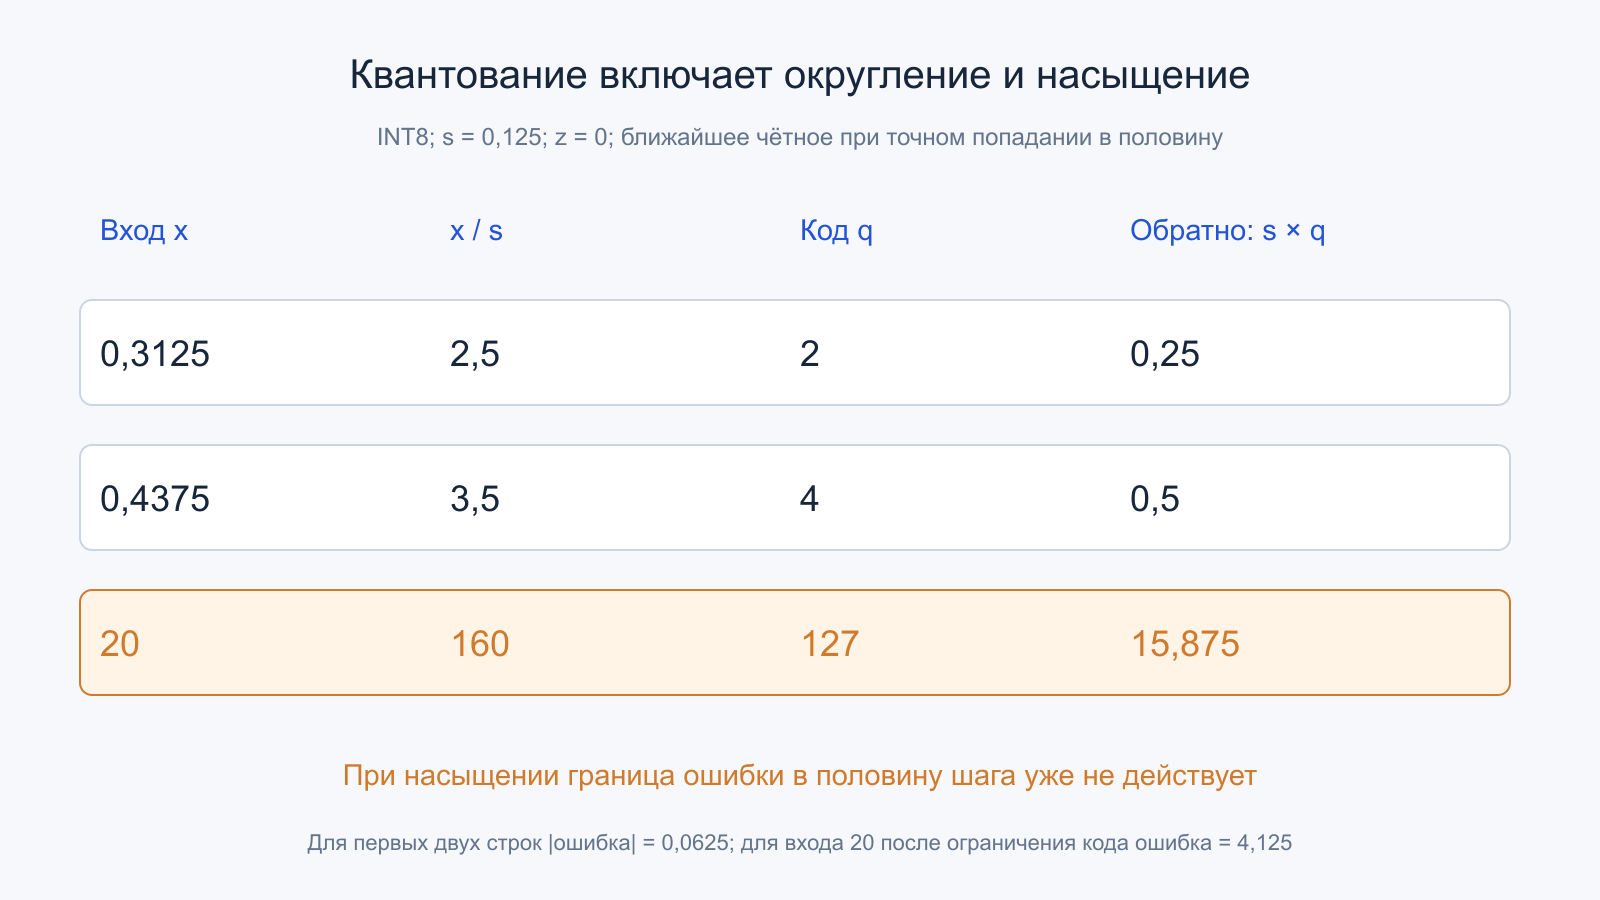
В простой линейной схеме вещественному значению сопоставляют целый код с масштабом s и нулевой точкой z. Обратное приближение имеет вид x̂ = s(q − z). Оператор ONNX QuantizeLinear определяет также округление и насыщение; эти детали нужны для воспроизводимого результата, а не только для экономии памяти.
В учебном примере s = 0,125 и z = 0 при INT8. Число 0,3125 даёт промежуточное 2,5 и при округлении к ближайшему чётному превращается в код 2: обратное значение равно 0,25. Число 0,4375 даёт 3,5, код 4 и значение 0,5. Выбранные дроби точно представимы в двоичной системе и показывают именно правило округления.
Для числа 20 промежуточный код 160 выходит за пределы INT8 и ограничивается 127. Восстановленное значение равно 15,875, ошибка уже 4,125. Граница в половину шага относится к обычному округлению внутри диапазона и не защищает от насыщения. Поэтому выбор масштаба требует проверки качества модели, а не только успешного преобразования файла.
Накопитель и выходная обработка тоже занимают аппаратные ресурсы
Сумма большого числа произведений требует запаса по диапазону. В условном скалярном произведении 4096 пар знаковых восьмибитных значений максимальная абсолютная величина отдельного произведения не превосходит 16 384. Консервативная оценка модуля суммы —67 108 864, что помещается в знаковый 32-битный накопитель. Смещения нулевых точек и bias в этот пример не включены.
Эта оценка не заменяет правил конкретного оператора: другая длина, коррекции и промежуточная точность способны изменить границы. Кроме умножения нужны масштабирование, округление, ограничение диапазона и нелинейная функция. Когда эти блоки имеют меньшую производительность или требуют дополнительных проходов, число MAC перестаёт описывать весь путь.
Объединение операций позволяет не записывать промежуточный результат во внешнюю память после каждого шага. Но оно ограничено поддерживаемыми сочетаниями и формами. Поэтому профилировщик должен показать фактические объединённые участки. Из наличия в модели последовательности «матрица, смещение, активация» ещё не следует, что любой компилятор обязательно исполнит её одним аппаратным проходом.
Для масштаба: промежуточный тензор 1024×1024 с двухбайтными элементами занимает 2 МиБ. Если после одной операции его полностью записывают во внешнюю память, а следующая полностью читает, получается 4 МиБ дополнительного обмена. Сохранение результата на подходящем локальном уровне потенциально убирает этот обмен через выбранную границу, но не сами данные и не обязательную итоговую запись. Выигрыш нужно проверять с учётом живых потребителей и доступной ёмкости, а не по одному факту объединения названий слоёв.
Разреженность имеет структуру и цену
Нулевые веса иногда позволяют не выполнять часть произведений. Однако обнаружение нуля, хранение позиций и выбор нужных входов тоже требуют организации. Случайный набор нулей не превращает автоматически обычный плотный матричный блок в ускоренный разреженный. Значимы разрешённый шаблон, формат сжатия, поддержка команд и размер задачи.
Документация TensorRT описывает конкретный пример структурного шаблона 2:4 для поддерживаемых GPU: в соответствующих группах должно оставаться не больше двух ненулевых значений. Это свойство модели проверяется по определённой оси. Из него нельзя вывести поддержку того же формата любым NPU. Даже допустимый шаблон не гарантирует, что компилятор предпочтёт разреженный вариант.
Если в показателе производительности считается эквивалентная работа плотной матрицы, пропуск нулей увеличивает заявленный эффективный темп относительно числа реально выполненных произведений. Сравнение требует одинакового соглашения. Сохранение качества после изменения весов проверяется отдельно: уменьшение арифметики не является доказательством сохранения результата на нужных данных.
Один неподдерживаемый участок способен изменить итог
Граф может исполняться целиком на ускорителе, разделяться между устройствами либо вообще не компилироваться в выбранном режиме. Автоматического универсального возврата на CPU для любой ошибки не существует. Даже когда программный стек поддерживает разделение, границы подграфов способны потребовать синхронизации, преобразования формата и переноса тензоров.
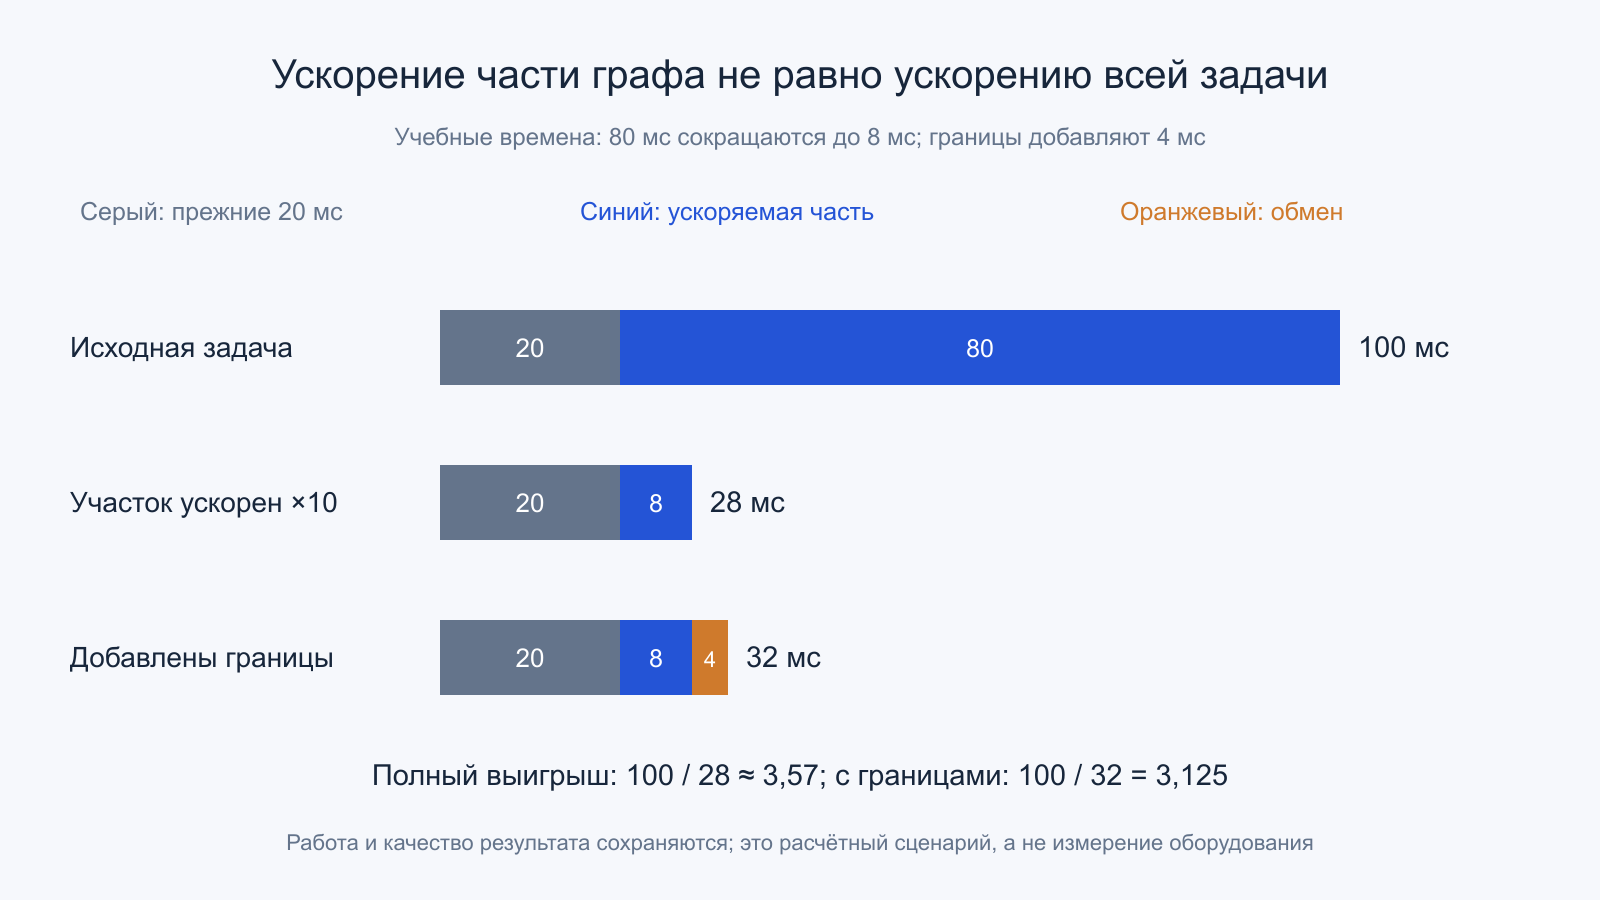
Пусть исходная задача занимает 100 мс, из которых 80 мс приходятся на ускоряемый участок. Ускорение этого участка в десять раз оставляет 20 + 8 = 28 мс, то есть общий выигрыш около 3,57 раза. Если границы исполнения дополнительно занимают 4 мс, получается 32 мс и выигрыш 3,125 раза. Никакого десятикратного ускорения всей задачи в этой модели нет.
Полезно выяснить не только долю операций, но и долю прежнего времени. Малочисленная операция с плохой локальностью или зависимостью может задерживать весь конвейер. Поэтому проценты «слоёв на NPU» без временной разбивки мало говорят о результате. Важен законченный путь от допустимого входа до результата нужного качества.
Пропускная способность и ожидание пользователя растут по-разному
Пакетная обработка помогает загрузить вычислители, но готовый пакет сначала нужно получить. Руководство TensorRT по оптимизации рассматривает этот компромисс для GPU. Он полезен и как общий вопрос к системе: сколько запросов завершается за секунду и сколько ждёт конкретный запрос?
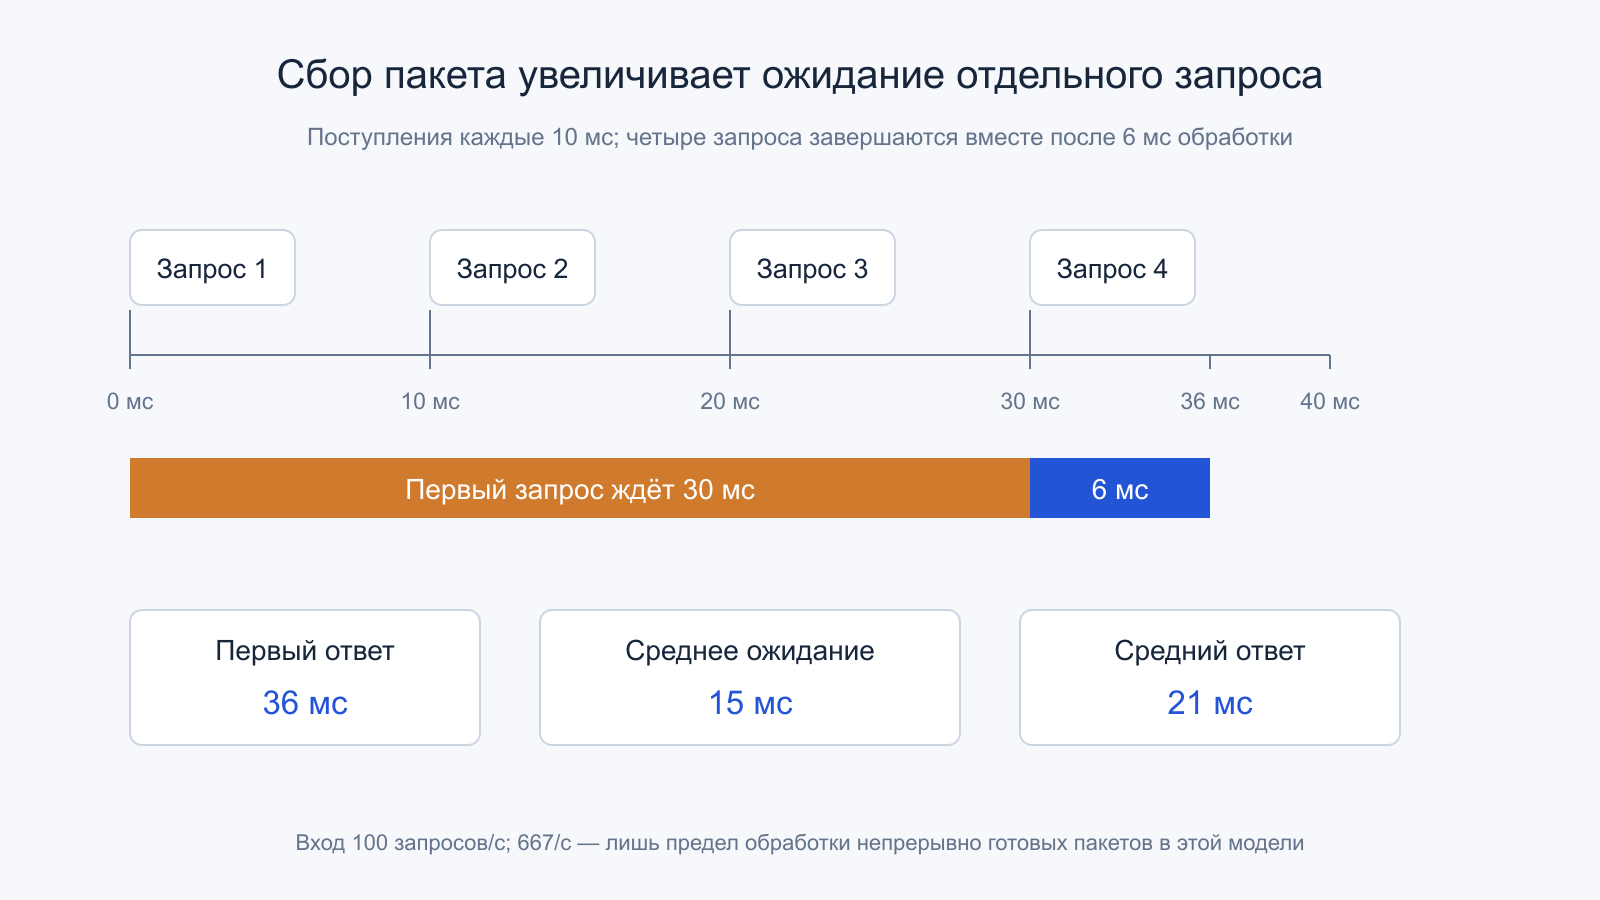
Предположим равномерные поступления через 10 мс. Для пакета из четырёх первые запросы ждут накопления 30, 20, 10 и 0 мс: среднее ожидание равно 15 мс. Если обработка готового пакета занимает 6 мс, первый результат для первого участника появится через 36 мс, а среднее время ответа составит 21 мс. В одиночном режиме с заданными 3 мс обслуживания ожидание пустой очереди отсутствует.
Предельный темп обработки непрерывно готовых пакетов был бы 4/0,006, около 667 запросов в секунду, против 333 в одиночном режиме. Но при входных 100 запросах в секунду обе системы реально получают только 100. Большая предельная мощность не делает редкий поток быстрее. Учебный сценарий предполагает завершение пакета одновременно и исключает дополнительные очереди.
Несколько очередей не создают бесконечную параллельность
Параллельные запросы могут занимать разные доступные участки устройства и скрывать простои между стадиями. Одновременно они делят вычислители, локальную память, внешнюю полосу и доступ хоста. Увеличение числа запросов иногда повышает общий поток, иногда лишь увеличивает очередь. Различать эти варианты нужно по времени завершения и загрузке конкретных ресурсов.
Общая платформа также ограничена температурой и мощностью. CPU подготавливает данные, GPU может обслуживать изображение, а NPU выполняет модель; их предельные цифры не обязательно достижимы одновременно. В длительном тесте частоты и распределение бюджета способны измениться. Короткий пик после простоя и установившийся режим отвечают на разные вопросы.
Заполнение матричного массива зависит от формы задачи. Небольшие или неудобные размерности оставляют часть аппаратуры без полезной работы либо требуют дополнительных тайлов. Поддерживаемая произвольная форма и эффективная форма не тождественны. Однако универсального «правильного кратного числа» для всех NPU нет: его выясняют по документации и фактическому выбранному исполнению.
В учебном видеопотоке 30 кадров в секунду интервал составляет около 33,33 мс. Если перед новым кадром уже стоят пять последовательных задач по 6 мс, его собственная обработка заканчивается через 36 мс после постановки в эту очередь. При дополнительных 8 мс подготовки получается 44 мс полного пути. Отдельный расчёт за 6 мс укладывался бы в интервал, но накопленная работа меняет результат. Управление очередью входит в систему наравне с арифметикой.
Почему генерация текста не сводится к одной цифре TOPS
Разные стадии одной языковой модели имеют различный характер работы. Обработка входной последовательности допускает значительный параллелизм, а последовательная выдача новых токенов включает зависимости от предыдущих результатов. Весовые матрицы, промежуточные активации и сохранённое состояние внимания образуют разные части рабочего набора. Их размер меняется с моделью и режимом.
Память для состояния зависит не только от числа параметров. Длина контекста, количество одновременно обслуживаемых последовательностей, тип данных и организация внимания способны менять требования. Поэтому правило «файл помещается в RAM, значит модель удобно работает на NPU» неполно. Нужно учитывать дополнительные буферы, форматы и возможность исполнения всех нужных операций.
В MLPerf Inference рабочие задачи связываются со сценариями, метриками и требованиями к качеству. Для собственного опыта аналогично отделяют ожидание первого результата, скорость дальнейшего вывода и завершение всего запроса. Эти величины нельзя восстановить из пикового темпа одной матричной операции без знания реального графа.
Энергию нужно измерять на выбранной границе
Небольшая мощность ускорителя может быть полезна для постоянной обработки, но не сообщает расход всего компьютера. Учебный блок потребляет 8 Вт в течение 8 мс: это 0,064 Дж. Если вся система в течение полного пути 11 мс потребляет в среднем 18 Вт, её энергия на запрос равна 0,198 Дж. Эти две оценки относятся к разным границам.
Их нельзя складывать: мощность всей системы уже включает работу её компонентов. Для сравнения дополнительной энергии относительно простоя требуется отдельно определить базовое потребление и одинаковый интервал. Пиковый датчик одного блока, средняя мощность из розетки и программная оценка драйвера не являются автоматически взаимозаменяемыми измерениями.
Энергоэффективность также имеет смысл только при нужном результате. Если быстрый режим меняет качество модели, задержку или допустимую длину входа, простое отношение запросов к ваттам описывает уже другую задачу. Нужны одинаковая работа, согласованная граница питания и достаточно длинный интервал, чтобы короткие всплески и простои не искажали вывод.
Как провести содержательное измерение
Сначала фиксируют модель, входные формы, данные и критерий качества. Затем записывают версию программного стека, устройство, точность, размер пакета и число запросов в полёте. Отдельно оговаривают прогрев и компиляцию. Без этих условий число миллисекунд трудно воспроизвести, а сравнение двух машин легко превращается в сравнение разных настроек.
Документация TensorRT по измерениям различает полный путь, время работы устройства и профилирование отдельных участков. Асинхронная отправка команды требует особой аккуратности: короткое время возврата функции ещё не означает, что результат готов. Для общей задержки используют границы, соответствующие реальному потребителю.
Нужно смотреть не только среднее. Редкие задержки подготовки, ожидание очереди и изменение частоты могут быть незаметны в одной усреднённой цифре. Полезно сохранять распределение времени и условия нагрузки, повторять тот же сценарий и проверять выход. Искусственный граф из удобных матриц хорошо исследует вычислительный блок, но не заменяет испытание приложения.
Какие вопросы задавать вместо сравнения одних TOPS
Начинать стоит с совместимости: исполняется ли нужная модель, с какими формами и качеством результата? Затем выясняют, какие участки занимают время, помещаются ли рабочие данные в доступную память и сколько стоит переход между устройствами. После этого оценивают задержку, поток и энергию в одинаковом сценарии. Такой порядок связывает аппаратные возможности с полезной задачей.
У паспортной производительности нужно уточнить точность, определение операции, плотный или разреженный режим и условия достижения пика. У измерения приложения — размер пакета, границы времени и состояние программного стека. Если эти сведения отсутствуют, число сохраняет рекламную выразительность, но почти не помогает инженерному выводу.
Хороший ускоритель уменьшает стоимость нужной части работы при приемлемых ограничениях. Его полезность определяется согласованием графа, вычислителей, памяти и окружающей системы. Поэтому технически содержательный результат выглядит как проверенный путь исполнения с понятными узкими местами, а не как обещание, что любое приложение ускорится пропорционально новой цифре в характеристиках.
Первичные источники и границы примеров
Документы ниже описывают разные платформы и поколения. Они используются для конкретных механизмов и методики; их паспортные возможности не объединяются в одно вымышленное устройство. Численные примеры и иллюстрации статьи самостоятельные и условные.
- Arm — Ethos-U85 NPU Technical Overview, Issue 03, 2025: управление, DMA, MAC и локальные буферы.
- Jouppi и соавторы — In-Datacenter Performance Analysis of a Tensor Processing Unit, 2017: исторический пример специализированной архитектуры.
- NVIDIA — Matrix Multiplication Background: число операций и организация матричного расчёта.
- Williams, Waterman, Patterson — Roofline, UCB/EECS-2008-134: граница вычислений и обмена с памятью.
- ONNX — QuantizeLinear: масштаб, нулевая точка, округление и насыщение.
- OpenVINO 2025 — NPU Device: возможности и ограничения конкретного плагина.
- NVIDIA TensorRT 11.4 — Data Formats and Tensors: размещение и структурная разреженность.
- NVIDIA TensorRT — Optimizing Performance: пакетная обработка и объединение операций.
- NVIDIA TensorRT — Performance Benchmarking: границы времени и профилирование.
- MLCommons — MLPerf Inference Datacenter: сценарии, метрики и требования к качеству.
Комментарии