SIMD и векторные инструкции: как процессор обрабатывает много данных за команду
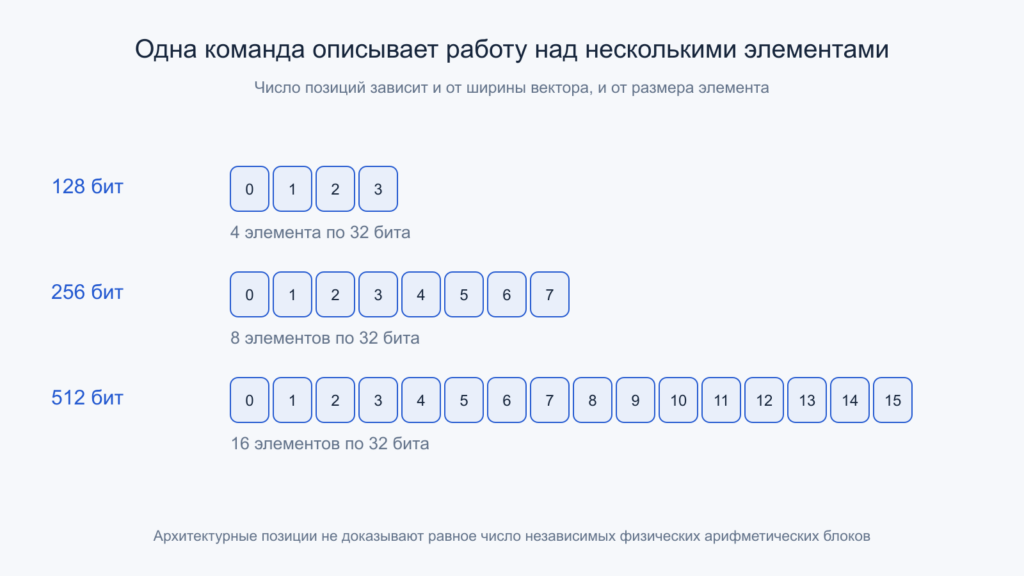
Число архитектурных позиций определяется шириной вектора и размером элемента. Физическая реализация команды может выполнять их несколькими частями. Открыть иллюстрацию в полном размере.
Процессор умеет выполнять широкие векторные инструкции, но программа использует лишь небольшую часть заявленной вычислительной мощности. После перехода на более широкие команды один цикл ускорился, а всё приложение почти не изменилось. В другом случае результат вычисления слегка отличается от скалярной версии. Чтобы объяснить эти ситуации, нужно разделить ширину данных, возможности исполнительных блоков, движение памяти и правила арифметики.
SIMD означает single instruction, multiple data: одна архитектурная команда описывает однотипную работу над несколькими элементами. Это не обещание одинаковой длительности всех команд и не автоматическое распараллеливание любого алгоритма. Ниже разобраны механизмы CPU и способы интерпретации результата. Все численные сценарии учебные, с указанными допущениями; они не являются измерениями оборудования владельца сайта.
Содержание статьи
- Ширина вектора и размер элемента задают число позиций
- Архитектурная команда не обязана совпадать с одной микрооперацией
- Векторизация и многопоточность используют разную независимость
- Независимые элементы и цепочка зависимостей требуют разных преобразований
- Неизвестное пересечение массивов может потребовать проверки
- Раскладка данных определяет стоимость их упаковки
- Невыровненная загрузка не всегда пересекает строку кэша
- Gather и перестановки не делают произвольные адреса бесплатными
- Маски и хвост массива определяют, сколько элементов полезно
- Условное действие может превратиться в обработку нескольких путей
- Редукция меняет порядок арифметики
- FMA объединяет умножение и сложение с одним округлением
- Задержка команды отличается от темпа её выдачи
- Как считать идеальную вычислительную границу
- Полоса памяти способна ограничить SIMD раньше арифметики
- Поддержка расширения требует совместимого состояния системы
- Подготовительная работа определяет границу выгоды
- Как подтвердить, что ускорен нужный участок
- Официальные первичные источники
- Читайте также
Ширина вектора и размер элемента задают число позиций
Векторный регистр можно рассматривать как контейнер нескольких элементов выбранного типа. В 128 бит помещаются четыре элемента по 32 бита, в 256 бит — восемь, в 512 бит — шестнадцать. Для 64-битных элементов при той же ширине число позиций уменьшается вдвое. Поэтому фраза «одна команда обрабатывает восемь чисел» требует уточнения типа данных и действующей архитектурной операции.
Одинаковые биты могут интерпретироваться как целые значения, числа с плавающей точкой или набор для логического преобразования. Смысл задаёт инструкция, а не вид регистра на рисунке. Разные операции поддерживают разные типы и способы насыщения, расширения или усечения. Например, обычное сложение целых и насыщающее сложение имеют различное поведение у границ диапазона.
Количество позиций называют количеством элементов или lanes в данном обсуждении. Не следует из этого автоматически выводить число независимых физических арифметических устройств. На уровне ISA описан результат, а внутри широкая команда может выполняться несколькими частями. Сначала выясняют семантику, затем изучают её реализацию на выбранном CPU.
Для учебных беззнаковых восьмибитных элементов сумма 250 + 20 при сложении по модулю 256 превращается в 14, а насыщающее сложение даёт 255. Обе операции используют одинаковое число позиций регистра, но решают разные задачи. При сравнении со скалярным кодом нужно учитывать и правила языка: узкие целые часто сначала расширяются, а ограничение результата возникает при последующем преобразовании. Совпадение ширины исходных переменных ещё не доказывает совпадение арифметики.
Архитектурная команда не обязана совпадать с одной микрооперацией
Процессор преобразует архитектурные инструкции во внутреннюю работу. Одна широкая команда способна занять несколько микроопераций или несколько исполнительных путей. Загрузка, перестановка и арифметика предъявляют разные требования, хотя снаружи все выглядят как операции над вектором. Поэтому подсчёт инструкций без их состава не является достаточной оценкой стоимости.
Intel Intrinsics Guide связывает интерфейсы intrinsics с требуемыми расширениями и семантикой. Сам справочник предупреждает, что некоторые intrinsics разворачиваются в последовательность инструкций. Вызов похожей на функцию конструкции не гарантирует ровно одной аппаратной команды. Это особенно важно для сложных перестановок, математических функций и операций, не имеющих прямого аналога в выбранном наборе.
При этом внутренняя реализация может меняться между поколениями при сохранении программного результата. Удвоение видимой ширины регистра не обещает удвоение выдачи арифметики за такт. Для анализа нужны доступные блоки, ограничения портов и зависимости. Название AVX, SVE или другого расширения описывает возможности исполнения, но не заменяет микроархитектурный паспорт конкретной операции.
Векторизация и многопоточность используют разную независимость
SIMD объединяет несколько однотипных элементов в одной последовательности команд. SMT предоставляет ядру несколько аппаратных потоков команд, а программная многопоточность распределяет работу между исполнителями. Эти механизмы способны сочетаться: каждый поток выполняет векторный цикл, а несколько потоков одновременно используют CPU. Однако они конкурируют за общие исполнительные ресурсы и ресурсы памяти.
Если один векторный поток уже насыщает соответствующие блоки ядра, второй SMT-сосед не получает второй полный комплект этих блоков. Аналогично увеличение числа ядер не ускорит бесконечно поток, ограниченный общей полосой памяти. Полезно отдельно оценивать объём независимости по данным и количество независимых потоков управления. Одного слова «параллельно» для этих двух решений недостаточно.
Векторный вариант также может уменьшить давление на выборку и декодирование, потому что описывает больше однотипной работы меньшим количеством команд. Но он способен добавить перестановки, проверки и обработку хвоста. Итог зависит от полного пути. Сравнивать следует одинаковые входные данные и проверяемый результат, а не только размер регистра в дизассемблере.
Независимые элементы и цепочка зависимостей требуют разных преобразований
Покомпонентное выражение, в котором результат для индекса i зависит только от входов того же индекса, удобно объединять в векторы. Совсем иначе ведёт себя рекуррентная зависимость: следующий элемент использует только что вычисленный предыдущий. Одновременная обработка нескольких индексов тогда может изменить исходный смысл, если просто подставить широкую команду вместо скалярной.
Это не означает, что всякая зависимость навсегда запрещает ускорение. Некоторые алгоритмы допускают префиксные преобразования, разбиение на независимые цепочки или специальную редукцию. Но нужно доказать эквивалентность и учесть дополнительную работу. Универсальная директива «векторизовать всегда» не является таким доказательством: неправильно заявленные свойства способны привести к неверному результату.
Документация LLVM разделяет векторизацию циклов и объединение похожих скалярных операций в базовых блоках. Также описаны ограничения зависимостей и допустимые преобразования. Для инженерного разбора важно знать, какой именно механизм сработал, а не считать любое появление векторной инструкции доказательством успешной обработки всего горячего цикла.
Неизвестное пересечение массивов может потребовать проверки
Два указателя в исходном коде могут ссылаться на непересекающиеся области, на одну область или на сдвинутые части общего массива. Для некоторых расположений запись очередного результата изменит значение, которое следующая итерация ещё должна прочитать. Компилятор обязан сохранить заданное поведение допустимой программы, поэтому неопределённость адресов влияет на выбор преобразования.
Один из вариантов — проверить отношения диапазонов во время исполнения и выбрать векторную либо скалярную ветвь. Такой механизм описан в LLVM для runtime checks. Он сохраняет корректность для разных входных адресов, но добавляет подготовительную работу и несколько вариантов кода. На маленьких массивах эта цена может оказаться значимой относительно самого вычисления.
Обещания вроде restrict и предположений о выравнивании полезны только тогда, когда соответствующие условия действительно выполняются. Это не просьба компилятору «постараться сильнее», а часть контракта программы с определёнными правилами. В информационном разборе важнее понять причину проверки, чем механически добавлять аннотации во все функции. Корректная скалярная ветвь ценнее быстрого варианта с ложным предположением.
Раскладка данных определяет стоимость их упаковки
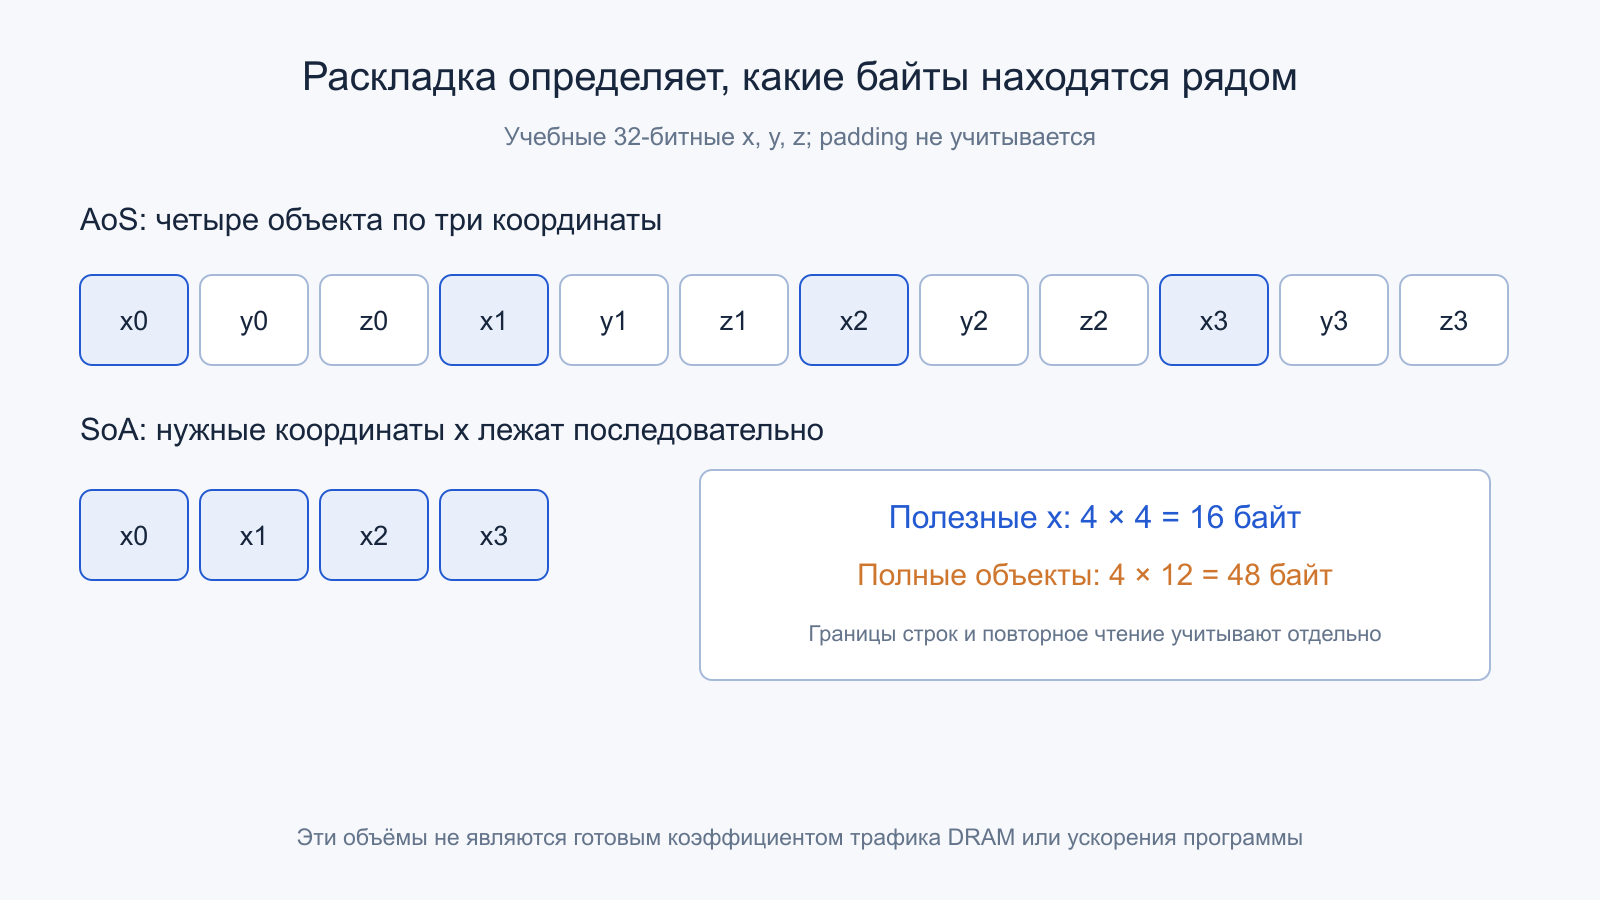
Пусть объект содержит три 32-битных координаты x, y и z. В массиве структур, AoS, память выглядит как x0,y0,z0,x1,y1,z1 и далее. Если горячему циклу нужны только x нескольких объектов, нужные элементы разделены другими полями. В структуре массивов, SoA, последовательность x0,x1,x2 хранится отдельно и лучше соответствует непрерывной загрузке этих координат.
Для четырёх таких объектов полезные координаты x занимают 16 байт, а полные структуры — 48 байт без padding. Но из этого нельзя автоматически объявить трёхкратное снижение трафика DRAM после изменения раскладки. Реальное движение идёт строками кэша и зависит от границ, повторного использования и того, нужны ли затем y и z. Это пример пространственной организации, а не универсальный коэффициент скорости.
Перекладка готового массива тоже требует времени и памяти. Она оправданна, когда последующая работа достаточно долго использует новый формат или данные сразу создаются удобно. Для смешанных операций иногда выгодны промежуточные блочные схемы. Рекомендации Intel по векторизации связывают раскладку и регулярный доступ с возможностями компилятора, сохраняя зависимость от задачи.
Невыровненная загрузка не всегда пересекает строку кэша
Для загрузки 32 байт выравнивание на 32-байтную границу означает соответствующее кратное начального адреса. Но граница инструкции и граница условной строки кэша 64 байта — разные вещи. Загрузка с 0x1004 по 0x1023 не выровнена на 32 байта, однако целиком находится внутри строки 0x1000–0x103F. Поэтому отождествлять любую невыровненность с двумя строками неверно.
Загрузка тех же 32 байт с 0x1030 по 0x104F действительно пересекает указанную границу. Это способно требовать дополнительной внутренней работы; пересечение страницы добавляет другой случай. Наблюдаемая стоимость зависит от инструкции, поколений CPU, попаданий и других условий. Одна универсальная задержка для всех невыровненных обращений не описывает эти различия.
Также существуют команды с обязательными требованиями к выравниванию и команды, предназначенные для допуска невыровненного доступа. Требование корректности нельзя подменять средним результатом быстрого опыта. Правильный выбор следует из архитектурной семантики и реальных свойств адресов. Затем измеряют стоимость на нужной платформе, сохраняя отдельный учёт раскладки, строк кэша и страниц.
Для условных страниц по 4 КиБ загрузка 32 байт с 0x1FF0 по 0x200F затрагивает две страницы. Это не делает её автоматически ошибочной: обе области могут быть разрешены и присутствовать в памяти. Однако нужны соответствующие переводы и доступность обеих частей. Если второй участок недопустим, правильная обработка хвоста особенно важна. Таким образом, требования объекта программы, границы страниц и гранулярность кэша следует проверять раздельно.
Gather и перестановки не делают произвольные адреса бесплатными
Gather собирает элементы из нескольких адресов в один вектор по правилам конкретной инструкции. Это удобно для индексированных структур, но физический канал памяти всё равно должен получить нужные строки и выполнить переводы адресов. Восемь элементов из одной строки и восемь элементов с разных страниц имеют разные требования, хотя результат помещается в регистр одинаковой ширины.
Перестановки и распаковки изменяют расположение элементов внутри векторов или между ними. Их стоимость зависит от поддерживаемой области обмена и внутренней реализации. Иногда половины широкого регистра имеют дополнительные ограничения для определённых команд. Поэтому схема с произвольными стрелками от каждого входа к каждому выходу может скрывать несколько реальных инструкций.
Алгоритм оценивают вместе с подготовкой данных. Если арифметика занимает мало работы, сборка и перемешивание способны стать основным пределом. В таком случае изменение структуры данных иногда полезнее замены арифметической команды на более широкую. Но оно тоже имеет цену и должно сохранять доступность данных остальной программе. Быстрая отдельная перестановка не доказывает быстрый полный цикл.
Маски и хвост массива определяют, сколько элементов полезно
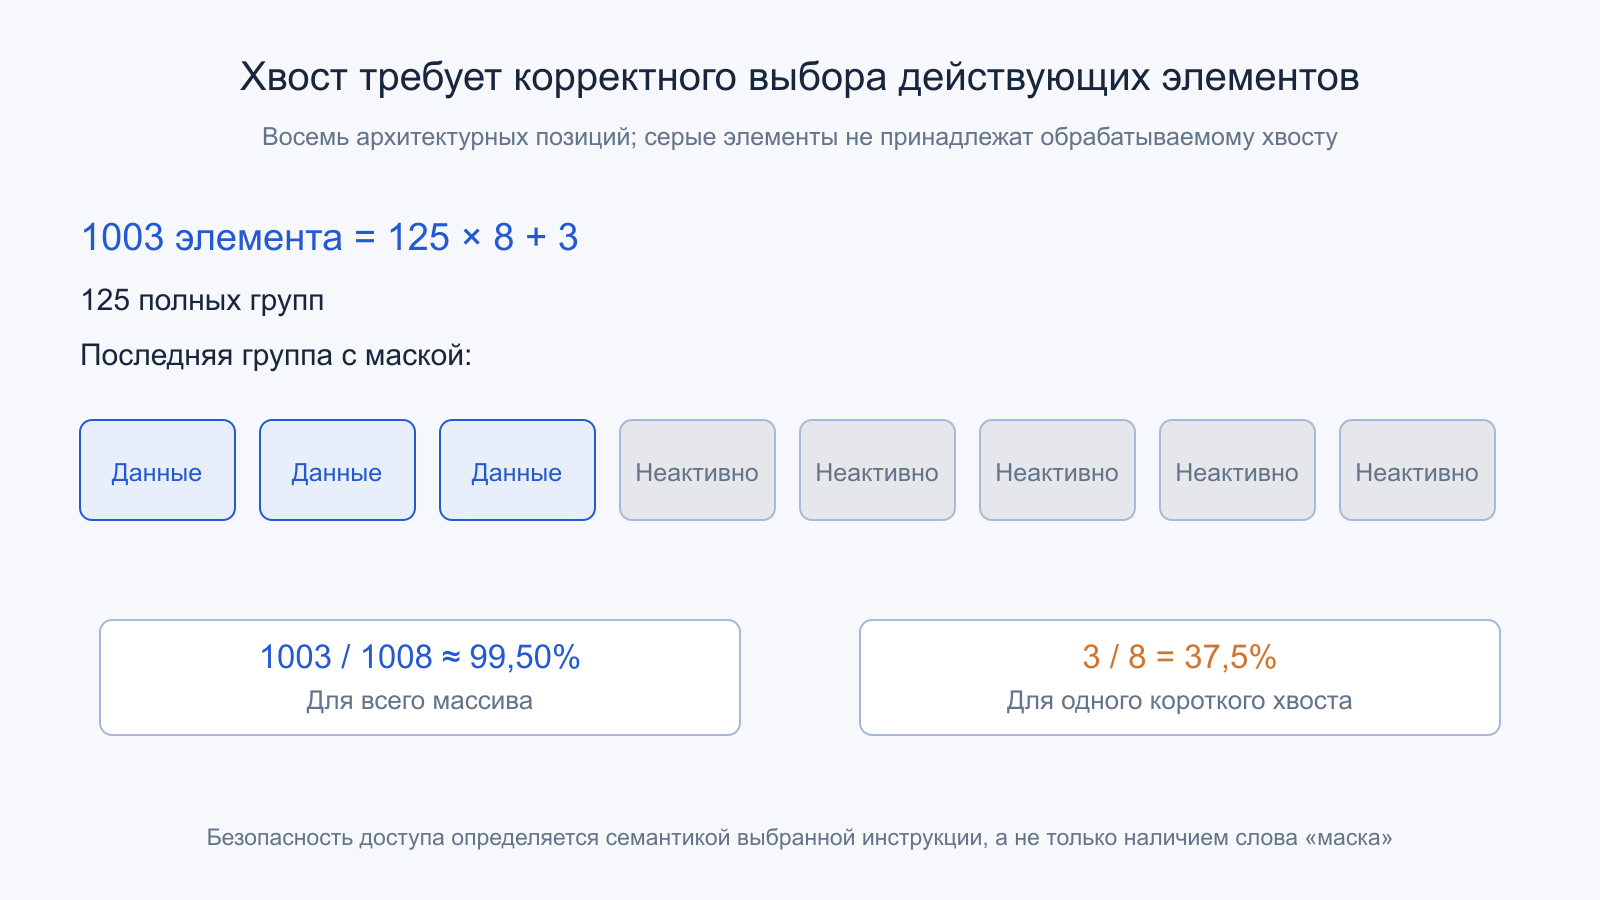
Размер массива редко обязан быть кратен ширине вектора. Для 1003 элементов и восьми позиций получаются 125 полных групп по восемь и остаток три. Реализация может обработать хвост скалярно, более узкой командой или маской. Если выбрана одна восьмипозиционная группа для остатка, всего задействовано 1008 архитектурных позиций при 1003 полезных элементах: около 99,50 процента.
Для массива всего из трёх элементов та же группа имеет полезные 37,5 процента позиций, а подготовительные расходы становятся заметнее. Процент заполнения не равен проценту использования всех транзисторов: выключенные элементы и маски реализуются по-разному. Также нельзя считать, что любая маскированная команда гарантирует безопасное обращение за пределы объекта. Требуется предусмотренная семантика именно выбранной операции.
В архитектурах с масштабируемой длиной полезен другой стиль цикла: количество доступных элементов определяется предусмотренным способом, а предикат отмечает действующие позиции. Arm ACLE описывает соответствующую модель SVE. Код, независимый от длины вектора, отличается от программы с навсегда зашитой цифрой восемь; переносимость требует соблюдения правил типов и предикатов.
Условное действие может превратиться в обработку нескольких путей
При разных условиях для соседних элементов векторный код способен вычислить несколько вариантов и затем выбрать нужные результаты маской. Это уменьшает некоторые переходы, но не обязательно исключает арифметику невыбранных путей. Иногда аппаратура поддерживает более эффективную предикацию, иногда компилятор оставляет отдельный цикл. Итог зависит от операции и статистики данных.
Если один путь очень дорогой и нужен редко, вычислять его для всех элементов может оказаться невыгодно. Для другого алгоритма регулярная обработка без плохо предсказываемых переходов даёт преимущество. Нельзя оценить ситуацию только по числу строк if в исходном тексте. Нужно знать, какие инструкции действительно исполняются и какие обращения к памяти они вызывают.
Исключения и побочные эффекты тоже входят в семантику. Невыбранное деление, вызов функции или доступ к недопустимому адресу нельзя безусловно считать безвредным только потому, что его результат потом отбрасывается. Корректное преобразование учитывает правила языка и ISA. Это ещё одна причина, почему автоматическая векторизация представляет собой анализ, а не механическое объединение соседних итераций.
Редукция меняет порядок арифметики
При суммировании элементы часто распределяются между несколькими частичными аккумуляторами, которые затем объединяются. Это помогает получить независимость и использовать широкую обработку. Но порядок сложений меняется. Для целых чисел результат зависит от определённой арифметики и обработки переполнения; для чисел с плавающей точкой важны округления после операций.
В учебном примере IEEE binary32 с обычным округлением к ближайшему выражение (100000000 + (−100000000)) + 1 даёт 1. При другом порядке 100000000 + ((−100000000) + 1) внутренняя единица теряется при округлении рядом с большим по модулю числом, и получается 0. Это демонстрация неассоциативности, а не неисправность векторного блока.
Работа Дэвида Голдберга в Numerical Computation Guide объясняет такие ограничения арифметики. Допустимость перестановки определяется требованиями численного алгоритма и режимом компиляции. Для воспроизводимых расчётов проверяют не только среднюю относительную ошибку, но и особые значения, чувствительные случаи и нужный критерий совпадения. Максимальная скорость не является самостоятельным доказательством численной пригодности.
FMA объединяет умножение и сложение с одним округлением
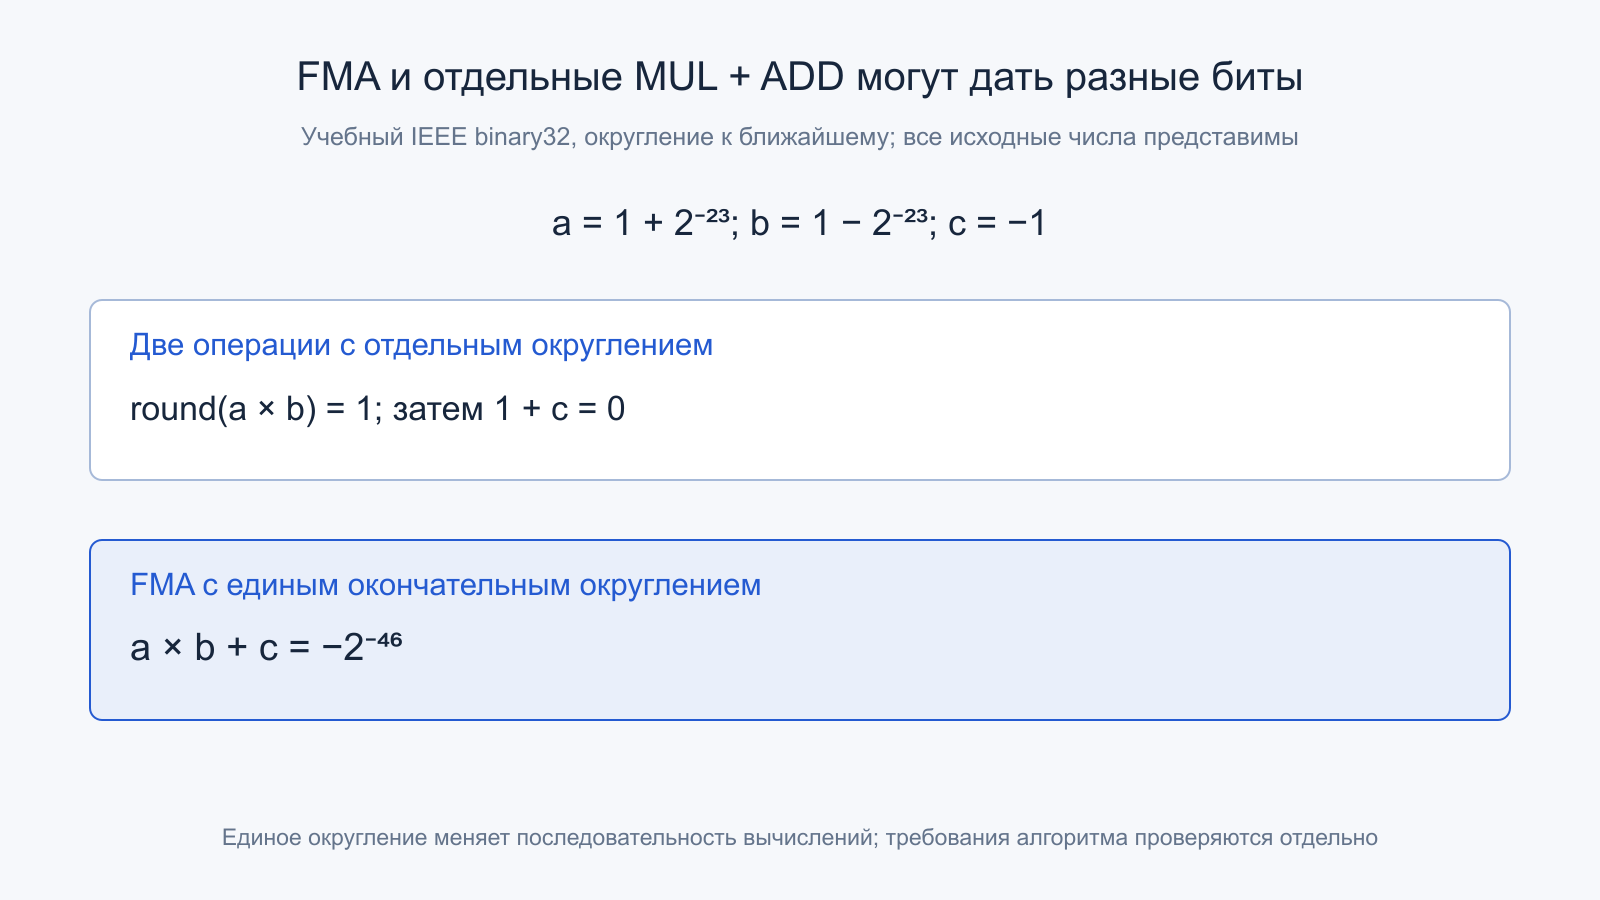
Fused multiply-add вычисляет выражение вида a×b+c с предусмотренным единым окончательным округлением вместо двух отдельных округлений результата умножения и последующего сложения. Для одной позиции это обычно считают двумя арифметическими операциями при подсчёте FLOP, хотя архитектурная инструкция одна. Смешение числа команд и числа операций делает паспортные сравнения бессмысленными.
Пусть binary32-числа a = 1 + 2⁻²³, b = 1 − 2⁻²³ и c = −1. Точное произведение равно 1 − 2⁻⁴⁶. При отдельном округлении в binary32 произведение становится 1, а последующее сложение даёт 0. В объединённой операции точный промежуточный результат после прибавления c равен −2⁻⁴⁶, которое представимо в этом формате. Получаются разные корректные результаты разных последовательностей.
Единое округление часто полезно для точности, но не означает, что можно менять любой алгоритм без проверки. Оно меняет воспроизводимость по сравнению с прежней последовательностью и взаимодействует с требованиями библиотеки. Следует отдельно знать, разрешено ли объединение операций и требуется ли битовое совпадение. FMA является инструментом с определённой семантикой, а не общей кнопкой «быстрее и всегда лучше».
Задержка команды отличается от темпа её выдачи
Предположим, условная арифметическая операция имеет задержку четыре такта, а соответствующие блоки способны начинать две независимые операции за такт. Одна последовательная цепочка накопления ждёт свой предыдущий результат и не использует весь такой темп. Для идеального заполнения понадобятся по меньшей мере восемь независимых цепочек: четыре такта умножить на две операции за такт.
Это объясняет использование нескольких аккумуляторов и развёртки цикла. Но больше аккумуляторов расходуют регистры, меняют код и могут добавить финальное объединение. После определённого предела дальнейшее расширение повышает расходы или вызывает сохранение временных данных в память. Нельзя считать, что произвольное увеличение развёртки всегда лучше: нужно сопоставить независимость с конечными ресурсами.
Приведённые четыре и два — параметры учебной машины. Для реального CPU задержку и допустимый темп берут из соответствующей документации или корректного измерения. Отдельно проверяют, не ограничивают ли цикл загрузки, адресная арифметика и перестановки. Быстрый арифметический блок не поможет, если необходимые операнды приходят реже его возможностей.
Как считать идеальную вычислительную границу
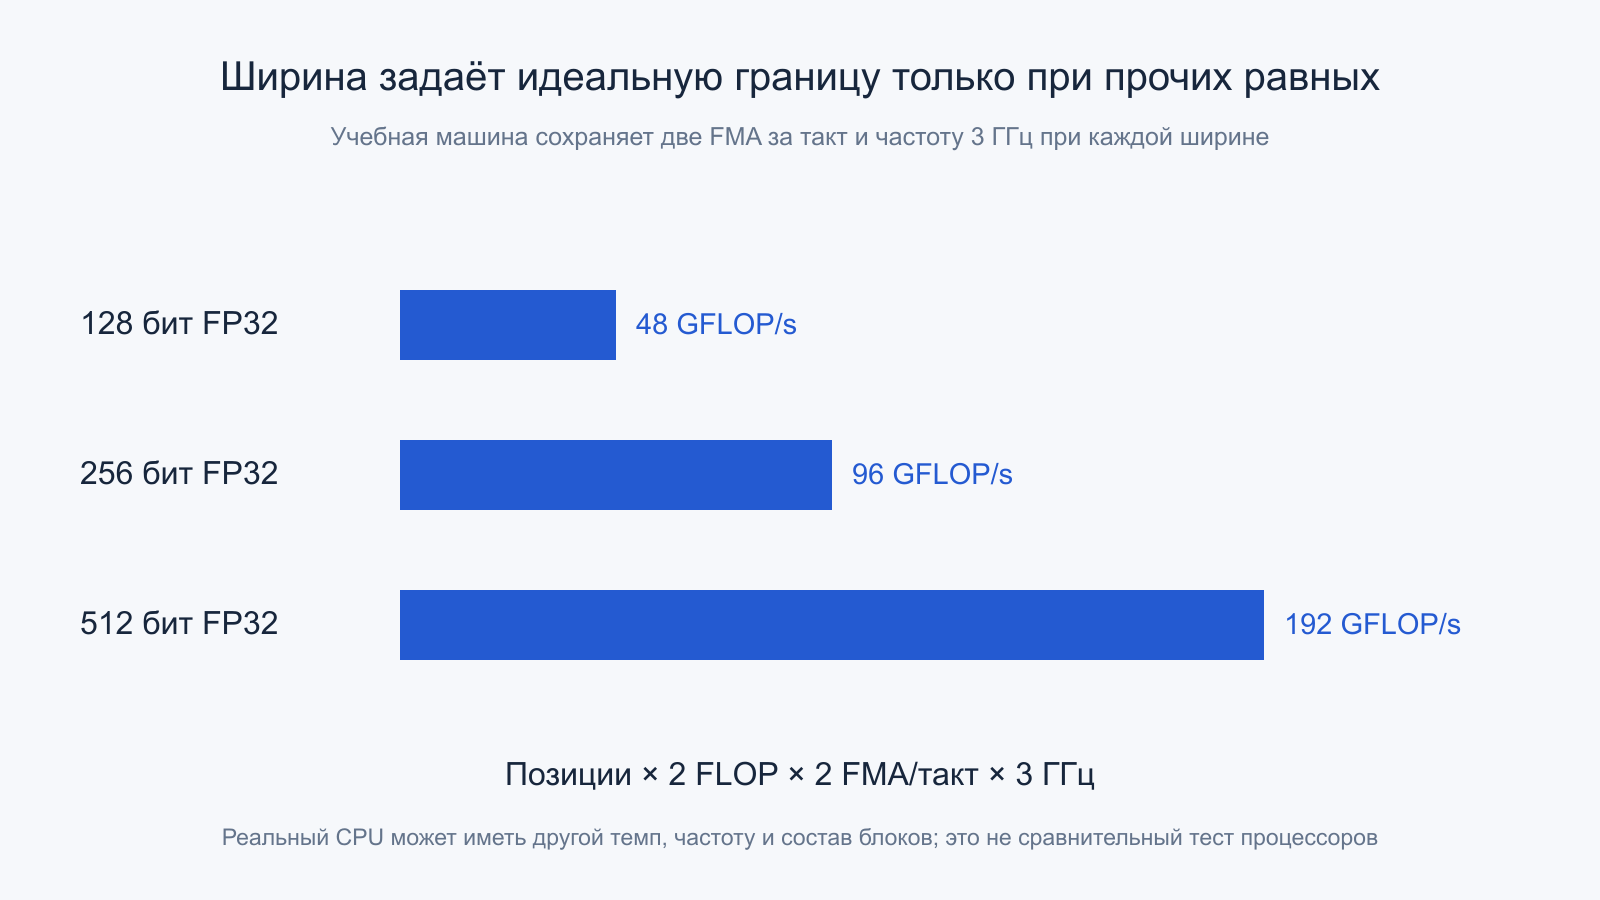
Зададим восьмипозиционную FP32 FMA, то есть регистр 256 бит, две такие независимые инструкции за такт и постоянную частоту 3 ГГц. Идеальная граница равна 8 × 2 × 2 × 3 миллиарда = 96 GFLOP/s: восемь элементов, две операции на элемент, две инструкции и число тактов. Это расчёт заданной машины без загрузок, перестановок, хвостов и ограничений.
При четырёх FP64-элементах и тех же остальных предположениях получится 48 GFLOP/s. Если искусственно сохранить темп для 512 бит, шестнадцать FP32-элементов дали бы 192 GFLOP/s. Но именно сохранение темпа требует доказательства: настоящий CPU способен исполнять широкую операцию частями или иметь другой состав блоков. Рисунок линейной зависимости ниже не является таблицей реальных процессоров.
Смешанная программа содержит иные команды, поэтому отношение к такой границе требует ясной методики. Некоторые операции выполняют больше внутренней работы при одном архитектурном результате, а другие ограничиваются делением или обменом данных. Граница помогает найти масштаб, но не обязана быть достижимой для любого алгоритма. Сначала выбирают правильный вид полезной операции, а затем считают соответствующий предел.
Полоса памяти способна ограничить SIMD раньше арифметики
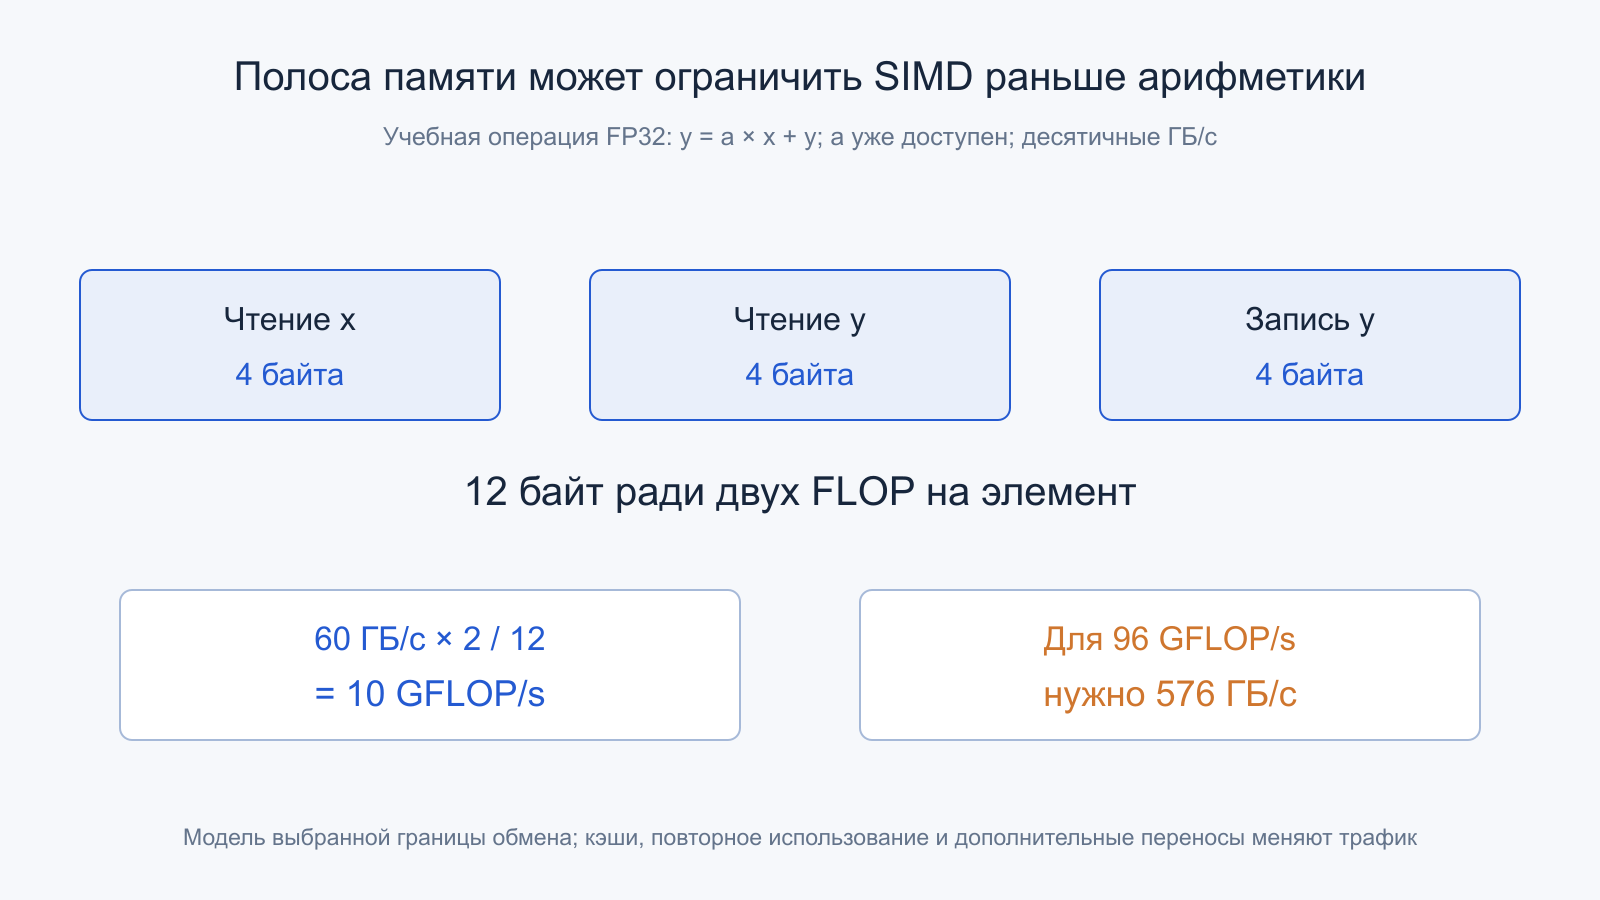
Для операции y = a×x + y над FP32-элементами требуется прочитать x, прочитать старое y и записать новое y. В простой модели внешнего обмена это 12 байт ради двух FLOP на элемент. Если доступная полоса равна 60 десятичным ГБ/с, идеальный предел по этому обмену составляет 60 × 2/12 = 10 GFLOP/s. Более широкий регистр сам по себе не меняет деление.
Чтобы поддерживать ранее заданные 96 GFLOP/s при той же интенсивности обмена, понадобились бы 576 ГБ/с. В реальности кэширование и повторное использование могут уменьшить внешний трафик, а дополнительные переносы — увеличить. Поэтому важно выбрать границу: DRAM, конкретный уровень кэша или интерфейс между блоками. Подстановка полосы одного уровня и трафика другого создаёт фиктивный прогноз.
Если алгоритм многократно обрабатывает уже загруженные данные, арифметическая интенсивность растёт. Тогда SIMD способен проявить больше своей вычислительной возможности. Для одноразового простого прохода предел часто другой. Оптимизация полезна, когда изменяет соответствующее узкое место, а не только название инструкции. Сокращение лишних проходов иногда важнее увеличения ширины отдельного умножения.
Поддержка расширения требует совместимого состояния системы
Бинарный файл должен использовать инструкции, разрешённые на фактическом процессоре и поддерживаемые окружающей системой. В x86 для расширенного состояния важны не только признаки CPU, но и предусмотренное управление сохранением соответствующих регистров ОС. Проверка возможностей и выбор ветви исполнения выполняются по архитектурным правилам; одна строка из описания магазина не заменяет их.
Библиотеки часто содержат несколько реализаций и выбирают подходящую при запуске. Это позволяет обслуживать разные машины одним приложением, сохраняя запасной путь. Но наличие широкого кода в бинарном файле не означает, что он был выбран в конкретном опыте. Нужно учитывать фактическую ветвь, разрешённые возможности и среду исполнения, особенно при виртуализации и неоднородной аппаратуре.
Кроме того, интенсивная векторная работа может менять установившийся режим частоты и мощности конкретного CPU. Это не универсальная фиксированная скидка на все широкие инструкции и не повод обходить ограничения. В испытании сохраняют реальные условия, длительность и температуру, а частоту рассматривают вместе с числом выполненных операций. Эффективный вариант выбирается по законченному результату.
Подготовительная работа определяет границу выгоды
Векторный путь может требовать проверки адресов, подготовки констант, перестановки формата и обработки остатка. Зададим постоянные 300 нс подготовки и 1 нс на элемент, а скалярному пути — 4 нс на элемент без дополнительной подготовки. Равенство 300 + N = 4N даёт N = 100. Только выше этой границы именно наша модель обещает выигрыш векторного варианта.
Для 32 элементов получаются 332 нс против 128 нс: широкий путь медленнее. Для 1024 элементов — 1324 нс против 4096 нс, или примерно 3,09-кратное ускорение. Числа искусственные и не учитывают изменения кэша, но показывают цену постоянной работы. Измерение одного большого массива не доказывает выгодность для тысяч маленьких вызовов.
Перенос подготовки за цикл или переиспользование преобразованных данных способно изменить границу. Одновременно оно меняет жизненный цикл буфера и требования к памяти. Для реальной программы рассматривают распределение размеров и частоту повторного использования, а не только лучший единичный случай. Правильная оптимизация должна сохранять численные требования и быть полезной в фактической структуре работы.
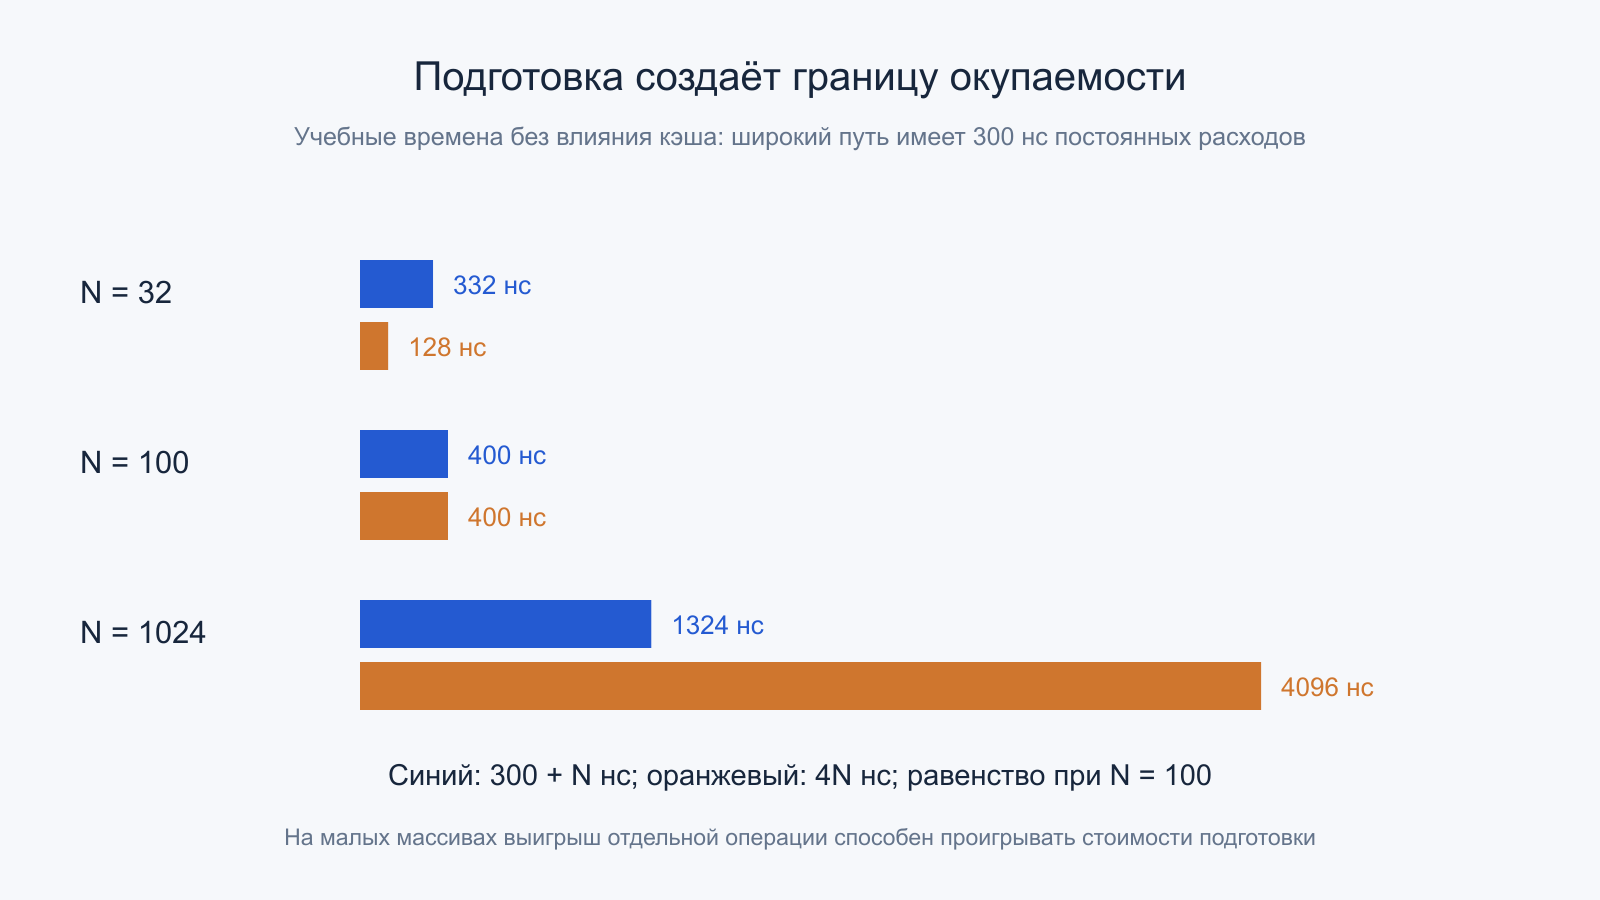
Особенно полезны случаи около границы: 99, 100 и 101 элемент в заданной модели. Для них времена широкого пути равны 399, 400 и 401 нс, а скалярного —396, 400 и 404 нс. Малое преимущество рядом с пересечением легко скрывается измерительным шумом и расходами вызова. Поэтому точку окупаемости нельзя честно объявлять по одному запуску; анализируют диапазон размеров и повторяемость законченной операции.
Как подтвердить, что ускорен нужный участок
Начинают с горячего участка и одинакового проверенного результата. Отчёт компилятора помогает увидеть, какие циклы векторизованы и почему другие оставлены скалярными. Дизассемблирование подтверждает выбранные инструкции, но само по себе не показывает их долю во времени. Затем сопоставляют профиль, движение данных и длительность всей обработки, сохраняя одинаковые входные условия.
Проверяют разные размеры, выравнивания и допустимые отношения адресов, а также хвосты и особые численные значения. Измерения повторяют после прогрева в контролируемой среде. Если ускорен цикл, занимавший малую часть общего времени, приложение закономерно меняется слабее. Вывод связывают с долей этого участка и появившимися новыми ограничениями, а не с обещанием ускорить весь компьютер.
SIMD ценен тем, что делает однотипную независимую работу компактнее для CPU. Его возможности раскрываются, когда данные приходят в подходящем виде, ресурсы загружены осмысленно, а численная семантика сохранена. Самая широкая доступная команда является лишь одним вариантом реализации. Инженерный результат — корректная задача, выполненная быстрее в своих условиях, с понятной причиной и проверяемыми границами.
Официальные первичные источники
- Intel — Software Developer Manuals: архитектурная семантика, расширенное состояние и определение инструкций.
- Intel — Intrinsics Guide.
- LLVM — Auto-Vectorization: проверки адресов, редукции, хвосты, gather и SLP.
- Intel — Vectorization Programming Guidelines, версия 2025.2.
- Arm — C Language Extensions: модель векторных типов и предикатов SVE.
- GCC — Auto-vectorization: документация проекта преобразований циклов и базовых блоков.
- David Goldberg — What Every Computer Scientist Should Know About Floating-Point Arithmetic, публикация в Oracle Numerical Computation Guide.