Вычисления в памяти: PIM, цифровые ядра и аналоговые матричные массивы
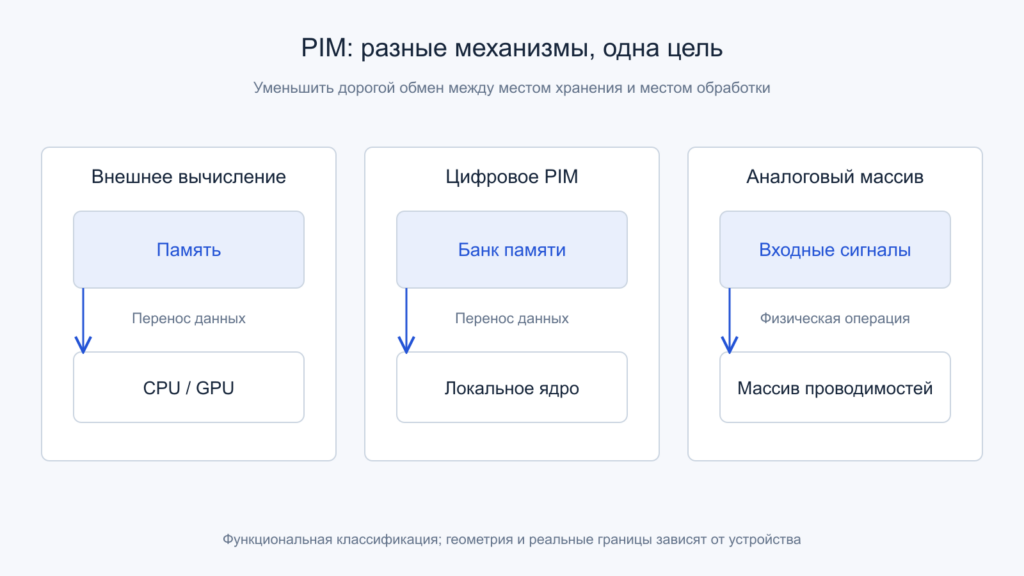
Три способа расположить вычисления относительно данных. Функциональная схема, без привязки к топологии конкретной микросхемы. Открыть иллюстрацию в полном размере.
У процессора может быть огромная вычислительная мощность, но она бесполезна в тот момент, когда исполнительные блоки ждут очередную порцию данных. Увеличение числа ядер не расширяет автоматически каналы памяти. Кэш помогает только при повторном использовании, а в длинном проходе по большому массиву каждый элемент приходится действительно прочитать. Отсюда возникает привлекательная идея: перенести вычисления туда, где уже находятся данные.
Под названием processing-in-memory, или PIM, скрываются разные машины. Одни содержат обычные цифровые ядра рядом с банками DRAM. Другие выполняют матричное умножение благодаря электрическим свойствам массива памяти. Их нельзя оценивать одним числом TOPS и одной картинкой «процессор внутри оперативки». Разберём границы обмена, программирование, точность и полное время задачи. Статус примеров сверён на 26 октября 2026 года; все числовые модели и схемы ниже учебные, а не измерения оборудования владельца сайта.
Содержание статьи
- 1. Что именно мешает обычному вычислению
- 2. Три разных смысла вычислений около памяти
- 3. Что реально показано, а что ещё нельзя обещать
- 4. Цифровой PIM: обычные инструкции в необычном месте
- 5. Разделение данных важнее количества исполнителей
- 6. Начальная загрузка: когда ускорение начинает окупаться
- 7. Внутренняя полоса и размер возвращаемого результата
- 8. Аналоговый массив: от закона Ома к матрице
- 9. Почему одновременно считать не означает бесплатно считать
- 10. Разбиение на разряды и скрытая цена точности
- 11. Квантование, шум и дрейф — разные ошибки
- 12. Запись весов, обучение и повторное использование
- 13. Что доказала демонстрация ALBERT
- 14. Почему большая HBM ещё не становится PIM
- 15. Температура, обновление DRAM и системная надёжность
- 16. Энергия: считать полезный результат на одинаковой границе
- 17. Как выбрать первый алгоритм для переноса
- 18. Протокол проверки без рекламных сокращений
- 19. Где проходит настоящая граница преимущества
- 20. Первичные источники и границы материала
- Читайте также
1. Что именно мешает обычному вычислению
Рассмотрим фильтрацию таблицы: для каждой записи проверяется короткое условие, а наружу возвращаются только совпадения. Арифметики мало, вход велик. Если память отдаёт данные медленнее, чем ядра проверяют условия, установка более мощного процессора почти не изменит пропускную способность. Необходимо уменьшить объём обмена или расширить именно ограничивающую границу.
Однако фраза «задача ограничена памятью» недостаточно точна. Можно упереться в внешние каналы DRAM, в пропускную способность кэша, в задержку цепочки зависимых чтений либо в доступ к памяти другого сокета. PIM, устраняющий одну границу, не обязан исправить остальные. Разреженный граф с зависимыми указателями и последовательное чтение столбца предъявляют разные требования, хотя оба сценария часто называют memory-bound.
Сначала полезно нарисовать путь одного полезного результата. Какие байты прочитаны, какие использованы повторно, какие отброшены? Затем отметить, где данные пересекают дорогую границу. Только после этого появляется предметный вопрос: какую часть этой работы удастся выполнить локально и сколько результата придётся вернуть.
2. Три разных смысла вычислений около памяти
Вычислитель можно расположить на модуле памяти, на логическом кристалле под стеком DRAM или непосредственно рядом с отдельными банками. В этих случаях арифметика часто остаётся цифровой: инструкции, регистры, целочисленные операции и явно организованные переносы. Сокращается расстояние и меняется доступная параллельность, но сами ячейки памяти не обязаны становиться арифметическими элементами.
У in-array computing часть операции реализуется внутри массива. В аналоговом резистивном массиве проводимости кодируют коэффициенты, напряжения представляют вход, а токи складываются по столбцам. Есть и другие механизмы, включая цифровые операции с битовыми представлениями. Поэтому противопоставление «обычный компьютер цифровой, PIM аналоговый» неверно уже на уровне классификации.
Удобнее задавать три независимых вопроса: где расположен вычислитель, какой физический механизм выполняет операцию и какая программная модель доступна. Две системы с одинаковым положением логики могут иметь совершенно разные наборы операций. А одинаковый математический результат может получаться либо последовательностью инструкций, либо смешанным аналоговым трактом с цифровой обработкой.
3. Что реально показано, а что ещё нельзя обещать
В исследовании UPMEM описана изготовленная и экспериментально изученная система с цифровыми DPU внутри микросхем DRAM. Это свидетельство существования работающей архитектуры, а не прогноз из симулятора. Публикация Samsung 2021 года отдельно описывает интеграцию HBM-PIM с ускорителем Alveo и обработку на модуле AXDIMM. Эти примеры имеют разные места размещения логики.
В сентябре 2026 года SK hynix показала AiM, плату AiMX, сервер с этой платой и демонстрационный LLM-сервис. Публичный показ подтверждает демонстрацию названной конфигурации. Сам по себе он не устанавливает доступность всех вариантов в рознице, цену интеграции или гарантированный выигрыш произвольной модели.
У IBM существуют разные исследовательские чипы: публикация 2023 года о смешанной архитектуре с 64 аналоговыми тайлами и отдельная работа о 34-тайловом речевом чипе. Их характеристики нельзя собирать в один воображаемый продукт. Состояние направления следует оценивать по конкретной плате, версии программ и задаче, сохраняя различие между исследованием, демонстрацией и пригодной к закупке системой.
4. Цифровой PIM: обычные инструкции в необычном месте
Цифровое ядро около банка памяти получает локальный участок данных и исполняет программу. Это удобно для простых фильтров, поиска, локальной агрегации и некоторых регулярных преобразований. Программа не обязана превращаться в нейросеть: ускоряемая операция может быть совершенно обычной обработкой записей.
В исследованной архитектуре UPMEM различаются большая локальная MRAM и небольшая рабочая WRAM; данные между ними переносятся явно. В этом контексте MRAM означает Main RAM и относится к DRAM, а не к магниторезистивной памяти с тем же сокращением. Название необходимо читать в документации конкретной системы. Важна и организация потоков: полезная параллельность определяется ресурсами ядра и характером доступа.
Близость к памяти не превращает небольшое ядро в полноценный серверный CPU. Сложная арифметика, поддерживаемые типы, размер рабочего набора и стоимость инструкций могут изменить баланс. Наилучший кандидат — участок, где локальная простая обработка заменяет большой внешний перенос, а обмен между локальными исполнителями остаётся небольшим. Проверять нужно именно такую структуру, а не только размер исходного файла.
5. Разделение данных важнее количества исполнителей
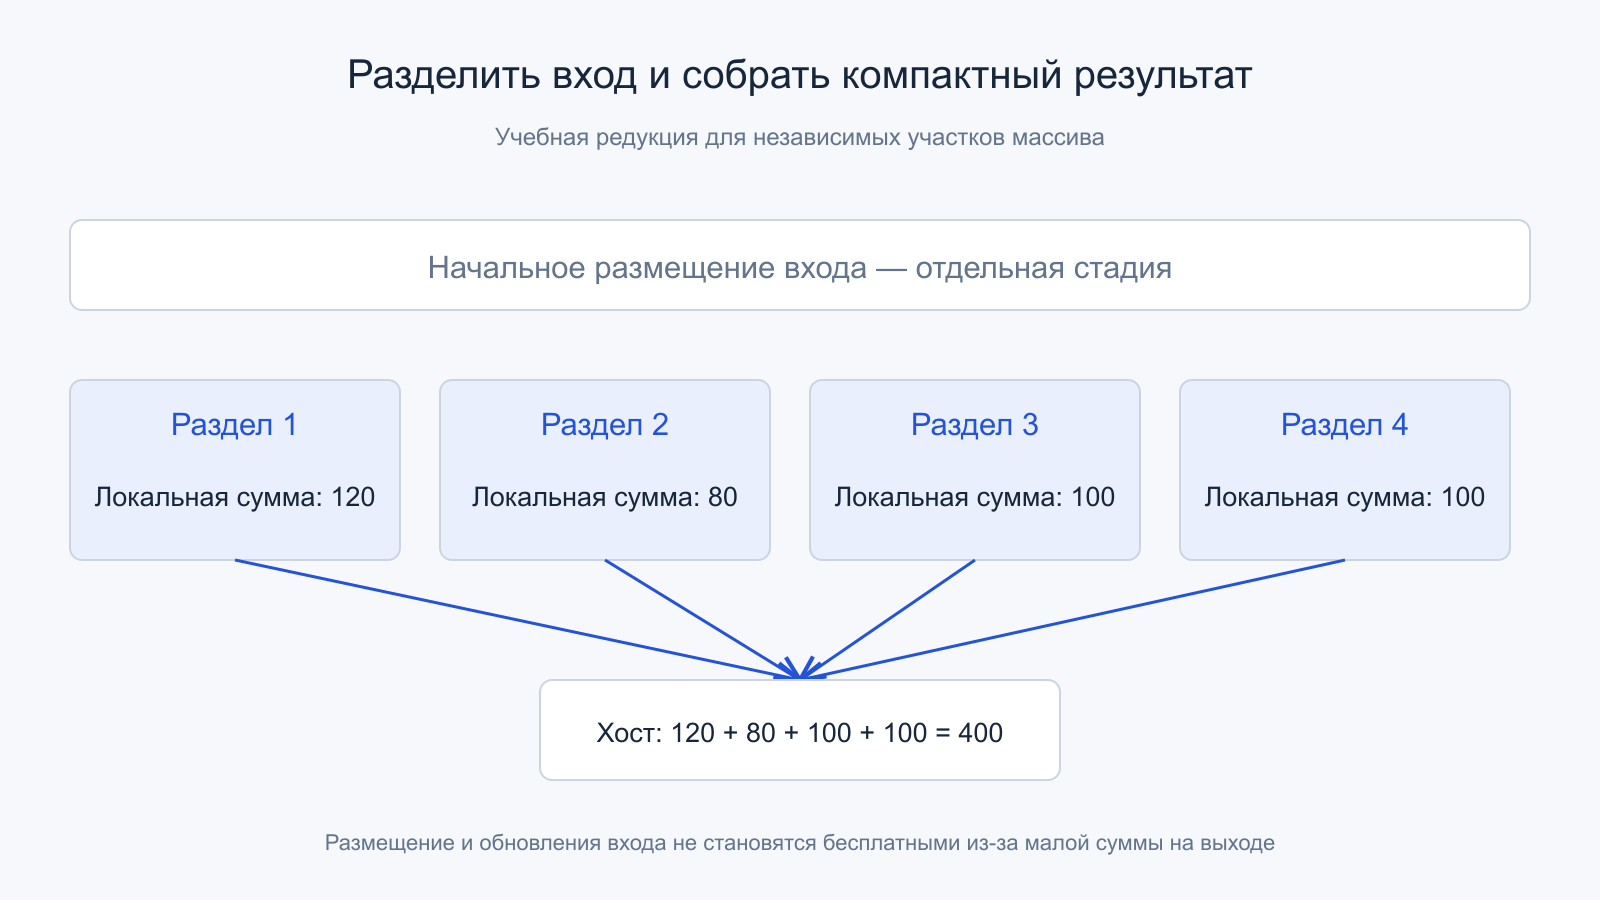
Представим четыре раздела таблицы с независимыми записями. Каждый локальный исполнитель считает свою сумму, после чего хост складывает четыре числа. Для учебного примера это 120 + 80 + 100 + 100 = 400. Наружу идут четыре частичных результата вместо полной таблицы. Такая декомпозиция сохраняет небольшой объём связи между участниками.
Теперь заменим сумму соединением двух таблиц по ключу. Если совпадающие ключи находятся в разных разделах, потребуются перераспределение, дополнительные проходы либо участие хоста. Локальная пропускная способность не отменяет стоимость shuffle. Аналогичная проблема возникает в графе, где соседние вершины разнесены между исполнителями.
До переноса алгоритма стоит определить владельца каждого блока, место промежуточных результатов и операцию окончательной сборки. Важно проверить перекос: один раздел может получить большую часть подходящих записей и задержать остальных. Равные размеры входа не гарантируют равную работу. Иногда выигрышнее изменить разбиение или сжать промежуточный результат, чем добавлять ещё вычислительных блоков к уже несбалансированной задаче.
6. Начальная загрузка: когда ускорение начинает окупаться
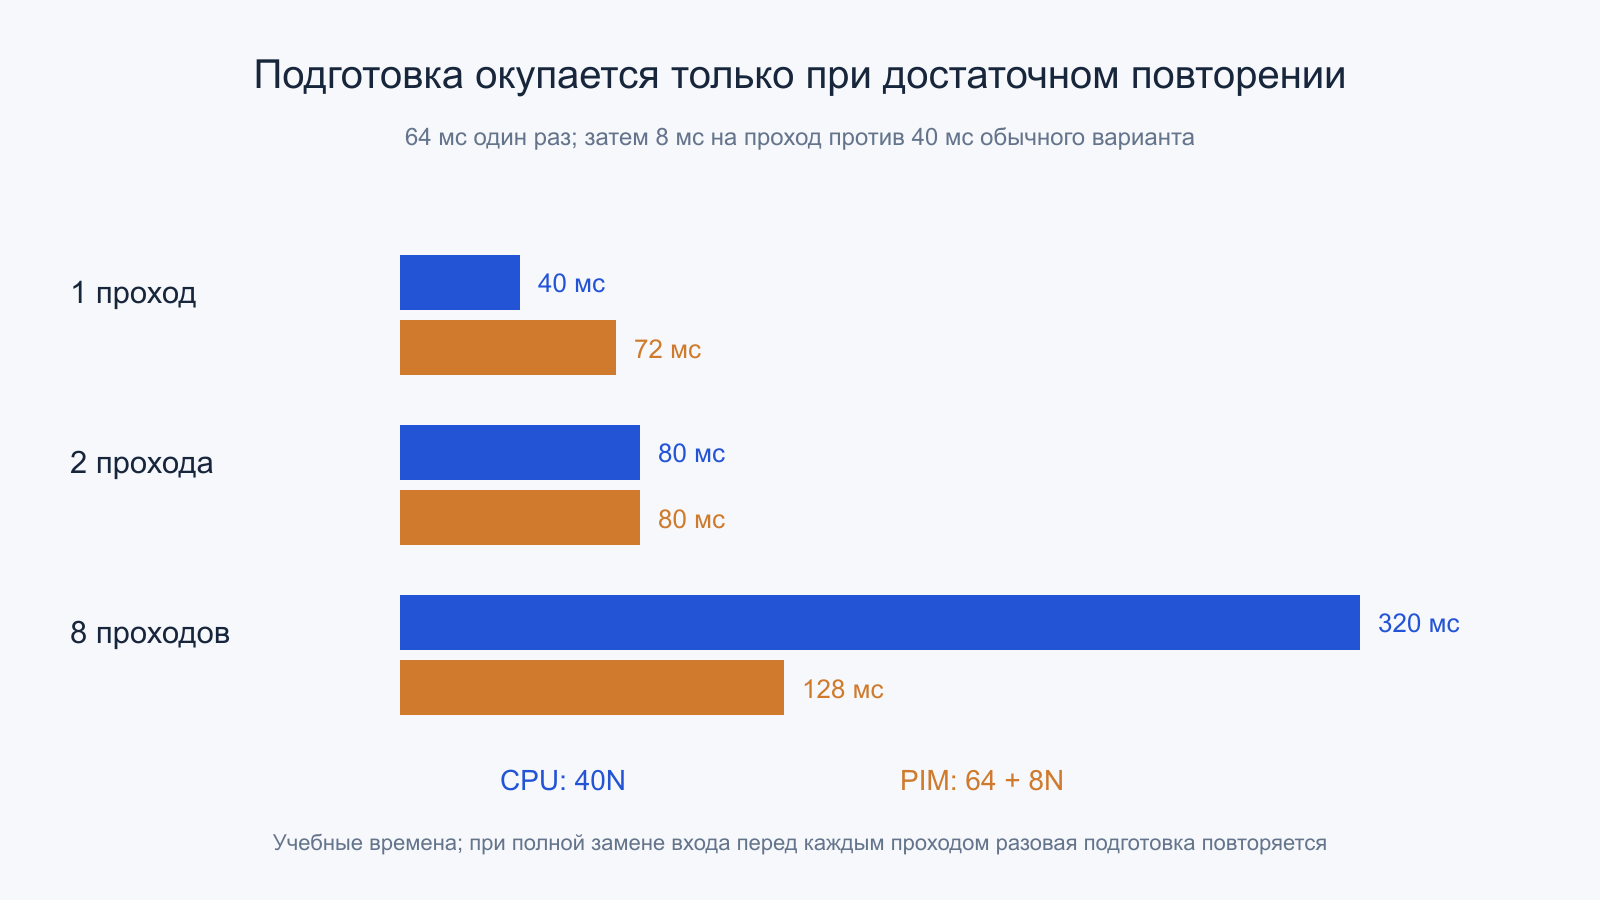
Пусть обычный вариант выполняет один проход за 40 мс. Условная PIM-система требует 64 мс подготовки и размещения данных, а последующий проход вместе с выдачей результата занимает 8 мс. Для N повторений полное время равно 40N и 64 + 8N мс соответственно. Это специально заданные величины, не паспортные параметры устройств.
При одном проходе получаем 40 против 72 мс: ускоряемый локальный участок не компенсировал подготовку. При двух проходах оба варианта занимают 80 мс. При восьми — 320 против 128 мс, то есть полное ускорение составляет 2,5 раза. Условие выигрыша: 32N > 64, следовательно, N > 2.
Если исходные данные полностью меняются перед каждым проходом, подготовка перестаёт быть разовым платежом. Тогда модель становится 72N, и прежний вывод исчезает. Если меняется малая часть массива, нужно отдельно оценить обновления и синхронизацию. Именно срок жизни локального набора, а не только скорость вычислителя, определяет экономику переноса.
7. Внутренняя полоса и размер возвращаемого результата
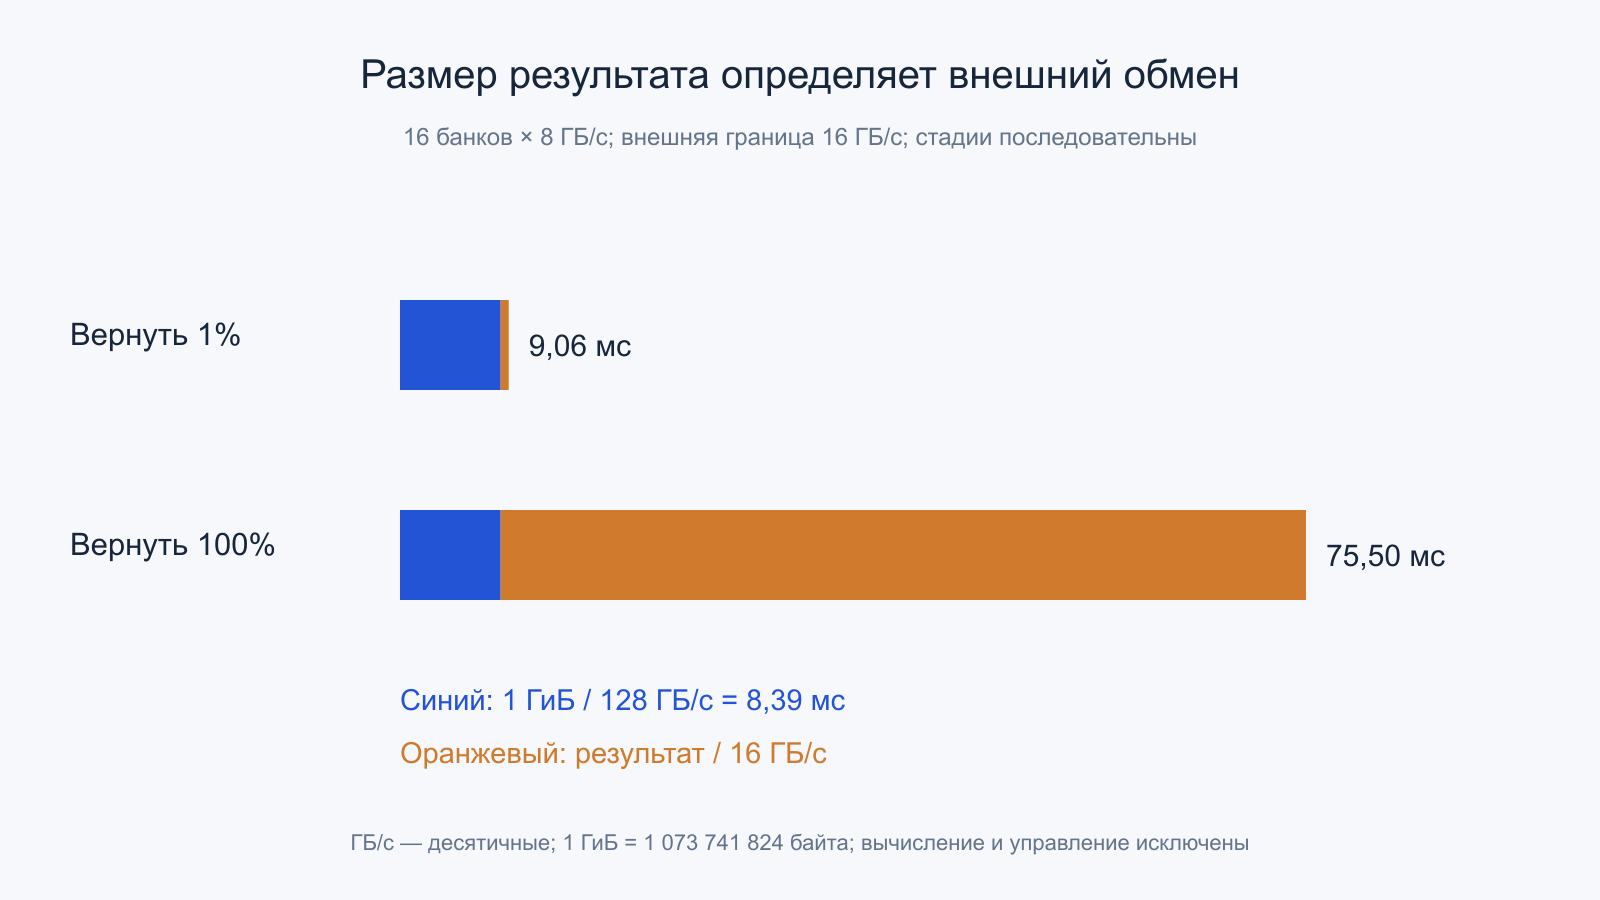
Возьмём другую идеализированную систему: 16 независимых банков дают по 8 ГБ/с, их суммарная внутренняя полоса равна 128 ГБ/с. Внешний канал ограничен 16 ГБ/с. Используем десятичные ГБ/с и вход размером 1 ГиБ, то есть 1 073 741 824 байта. Идеальный локальный проход занимает около 8,39 мс.
Если фильтр возвращает 1% входных байтов, передача результата занимает примерно 0,67 мс. При строго последовательном чтении и возврате получаем 9,06 мс, пока игнорируем арифметику и управление. Если вернуть весь вход, внешний перенос займёт 67,11 мс, а сумма увеличится до 75,50 мс. Чтение того же входа обычным хостом через заданную внешнюю границу само по себе занимает 67,11 мс.
Вывод относится к модели с указанными допущениями: малая селективность результата делает локальную фильтрацию привлекательной. Сумма полос банков достижима лишь при достаточной независимости и равномерной загрузке. Перекрытие стадий, служебный трафик, вычисления и конкуренция изменят время; прибавлять или исключать их следует явно, сохраняя одинаковую границу сравнения.
8. Аналоговый массив: от закона Ома к матрице
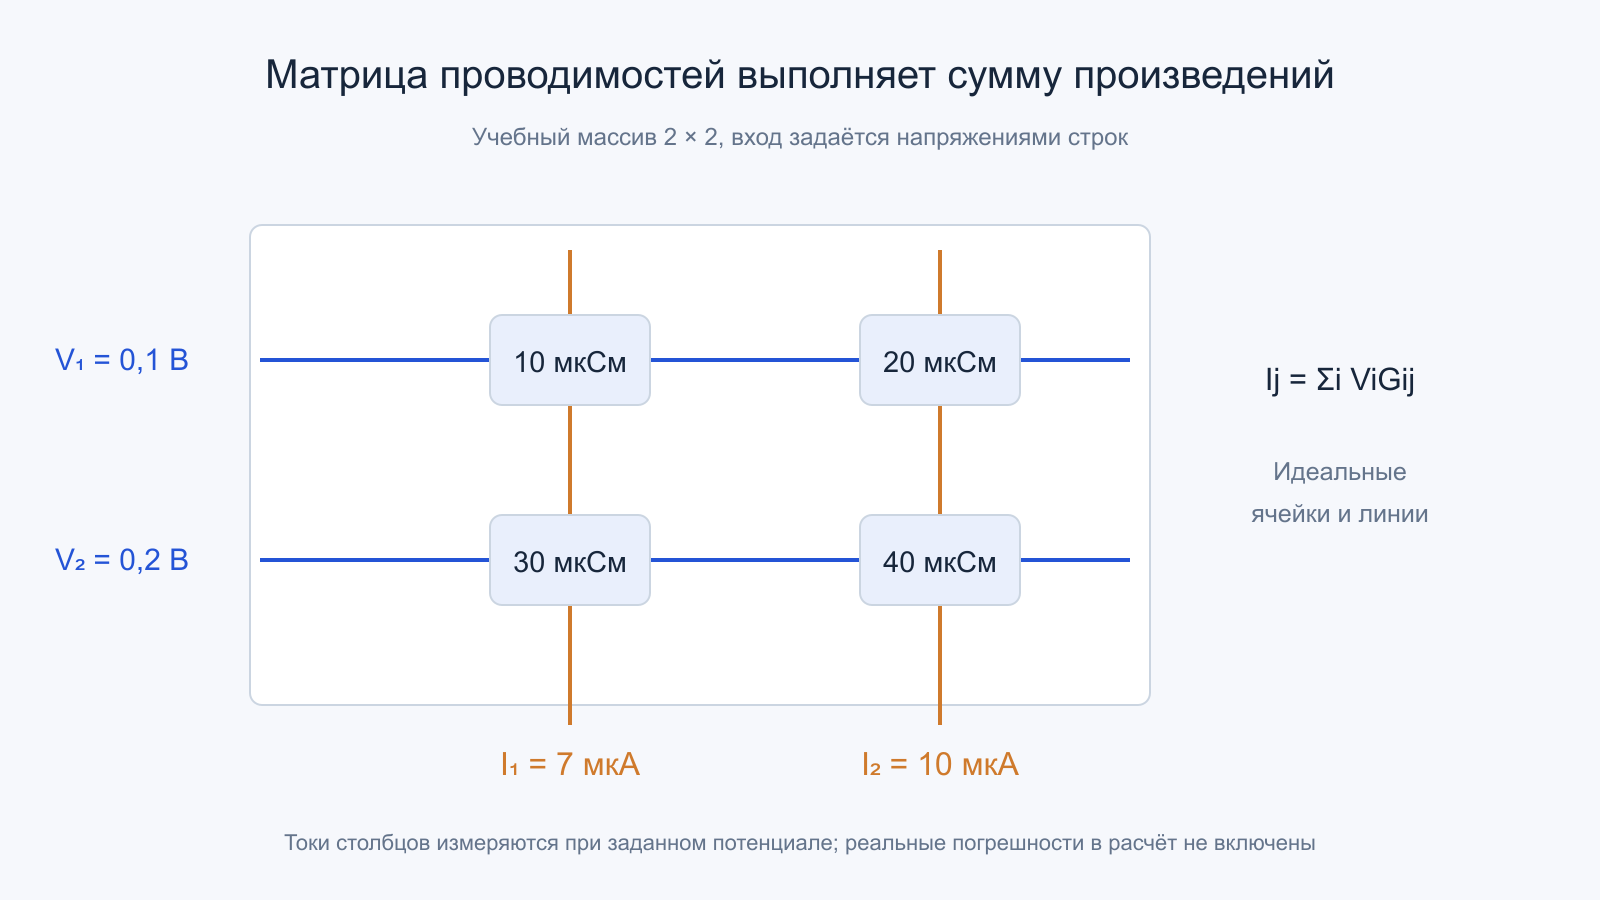
В идеальном перекрёстном массиве строкам задаются напряжения, а ячейкам — проводимости. Для столбца j ток равен Ij = Σi ViGij. Закон Ома даёт произведение в отдельной ячейке, а суммирование токов реализует накопление. Получается физическая модель умножения вектора на матрицу проводимостей.
Пусть матрица G содержит строки [10, 20] и [30, 40] мкСм, а входные напряжения равны 0,1 и 0,2 В. Тогда первый выход: 0,1 × 10 + 0,2 × 30 = 7 мкА. Второй: 0,1 × 20 + 0,2 × 40 = 10 мкА. Ориентация строк и столбцов здесь задана явно, чтобы избежать незаметного транспонирования.
Расчёт предполагает омические ячейки, идеальные провода и измерение столбцов с поддержанием нужного потенциала. Реальная схема добавляет сопротивление линий, ограничения напряжений и погрешности считывания. Отрицательную математическую величину нельзя получить «отрицательной проводимостью» пассивной ячейки: обычно нужна разностная либо другая специальная кодировка. Физический массив реализует определённое отображение чисел, а не произвольную точную арифметику.
9. Почему одновременно считать не означает бесплатно считать
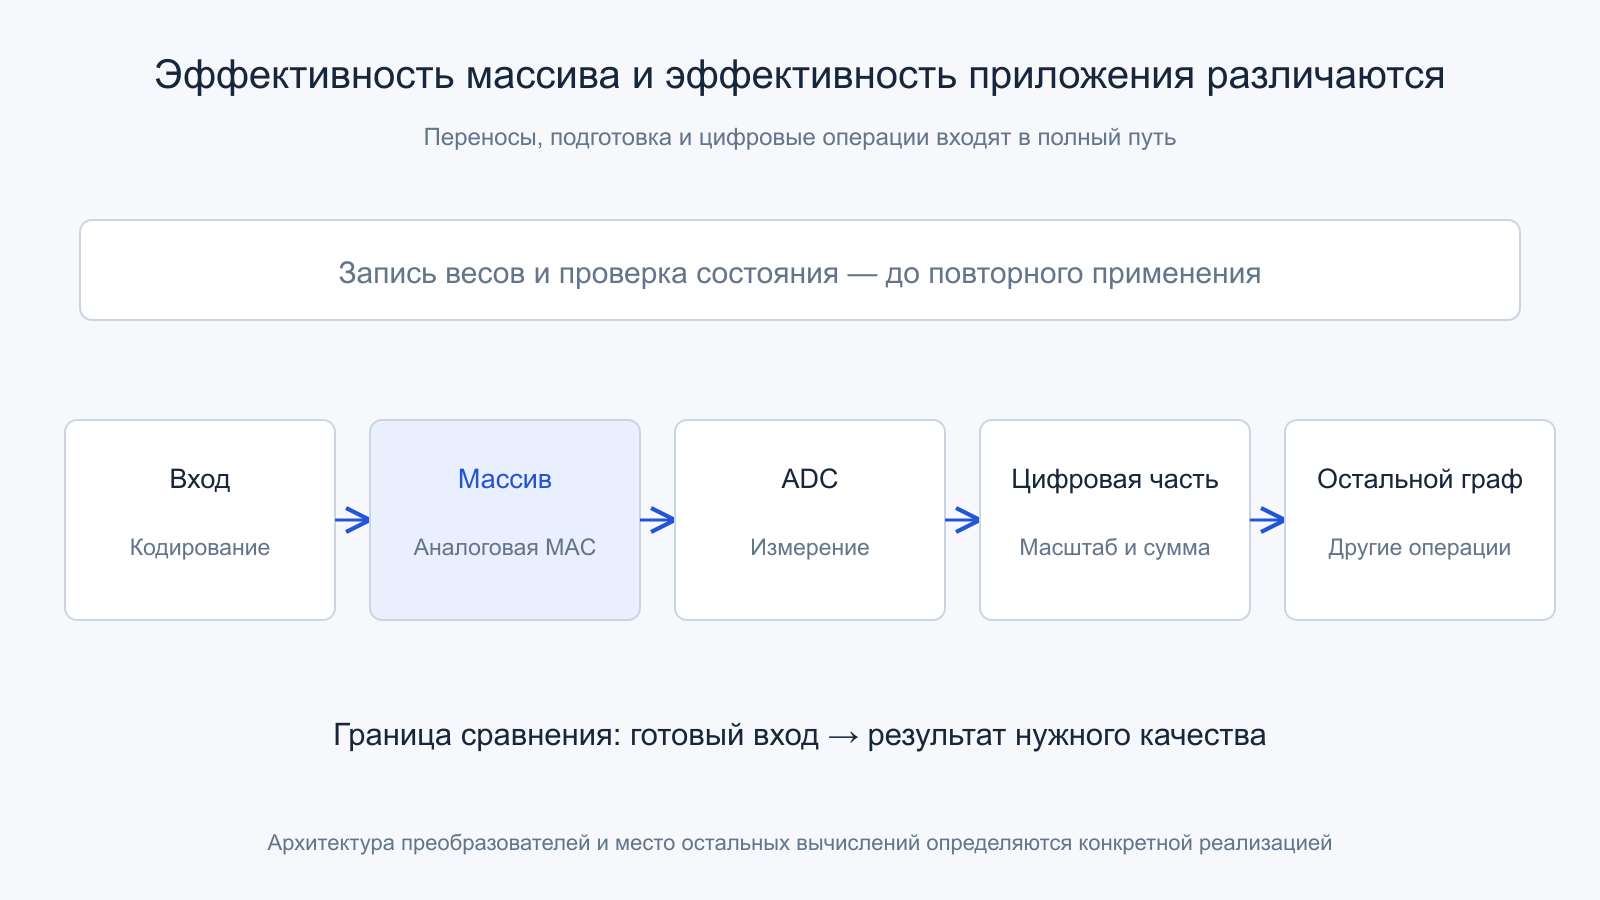
Внутри массива множество токовых вкладов действительно появляется параллельно. Но цифровому приложению нужны числа в определённом формате. Поэтому вокруг массива возникают кодирование входа, драйверы строк, измерение столбцов, аналого-цифровое преобразование, масштабирование и цифровое суммирование. Эти блоки занимают площадь и потребляют энергию.
Увеличивая массив, разработчик получает больше произведений за одно возбуждение, но одновременно усложняет доставку сигналов и считывание слабых вкладов на фоне больших. Если измеритель имеет ограниченный диапазон, крупная сумма может насыщаться. Если уменьшить сигналы, возрастает относительное влияние шума. Деление задачи на меньшие тайлы уменьшает некоторые физические проблемы, но увеличивает число частичных сумм и переносов.
Поэтому фотография плотного массива не раскрывает эффективность целой микросхемы. Следует смотреть на долю полезных ячеек, преобразователи, цифровую периферию и транспорт между тайлами. Одновременно важно знать, какой режим действительно измерен: одиночный матричный вектор, серия повторений с заранее записанными весами или полное приложение с подготовкой и выдачей результата.
10. Разбиение на разряды и скрытая цена точности
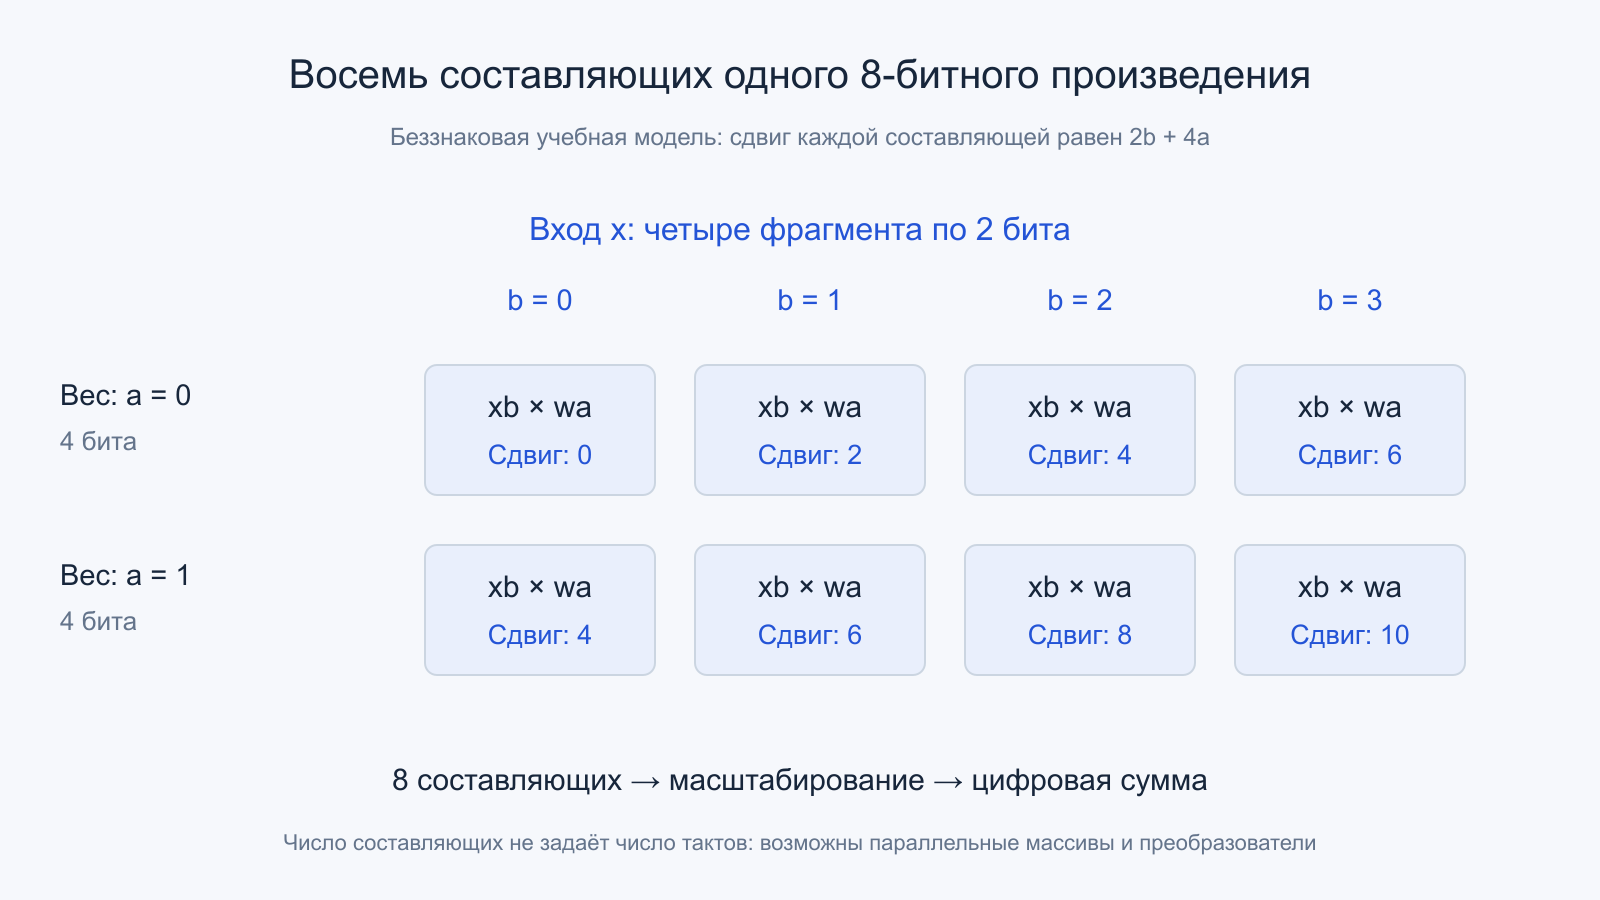
Допустим, вход — беззнаковое восьмибитное число, разделённое на четыре двухбитных фрагмента. Вес тоже восьмибитный, но разделён на два четырёхбитных фрагмента. Тогда x = Σb xb2^(2b), w = Σa wa2^(4a), а произведение содержит восемь составляющих xbwa2^(2b+4a). Здесь b принимает значения от 0 до 3, a — от 0 до 1.
Сдвиги первой группы равны 0, 2, 4 и 6 битам; второй — 4, 6, 8 и 10. Совпадение некоторых сдвигов не устраняет сами слагаемые. Их нужно правильно накопить в достаточной разрядности. Знаковые представления и насыщение требуют дополнительных правил, которых в этой беззнаковой модели нет.
Восемь составляющих не означают обязательно восемь последовательных тактов: часть массивов и преобразователей может работать параллельно. Но параллелизм требует ресурсов. Именно поэтому паспортная производительность без указания точности входа, весов, выхода и способа подсчёта операций плохо подходит для сравнения архитектур. Больше разрядов может менять одновременно время, площадь и энергию.
11. Квантование, шум и дрейф — разные ошибки
Квантование заменяет непрерывное значение ограниченным набором кодов. Для идеального шестибитного преобразователя имеется 64 кода, для восьмибитного — 256. В упрощённой равномерной модели с диапазоном 16 мкА шестибитный шаг составляет 0,25 мкА. При округлении без насыщения максимальная ошибка квантования внутри диапазона равна половине шага: 0,125 мкА.
Это не оценка всей погрешности реального тракта. Шум добавляет случайную составляющую, ошибка записи отклоняет проводимость от требуемой, нелинейность нарушает идеальную зависимость, а дрейф меняет состояние со временем. Эти эффекты могут зависеть от температуры, уровня сигнала и конкретной ячейки. Простое увеличение числа выходных битов не гарантирует соответствующей физической точности.
Полезно разделять точность отдельной операции и качество приложения. Нейросеть может сохранять метрику при заметных локальных отклонениях, но чувствительность различается между слоями и входными данными. Поэтому нужны измерения на целевой задаче, описание калибровки и проверка после времени хранения, а не только красивое совпадение одного матричного примера.
12. Запись весов, обучение и повторное использование
Устойчивые веса удобны для аналогового инференса: их можно записать и многократно применять к новым входам. Запись, однако, представляет собой отдельный процесс с подбором состояния и проверкой результата. Время подготовки необходимо учитывать, если модель часто меняется либо разные пользователи требуют разных наборов весов.
Обучение сложнее такого повторения. Оно требует вычисления градиентов, накопления обновлений, достаточной точности и согласованности промежуточных состояний. Если каждый шаг вызывает дорогую перезапись или значительные цифровые операции за пределами массива, преимущество одной матричной стадии может исчезнуть. Из успешного инференса нельзя автоматически выводить эффективность обучения той же сети.
Есть промежуточные сценарии: статичная базовая модель, отдельные адаптеры, периодическое обновление либо несколько заранее размещённых моделей. Для каждого нужно посчитать занимаемую ёмкость, переключение и сохранение состояния. Аппаратно ориентированное обучение может повысить устойчивость модели к ошибкам конкретного тракта, но его собственные затраты и зависимость от версии оборудования также входят в инженерную оценку.
13. Что доказала демонстрация ALBERT
Работа 2025 года с ALBERT особенно полезна тем, что описывает границы исполнения. Полносвязные слои использовали аналоговый чип, а вычисление attention, функции активации и ряд остальных стадий выполнялись программно. Это гибридная демонстрация модели с реальным аналоговым участком, а не утверждение, что весь трансформер работает внутри ячеек памяти.
В исследовании рассматриваются ошибки аппаратного отображения и компенсация дрейфа. Такие результаты показывают необходимость совместной настройки модели и аппаратуры. Они не превращаются в универсальный коэффициент ускорения любой языковой модели: меняются структура сети, размер, требуемая точность и доля оставшегося программного исполнения.
Читая подобную публикацию, полезно разнести три результата: удалось ли физически выполнить нужные операции, сохранилось ли качество на выбранном наборе задач и сколько стоит полный запуск. Хорошая точность отвечает на второй вопрос; она сама по себе не отвечает на третий. Значимая демонстрация может быть успешной именно как проверка архитектурной гипотезы, даже когда законченный серверный продукт ещё требует разработки.
14. Почему большая HBM ещё не становится PIM
HBM обеспечивает широкий интерфейс и близкое размещение памяти к ускорителю. Наличие логического базового кристалла создаёт место для управления и потенциальных функций, однако не означает автоматического появления доступного пользователю вычислительного ядра. Конкретные операции и способ их вызова должны быть заявлены и поддержаны системой.
Сходным образом расширитель памяти по CXL увеличивает варианты размещения данных, но не обязан обрабатывать их локально. Если процессор по-прежнему считывает весь массив через внешнее соединение, задача остаётся ограниченной этим путём. Добавление вычислений около такой памяти — отдельное архитектурное решение с собственным интерфейсом и программной поддержкой.
В инженерном описании стоит разделять три свойства: ёмкость, доступную полосу и возможность локального преобразования. Они могут сочетаться, но не следуют одно из другого. Устройство с меньшей ёмкостью иногда лучше подходит для локального фильтра, а большая общая память может оказаться удобнее для изменчивого набора данных и обычного программирования на CPU.
15. Температура, обновление DRAM и системная надёжность
Логика около памяти выделяет тепло там, где одновременно нужно сохранять корректное состояние ячеек. Для DRAM существенны режимы обновления и ограничения температуры; для аналогового массива важна стабильность характеристик хранения и считывания. Тепловой бюджет необходимо рассматривать вместе с доступной полосой, плотностью и режимом вычисления.
Даже корректное чтение цифровых битов не означает автоматически корректный итог локальной операции. Защита хранения, передача данных, вычислительный тракт и итоговое суммирование образуют разные участки. В зависимости от системы потребуются контрольные суммы, повторная обработка, проверка диапазонов и обнаружение ошибок исполнения. Нельзя предполагать, что обычный механизм ECC автоматически покрывает всю новую арифметику.
Для прикладного разработчика это превращается в вопросы о наблюдаемости: можно ли прочитать причину сбоя, повторить отдельный раздел, восстановить состояние и получить однозначный статус результата? Ускоритель, который быстро работает лишь до первой трудно диагностируемой ошибки, создаёт другую стоимость эксплуатации. Надёжность должна иметь такую же явную границу, как измеренная производительность.
16. Энергия: считать полезный результат на одинаковой границе
Уменьшение движения данных способно снизить энергию обмена, но питание системы включает много других составляющих. В аналоговом варианте это запись, драйверы, преобразователи и цифровая периферия; в цифровом — ядра, локальные переносы и синхронизация. Хост, сетевой обмен и охлаждение могут оставаться активными во всех случаях.
Если один вариант оценивается только по массиву, а другой — по всей серверной плате, сравнение несимметрично. Аналогично нельзя складывать измеренное потребление целого устройства с уже входящим в него компонентом. Нужно заранее установить границу: чип, плата, сервер либо сервис, а затем измерить одинаковый полезный результат с одинаковым требованием к качеству.
Практична метрика джоулей на обработанный запрос, дополненная задержкой и пропускной способностью. Следует указать простой, загрузку, длительность опыта и подготовку модели. Низкое мгновенное потребление при длительном исполнении может дать больше энергии, чем более мощный, но быстро завершающий работу вариант. Пиковые TOPS/W помогают описывать режим блока, но не заменяют такую проверку приложения.
17. Как выбрать первый алгоритм для переноса
Начать удобно с участка, который читает много данных, выполняет немного простой работы на элемент и выдаёт компактный результат. Нужно заранее проверить независимость разделов, размер рабочего набора и возможность удерживать вход локально между повторениями. Тогда потенциальная экономия видна ещё до сложной оптимизации.
Для цифрового PIM полезен небольшой эталон с тем же форматом записей и распределением ключей, что у реального приложения. Для аналогового массива — выделенная матричная стадия с реалистичными диапазонами входов и явным допуском по ошибке. Синтетический пример с равномерной нагрузкой стоит дополнить перекосом, редкими значениями и крайними размерами.
Параллельно нужен сильный обычный вариант: разумная укладка данных, векторизация, устранение лишних копий и подходящий размер пакета. Иначе сравнение вознаградит новую архитектуру за исправление программной ошибки в исходной реализации. После локального опыта следует вернуть участок в полный конвейер и проверить, не перенеслось ли ограничение в подготовку, обмен либо окончательную сборку.
18. Протокол проверки без рекламных сокращений
Зафиксируйте модель оборудования, прошивки, компилятора и библиотеки исполнения. Опишите набор данных, типы чисел, правила округления и критерий корректности. Отдельно измерьте размещение входа, запись состояния, локальную обработку, возврат результата и полный путь запроса. При возможности перекрытия стадий измеряйте реальный конвейер, а не сумму взаимоисключающих максимумов.
Покажите результаты для холодного запуска и устойчивой серии, нескольких размеров и разной доли возвращаемых данных. Сравните медиану с хвостовой задержкой и повторите опыт после прогрева. Для аналоговой схемы добавьте повторную оценку качества после выдержки и калибровки. Все изменения программного эталона должны быть отражены, чтобы сохранялась одинаковая задача.
Наконец, обозначьте условия отказа от переноса: слишком частые обновления, большой промежуточный обмен, неподдерживаемые операции или недопустимая потеря качества. Такой результат тоже полезен. Он превращает PIM из общего обещания в инструмент с понятной областью применения и позволяет выбрать дальнейшую оптимизацию по измеренному ограничению, а не по названию технологии.
19. Где проходит настоящая граница преимущества
У вычислений в памяти нет единственного универсального противника. Цифровые локальные ядра конкурируют с оптимизированной обработкой данных и ценой их размещения. Аналоговые массивы конкурируют с эффективной цифровой матричной арифметикой при заданной точности. В обоих случаях важно, сколько дорогого обмена исчезает и какую дополнительную работу приходится ввести.
Наиболее убедительный проект начинается с конкретного потока данных и заканчивается воспроизводимым результатом приложения. Между ними находятся разбиение, программирование, преобразователи, калибровка, тепло и восстановление после ошибок. Эти детали не уменьшают привлекательность идеи: именно они объясняют, почему одна демонстрация удачна, а механический перенос похожей программы не приносит пользы.
Поэтому главный вопрос к очередному «интеллектуальному модулю памяти» звучит предметно: что он считает локально, какие байты перестают пересекать внешнюю границу и сколько времени, энергии и точности стоит полный результат? Если ответы содержат конкретную конфигурацию и проверяемые условия, перед нами инженерная технология, которую уже можно осмысленно сравнивать и развивать.
20. Первичные источники и границы материала
Источники ниже относятся к разным реализациям и годам. Экспериментальная платформа UPMEM не приравнивается к AiMX или аналоговому чипу IBM. Исторические исследования приведены для объяснения механизмов; демонстрационные системы не объявляются массовыми потребительскими устройствами. Числа из учебных примеров не характеризуют перечисленные продукты.
- UPMEM: экспериментальное исследование реальной PIM-архитектуры, версия 2022 года
- Samsung: интеграция HBM-PIM и архитектура AXDIMM, 2021 год
- SK hynix: показ AiM, AiMX и сервера на AI Infra Summit 2026
- IBM Research: смешанная архитектура с 64 аналоговыми тайлами, 2023 год
- IBM Research / Nature: отдельный 34-тайловый чип для распознавания речи, 2023 год
- IBM Research / Nature Communications: демонстрация ALBERT на аналоговом чипе, 2025 год
- Полный текст исследования ALBERT: распределение аналоговых и программных вычислений