FPGA изнутри: LUT, триггеры, память, DSP и аппаратный конвейер
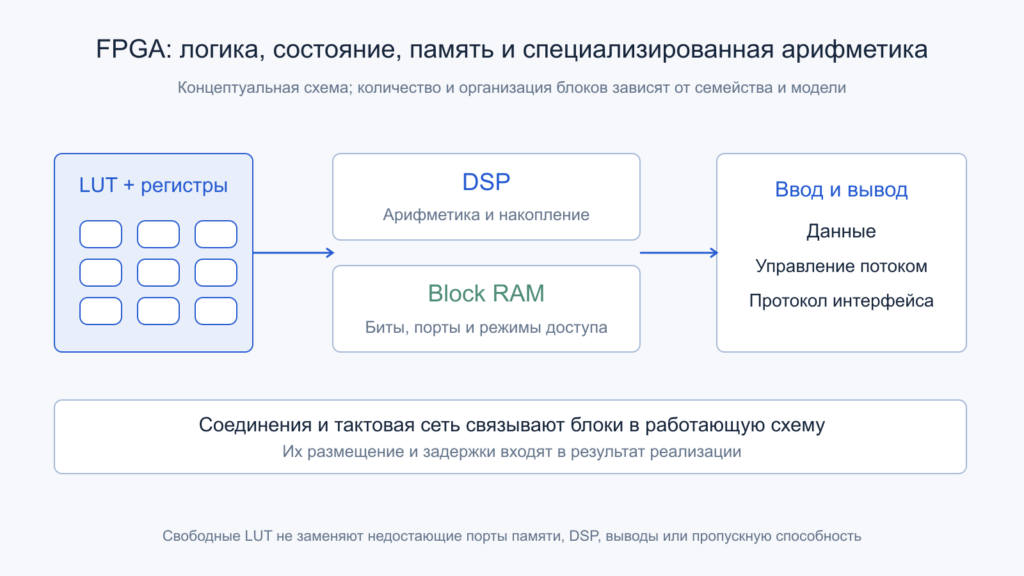
Концептуальная схема показывает согласованную работу разных ресурсов. Их число и организация определяются семейством и моделью FPGA. Открыть иллюстрацию в полном размере.
Ускоритель на FPGA способен принимать новый отсчёт на каждом такте, хотя отдельный результат проходит несколько стадий. При этом схема с небольшим количеством занятых LUT иногда не достигает нужной частоты, а проект с большим числом умножителей упирается в порты памяти. Чтобы объяснить такие ситуации, полезно рассмотреть FPGA как настраиваемую аппаратную систему: логические функции, состояние, соединения, память и арифметические блоки должны работать согласованно.
Ниже разбираются общие принципы с примерами из документации отдельных семейств. Числа в расчётах заданы для обучения, не являются характеристиками выбранной платы и не описывают испытания оборудования владельца сайта. Возможности разных FPGA не складываются в одно вымышленное устройство.
Содержание статьи
- Конфигурация задаёт схему, а не очередную команду CPU
- LUT хранит таблицу маленькой логической функции
- Регистры отделяют текущее состояние от комбинационного пути
- Соединения занимают место и время
- Разрядность меняет и точность, и размер схемы
- DSP-блок не является произвольным количеством бесплатных умножений
- У встроенной памяти есть порты и правила столкновений
- Банки памяти меняют предел параллельного чтения
- Конвейер имеет задержку и интервал запуска
- Частоту ограничивает самый трудный корректно заданный путь
- Hold и тактовые отношения нельзя исправить одним снижением частоты
- Между тактовыми доменами нужен протокол
- HLS переводит алгоритм в расписание аппаратных ресурсов
- Внешний интерфейс способен ограничить готовый конвейер
- Конфигурация и начальное состояние входят в устройство
- Сводка ресурсов показывает несколько самостоятельных ограничений
- Мощность зависит от переключений и движения данных
- Проверка результата требует нескольких разных доказательств
- Официальные первичные источники
- Читайте также
Конфигурация задаёт схему, а не очередную команду CPU
Обычный процессор последовательно получает инструкции и выполняет их предусмотренными исполнительными средствами. В программируемой логике конфигурация задаёт функции и соединения большого набора аппаратных ресурсов. После настройки несколько участков схемы могут одновременно реагировать на свои входы. Для такой работы не обязательно заново выбирать и декодировать инструкцию на каждое простое преобразование.
Это не означает, что внутри FPGA запрещены процессоры или управляющие автоматы. Существуют встроенные жёсткие CPU, программно описанные soft-core и специализированные контроллеры. Они могут управлять потоковым трактом, который выполняется отдельной логикой. Поэтому название платы FPGA ещё не сообщает, какая часть задачи реализована аппаратным конвейером, а какая исполняется программой.
Описание на HDL или языке высокого уровня проходит преобразования до конкретных элементов и связей. Конечный результат зависит от ограничений, синтеза, размещения и трассировки. Похожий исходный алгоритм способен породить разные схемы с различными затратами. Важен реализованный тракт, а не только число строк описания или знакомое имя математической операции.
LUT хранит таблицу маленькой логической функции
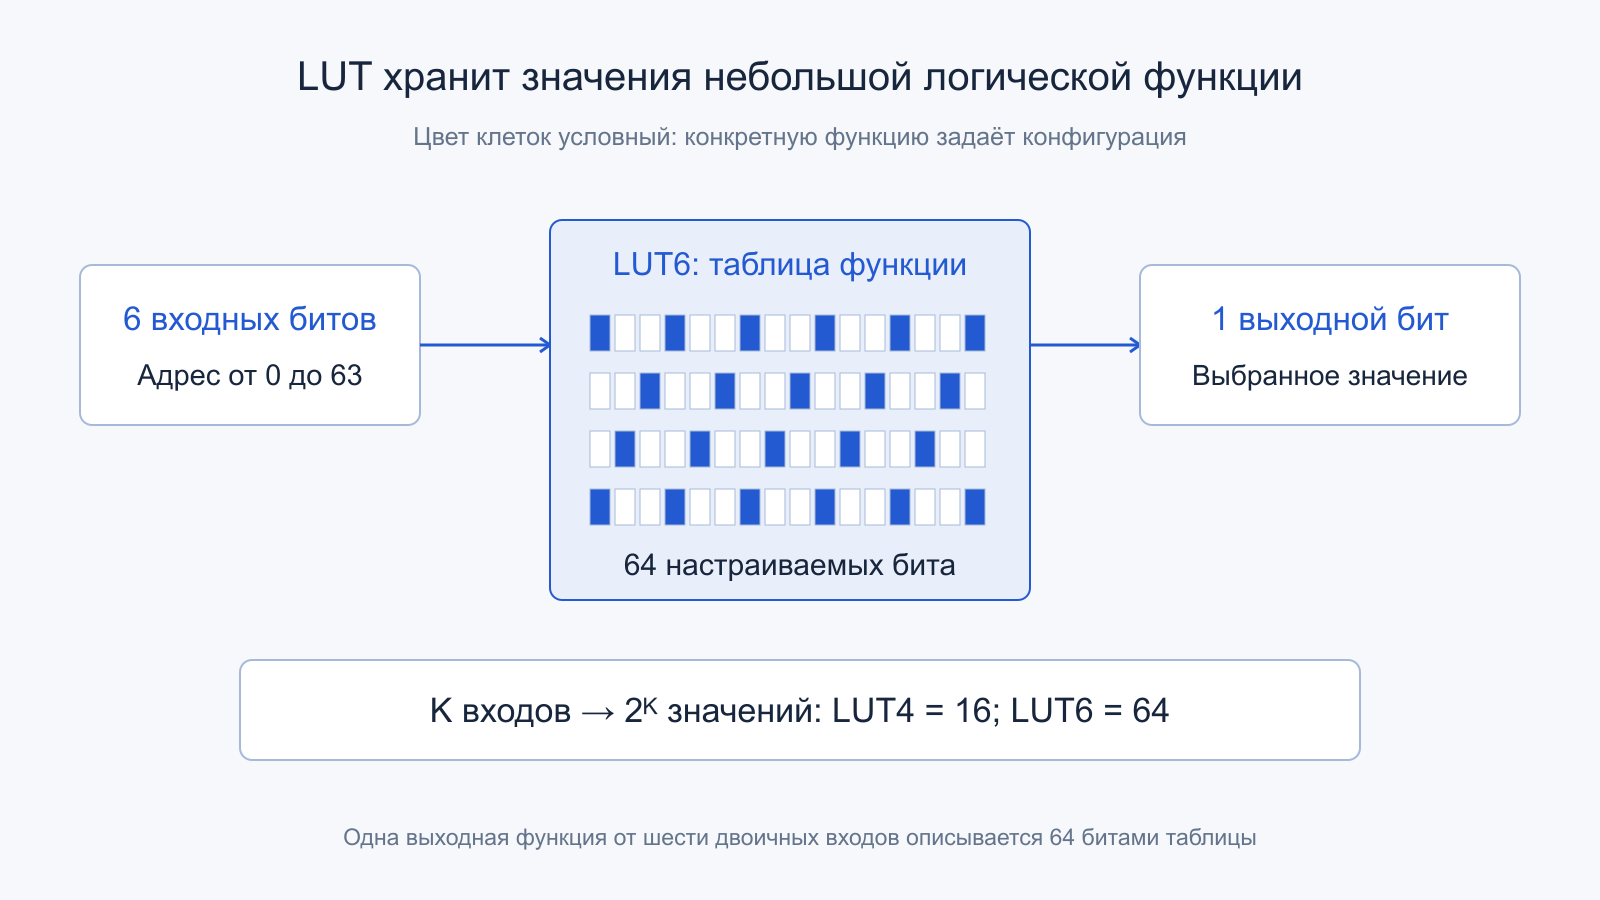
В учебной модели LUT с K входами реализует однобитную булеву функцию через таблицу из 2ᴷ результатов. Входной набор выбирает соответствующий бит таблицы. Для четырёх входов требуется 16 значений, для шести — 64. Содержимое задаётся конфигурацией, поэтому один и тот же тип ресурса способен реализовать разные функции без изменения топологии самого кристалла.
Это объяснение не следует путать с оперативной памятью программы. В данном использовании LUT обслуживает комбинационное преобразование сигналов. Некоторые физические ресурсы поддерживают также режимы распределённой RAM или сдвигового регистра, но такие возможности принадлежат определённым элементам и конфигурациям. Нельзя считать, что любая свободная LUT во всяком FPGA обязательно доступна для всех этих назначений.
AMD UG574 показывает конкретную организацию UltraScale: LUT, элементы хранения, цепи переноса и дополнительные мультиплексоры. Другой пример — описание Intel ALM. Архитектурные блоки имеют собственные режимы упаковки; названия ресурсов разных семейств нельзя превращать в равное количество абстрактных вентилей одним постоянным коэффициентом.
Регистры отделяют текущее состояние от комбинационного пути
Комбинационная логика формирует выходы из текущих входов, а триггер сохраняет состояние по предусмотренному событию такта. Последовательная схема сочетает оба механизма: значение запускается из регистра, проходит логику и фиксируется другим регистром. Такой путь даёт удобную границу анализа времени. У сигналов управления и данных при этом должны совпадать смысл и нужная стадия.
Если арифметический результат задержан на несколько тактов, сопровождающий признак действительности тоже нужно провести через соответствующее число стадий либо согласовать протоколом. Иначе схема может выдавать правильные числа с неправильными метками. Это функциональная ошибка, которую не устраняет высокая частота. Аналогично сброс, разрешение записи и остановка конвейера являются частью аппаратного поведения.
Не всякое сохранение в описании означает отдельный внешний регистр рядом с LUT. Инструмент может использовать внутренний регистр DSP, памяти или другого блока, если это сохраняет нужную семантику. Поэтому окончательный отчёт важнее буквального рисунка исходного описания. Перенос регистра через логику, retiming, также требует соблюдения условий, а не является произвольным изменением задержек интерфейса.
Соединения занимают место и время
Между ресурсами находится программируемая сеть соединений. Она позволяет составлять разные схемы, но имеет конечные каналы и собственную задержку. Логически соседние операции могут оказаться физически далеко. Сигнал с большим числом потребителей предъявляет дополнительные требования к распределению. Поэтому два проекта с одинаковым числом LUT не обязаны иметь одинаковый временной результат.
Специализированные локальные соединения помогают там, где структура задачи совпадает с их назначением. Цепи переноса удобны для арифметики, каскады DSP — для определённых последовательностей, а выделенная тактовая сеть — для распределения такта. Перенос любого сигнала на произвольную общую трассу не сохраняет автоматически эти преимущества. Архитектурный путь нужно выбирать вместе с размещением.
Высокая заполненность кристалла может усложнить трассировку даже тогда, когда формально осталось некоторое количество отдельных ресурсов. Свободные элементы должны находиться в подходящих местах и иметь доступные соединения, питание и интерфейсы. Процент использования полезен как индикатор, но не заменяет проверку физической реализуемости. Это одна из причин, почему ресурсная оценка до размещения остаётся предварительной.
Разрядность меняет и точность, и размер схемы
В CPU ширина аппаратного целого часто уже задана набором команд. В FPGA проектировщик может описать тракт подходящей ширины, если инструменты и ресурсы это поддерживают. Более узкие значения способны уменьшить количество логики, регистров и соединений. Но уменьшение числа бит одновременно меняет диапазон и поведение округления, поэтому оно должно следовать из требований задачи.
Два знаковых 16-битных числа требуют до 32 бит для полного произведения. Для суммы восьми таких произведений консервативный запас составляет 35 знаковых бит. Например, восемь произведений минимальных входных значений дают 8×32768² = 8 589 934 592, то есть 2³³. Максимум знакового 34-битного числа на единицу меньше; при таком предельном случае 34 бит недостаточно.
После накопления может потребоваться сдвиг, округление и насыщение до выходного формата. Простое отбрасывание старших или младших разрядов реализует другую операцию и может быть допустимо только по договорённости. Проверка обычного сигнала небольшой амплитуды не выявляет все проблемы диапазона. Нужны предельные значения, отрицательные числа и предусмотренный режим обработки переполнения.
DSP-блок не является произвольным количеством бесплатных умножений
Выделенные арифметические блоки содержат определённые умножители, сумматоры, регистры и пути каскадирования. Они обычно эффективнее общей логики для подходящих операций. Однако допустимые ширины, режимы и набор одновременно используемых функций ограничены. Справочник DSP48E2 отдельно описывает порты, режимы и внутренние регистры конкретного примитива.
Большое умножение способно потребовать нескольких DSP, а небольшое иногда удаётся иначе упаковать или реализовать общей логикой. Нельзя по одному числу DSP в характеристиках получить точную производительность любого выражения. Следует знать тип операции, ширину, наличие накопления и выбранный инструментом вариант. Также нужно обеспечить поступление операндов с нужным темпом.
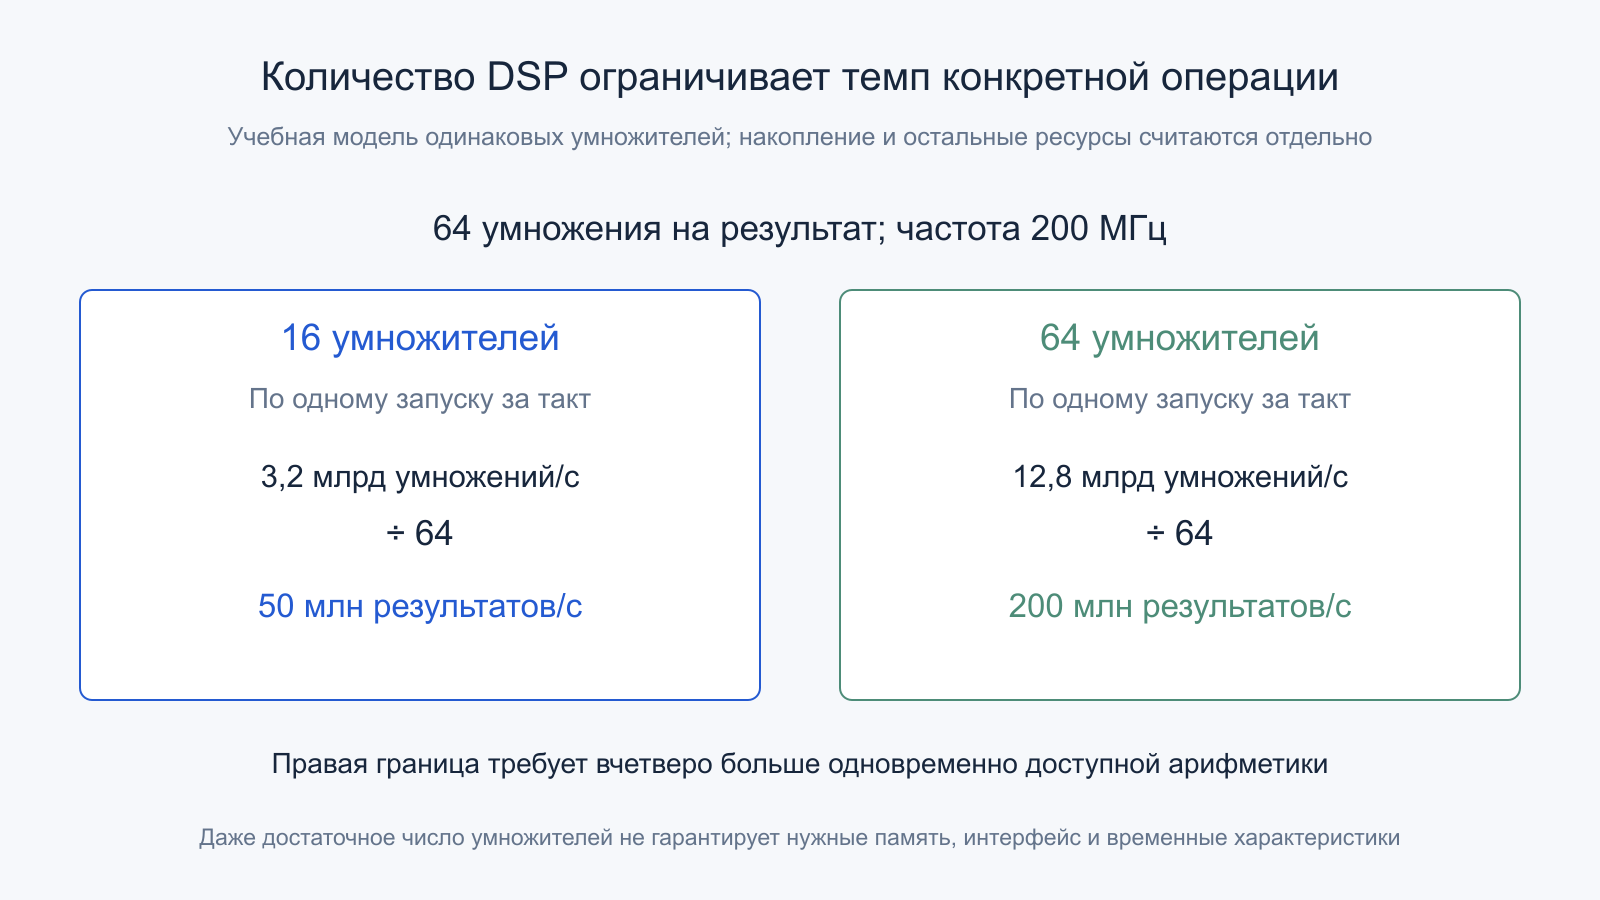
Учебный фильтр выполняет 64 умножения на один результат. Если доступны 16 одинаковых умножителей, каждый начинает одну операцию за такт при 200 МГц, их общий идеальный темп — 3,2 миллиарда умножений в секунду. Это не более 50 миллионов результатов в секунду при заданных 64 умножениях. Для 200 миллионов результатов потребовалось бы 12,8 миллиарда умножений в секунду либо изменение алгоритма.
У встроенной памяти есть порты и правила столкновений
Блок RAM — не просто запас битов. Он имеет допустимые формы организации, число портов, задержку чтения и правила чтения при одновременной записи. Для выбранной конфигурации один порт может обслуживать один предусмотренный доступ за такт. Понятие dual-port не означает произвольное количество чтений и записей одновременно. Реальный контракт задаётся документацией блока.
Когда порты обращаются к одной области, результат зависит от сочетания операций и тактов. В AMD UG573 отдельно разобраны столкновения адресов. Чтение и запись не обязаны всегда возвращать именно старое или именно новое значение. Перенос случайного поведения симулятора в аппаратный проект без проверки режима способен скрыть ошибку.
Кроме block RAM существуют распределённая память, регистровые массивы и более крупные специализированные ресурсы отдельных семейств. Один и тот же исходный массив может отображаться по-разному в зависимости от размера и способа доступа. Число бит не описывает стоимость многопортовости: для дополнительных чтений иногда нужно размножать данные или менять архитектуру хранения.
Банки памяти меняют предел параллельного чтения
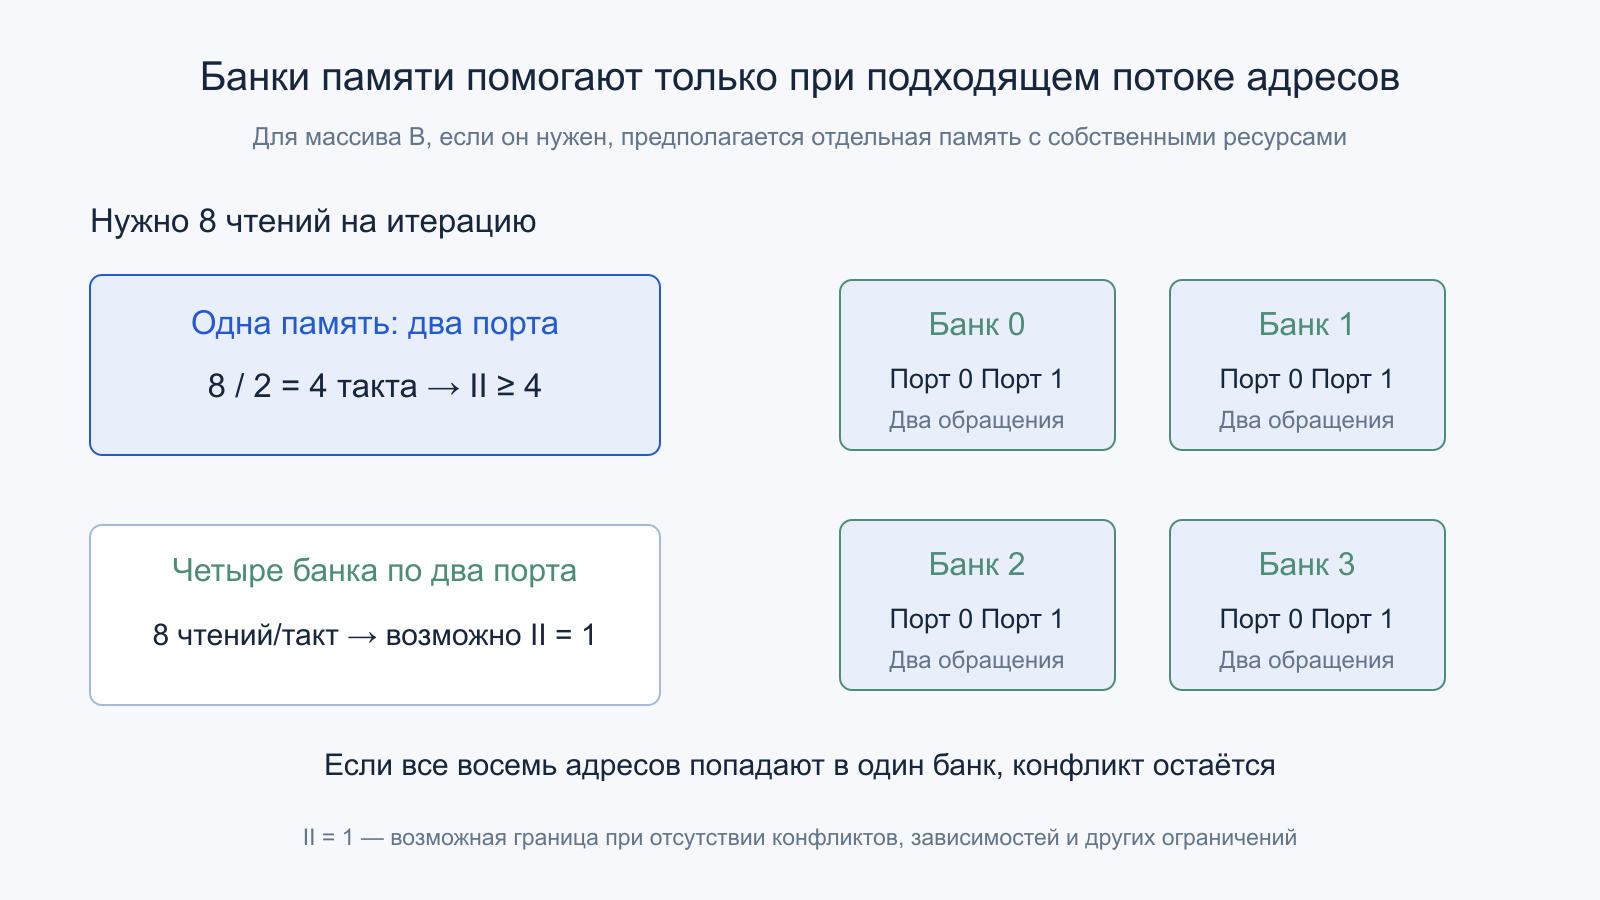
Пусть одна итерация требует восемь чтений из массива A, а его учебная память предоставляет два чтения за такт. Даже при мгновенной арифметике потребуется не менее четырёх тактов обслуживания этих чтений на итерацию. При большом потоке это создаёт нижнюю оценку II≥4. Если массив B имеет такое же независимое требование и собственные два порта, его ограничение аналогично.
Разделение A на четыре независимых банка с двумя портами потенциально даёт восемь чтений за такт. Но только если адреса распределены так, что каждому банку хватает своих портов. Восемь запросов в один банк по-прежнему конфликтуют. Потребуются подходящее отображение адресов, доступные блоки и остальная инфраструктура. Увеличение количества банков не гарантирует нужного II без анализа шаблона доступа.
Репликация решает иную задачу: несколько копий одного содержимого обслуживают разные чтения. Для изменяемых данных нужно согласовывать обновления копий. Разбиение, репликация и преобразование формата имеют различные расходы памяти и управления. Поэтому разумно начинать с расписания обращений, а затем выбирать физическую организацию, вместо добавления ресурсов без понимания причины конфликта.
Конвейер имеет задержку и интервал запуска
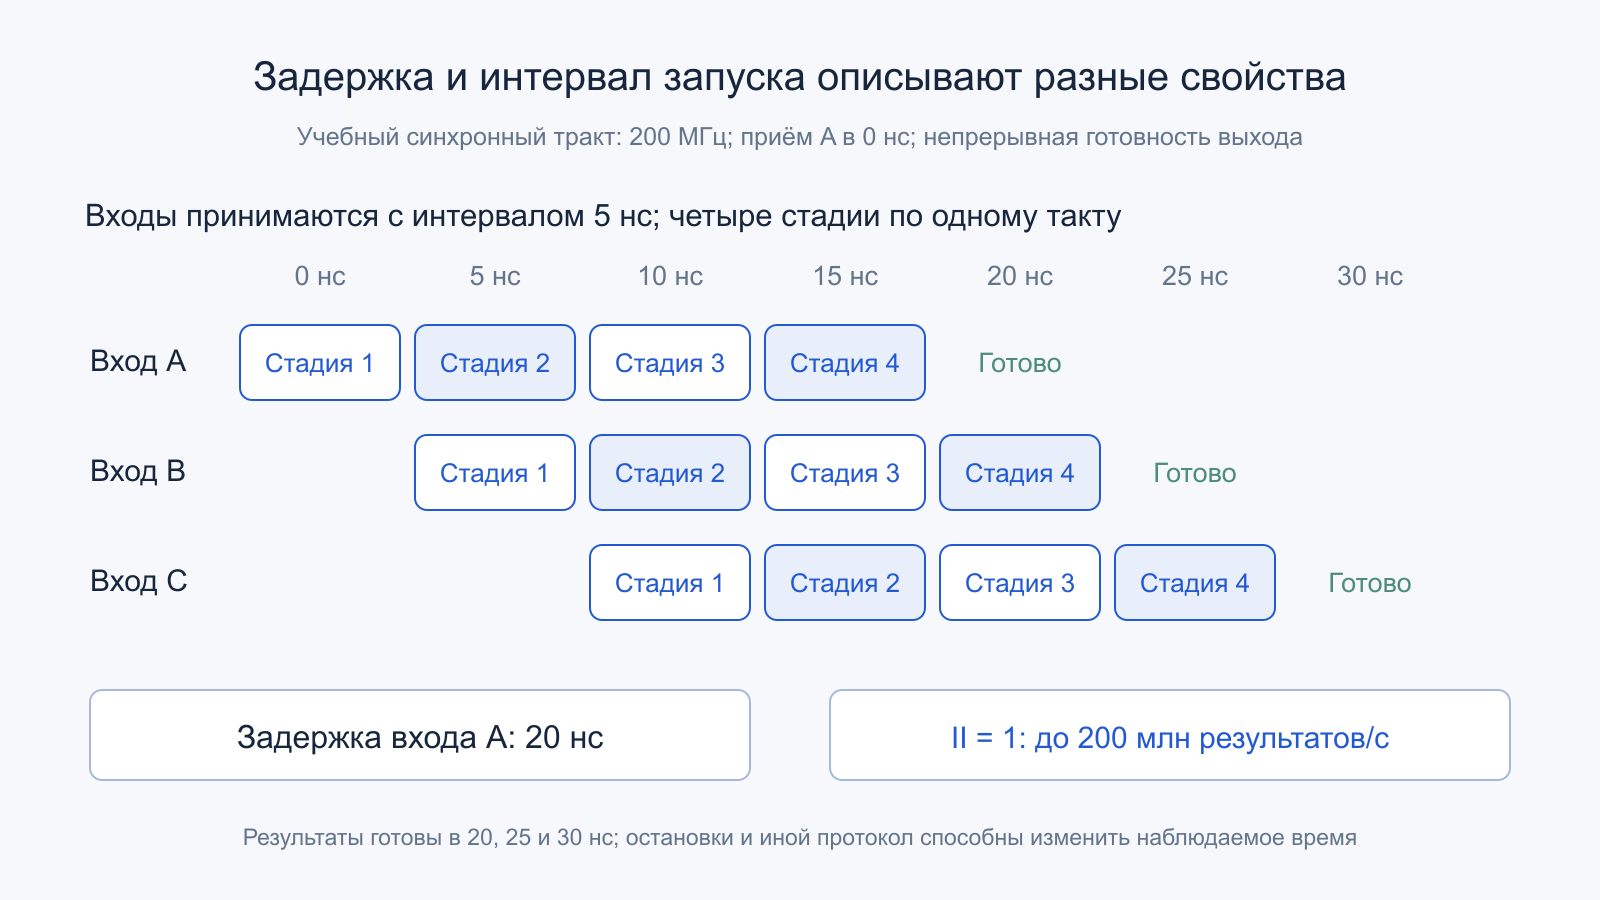
Задержка показывает, сколько тактов проходит от принятия входа до соответствующего выхода. Интервал запуска, initiation interval или II, показывает, как часто можно принимать следующий независимый вход. В учебном четырёхстадийном тракте при 200 МГц такт равен 5 нс, задержка составляет 20 нс. При II=1 после заполнения возможен один новый результат каждые 5 нс.
Это соответствует 200 миллионам результатов в секунду, но не означает получение отдельного результата за 5 нс от его входа. При другой заданной организации с II=4 предельный темп при той же частоте был бы 50 миллионов результатов. Задержку такой организации нужно узнать отдельно. Число стадий, интервал и частота являются связанными, но самостоятельными характеристиками.
Документация Vitis HLS определяет II через возможность принимать новые входы и отмечает, что запрошенный интервал может оказаться недостижимым. Зависимости, порты памяти и разделяемые ресурсы способны увеличить фактическое значение. Директива проектировщика задаёт цель преобразования, а не отменяет эти аппаратные ограничения.
Частоту ограничивает самый трудный корректно заданный путь
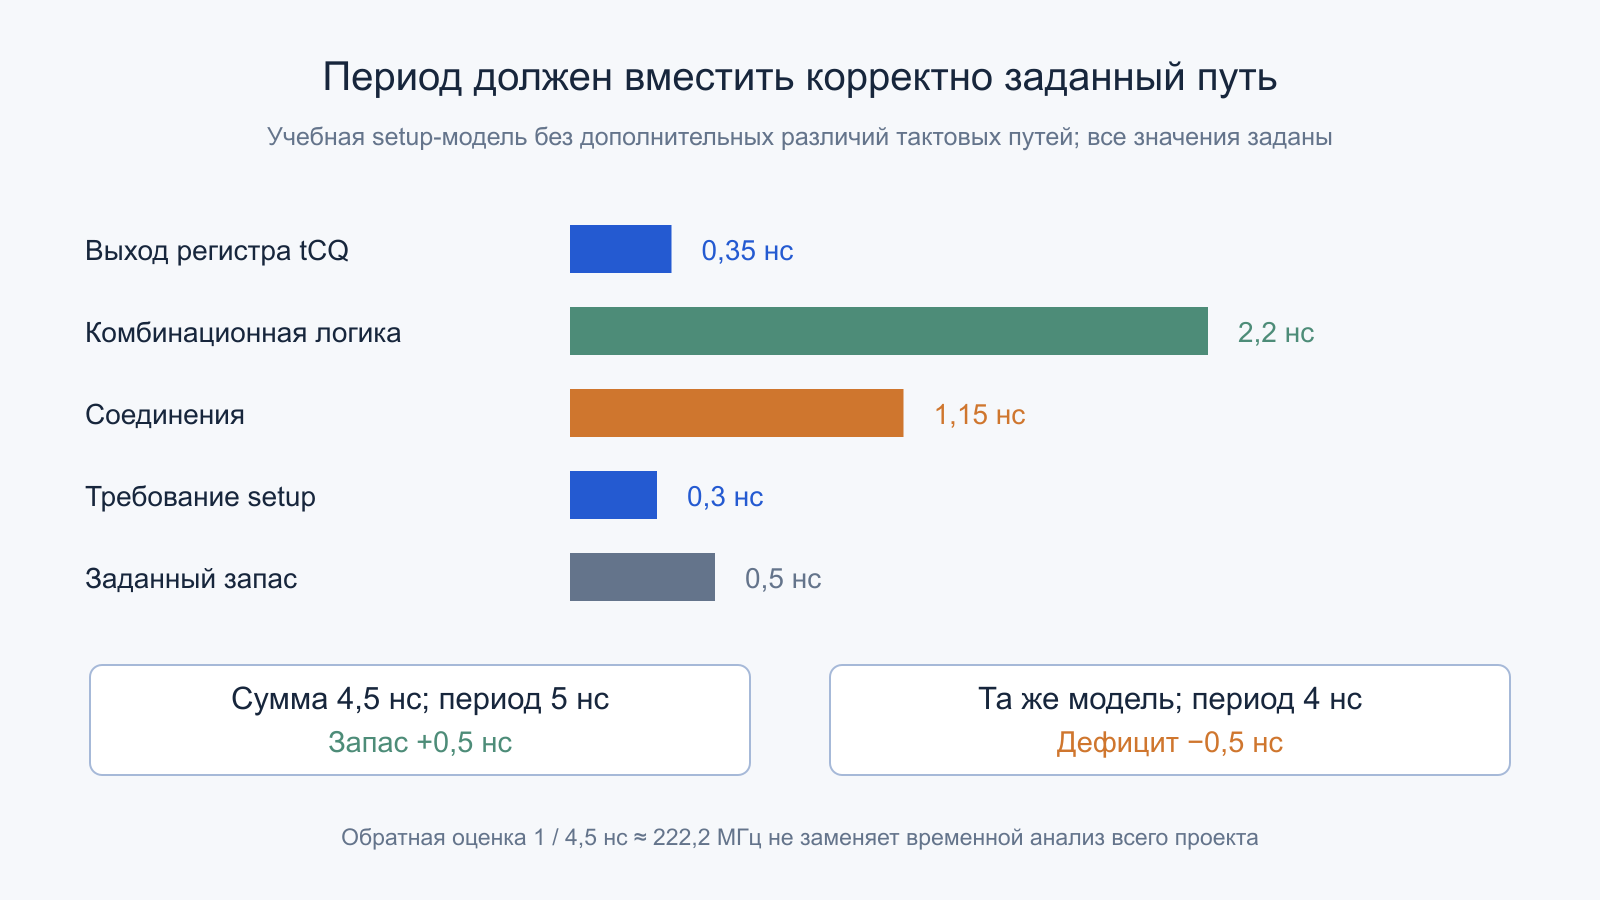
Для простого синхронного пути учитываются задержка выхода исходного регистра, комбинационная логика, трасса и требования входного регистра. Также нужны условия тактовой сети и запас. Сумма должна укладываться в разрешённое время до нужного фронта захвата. Частота в описании проекта — требование к реализации, а не доказательство того, что готовая схема ему соответствует.
В учебной модели tCQ=0,35 нс, логика занимает 2,2 нс, трасса — 1,15 нс, setup — 0,3 нс и суммарный заданный запас — 0,5 нс. Итого 4,5 нс при исключённых дополнительных различиях тактовых путей. Период 5 нс оставляет 0,5 нс запаса, а период 4 нс даёт дефицит 0,5 нс. Простая обратная оценка границы периода соответствует примерно 222,2 МГц.
Нельзя использовать это деление как универсальный способ получить Fmax всего проекта. Реальный временной анализ учитывает другие пути, фронты, ограничения ввода-вывода и условия модели устройства. UG903 о временных ограничениях полезен именно тем, что связывает анализ с заданными отношениями тактов и путей. Неправильно описанная задача может выглядеть успешно проверенной.
Hold и тактовые отношения нельзя исправить одним снижением частоты
Setup-анализ проверяет своевременное прибытие нужных данных, а hold-анализ — сохранение требуемого значения около соответствующего фронта. Слишком быстрый короткий путь способен быть проблемным для hold, даже если длинный путь хорошо укладывается в период. Поэтому заключение «уменьшим частоту и всё станет правильно» неполно. Необходимо исследовать соответствующие тактовые отношения и оба типа проверок.
Если обработка по смыслу занимает несколько циклов, это должно следовать из реального управления и корректных ограничений. Объявление multicycle только ради зелёного отчёта не добавляет аппаратуре правильного удержания данных. Аналогично исключение пути из анализа не превращает физическое соединение в безопасное. Требования и исключения документируют по назначению схемы, а не по желаемому результату отчёта.
Тактовая сеть также является специальным ресурсом. Произвольное формирование такта общей комбинационной логикой создаёт другие условия, чем использование предусмотренных средств управления. В проекте важны источники, фазовые отношения, сброс и старт последовательности. Одинаковая номинальная частота двух генераторов не доказывает синхронность их фронтов.
Между тактовыми доменами нужен протокол
Асинхронный сигнал способен измениться рядом с моментом выборки и нарушить временные требования регистра. Синхронизирующая цепочка уменьшает вероятность того, что неразрешённое состояние повлияет на дальнейшую логику. Она не делает вероятность физически нулевой и добавляет задержку. AMD UG949 о пересечении тактовых доменов подчёркивает необходимость подходящей схемы синхронизации: обычный временной анализ асинхронного пути не доказывает его аппаратную корректность.
Для многобитного значения мало поставить независимую цепочку на каждый бит и считать слово согласованным. Части одного изменения могут попасть в разные моменты захвата. Нужен подходящий способ передачи: handshake, асинхронный FIFO или иная доказанная организация для конкретного типа данных. Короткий импульс также может потребовать специального протокола, чтобы приёмник вообще заметил событие.
Физическая реализация синхронизатора имеет значение. AMD описывает размещение и атрибуты регистров синхронизации для своей архитектуры. Но структурная проверка, обычный timing-анализ и функциональная симуляция отвечают на разные вопросы. Успех одного инструмента не означает автоматического доказательства всех свойств перехода между доменами.
HLS переводит алгоритм в расписание аппаратных ресурсов
Высокоуровневый синтез позволяет описывать вычисления привычными конструкциями языка, но результатом остаётся схема. Цикл может разворачиваться в параллельные блоки, использовать общую арифметику по очереди или превращаться в конвейер. Выбор зависит от зависимостей, ограничений, типов и директив. Один оператор исходного кода не обязан иметь один постоянный аппаратный образ.
Развёртка увеличивает доступную параллельность только вместе с возможностью доставить операнды. Если после неё восемь арифметических операций делят два порта памяти, узкое место сохраняется. В других случаях длительная рекуррентная зависимость ограничивает II независимо от числа свободных DSP. Нужно связывать расписание с реальными источниками задержки, а не только увеличивать степень развёртки.
Schedule Viewer в UG1399 различает latency, II и использование ресурсов. После HLS следует ещё проверить физическую реализацию. Оценка до размещения не включает все будущие эффекты трассировки, а выполнение целевого II не доказывает выполнения требуемого периода. Именно совместный отчёт даёт инженерную картину.
Внешний интерфейс способен ограничить готовый конвейер
При темпе 200 миллионов результатов в секунду и одном 16-битном входе требуется 3,2 Гбит/с полезных данных, то есть 400 десятичных МБ/с. Для двух таких входов и одного 16-битного выхода суммарный обмен составляет 1,2 ГБ/с. Служебные поля, паузы и дополнительные промежуточные данные в эту модель не включены. Важно также различать направления передачи.
Если интерфейс не обеспечивает нужный поток, внутренняя возможность принимать данные каждый такт остаётся недоиспользованной. Буфер может сгладить короткий всплеск, но не исправляет постоянный дефицит средней полосы. Обратное давление должно корректно останавливать или регулировать тракт, сохраняя соответствие результатов. Потеря данных при заполнении очереди — функциональная ошибка, а не просто снижение производительности.
Практический анализ включает размеры пакетов, границы памяти хоста, DMA, очереди и программное обслуживание. Очень быстрый искусственный поток внутри FPGA не равен быстрому приложению на ПК. Если перед каждым небольшим заданием требуется отдельная настройка и передача, расходы границ могут доминировать. Измерение полного пути поэтому дополняет проверку арифметического конвейера.
Учебная очередь на 1024 слова принимает 200 миллионов слов в секунду, а удаляет 150 миллионов. Из пустого состояния при постоянных темпах она заполнится за 1024/(50×10⁶), то есть 20,48 мкс. Большая очередь даёт больший запас времени, но не устраняет разность средних скоростей. Требуется согласовать темп либо предусмотреть допустимую политику отказа; обещать бесконечное сохранение потока таким буфером нельзя.
В интерфейсе с явным разрешением передачи источник обязан сохранять действительные данные, пока получатель не принял их по условиям протокола. Одного переключения сигнала valid недостаточно, если данные уже ушли вперёд. Этот контракт влияет на регистры, счётчики и возможность остановить все стадии. Проверяют также возобновление после остановки: ошибка часто проявляется именно на границе паузы, а не в непрерывном идеальном потоке.
Конфигурация и начальное состояние входят в устройство
После включения конкретная FPGA должна пройти предусмотренную последовательность питания, тактирования и конфигурации. У многих семейств конфигурационное состояние хранится в энергозависимых ячейках и загружается из внешнего источника; существуют и другие технологии. Нельзя переносить порядок запуска одного семейства на все программируемые кристаллы. Важны возможности именно выбранного компонента и платы.
UG570 описывает bitstream UltraScale как данные и команды конфигурационной логике. Это не универсальный исполняемый файл для любого FPGA. Совместимость с устройством, параметрами сборки и разрешённым способом загрузки существенна. Сам факт успешного завершения передачи ещё не подтверждает правильное начальное состояние всех пользовательских интерфейсов.
Проекту нужны определённые условия сброса, готовности PLL и инициализации обмена. Если внешняя сторона начинает посылать данные раньше, часть событий может потеряться или интерпретироваться неверно. При обновлении конфигурации также необходимо определить поведение окружающей системы. Процедура запуска — часть законченного устройства, даже когда основной математический тракт работает без ошибок.
Сводка ресурсов показывает несколько самостоятельных ограничений
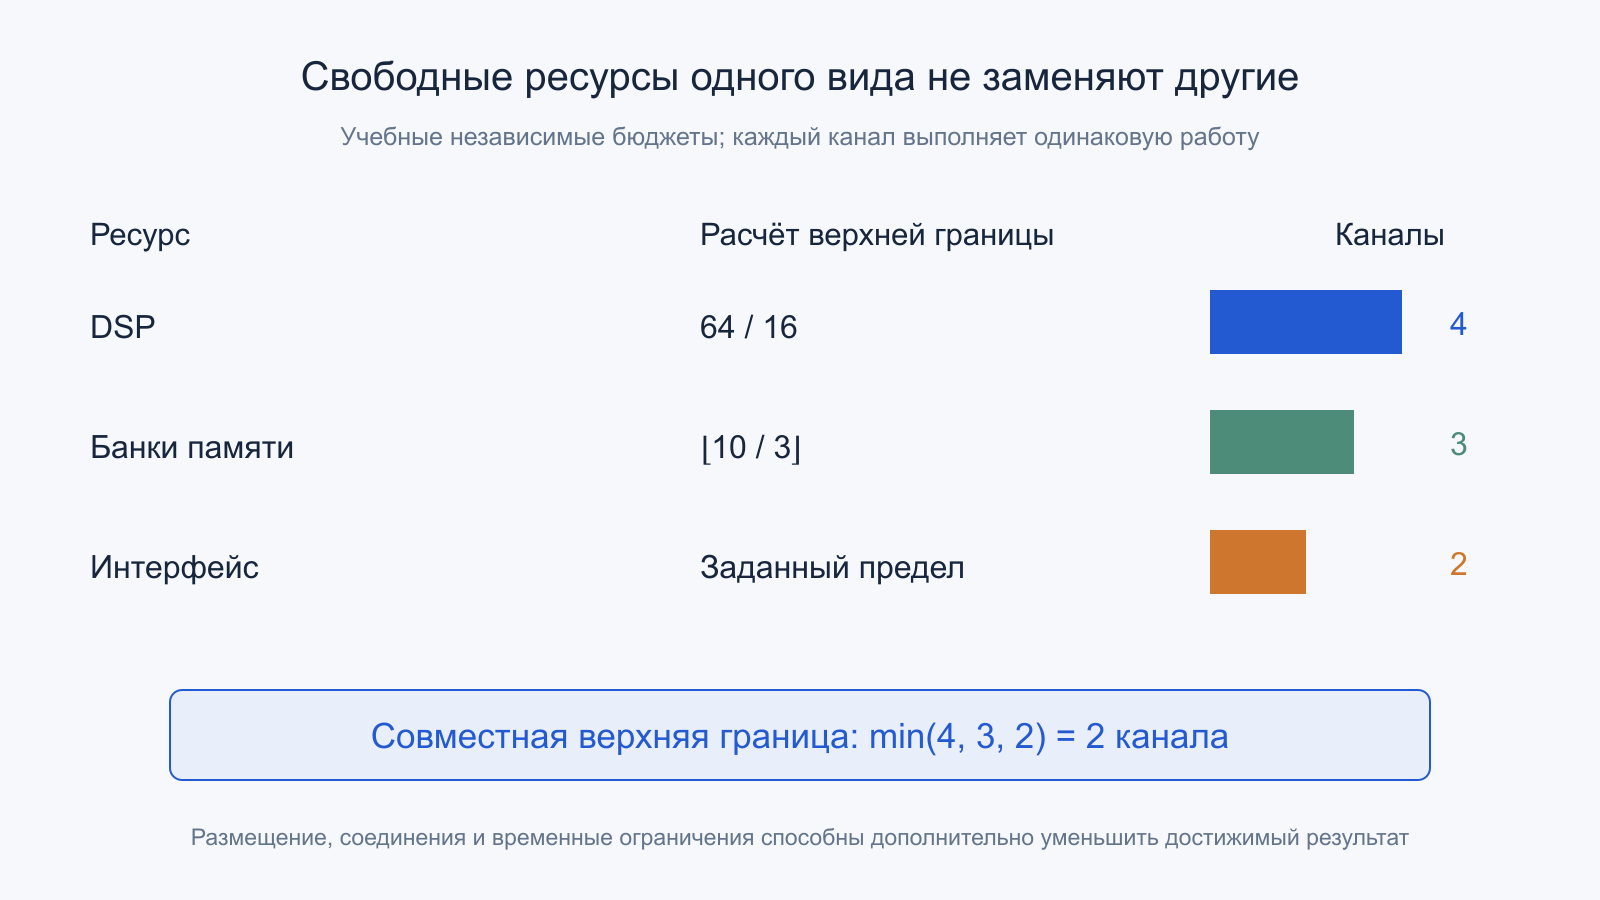
У проекта есть отдельные бюджеты LUT, регистров, DSP, памяти, тактовых средств, выводов и соединений. Остаток одного вида не заменяет отсутствующий ресурс другого. Схема с 40% использования LUT способна упираться в DSP или порты памяти, а набор свободных регистров не превращается автоматически в подходящий высокоскоростной интерфейс. Поэтому общий процент заполнения недостаточен для решения о расширении проекта.
В учебном расчёте имеется 64 DSP, а один канал требует 16: арифметическая оценка допускает четыре канала. При десяти доступных банках памяти и трёх банках на канал получается не больше трёх. Если интерфейс обслуживает только два таких канала, итоговая верхняя граница — два, а не четыре. Даже она не доказывает успешное размещение: трассы, тактовые и другие ограничения ещё могут уменьшить результат.
Также важна совместимость упаковки. Несколько логических элементов могут требовать разных тактов или управляющих сигналов, хотя по отдельности помещаются в номинальную ёмкость блока. Синтез и размещение способны использовать дополнительную логику для решения таких условий. При сравнении вариантов оценивают весь отчёт реализации и нужную производительность, сохраняя одну функциональную задачу и одинаковую точность результата.
Мощность зависит от переключений и движения данных
Размножение вычислительных блоков может уменьшить время обработки, но увеличивает активную логику, тактовую нагрузку и требования к питанию. Значимы частота переключений, ёмкости соединений и напряжение. Свободные ресурсы не обязательно полностью обесточены, а динамический расход зависит от реальных данных и разрешений. Простого отношения количества LUT к ваттам не существует.
В учебном примере законченная работа требует 20 мс при 10 Вт на выбранной границе: энергия равна 0,2 Дж. Другая реализация выполняет ту же работу за 12 мс при 14 Вт, расходуя 0,168 Дж. Более высокая мощность сочетается с меньшей энергией результата. Эти числа не являются характеристиками FPGA и не учитывают время ожидания между заданиями.
Для приложения важна также энергия интерфейсов, памяти и хоста. Показатель только кристалла не следует выдавать за потребление всей платы или компьютера. Сравнение выполняют при одинаковой работе, точности и границе измерения. Переход в более экономичный режим между редкими запросами способен изменить итог сильнее небольшого различия активной арифметики.
Проверка результата требует нескольких разных доказательств
Функциональная симуляция проверяет поведение модели при выбранных воздействиях. Синтез устанавливает, что описание удалось преобразовать, а отчёты ресурсов показывают выбранные блоки. Размещение и трассировка добавляют физические ограничения. Временной анализ проверяет заданные пути в модели устройства. Ни один из этих этапов сам по себе не заменяет остальные.
В протокол полезно включить семейство и вариант кристалла, частоты и интерфейсы, форматы данных, целевые latency и II, загрузку ресурсов и состояние временных проверок. Отдельно фиксируют корректность переполнения, остановки, сброса и CDC. После этого аппаратный опыт должен подтвердить работу законченного устройства, включая длительный поток и пограничные ситуации. Без такой связки слово «скомпилировалось» говорит слишком мало.
Например, для очереди полезно проверять свойства «принятые данные не теряются», «порядок сохраняется» и «при остановке потребителя выход остаётся действительным». В тестах нужны пустое и полное состояния, одновременные приём и выдача, последовательности остановок и возобновлений. Для арифметики отдельно сравнивают эталон с теми же правилами округления и переполнения, иначе расхождение может быть заложено в самой постановке сравнения.
Случайный набор воздействий расширяет покрытие, но не доказывает исчерпывающую корректность всех состояний. Формальная проверка способна исследовать заявленные свойства в своей модели, однако также зависит от допущений об окружении и полноты спецификации. Поэтому проверенный контракт интерфейса, временные отчёты и проверка платы должны подтверждать согласованный набор требований. Пропуск одного вида проверки нельзя компенсировать большим количеством повторов другого.
FPGA даёт возможность построить тракт под задачу, а не гарантирует преимущество при любом алгоритме. Её сильная сторона проявляется, когда вычисления, память и обмен имеют согласованную структуру и нужные ограничения оправдывают разработку. Полезный итог — корректная аппаратная система с понятной задержкой, потоком и расходом ресурсов, а не максимальное заполнение таблицы характеристик.
Официальные первичные источники
Архитектурные описания ниже относятся к указанным семействам и версиям. Учебные расчёты и схемы статьи самостоятельные; они не являются сравнительными испытаниями плат.
- AMD UG574 — CLB Overview: LUT, регистры и специальные цепи UltraScale.
- Intel FPGA Optimization Guide 2023.1 — Adaptive Logic Module.
- AMD UG1704 — DSP48E2: порты и режимы арифметического примитива.
- AMD UG573 — Address Collision: взаимодействие портов block RAM.
- AMD UG1399 — Pipeline: интервал запуска и конвейеризация.
- AMD UG1399 — Schedule Viewer: latency, II и использование ресурсов.
- AMD UG903 — Using Constraints: временные отношения и ограничения.
- AMD UG949 — Constraining Asynchronous Clock Groups and Clock Domain Crossings.
- AMD UG574 — Register Synchronizers: реализация цепочек синхронизации.
- AMD UG570 — Configuration Bitstream.