GDDR7 и PAM3: как память видеокарты передаёт больше данных
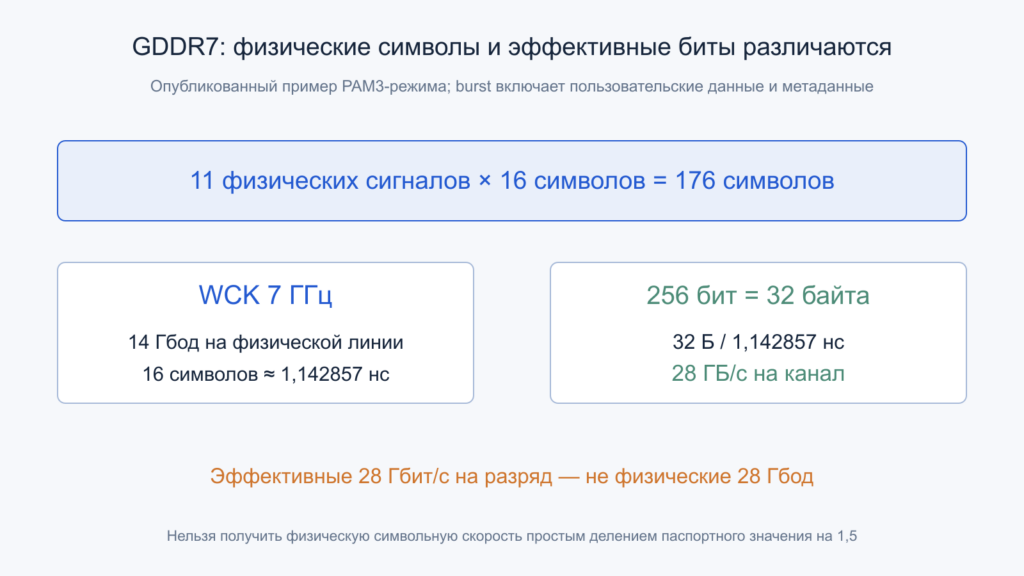
В примере WCK 7 ГГц даёт 14 Гбод. Шестнадцать символов занимают около 1,142857 нс, обеспечивая 28 ГБ/с пользовательских данных на канал. Открыть иллюстрацию в полном размере.
GDDR7 интересна не только ростом гигабайтов в секунду. Она меняет способ представления данных, организацию каналов, тактирование и контроль передачи. При этом простая фраза «три бита за два символа» объясняет лишь часть картины: реальный интерфейс нельзя рассчитывать как одну абстрактную трёхуровневую проволоку. Разберём устройство обмена, математические оценки и аппаратные ограничения. Статусы продуктов сверены на 26 октября 2026 года. Все наши диаграммы и численные сценарии учебные и не являются тестами оборудования владельца сайта.
Содержание статьи
- Стандарт, микросхема и видеокарта имеют разные пределы
- Зачем нужен третий уровень
- Как три бита помещаются в два символа
- Реальная упаковка сложнее одной схемы 3b2S
- Как считать WCK и физическую скорость
- Четыре канала позволяют обслуживать независимую работу
- Такт чтения помогает наблюдать данные в нужный момент
- Командный путь тоже должен успевать
- Тренировка ищет рабочее окно, а не одну удачную точку
- Эквализация борется с памятью канала
- CRC и ECC защищают разные участки
- Полоса видеокарты зависит от ширины эффективной шины
- Почему ёмкость не растёт вместе с частотой
- Кэш уменьшает потребность во внешней памяти
- Энергия одного бита не равна мощности всей платы
- Корпус и плата ограничивают длительную работу
- Почему GDDR7 нельзя поставить вместо GDDR6
- Что подтверждено в продуктах к дате сверки
- Как оценивать пользу без ложных выводов
- Первичные источники
- Читайте также
Стандарт, микросхема и видеокарта имеют разные пределы
JEDEC объявила публикацию JESD239 GDDR7 в марте 2024 года. В объявлении указан потенциал до 192 ГБ/с на устройство. Для эффективной ширины 32 бита это соответствует 48 Гбит/с на логический разряд: 48 × 32 / 8 = 192. Такой предел не означает, что каждая выпускаемая микросхема или видеокарта работает в этом режиме.
Контроллер GPU, конкретная DRAM, корпус и плата должны поддерживать выбранную скорость вместе. Производитель может использовать микросхемы определённого семейства на более низком режиме ради выхода годных, энергопотребления или запаса. Поэтому сравнивают точный артикул памяти и спецификацию готового изделия.
Развитие стандарта продолжается редакциями; Cadence в сентябре 2026 года описывает JESD239F, выпущенную в августе. Для проектирования требуется выбранная редакция, а не только название GDDR7. Документ, демонстрационный кристалл, образец памяти и продаваемая карта подтверждают разные вещи. Дальше будем явно отделять общие механизмы от расчётных примеров и от характеристик конкретного продукта.
Зачем нужен третий уровень
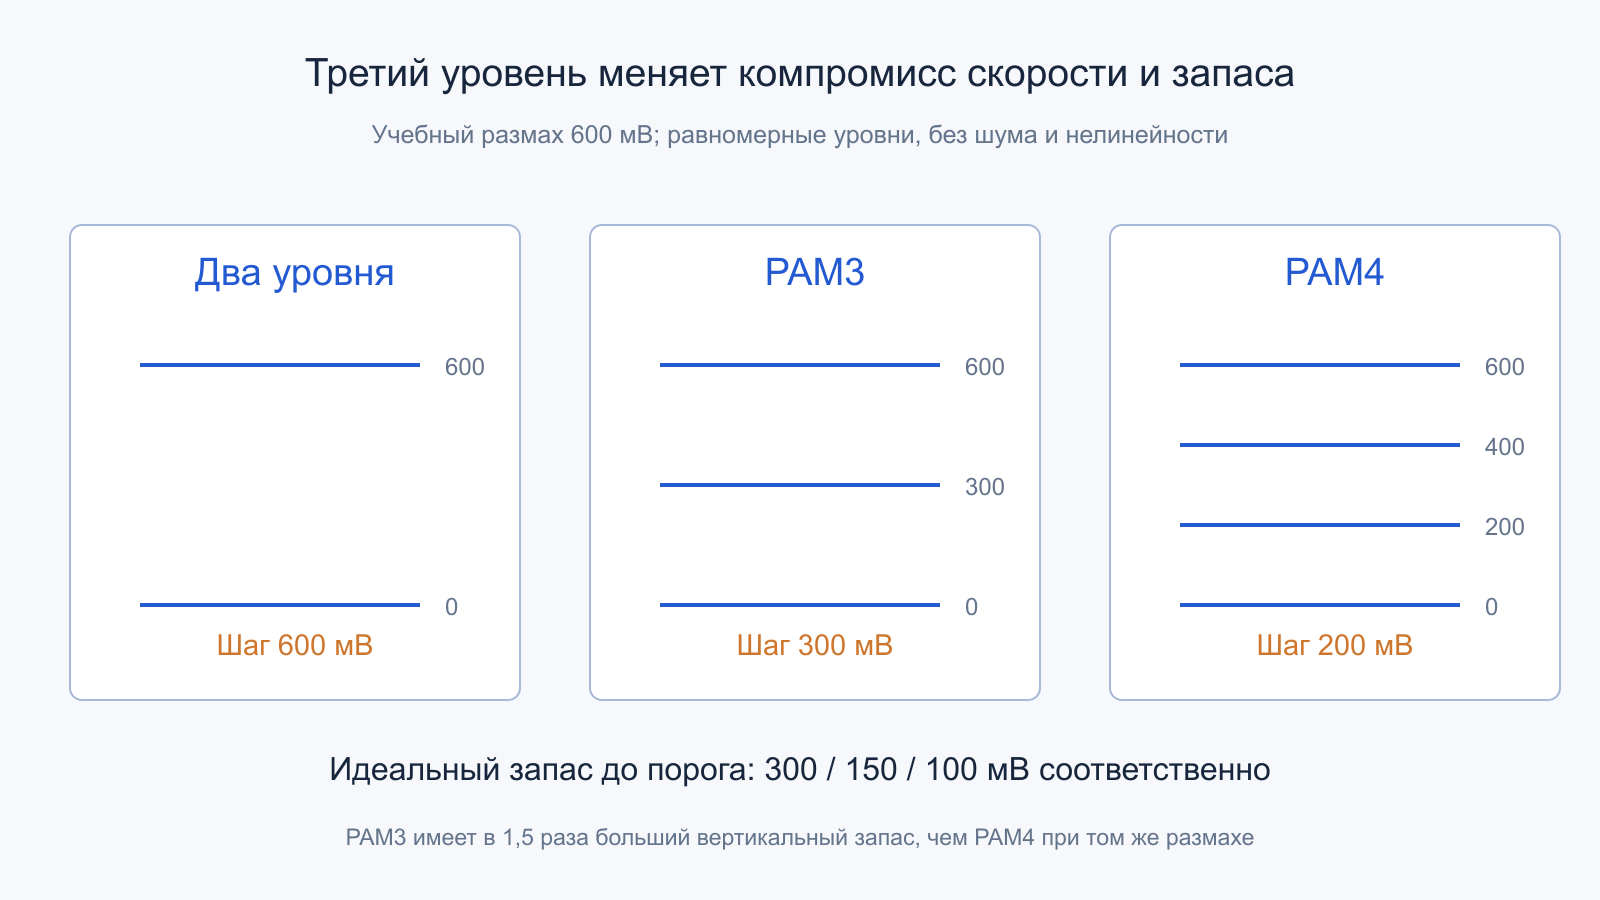
Двухуровневая передача различает два состояния за символьный интервал. Добавление среднего уровня увеличивает число доступных комбинаций без обязательного пропорционального роста числа временных переходов. Но при фиксированном общем размахе напряжений расстояние между соседними состояниями уменьшается, а требования к приёмнику растут.
В учебном примере крайние уровни находятся на 0 и 600 мВ. У двухуровневого сигнала шаг равен 600 мВ, у равномерного PAM3 — 300 мВ, у PAM4 — 200 мВ. Идеальный запас от уровня до ближайшего порога составляет соответственно 300, 150 и 100 мВ. Таким образом, выбранный PAM3 имеет в полтора раза больший вертикальный запас, чем PAM4 с тем же размахом, но уступает двум уровням.
Это геометрия условных уровней, а не нормативные напряжения GDDR7 и не готовая оценка BER. На практике глаза зависят от нелинейности передатчика, шума, межсимвольной интерференции и моментов выборки. Третий уровень является компромиссом между информационной плотностью и электрическим запасом, который нужно реализовать всем трактом.
Как три бита помещаются в два символа
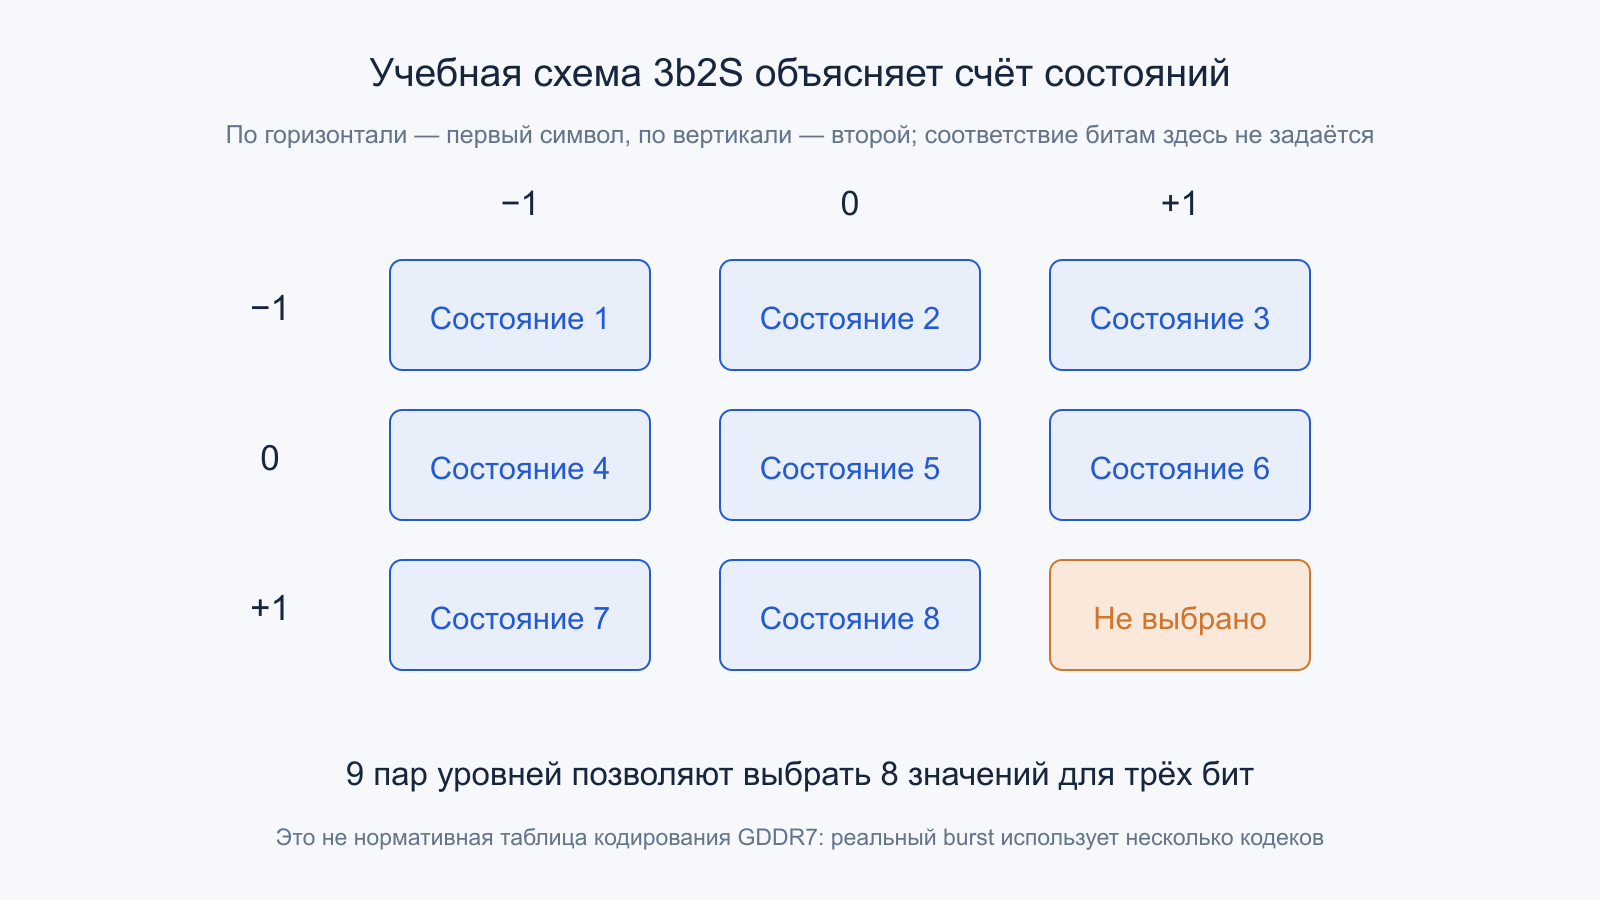
У двух последовательных трёхуровневых символов существует девять комбинаций: три варианта первого состояния умножаются на три варианта второго. Для представления трёх двоичных бит достаточно восьми значений. Поэтому можно выбрать восемь комбинаций из девяти и передавать по три бита за пару интервалов.
Средняя информационная плотность такой схемы составляет 1,5 бита на символ. Величина log₂3 приблизительно равна 1,585 и выражает теоретическую информационную ёмкость равновероятного трёхзначного алфавита. Она не означает, что простая схема 3b2S автоматически передаёт дробную дополнительную часть полезных данных в каждом интервале.
Конкретное соответствие двоичных слов и пар уровней задаётся кодом. Произвольно нарисованную таблицу нельзя выдавать за таблицу стандарта. В нашей иллюстрации показано только число доступных состояний. Приёмник должен правильно восстановить последовательность и границы кодовых групп; ошибка уровня способна изменить несколько восстановленных бит. Поэтому анализ исключительно отдельных напряжений не описывает весь путь до пользовательских данных.
Реальная упаковка сложнее одной схемы 3b2S
В техническом описании Cadence для PAM3-режима указан burst из 176 символов: одиннадцать физических сигналов по шестнадцать временных интервалов. На один доступ канала приходится 256 бит пользовательских данных, а кодирование включает несколько форматов, среди которых 11b7S и 3b2S. Следовательно, рекламное объяснение нельзя механически применять к каждому проводу независимо от структуры доступа.
Математика блока 11b7S хорошо показывает причину более плотной упаковки. Семь трёхзначных символов имеют 3⁷ = 2187 вариантов. Этого достаточно для 2¹¹ = 2048 двоичных слов, но недостаточно для 2¹² = 4096. Информационная плотность такого блока равна 11/7, примерно 1,571 бита на символ. Это расчёт мощности алфавита, а не полное описание нормативной таблицы.
В целом нужно разместить пользовательские данные и служебную информацию, сохранив допустимые комбинации и удобство аппаратной обработки. Поэтому полезная скорость, физическое число сигналов и плотность одного кодека являются тремя разными величинами. Их смешение даёт ошибки даже при правильной общей идее трёхуровневой передачи.
Как считать WCK и физическую скорость
Возьмём опубликованный Cadence пример WCK 7 ГГц. Физическая скорость PAM3 на линии составляет 14 Гбод, а шестнадцать символов занимают восемь периодов WCK. Время burst равно 8 / 7 миллиардов секунд, приблизительно 1,142857 нс. Пользовательские 256 бит за это время дают 224 Гбит/с, то есть 28 ГБ/с для канала.
Если выразить те же 224 Гбит/с через восемь эффективных двоичных разрядов канала, получится 28 Гбит/с на разряд. Это не 28 Гбод физического сигнала. Деление паспортных 28 на 1,5 тоже не даёт верного физического значения для данного интерфейса: оно игнорирует дополнительные сигналы и блочную упаковку.
Универсальный способ проверки — сначала зафиксировать полезные биты на доступ, количество физических интервалов и длительность интервала. Затем отдельно вывести принятую эффективную скорость. Такой порядок полезен при чтении осциллограмм и настройке моделей: обозначение на коробке видеокарты не обязано совпадать с частотой, которую показывает генератор такта или анализатор символов.
Четыре канала позволяют обслуживать независимую работу
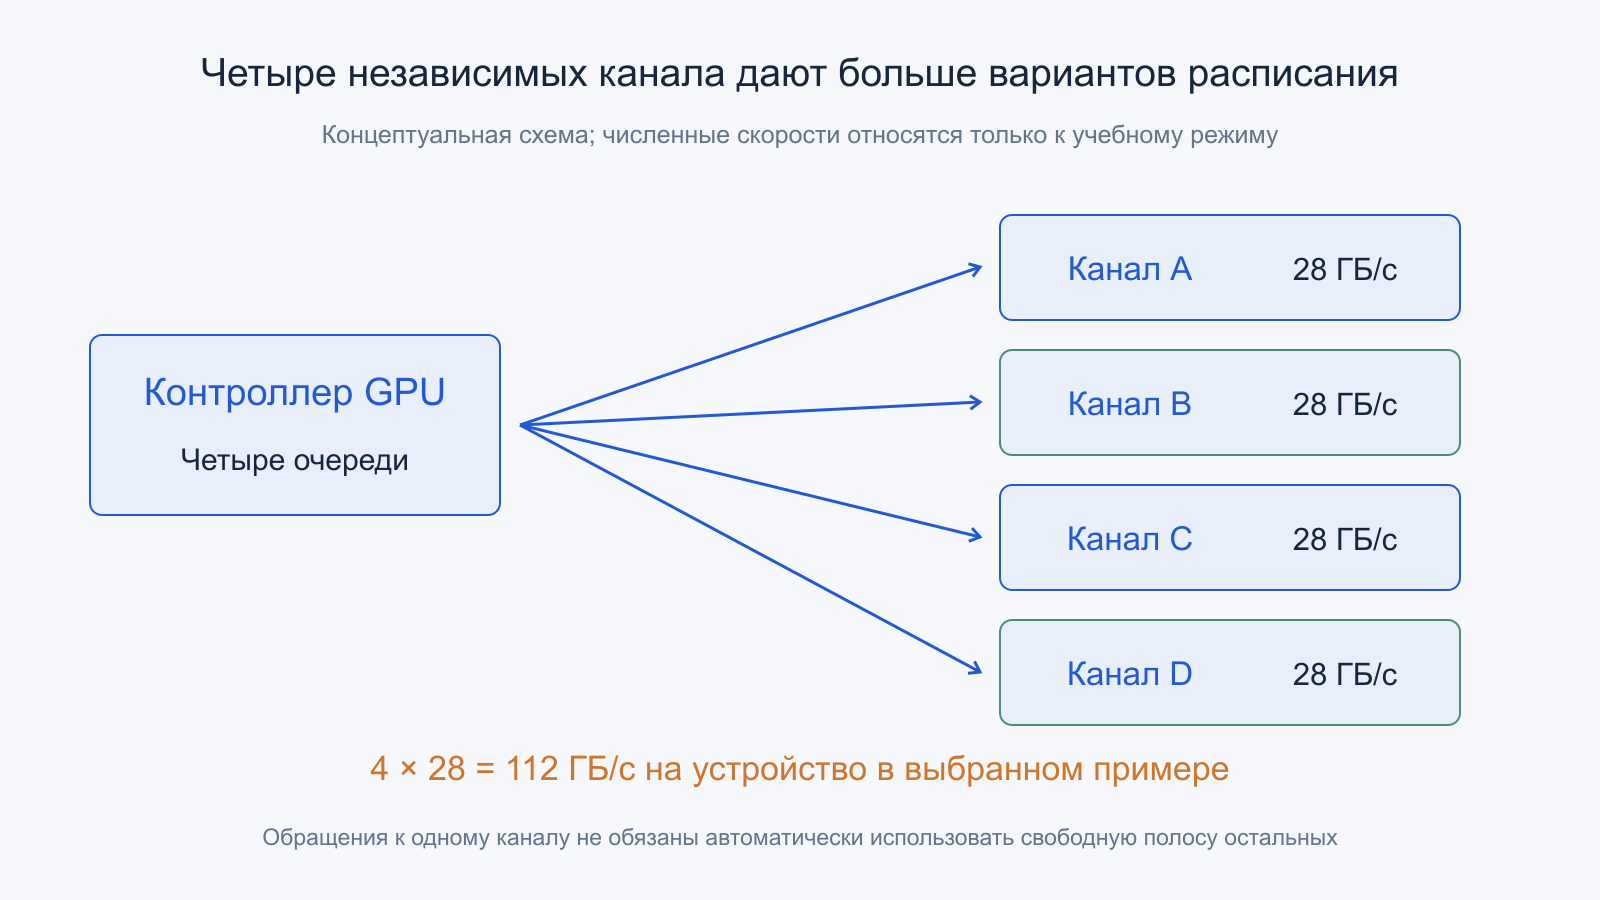
Типичная организация GDDR7 использует четыре независимых канала эффективной шириной по одному байту. Они имеют собственные интерфейсные ресурсы и дают контроллеру больше возможностей планировать обращения. Суммарная эффективная ширина устройства остаётся 32 бита; деление на каналы не создаёт второй экземпляр этой полосы.
Для учебной оценки четыре канала по 28 ГБ/с дают 112 ГБ/с на устройство. Если нагрузка обращается только к одному из них, доступность остальных трёх не гарантирует автоматического перераспределения адресов. Раскладка адресного пространства и политика контроллера должны обеспечивать полезный параллелизм.
Такое разделение особенно интересно при небольших независимых запросах: контроллеру легче находить готовую работу в разных частях памяти. Однако общий предел корпуса, питающие цепи и тепловая среда остаются общими ограничениями. Четыре канала полезно воспринимать как четыре управляемые очереди с собственными ресурсами, а не как обещание четырёхкратного ускорения произвольного алгоритма относительно предыдущего поколения.
Такт чтения помогает наблюдать данные в нужный момент
GDDR7 использует входной WCK и формируемый памятью RCK для чтения. Возвращаемый вместе с данными такт помогает приёмнику соотнести выборку с реальным выходом DRAM. Внутренний CK4 получается делением WCK на четыре и служит опорой для ряда задержек и командных интервалов.
RCK имеет режимы управления, позволяющие выбирать постоянную работу или включение при определённых условиях. Остановка ненужного тактирования снижает динамические расходы, но требует правильно выдержать запуск и переход к передаче. Частота, фаза и момент разрешения сигнала являются разными параметрами.
В учебном временном примере общая задержка проводников данных и сопровождающего такта увеличилась на 20 пс, а разность их задержек сохранилась. Для синхронной выборки это мягче, чем рост только задержки данных на те же 20 пс. Но общая помеха компенсируется не идеально: тракты имеют разный шум и чувствительность. Поэтому согласование длин полезно, однако не заменяет проверки реального окна выборки.
Командный путь тоже должен успевать
Даже идеальная линия данных бесполезна, если память не получает достаточно корректных команд. GDDR7 поддерживает частично независимую организацию команд строк и столбцов. Это помогает перекрывать совместимые операции, однако разрешённые последовательности всё равно ограничены таймингами банков и массива DRAM.
Представим учебный планировщик, которому для четырёх передач приходится выполнить восемь подготовительных действий. Если все действия строго последовательны, увеличение скорости вывода данных почти не ускоряет подготовку. Перекрытие независимых действий снижает простой, но требует наличия независимых адресов и соблюдения причинных связей. Этот пример описывает общий принцип расписания и не назначает число команд GDDR7.
При высокой нагрузке важно проверять, чем ограничивается результат: свободным временем интерфейса данных, подготовкой строк или очередью команд. Разные причины требуют разных решений. Более высокая частота памяти способна оставить прежнюю производительность, если внешняя шина уже ждёт внутренние операции. И наоборот, хорошая раскладка запросов позволяет приблизиться к доступной полосе без смены микросхем.
Тренировка ищет рабочее окно, а не одну удачную точку
Настройка интерфейса должна подобрать временные положения и пороги, при которых приёмник устойчиво различает уровни. Для трёхуровневого сигнала полезно наблюдать оба глаза и разные переходы. Настройка, хорошая для одного набора данных, может оказаться слабой для другого из-за межсимвольной интерференции.
Cadence описывает FIFO-режим тренировки и генерацию псевдослучайных последовательностей через LFSR, включая счётчики по линиям и глазам. Псевдослучайный поток помогает быстро исследовать много сочетаний, но сам по себе не является доказательством всех возможных условий. Потребуются также специальные шаблоны и проверка границ напряжения и температуры.
В учебной карте окно занимает 80 пс по времени и 60 мВ по уровню. Если температурный сдвиг расходует 15 пс, а разброс компонентов — ещё 10 пс, остаётся 55 пс по выбранной временной модели. Вертикальный запас считают отдельно; складывать пикосекунды с милливольтами бессмысленно. Реальное окно зависит от корреляции факторов, поэтому простое сложение крайних значений служит только консервативной иллюстрацией.
Эквализация борется с памятью канала
Соседние символы влияют друг на друга из-за частотно зависимых потерь и отражений. Передающая коррекция меняет форму импульса, а приёмная помогает отделить текущий символ от остаточного влияния предыдущих. При трёх уровнях также требуется сохранять корректные расстояния между амплитудами.
Сильная коррекция не всегда лучше. Усиление высоких частот способно повысить шум, а решения обратной связи зависят от правильности предыдущих отсчётов. Поэтому предельное значение настройки является возможностью компенсации, а не универсальным рабочим режимом. Проверяют сочетание ошибок, окна и устойчивости адаптации.
SK hynix описывает применение T-coil структур и изменения внутренних трактов для расширения полосы. Такие элементы помогают согласовать ёмкостные нагрузки и частотную характеристику, однако не отменяют необходимости хорошей платы. Успешная микросхема использует согласованную систему мер: драйвер, приёмник, корпус, разводку и питание. Отдельная эффектная технология не объясняет весь достигнутый результат.
Численный запас зависит от точки измерения. Модель корпуса у выводов и осциллограмма после длинного измерительного перехода относятся к разным границам. Чтобы сравнивать результаты, удаляют известное влияние оснастки или приводят модели к общей опорной плоскости. Плохая модель перехода способна создать видимость красивого сигнала, поэтому проверяют также воспроизводимость и независимые признаки качества связи.
CRC и ECC защищают разные участки
Контроль передачи и защита ячеек памяти имеют разные границы. CRC помогает обнаружить повреждение обмена, а on-die ECC работает внутри DRAM с ошибками хранимых данных. Наличие внутреннего ECC не гарантирует исправления любого нарушения на контактах корпуса или в контроллере GPU.
Micron перечисляет для GDDR7 внутреннюю коррекцию, чётность команд и контроль CRC. Для конкретного изделия необходимо выяснять, как ошибка сообщается хосту и какие действия выполняет система. Некоторые механизмы обнаруживают проблему, но сами не восстанавливают правильный результат. Обнаружение, исправление и безопасное прекращение операции нельзя объединять словом «защищено».
Учебная схема проверки проста: бит изменился в массиве до формирования контрольных данных — его рассматривает внутренняя защита; бит изменился во время передачи — нужен контроль соответствующего внешнего пути. Если наблюдается неправильный результат программы, источник может находиться вообще в вычислении. Диагностику строят по границам покрытия, а не по наличию одной аббревиатуры в рекламном списке.
Полоса видеокарты зависит от ширины эффективной шины
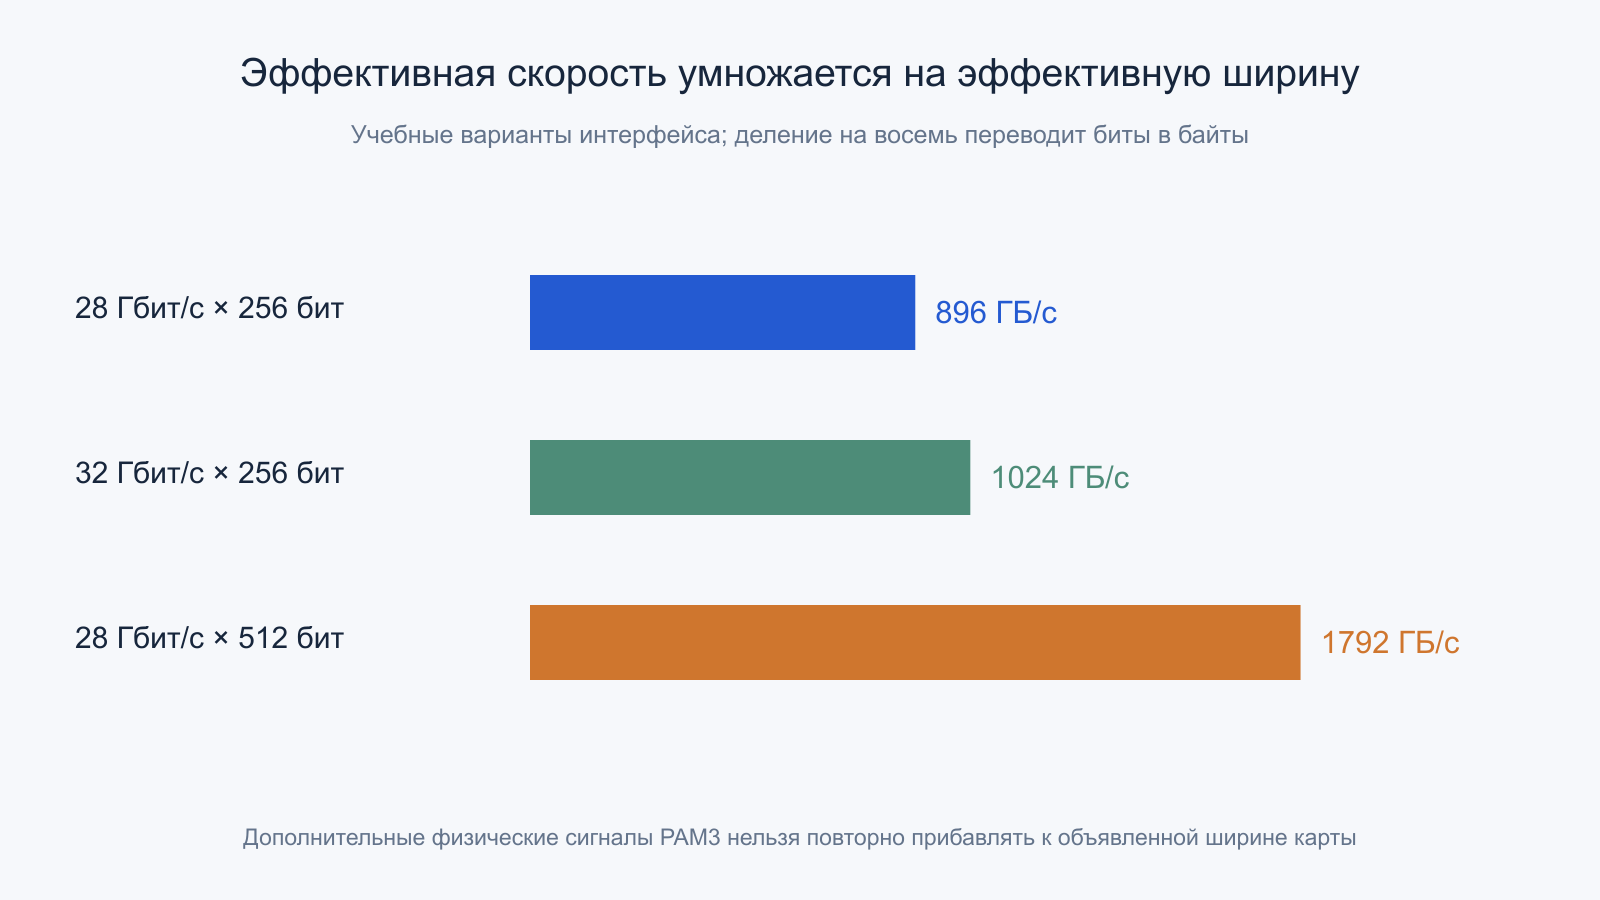
Для готовой карты обычно используют эффективную скорость на разряд и суммарную ширину контроллера. В учебном примере 28 Гбит/с и 256 бит дают 896 ГБ/с. При 512 битах получается 1792 ГБ/с. Это десятичные значения без вычета внутренних простоев и без удвоения за чтение плюс запись.
Если сравнить 32 Гбит/с на 256 битах с 28 Гбит/с на 512, получим 1024 против 1792 ГБ/с. Более высокая скорость памяти на разряд не гарантирует большей общей полосы. Важны также число подключённых устройств и реальный режим контроллера.
Физические дополнительные сигналы PAM3 нельзя ещё раз прибавлять к эффективной 256- или 512-битной ширине карты: полезная организация уже отражена в её спецификации. Иначе одна и та же выгода упаковки будет посчитана дважды. Для воспроизводимого сравнения отдельно выписывают полезную ширину, эффективную скорость, максимальную арифметическую полосу и измеренный прикладной результат.
Почему ёмкость не растёт вместе с частотой
Плотность микросхемы показывает количество хранимых бит, а скорость интерфейса — темп обмена. 24 Гбит ёмкости соответствуют трём гигабайтам в принятом обозначении плотности DRAM; это не 24 ГБ. Если использовать шестнадцать таких устройств целиком, получится 48 ГБ независимо от выбранной частоты интерфейса.
При этом число корпусов не всегда прямо определяет эффективную ширину шины. Некоторые варианты организации позволяют увеличить ёмкость при другом использовании каналов. Требуются поддержка контроллера, разводка и правильная конфигурация, а не просто свободное место на обратной стороне платы.
Для задачи, помещающейся в видеопамять, дополнительные гигабайты могут почти не изменить скорость. Если данные перестали помещаться и начались перемещения через PCIe, эффект ёмкости становится значительно сильнее. Это другой механизм ускорения, который не следует приписывать PAM3. Тесты сравнивают при известном рабочем наборе, фиксируя, происходила ли выгрузка данных в системную память.
Полезно посчитать и накладные расходы самой задачи. Если из каждой загруженной порции 32 байта алгоритм использует только четыре, эффективность полезного использования равна 12,5%. При физическом пользовательском потоке 896 ГБ/с скорость нужных программе значений окажется не выше 112 ГБ/с в этой модели. Перестройка данных, собирающая нужные элементы рядом, способна улучшить результат без изменения частоты.
Кэш уменьшает потребность во внешней памяти
Внешняя полоса интересна только для обращений, которые действительно дошли до DRAM. Если значительная доля данных повторно используется в кэше, потребность в GDDR7 уменьшается. Поэтому одинаковый поток запросов вычислительных блоков может создавать разную внешнюю нагрузку при разной локальности.
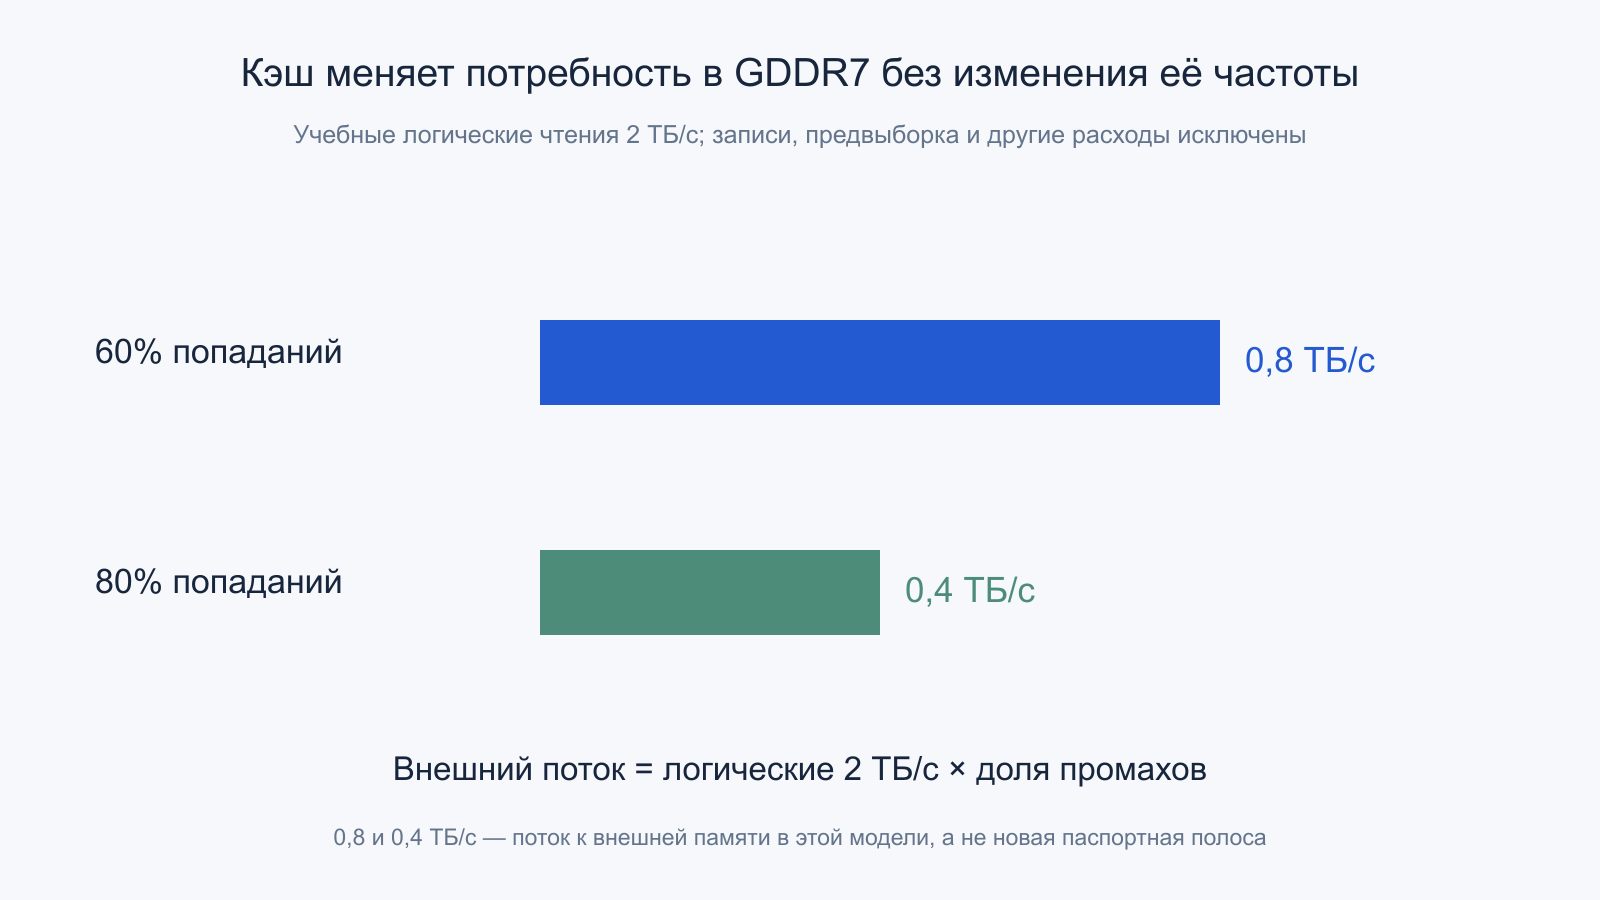
В учебной модели приложению нужно 2 ТБ/с логических чтений. При доле попаданий 60% внешний поток составит 0,8 ТБ/с, а при 80% — 0,4 ТБ/с. Это упрощение без записей, предвыборки и дополнительных чтений. Оно показывает, почему увеличение кэша способно дать больший эффект, чем небольшой прирост частоты DRAM.
Сравнение двух GPU только по памяти поэтому неполно: различаются кэши, сжатие, вычислительная архитектура и планировщик. Даже на одной карте две сцены могут по-разному реагировать на частоту памяти. Для объяснения результата полезно менять один фактор и наблюдать, как изменяются загрузка интерфейса и время задачи, сохраняя остальные настройки.
Например, при двух арифметических операциях на каждый прочитанный байт внешние 896 ГБ/с допускают максимум 1792 миллиарда таких операций в секунду, если других обращений нет. Увеличение вычислительного пика GPU выше этой границы не поможет выбранной модели. Если повторное использование увеличит число операций на байт до восьми, тот же поток сможет поддержать уже 7168 миллиардов операций. Именно связь алгоритма с данными определяет пользу быстрой памяти.
Энергия одного бита не равна мощности всей платы
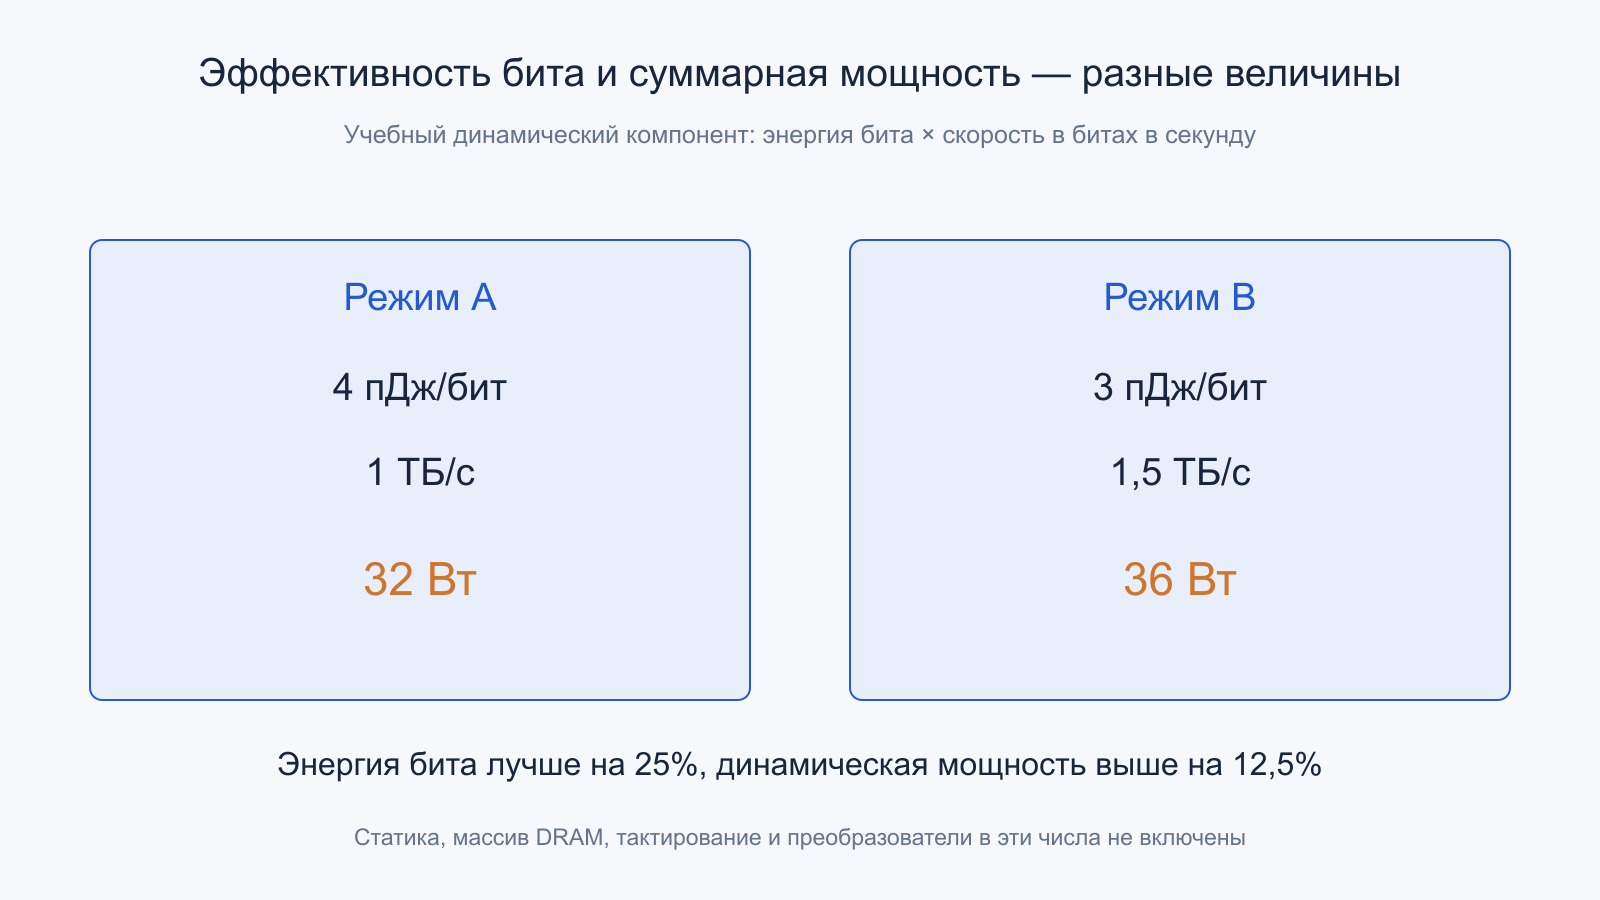
Улучшенная эффективность передачи может сопровождаться ростом общей мощности, если данных передаётся существенно больше. Для условных 4 пДж на бит и потока 1 ТБ/с получаем 32 Вт: триллион байт превращается в восемь триллионов бит, затем умножается на энергию бита. Это только выбранный динамический компонент модели.
При 3 пДж на бит и потоке 1,5 ТБ/с получится 36 Вт. Энергия бита улучшилась на 25%, но динамическая мощность выросла на 12,5%. Добавляются статические расходы, операции массива, тактирование и преобразование питания. Поэтому процент экономии производителя требует чтения его исходной скорости, напряжения и методики.
Для завершённой задачи оценивают энергию за всё время, включая работу GPU. Более высокая мощность памяти может окупиться меньшим ожиданием вычислительных блоков. Возможен и противоположный случай: вычислительно ограниченная задача почти не ускорится, а потребление увеличится. Режимы остановки тактирования и частичной активности особенно важны при неполной загрузке и простое.
Корпус и плата ограничивают длительную работу
Графическая память расположена рядом с горячим GPU и силовыми преобразователями. Температура зависит от контакта с охладителем, толщины теплового интерфейса и распределения воздушного потока. Улучшение материала корпуса не гарантирует такой же процент снижения температуры всей видеокарты.
В условной модели микросхема рассеивает 2 Вт при тепловом сопротивлении пути 8 К/Вт. Перегрев составляет 16 К. Если сопротивление уменьшить на четверть до 6 К/Вт, перегрев станет 12 К: выигрыш 4 К при той же мощности. Температура окружающей платы и других источников тепла здесь исключена, поэтому модель не предсказывает показание датчика реальной карты.
Высокоскоростные сигналы также зависят от переходов между слоями, возвратных токов и связи с соседними линиями. Изменение тепловой прокладки без понимания механики способно ухудшить контакт или деформировать плату. Для ремонта важны документация и корректное восстановление сборки, а для разработки — совместная электрическая и тепловая проверка длительного режима.
Для иллюстрации влияния раскладки возьмём четыре одинаковых канала по 28 ГБ/с. Если 70% потока адресовано одному каналу, весь поток ограничен величиной 28/0,7 = 40 ГБ/с, хотя сумма возможностей равна 112 ГБ/с. Остальные каналы в этом случае загружены лишь частично. Это модель распределения обращений, а не измерение конкретного контроллера. Она показывает цену неравномерности даже при быстром интерфейсе.
Почему GDDR7 нельзя поставить вместо GDDR6
Переход затрагивает контроллер, электрическую сигнализацию, выводы, обучение и команды. Micron прямо указывает отсутствие обратной совместимости GDDR7 с GDDR6 и GDDR6X. Даже совпадение общей ёмкости и близкое расположение корпусов на плате не делает компоненты взаимозаменяемыми.
Замена памяти при ремонте требует точного соответствия артикула либо документированного совместимого варианта, а также поддержки прошивки. Повышенная паспортная скорость отдельного кристалла не заставляет GPU выбрать новый режим. Контроллер и плата могли быть спроектированы под другой предел.
Следовательно, «апгрейд перепайкой до GDDR7» для обычной карты предыдущего поколения является неверным упрощением. Реалистичное улучшение производится в рамках поддерживаемой аппаратной конструкции и подтверждается испытаниями. Для диагностики полезнее сначала определить характер сбоя: дефект массива, питания, контакта или передачи. Замена исправной микросхемы на более быструю не устраняет плохую дорожку или неверное напряжение.
Что подтверждено в продуктах к дате сверки
GDDR7 применяется в продаваемых видеокартах: NVIDIA указывает для GeForce RTX 5090 32 ГБ GDDR7 и эффективный интерфейс 512 бит. Это подтверждает конкретную конфигурацию продукта, но не максимальную скорость всех будущих карт и не обещание пропорционального роста кадров.
Samsung в октябре 2024 года объявляла разработку 24-Гбит GDDR7 до 40 Гбит/с с возможностью 42,5 при определённых условиях. Более поздний отчёт компании за первый квартал 2026 года отдельно фиксирует начало производства 24-Гбит GDDR7 в январе 2025 года. Исторический план и последующее сообщение о производстве являются разными свидетельствами; максимальную скорость семейства всё равно проверяют для нужного артикула.
В открытом каталоге Samsung указаны плотности до 24 Гбит и скорость семейства до 40 Гбит/с. Cadence предлагает PHY IP с собственными пределами и условиями интеграции. Наличие IP не доказывает наличие готовой DRAM или массовой карты с той же цифрой. Для выбора оборудования нужны параметры и доступность конечного изделия.
Как оценивать пользу без ложных выводов
Проверку начинают с фактической частоты, типа памяти, ширины интерфейса и ёмкости карты. Затем выбирают задачу, размер данных и стабильные настройки GPU. Синтетический поток помогает исследовать предел памяти, а реальная нагрузка показывает, насколько этот ресурс важен приложению.
Нужны несколько режимов: помещающийся в кэш набор, большой последовательный поток, менее регулярные обращения и длительная задача после прогрева. Отдельно фиксируют ошибки и изменения частоты. Рост частоты при падении полезной производительности требует проверки устойчивости и повторных передач, а не объявления успешного разгона.
Главная инженерная идея GDDR7 — согласованное изменение кодирования и организации обмена. Трёх уровней недостаточно без правильного такта, упаковки, каналов и контроля. Когда все части согласованы, стандарт даёт заметный запас полосы через обычное размещение памяти на плате. Практический результат определяется тем, сколько этого потока конкретная задача действительно использует и насколько устойчиво работает вся конструкция.
При публикации результатов важно указывать, что именно называется скоростью: символы физической линии, эффективные биты логического разряда, байты устройства или полезный поток приложения. Все четыре числа могут одновременно быть верными и заметно различаться. Ясные единицы позволяют проверить вывод независимо от красивой диаграммы и уберегают от двойного подсчёта преимуществ кодирования. Это особенно полезно при сравнении GDDR7 с другими видами памяти.
Первичные источники
Использованы открытые материалы JEDEC, изготовителей DRAM, разработчика интерфейсного IP и производителя GPU. Рисунки и расчёты подготовлены для статьи; схема состояний не является нормативной таблицей кодирования.
- JEDEC: официальное объявление JESD239 GDDR7
- Micron: GDDR7, защита и отсутствие обратной совместимости
- Micron: PAM3 и компромисс информационной плотности
- Cadence: физическая организация, burst и кодеки, сентябрь 2026
- Cadence: WCK, CK4, RCK и тренировка интерфейса
- Cadence: проверка протокола и независимые каналы
- Cadence: интерфейсный PHY GDDR7
- SK hynix: внутренняя схемотехника и T-coil GDDR7
- Samsung: разработка 24-Гбит GDDR7, октябрь 2024
- Samsung: отчёт 2026 с историей производства GDDR7
- Samsung: текущий открытый каталог GDDR
- NVIDIA: конфигурация памяти GeForce RTX 5090