HBM4: широкая шина, логический базовый кристалл и цена близости к GPU
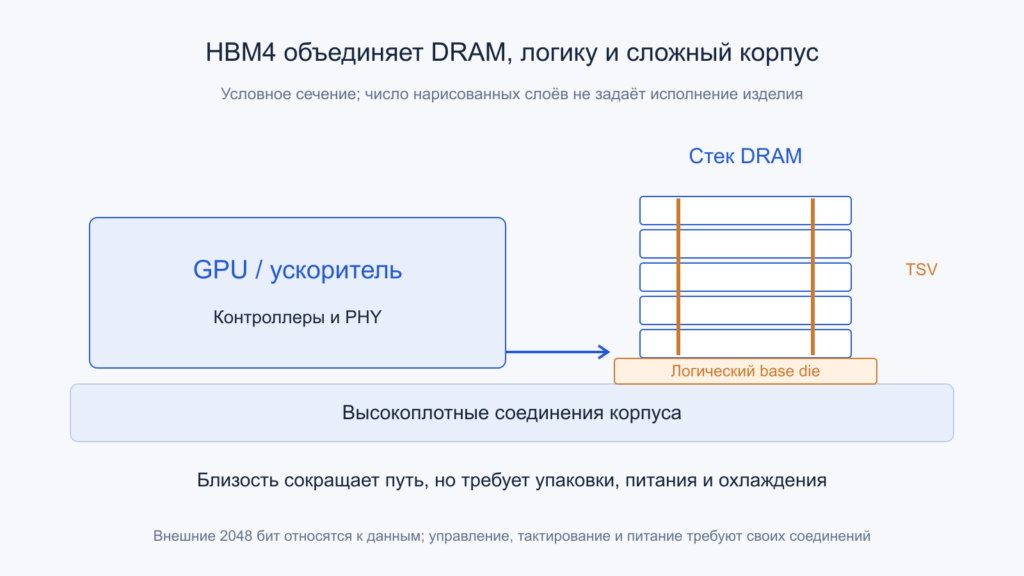
Архитектурная иллюстрация без масштаба и привязки к конкретной упаковке. Число изображённых слоёв условно. Открыть иллюстрацию в полном размере.
HBM4 интересна не только очередным рекордом терабайтов в секунду. В этом поколении меняется организация связи памяти с вычислителем: внешний интерфейс расширяется до 2048 бит, возрастает число каналов, а базовый кристалл становится важной частью совместного проектирования DRAM, логики и корпуса. Ускоритель получает больше возможностей доставлять данные, но одновременно требует более сложной разводки, питания и отвода тепла.
Разберём, что именно даёт эта архитектура и где заканчивается действие большой паспортной цифры. Состояние продуктов и публичных заявлений проверено на 26 октября 2026 года. Все расчётные сценарии ниже условные: это инженерные модели, а не испытания оборудования владельца сайта.
Содержание статьи
- Стандарт, образец и серийная поставка означают разные вещи
- 2048 бит: ширина данных, а не число всех соединений
- Каналы и псевдоканалы дают дополнительные независимые работы
- Как пересчитать скорость вывода в полосу стека
- Базовый кристалл соединяет два разных технологических мира
- Число нанометров не является общей мерой качества стека
- TSV и этажность не складывают полосу арифметически
- Близость к GPU требует дорогой инфраструктуры соединений
- Пиковая полоса требует подходящего потока команд
- Почему одной низкой задержки недостаточно
- Обновление DRAM и локальность остаются частью расписания
- Ёмкость и полоса расходуются по разным причинам
- Более быстрая память переносит границу узкого места
- Тепловая задача включает весь стек и соседнюю логику
- Энергия на бит и мощность всей памяти не тождественны
- Надёжность — отдельный ресурс системы
- Годный кристалл ещё не означает годный большой корпус
- Будущие тепловые решения нельзя задним числом объявлять свойством HBM4
- Официальные первичные источники
- Читайте также
Стандарт, образец и серийная поставка означают разные вещи
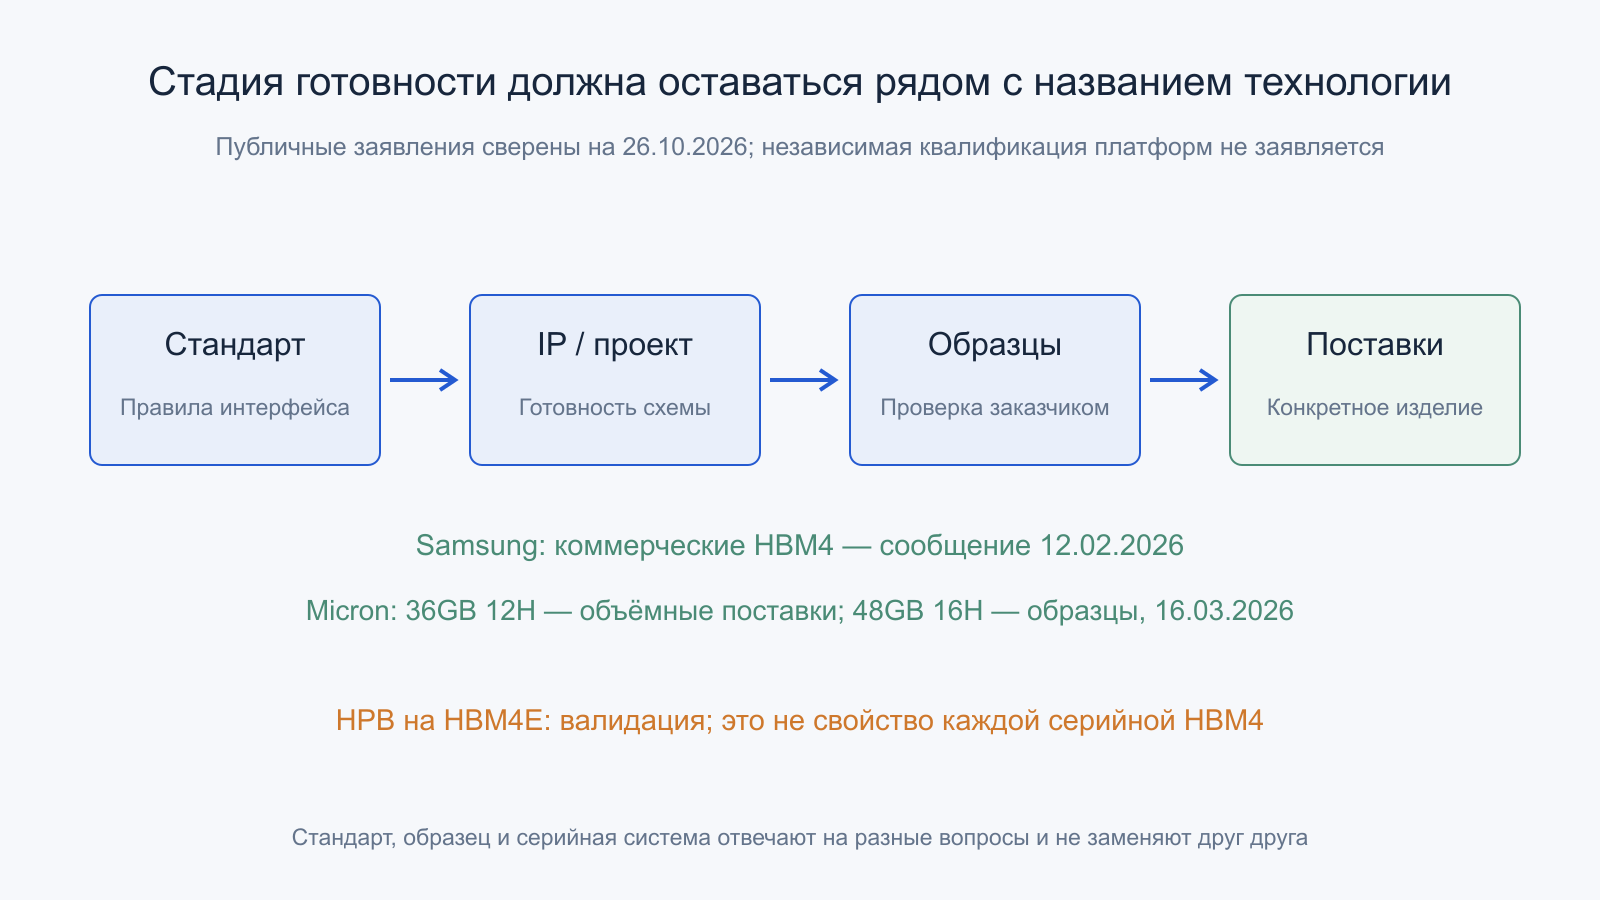
Название HBM4 обозначает семейство стандартизованной памяти, но не один неизменный товар. Стандарт определяет согласуемые правила интерфейса; разработчик DRAM создаёт конкретный стек, поставщик IP — контроллер и физический интерфейс, а изготовитель ускорителя объединяет их в корпусе. Готовность каждого участника наступает в своё время. Доступность проекта PHY ещё не означает наличие серийной видеокарты с этим PHY.
На указанную дату существуют именно заявления о коммерческом выпуске. Samsung 12 февраля 2026 года сообщила о начале массового производства и поставках коммерческих HBM4. Micron 16 марта описала объёмные поставки варианта 36 ГБ 12H с первого календарного квартала. Это сведения производителей, а не независимое подтверждение характеристик каждой конечной системы.
В том же сообщении Micron вариант 48 ГБ 16H назван образцами, переданными заказчикам. Разница существенна: получение образца позволяет проверять интеграцию, но не гарантирует доступный объём закупок или завершённую квалификацию платформы. Сопоставлять нужно одинаковые стадии, даты и исполнения, сохраняя эти уточнения рядом с цифрами.
2048 бит: ширина данных, а не число всех соединений
Главное архитектурное изменение обычной HBM4 — 2048 разрядов внешнего интерфейса данных вместо 1024 у HBM3. Это число нельзя читать как полный список контактов корпуса. Питание, земля, тактирование, управление, тестирование и другие необходимые сигналы также требуют физических соединений. Планирование корпуса не сводится к размещению ровно 2048 одинаковых проводников.
Расширение шины повышает совокупную передачу без обязательного удвоения скорости каждого вывода. Однако оно увеличивает площадь интерфейсной области, число одновременно переключающихся цепей и объём работы по их согласованию. Удвоить разрядность в таблице легко; разместить соответствующие драйверы, приёмники, питание и межкристальные соединения на ограниченном периметре значительно сложнее.
Важно также определить, о какой границе идёт речь: о внешнем интерфейсе одного стека или обо всей памяти ускорителя. Восемь стеков не образуют один произвольно адресуемый провод шириной 16384 бита. За их согласованным использованием стоят контроллеры, распределение адресов и внутренняя сеть вычислительного кристалла. Ошибка на этом уровне способна оставить часть внешней полосы невостребованной.
Каналы и псевдоканалы дают дополнительные независимые работы
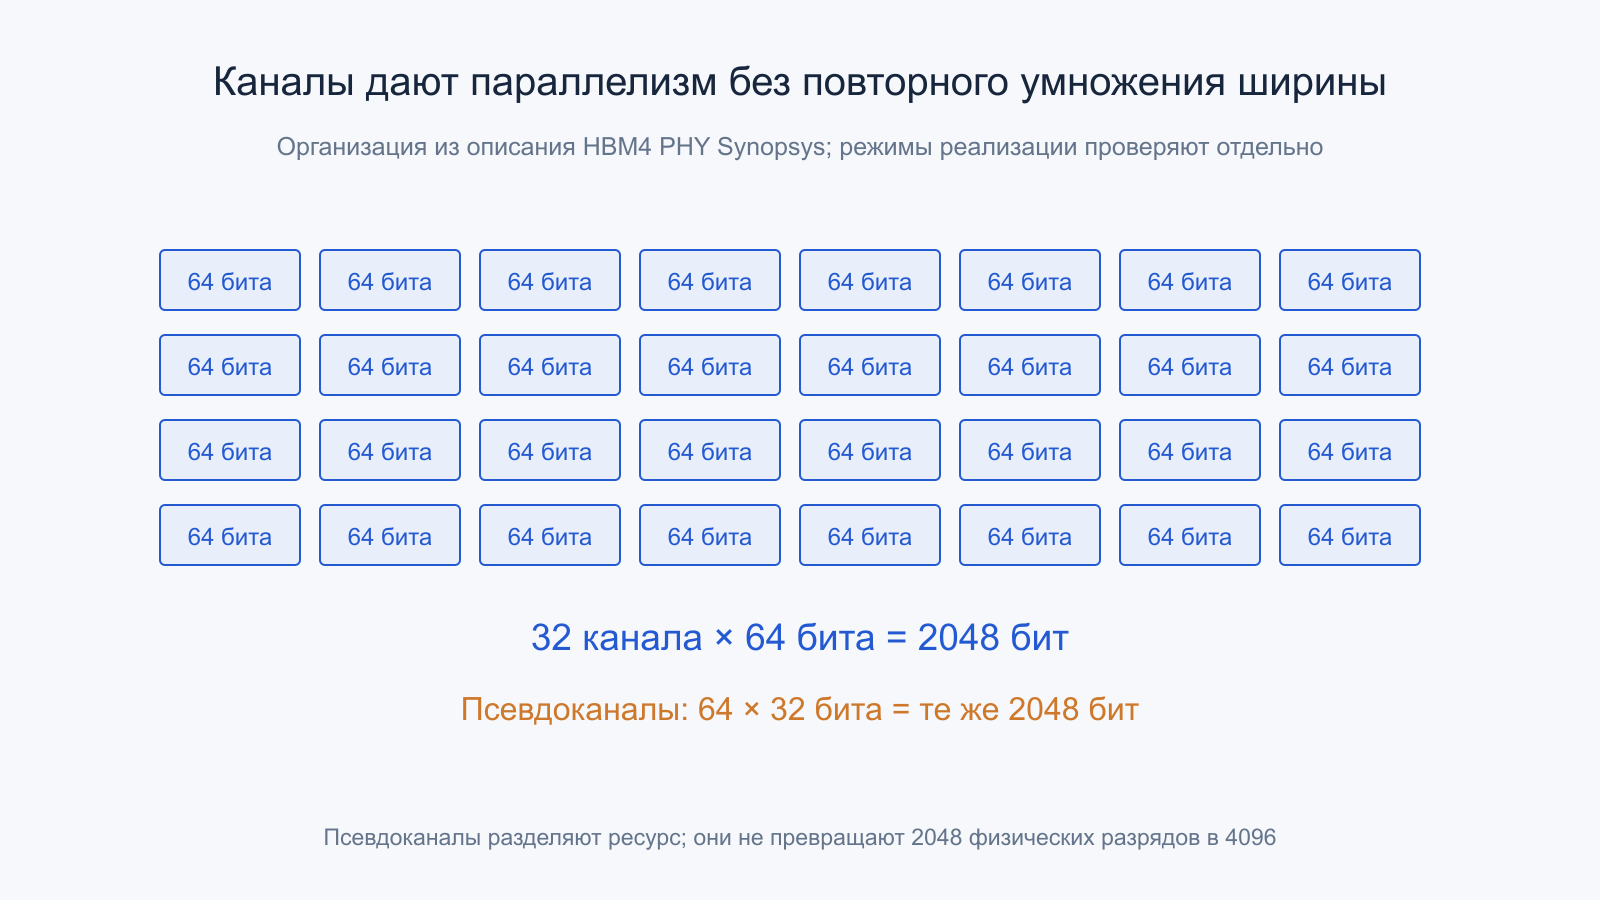
В опубликованном описании HBM4 PHY Synopsys интерфейс организован как 32 независимых 64-битных канала, с возможностью 64 псевдоканалов по 32 бита. Произведения 32×64 и 64×32 дают те же 2048 бит. Псевдоканалы не удваивают эту ширину повторно: они иначе разделяют доступный ресурс.
Независимость полезна, когда одновременно есть достаточно запросов к разным областям. Один канал может ожидать подготовку строки, пока другой передаёт уже доступные данные. Но это не означает полной независимости питания, тактирования и всех командных ограничений. У физически общего стека остаются общие условия, а конкретные правила задаются применимой спецификацией и устройством.
Приложение обычно не выбирает номер псевдоканала в каждом машинном обращении. Контроллер сопоставляет адреса каналам и банкам, планирует команды и учитывает зависимости. Поэтому распределение объектов, шаг обращения и число одновременных потоков влияют на результат. Больше каналов помогает широкому потоку независимых работ; последовательная цепочка зависимых чтений может почти не воспользоваться этим параллелизмом.
Как пересчитать скорость вывода в полосу стека
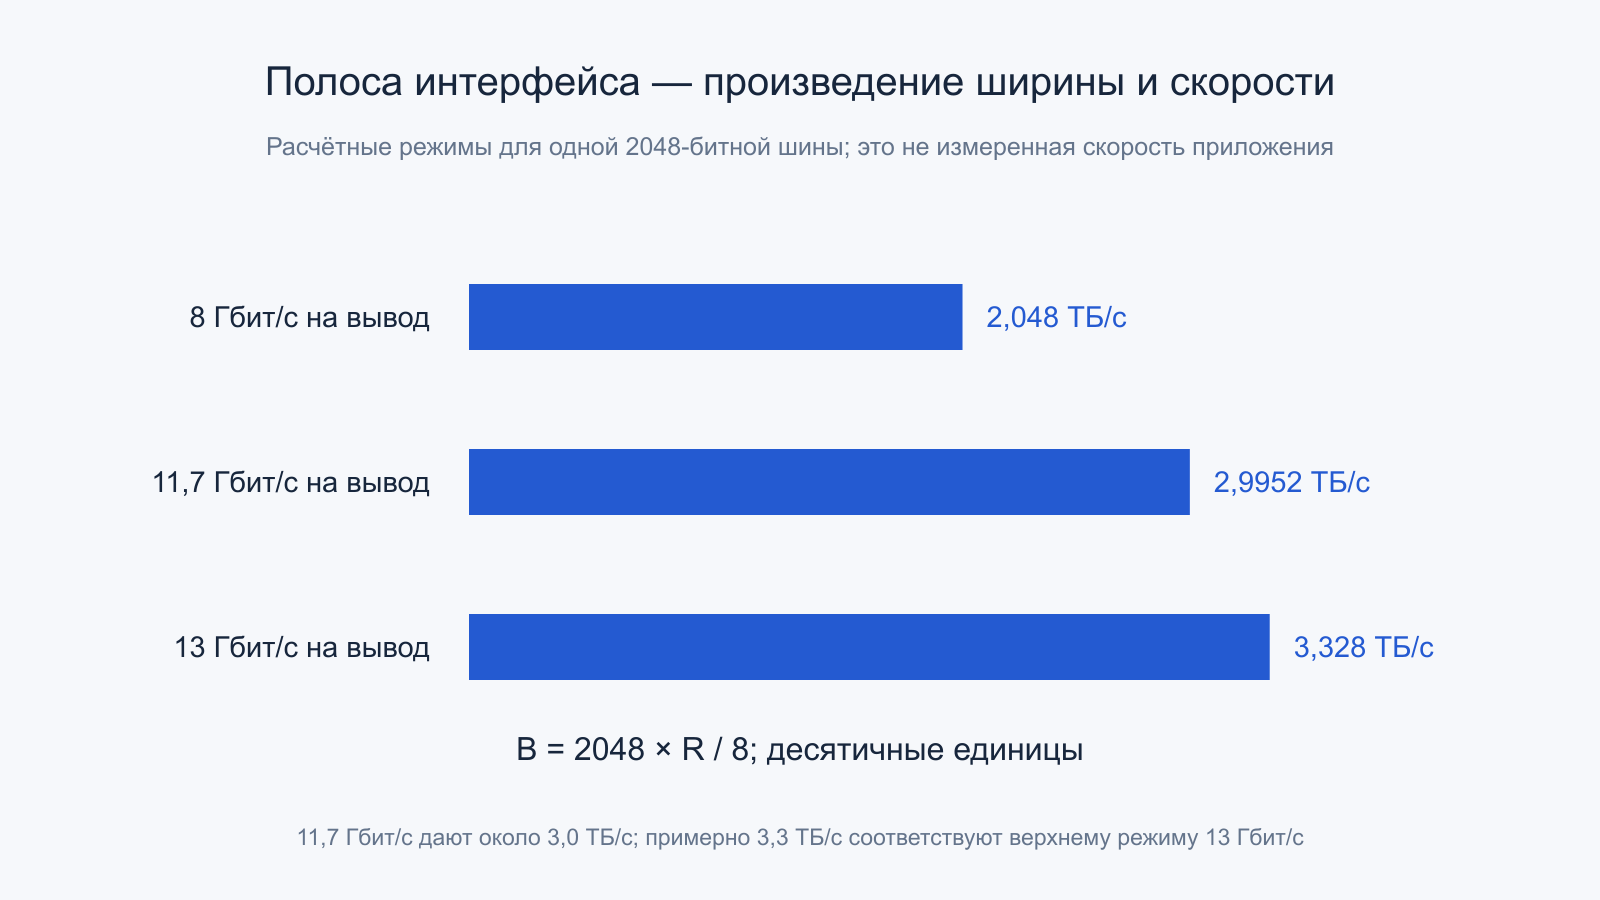
Для учебной оценки используется выражение B = W×R/8, где W — число информационных разрядов, а R — передаваемые биты в секунду на разряд. При 2048 битах и заданных 8 Гбит/с получается 2048 ГБ/с, или 2,048 десятичных ТБ/с. Дополнительно умножать R на два из-за слова DDR нельзя: в скорости передачи уже учтены передаваемые биты.
При условных 11 Гбит/с та же арифметика даёт 2816 ГБ/с. Для 11,7 получается 2995,2, а для 13 —3328 ГБ/с. Поэтому заявление Samsung о максимальных примерно 3,3 ТБ/с относится к верхнему режиму, а не автоматически к каждому случаю работы на 11,7 Гбит/с. Маркетинговое округление и выбор режима нужно видеть отдельно.
Эти произведения описывают доступную передачу интерфейса, а не полезный поток приложения. В них отсутствуют простои, команды подготовки, переключение направлений и ограничения доступа к массиву. Для сравнения разных продуктов требуются одинаковая конфигурация, направление, граница счёта байтов и условия. Число «ТБ/с» без этих пояснений легко превращается в сравнение разных свойств.
Базовый кристалл соединяет два разных технологических мира
Внизу стека расположен base die, через который память взаимодействует с внешней системой. Верхние кристаллы оптимизируются прежде всего под плотное хранение DRAM; нижний должен обслуживать интерфейс и сопутствующую логику. Разделение позволяет выбирать для этих задач разные процессы изготовления, вместо требования одинаково хорошо реализовать их на одной технологической платформе.
В соглашении SK hynix и TSMC 2024 года переход к передовому логическому процессу для базового кристалла HBM4 объяснялся возможностью разместить дополнительные функции в ограниченной площади. В документе также связаны разработка памяти и интеграция CoWoS. Это описание направления сотрудничества, а не основание приписать всем стекам одинаковый техпроцесс.
Само наличие логического основания не превращает обычную HBM4 в универсальный процессор внутри памяти. Состав функций определяется реализацией и договорённостями участников. Утверждения о пользовательских вычислительных блоках, сжатии или специализированной обработке требуют отдельного документа. Нельзя автоматически добавлять их к любому продукту только потому, что базовый кристалл теперь производится логической фабрикой.
Число нанометров не является общей мерой качества стека
Samsung в сообщении о коммерческой HBM4 отдельно называет DRAM поколения 1c и базовый кристалл логического процесса 4 нм. Это две технологические характеристики разных частей изделия. Обозначение 1c нельзя переводить в буквальный размер одного транзистора, а число 4 нм не описывает геометрию всех ячеек памяти сверху.
Передовой логический процесс может помочь плотности интерфейсных и управляющих схем. Но итог определяется также библиотеками, допустимыми напряжениями, разводкой питания, аналоговыми свойствами PHY и производственными ограничениями. Уменьшение цифровой логики не гарантирует такого же уменьшения каждого драйвера вывода или площади контактов. В широком интерфейсе геометрия соединений остаётся самостоятельным ограничением.
Для сравнения полезнее видеть конкретные возможности: число поддерживаемых каналов, режимы передачи, энергозатраты при одинаковой нагрузке, тепловые условия и доступное исполнение. Обещать пропорциональное ускорение от отношения технологических обозначений нельзя. Два базовых кристалла могут использовать разные инженерные компромиссы и при этом соответствовать совместимому интерфейсу памяти.
TSV и этажность не складывают полосу арифметически
Through-Silicon Via — вертикальное соединение через кремний. В стеке такие связи позволяют передавать сигналы и питание между уровнями, не выводя каждый путь длинной дорожкой по краю всех кристаллов. Важно различать внутреннюю вертикальную организацию и горизонтальный интерфейс между стеком и вычислителем: это разные участки общей системы.
Обозначения 12H и 16H относятся к числу слоёв DRAM в соответствующем исполнении; логическое основание обычно описывают отдельно. Если в учебном стеке каждый слой добавляет 3 ГБ, двенадцать дают 36 ГБ, шестнадцать —48 ГБ. Это модель ёмкости с выбранной плотностью, а не универсальный размер любого слоя HBM4.
Четыре дополнительных слоя не превращают 2048 внешних разрядов в 2731. Ёмкость, число доступных внутренних ресурсов и внешняя полоса связаны архитектурой, но не одним коэффициентом. Более высокий стек усложняет тепловую и механическую задачу. Нужно удержать нужную высоту, соединить больше уровней и сохранить пригодность всей сборки, а не только изготовить отдельные исправные кристаллы.
Близость к GPU требует дорогой инфраструктуры соединений
Обычная 2,5D-компоновка размещает вычислительный кристалл и стеки памяти рядом на общей высокоплотной инфраструктуре. Короткие соединения помогают реализовать широкую шину. Однако слово «рядом» не означает, что все линии равны нулю по длине или электрически идеальны. У них есть сопротивление, ёмкость, индуктивность, взаимное влияние и требования к возвратным токам.
Интерпозер, локальные мосты и перераспределительные слои представляют разные подходы к этой задаче. Конкретный корпус может комбинировать их; название HBM4 не определяет единственную обязательную конструкцию упаковки. Графическая схема с одним сплошным прямоугольником удобна для объяснения, но не доказывает устройство реального изделия. Подложка корпуса и интерпозер также не являются одним и тем же уровнем.
Размещение PHY влияет на компоновку вычислителя. Нужно согласовать выводы, длины трасс, питающие области и зоны для тестирования. Увеличение числа стеков требует дополнительного места вокруг логики и ресурса внутри неё. Поэтому решение «добавить ещё память» затрагивает весь корпус и может оказаться ограничено его геометрией раньше, чем числом доступных DRAM-кристаллов.
Пиковая полоса требует подходящего потока команд
DRAM обслуживает обращения через строки, банки и команды подготовки. Последовательная передача уже открытой области отличается от коротких обращений с постоянной сменой нужных строк. Контроллер старается использовать локальность и параллелизм, но не может отменить зависимости между командами. Поэтому одинаковое число байтов в двух программах не означает одинакового времени их доставки.
Переход от чтения к записи тоже имеет цену организации транспорта. Произведение ширины на скорость нельзя одновременно считать независимым полным максимумом для чтения и ещё таким же максимумом записи через те же двунаправленные линии. В отчёте нужно указать состав потока и способ подсчёта общего трафика. Иначе сумма двух направлений создаст несуществующий выигрыш.
Полезный измеритель должен различать байты, запрошенные программой, данные после кэширования и реальный обмен через интерфейс HBM. Один запрос способен породить дополнительный трафик, а попадание в кэш — устранить внешний обмен. Без названной границы сравнение с пиком интерфейса не показывает даже степень его использования, не говоря уже о причине возможного ограничения.
Почему одной низкой задержки недостаточно
Чтобы занять очень широкую память, в полёте должно находиться достаточно независимых обращений. Учебная система с полезным темпом 3 ТБ/с и средней длительностью обслуживания 300 нс требует примерно 900000 байт незавершённой работы через рассматриваемую границу. Это произведение темпа на время, около 879 КиБ, а не указание точного числа аппаратных очередей.
При независимых порциях по 256 байт получается приблизительно 3516 порций одновременно. Зависимость следующего адреса от предыдущего ответа не позволяет одной цепочке создать такой поток. Несколько потоков, предварительная выборка и обработка крупных массивов могут помочь, но конкретное число запросов определяется аппаратурой и характером обращений. Вычислители также должны успевать принимать результат.
Из этой модели нельзя заключить, что реальная HBM4 имеет задержку ровно 300 нс. В неё намеренно включена условная длительность всего выбранного пути. Механизм показывает другое: рост пикового темпа увеличивает требования к параллелизму. Если приложение не создаёт независимой работы, более широкая шина может оставаться свободной при вполне исправной памяти.
Обновление DRAM и локальность остаются частью расписания
Ячейка DRAM сохраняет состояние ограниченное время, поэтому массив нуждается в обновлении. Контроллер должен согласовать служебную работу с запросами вычислителя. У разных механизмов обслуживания различается охват ресурсов и доступная параллельность; переносить конкретный интервал обновления одной модели на всю HBM4 нельзя. Существенны также температурные условия и поддерживаемые режимы устройства.
Обновление не следует представлять как обязательную одновременную остановку всех стеков на одну и ту же длительность. Но нельзя и удалить его из устойчивой производительности на основании того, что короткая последовательная передача оказалась быстрой. Планировщик распределяет реальные ограничения во времени. При длинной нагрузке наблюдение должно охватывать достаточный интервал, включая повторяющееся обслуживание, а не только удобный начальный фрагмент.
Банковая локальность также создаёт компромисс. Объединение обращений к открытой строке может уменьшать подготовительную работу, однако чрезмерное ожидание удобных команд задерживает другие потоки. Политика контроллера балансирует пропускную способность, зависимости и справедливость. Средний высокий темп поэтому не раскрывает хвост задержек отдельного запроса. Для задач, чувствительных ко времени ответа, полезно смотреть распределение, а не только сумму прочитанных гигабайтов.
Ёмкость и полоса расходуются по разным причинам
Память может ограничивать задачу объёмом, темпом обмена либо обоими свойствами одновременно. Восемь учебных стеков по 36 ГБ дают 288 ГБ хранения. При условных 3 ТБ/с на стек сумма интерфейсных пиков составляет 24 ТБ/с. Эти числа описывают разные оси: уменьшение рабочего набора не обязательно уменьшает требуемую полосу в той же пропорции.
Например, переход к короткому формату весов уменьшает один массив, но оставляет активации, метаданные, временные результаты и состояние между запросами. Часть данных может повторно использоваться, другая — постоянно меняться. Поэтому размер файла модели нельзя без поправок делить на полосу и объявлять результат временем всей нейросети. Такое деление относится только к оговорённому переносу.
Если рабочий набор не помещается, обмен с более далёкой памятью способен изменить общую картину. Быстрая HBM4 не делает внешнюю связь столь же широкой. Для оценки нужно увидеть, какие байты действительно остаются рядом с GPU, какие переходят через другой интерфейс и как часто. Баланс ёмкости и полосы выбирают для конкретного режима работы, включая количество одновременно обслуживаемых задач.
Распределение по стекам способно ограничить даже полностью помещающуюся задачу. В учебном примере четыре контроллера обеспечивают по 3 ТБ/с. Если половина обязательных байтов приходится на один контроллер, общий поток не превысит 6 ТБ/с при таком распределении: половина общего темпа должна пройти через его предел 3 ТБ/с. Остальные контроллеры могут иметь свободный ресурс, который без изменения размещения нельзя автоматически передать перегруженному. Это пример неравномерности адресного потока, а не характеристика конкретной системы.
Более быстрая память переносит границу узкого места
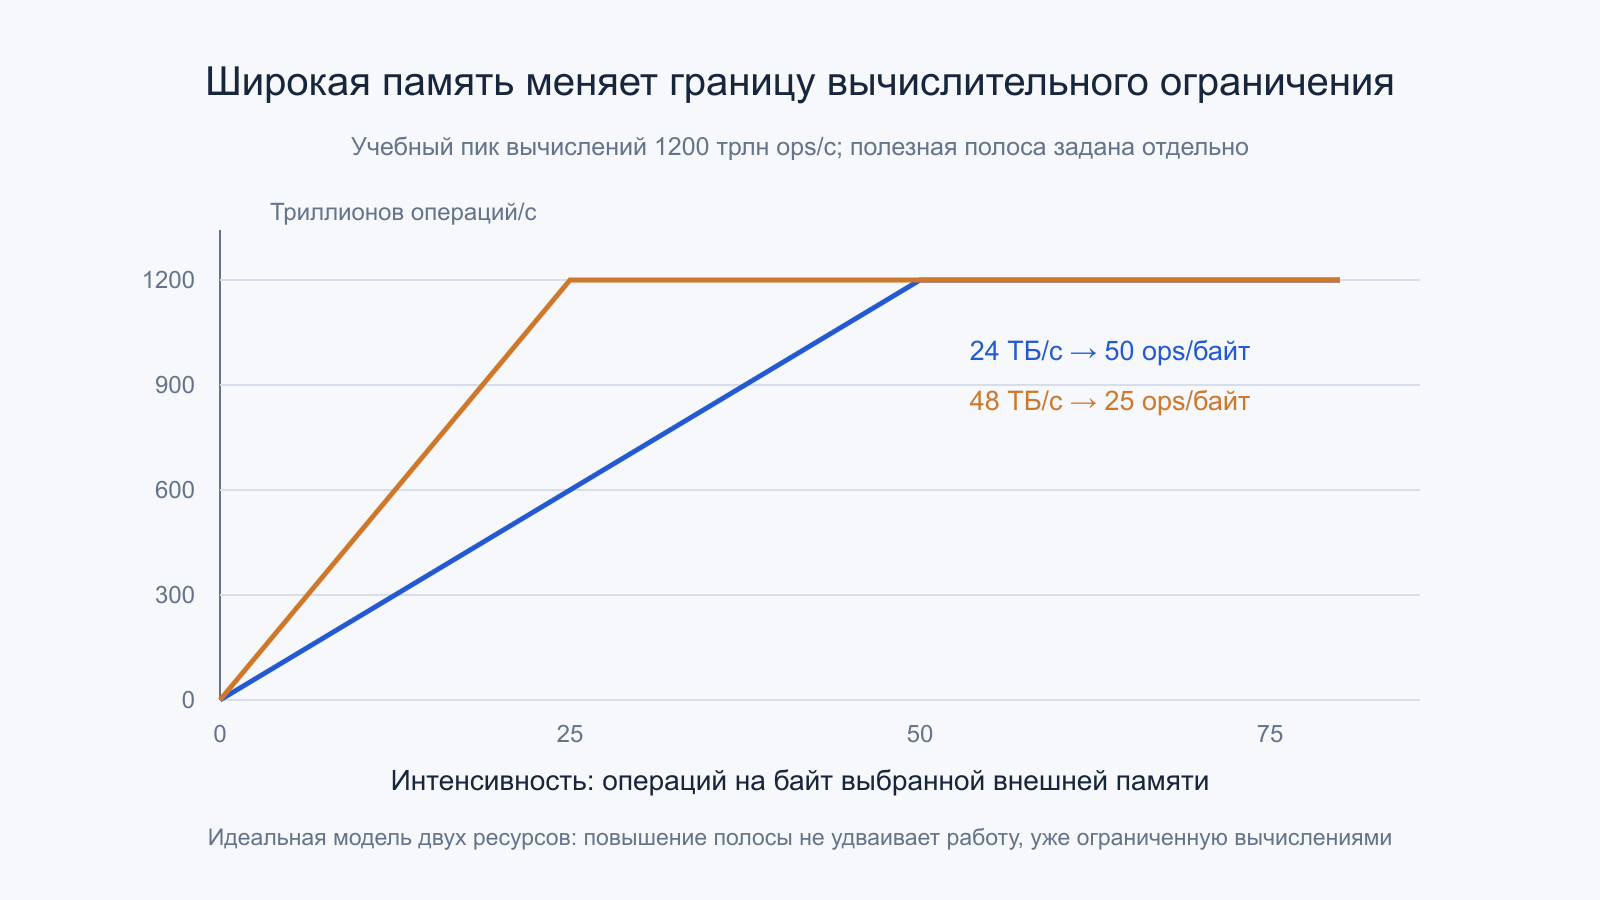
Учебный вычислитель имеет пик 1200 триллионов операций в секунду, а полезная внешняя полоса задана как 24 ТБ/с. Пересечение ограничений находится при 50 операциях на байт. При интенсивности 10 верхняя граница по памяти равна 240 триллионам операций в секунду, при 25 —600, при 50 —1200. Дальше одной памяти недостаточно для дальнейшего роста.
Если удвоить полосу, сохранив вычислительный пик, граница сдвигается к 25 операциям на байт. Нагрузка с интенсивностью 10 теоретически получает более высокий предел, а задача, уже ограниченная арифметикой, не получает автоматического удвоения. Это идеальная модель двух ресурсов; реальные конфликты, последовательные участки и затраты управления добавляют собственные ограничения.
Такой анализ полезен при оценке нового поколения без обещаний универсального ускорения. Нужно измерить обмен именно на выбранном уровне, оценить число полезных операций и выяснить, какую часть времени занимает ограниченный участок. Рост одного паспортного ресурса может просто сделать заметнее предел другой части кристалла или программной системы.
Тепловая задача включает весь стек и соседнюю логику
Тепло выделяется в DRAM, интерфейсных схемах, основании и соседнем ускорителе. Оно проходит через несколько материалов и контактов. Близость уменьшает электрическое расстояние, но одновременно помещает источники нагрева в ограниченную площадь. Верхняя крышка, контактный материал, распределение высот и прижим участвуют в тепловом пути наряду с самим радиатором или холодной плитой.
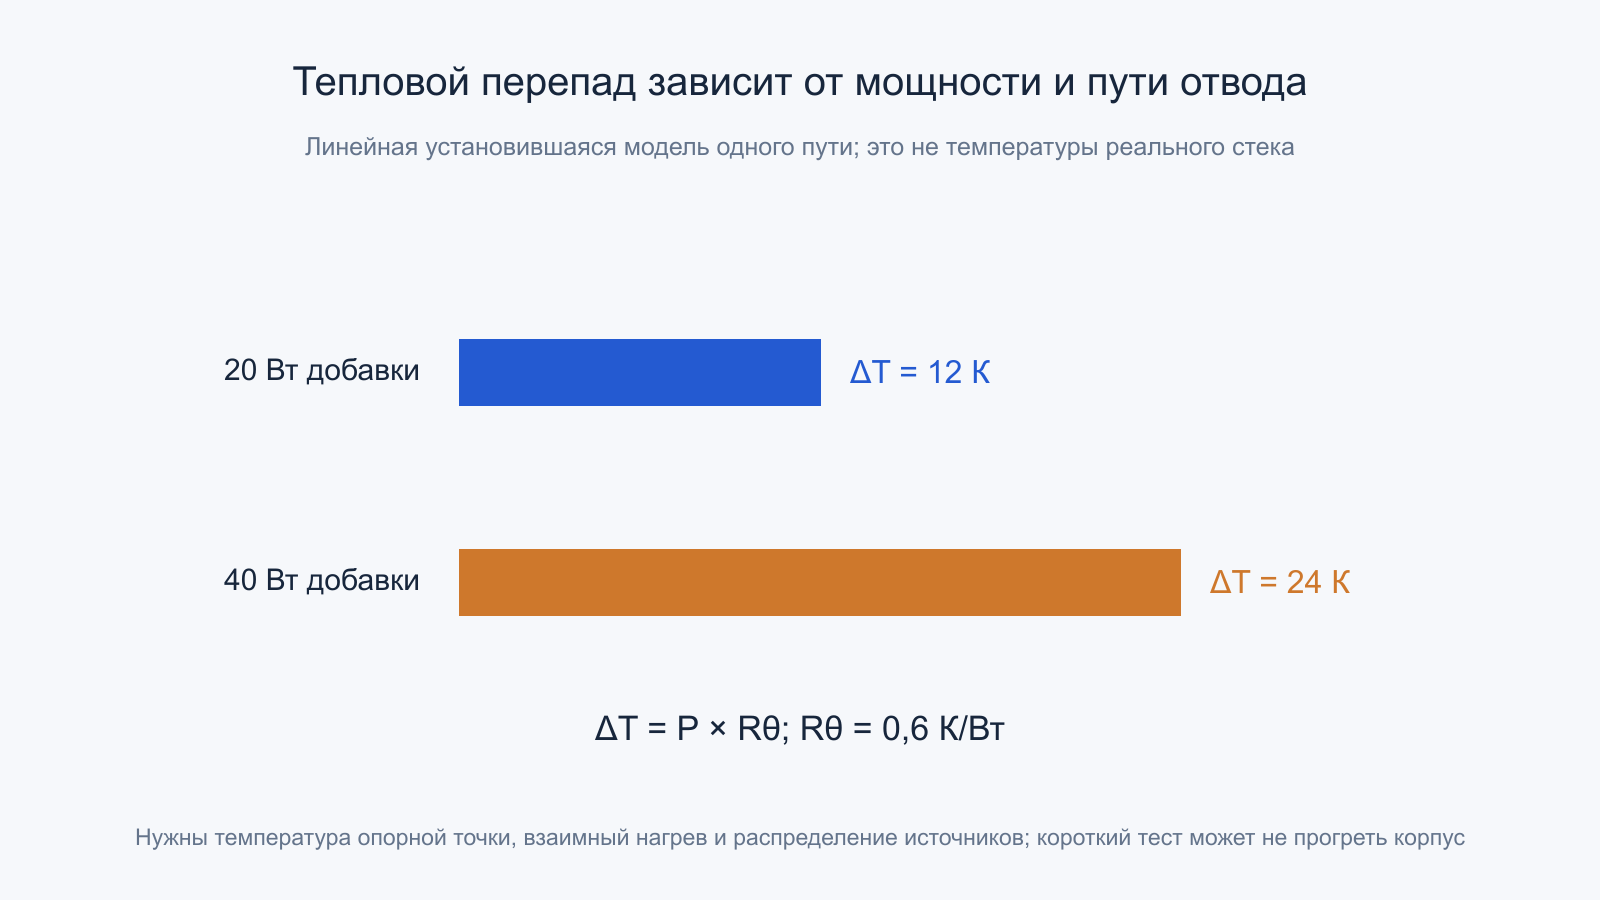
Для простой учебной модели возьмём тепловое сопротивление выбранного пути 0,6 К/Вт. Дополнительные 20 Вт дают установившийся перепад 12 К; при 40 Вт —24 К. Это линейная модель одного пути с постоянными параметрами. Она не описывает полную температуру реального HBM-стека: нужны температура опорной точки, взаимный нагрев и распределение источников.
Именно поэтому заявления об улучшении теплового сопротивления нельзя переводить прямо в такой же процент прироста скорости. Температура зависит от нагрузки и окружающей системы, а режим ограничивается набором допустимых условий. Локальная горячая область может определять предел даже тогда, когда средний датчик корпуса показывает умеренное значение. Нужны определённые точки измерения и длительность нагрузки.
Переходный режим добавляет тепловую инерцию: после включения нагрузки температура не обязана сразу достигать установившегося значения. Короткое измерение может завершиться раньше прогрева всей конструкции. Поэтому для сопоставления указывают начальное состояние, температуру охлаждающей среды и момент регистрации. Даже при одинаковом имени памяти два корпуса с разными тепловыми путями способны поддерживать разные длительные режимы, не противореча параметрам самих DRAM.
Энергия на бит и мощность всей памяти не тождественны
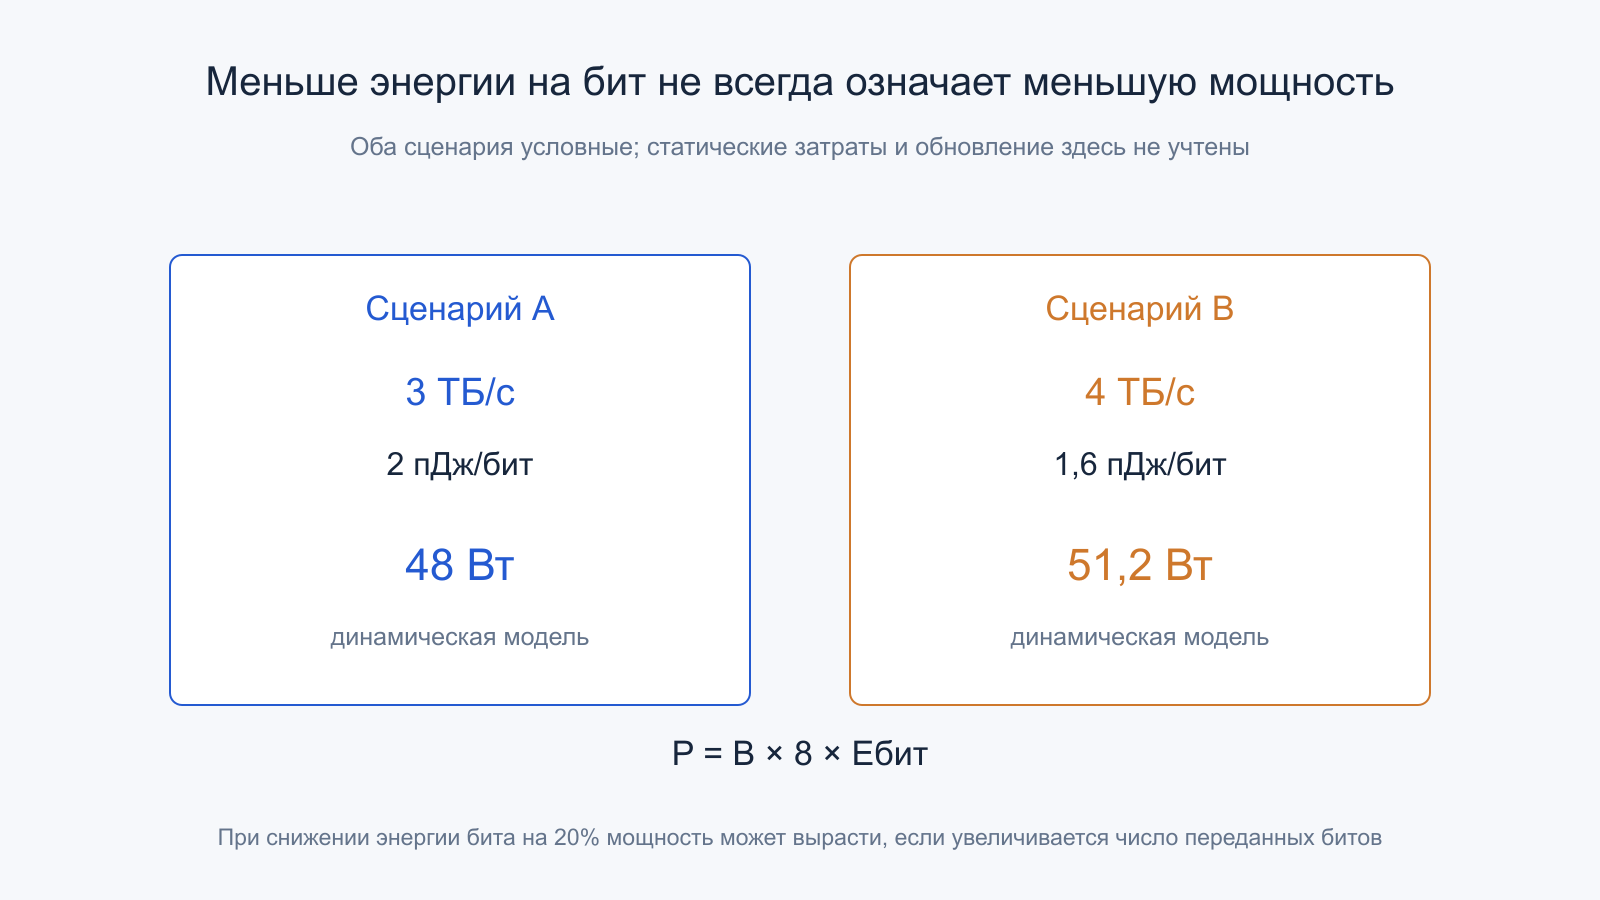
Уменьшение пикоулей на переданный бит полезно, но общий расход зависит ещё и от количества передаваемых битов. В условной модели 3 ТБ/с соответствуют 24 триллионам бит в секунду. При заданных 2 пДж/бит получается 48 Вт динамической составляющей. Это специально выбранные числа, а не энергетический паспорт HBM4 конкретного производителя.
Если темп вырастет до 4 ТБ/с, а энергия снизится до 1,6 пДж/бит, произведение даст 51,2 Вт. Эффективность одного бита улучшилась на 20%, но рассматриваемая мощность выросла из-за большего обмена. Поверх неё могут существовать статические затраты, обновление DRAM и другие функции, которые выбранная формула не учитывает.
На странице Micron HBM4 сравнение эффективности привязано к пДж/бит и сопоставимым скоростям соответствующих 12-слойных вариантов. Это правильный тип оговорки для чтения подобных процентов. Сравнение всего ускорителя требует более широкой границы: экономия интерфейса не равна экономии всех вычислений, охлаждения и питания сервера.
Надёжность — отдельный ресурс системы
Большая память увеличивает количество сохраняемых битов и интенсивность обращения к ним. Исправление ошибок, обнаружение неисправных путей и обслуживание состояния важны не меньше полосы. При этом внутренняя коррекция ячеек, защита интерфейса и сообщаемая системе ошибка относятся к разным уровням. Один механизм не следует автоматически считать защитой всего пути от приложения до DRAM.
Паспорт конкретного ускорителя должен объяснять доступные события, счётчики и реакцию на них. Исправленная ошибка и неисправимая ошибка требуют различной интерпретации; повторение событий в одной области отличается от единичного наблюдения. Без документации нельзя объявить конкретную стратегию резервирования или восстановления обязательной для всех HBM4. Стандарт интерфейса не раскрывает каждую политику платформы.
Надёжность также связана с допустимой температурой и питанием. Достижение красивой скорости в коротком прогоне не подтверждает длительную устойчивость всей сборки. Для серьёзной оценки задают рабочие режимы, длительность, профиль обращений и критерии корректности результата. Производительность полезна тогда, когда система сохраняет требуемую точность и предсказуемо сообщает о выходе за границы исправного состояния.
Крупный объём не следует считать полностью доступным приложению без чтения паспорта платформы. Резервирование, служебные области и политика программного стека могут менять видимую ёмкость. Аналогично сообщение о коррекции не сообщает автоматически, в какой именно микросхеме возникло событие. Интерпретация начинается с документированных счётчиков и их области действия; уверенный диагноз по одному общему числу ошибок был бы необоснованным.
Годный кристалл ещё не означает годный большой корпус
Сборка объединяет множество компонентов и соединений. Поэтому проверять нужно не только DRAM до укладки, но и вертикальные связи, базовый кристалл, интерфейс после интеграции и совместную работу с вычислителем. Known-good die означает определённую проведённую проверку на своей стадии; дальнейшие операции способны добавить новые дефекты. Термин не является обещанием абсолютной безошибочности.
В учебной модели независимая вероятность пригодности одного уже собранного стека равна 0,99. Для восьми одновременно необходимых стеков произведение 0,99⁸ даёт примерно 0,9227. Это не оценка выхода годных HBM4: реальные дефекты зависимы, существуют отбор, ремонт и разные процедуры тестирования. Модель лишь показывает, почему увеличение числа компонентов меняет экономику сборки.
К стоимости добавляются межсоединения, тестовое время, потери дорогих соседних компонентов и доступность упаковочных мощностей. Поэтому цену близости нельзя вывести только из площади DRAM или числа нанометров base die. Конструкция выбирает компромисс производительности, объёма, ремонтопригодности и вероятности успешно получить целую систему. Пользователь ускорителя получает результат этой совместной оптимизации.
Эта интеграция меняет и обслуживание: стек внутри сложного корпуса не является модулем DIMM, который владелец может заменить другим совместимым экземпляром. Возможность заводской доработки, отбраковки или ремонта относится к конкретному производственному процессу. Из архитектурной схемы нельзя вывести доступную пользователю процедуру замены. Поэтому полезно оценивать надёжность и поддержку законченного ускорителя вместе с характеристиками его памяти.
Будущие тепловые решения нельзя задним числом объявлять свойством HBM4
В материале Samsung о COMPUTEX 2026 показан Heat Path Block: выделенный путь отвода тепла от области D2D PHY в базовом кристалле. Документ прямо относит проверку технологии к HBM4E и говорит о планируемом применении в будущей HBM5. Макет и валидация не равнозначны серийному оснащению каждого HBM4.
Аналогично заказной base die, гибридное соединение и вычисления рядом с памятью представляют самостоятельные направления. Их готовность нужно подтверждать отдельно для конкретного продукта. Они не следуют автоматически из расширения шины до 2048 бит. В описании передовой технологии особенно полезны точные глаголы: опубликован стандарт, разработан IP, передан образец, пройдена квалификация, начаты поставки.
Техническая оценка HBM4 поэтому собирается из нескольких согласованных частей: исполнение стека, режим вывода, контроллер, упаковка, питание, тепло и фактический поток приложения. Новое поколение расширяет доступную полосу и возможности интеграции. Насколько они реализуются в задаче, определяют все эти части вместе, а не только максимальное произведение числа выводов на скорость передачи.
Официальные первичные источники
- Samsung — коммерческие поставки HBM4, 12 февраля 2026 года.
- Micron — объёмные поставки 36GB 12H и образцы 48GB 16H, 16 марта 2026 года.
- Synopsys — HBM4 PHY, 32 канала и 64 псевдоканала.
- SK hynix и TSMC — базовый кристалл и совместная интеграция, 2024 год.
- Micron — HBM4: параметры и условия сравнения эффективности.
- Samsung — HBM4E и проверка Heat Path Block на COMPUTEX 2026.