MRDIMM: как мультиплексирование рангов увеличивает полосу серверной памяти
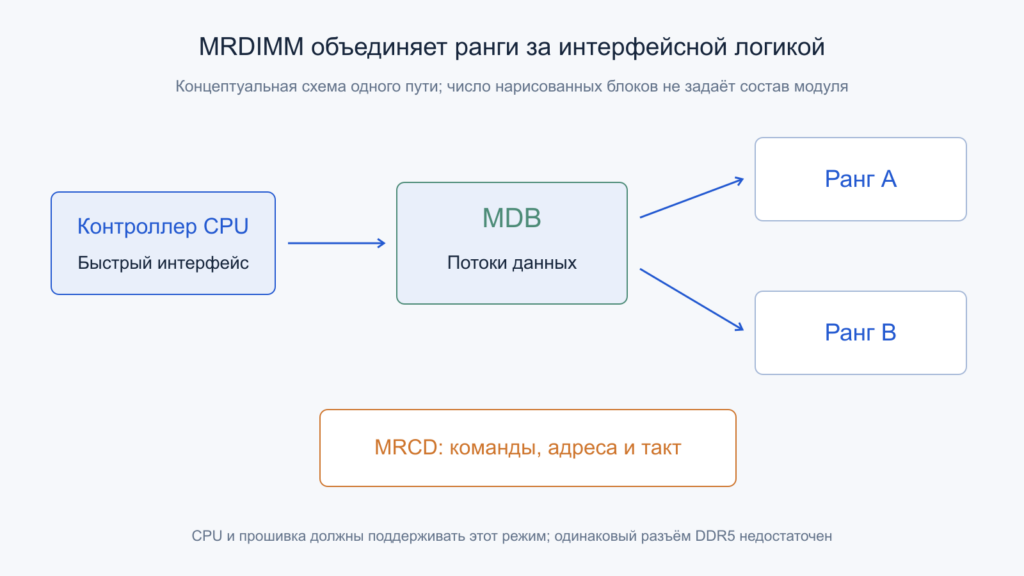
MRDIMM объединяет внутренние потоки за буферами. Для работы необходимы поддерживающие контроллер, плата и прошивка. Открыть иллюстрацию в полном размере.
Серверу с десятками и сотнями ядер мало просто установить больше оперативной памяти. Если каждый запрос ждёт освобождения общей шины, вычислительные блоки простаивают. MRDIMM повышает скорость внешнего интерфейса, объединяя работу нескольких рангов за буферами на модуле. Это интересная инженерная перестройка пути данных, а не обычный разгон DDR5. Разберём её механизмы, ограничения и условия применения. Сведения о продуктах сверены на 26 октября 2026 года; все наши численные примеры являются учебными моделями, а не испытаниями владельца сайта.
Содержание статьи
- Почему дополнительные ранги не удваивают обычную шину
- Два более медленных потока питают один быстрый
- MRCD управляет командной стороной
- MDB разделяет электрические нагрузки и скорость
- Сколько полосы даёт 8800 MT/s
- Почему контроллер должен знать о таком модуле
- Первая реализация и развитие стандартов
- 12800 и 16000 требуют раздельных статусов
- Обучение разделяет несколько временных границ
- Широкий поток не гарантирует короткое чтение
- Необходимое число запросов можно оценить
- Полезная загрузка отличается от занятости проводников
- Чтение и запись конкурируют за направление
- Обновление ячеек остаётся обязательным
- Ёмкость и число рангов связаны через организацию
- Питание буферов нужно считать на уровне задачи
- Тепловая конструкция влияет на устойчивую скорость
- Сбалансированные каналы важнее красивой суммы ёмкостей
- Как проверить конкретную конфигурацию
- Первичные источники и дата сверки
- Читайте также
Почему дополнительные ранги не удваивают обычную шину
Ранг объединяет микросхемы DRAM, которые совместно обеспечивают требуемую ширину интерфейса. Несколько рангов дают контроллеру дополнительные банки и возможность чередовать внутренние операции. Пока один участок памяти восстанавливается после обращения, другой способен готовить следующий запрос. Однако обычная общая шина данных не становится шире от появления дополнительного ранга.
На одном наборе внешних проводников нельзя одновременно передать два независимых значения. Контроллер назначает очередность и соблюдает интервалы переключения. Дополнительные электрические нагрузки также затрудняют достижение высокой скорости. Поэтому увеличение числа рангов улучшает некоторые сценарии параллелизма, но не означает автоматического удвоения внешней полосы.
MRDIMM переносит часть организации обмена на сам модуль. Буферы отделяют нагрузку микросхем DRAM от быстрого интерфейса процессора и объединяют потоки данных. Изменение затрагивает команды, тактирование и расписание передач. Принципиально важно различать внутреннюю параллельную работу и скорость внешних выводов: именно согласование этих двух сторон создаёт выигрыш, а не одно только количество микросхем.
Два более медленных потока питают один быстрый
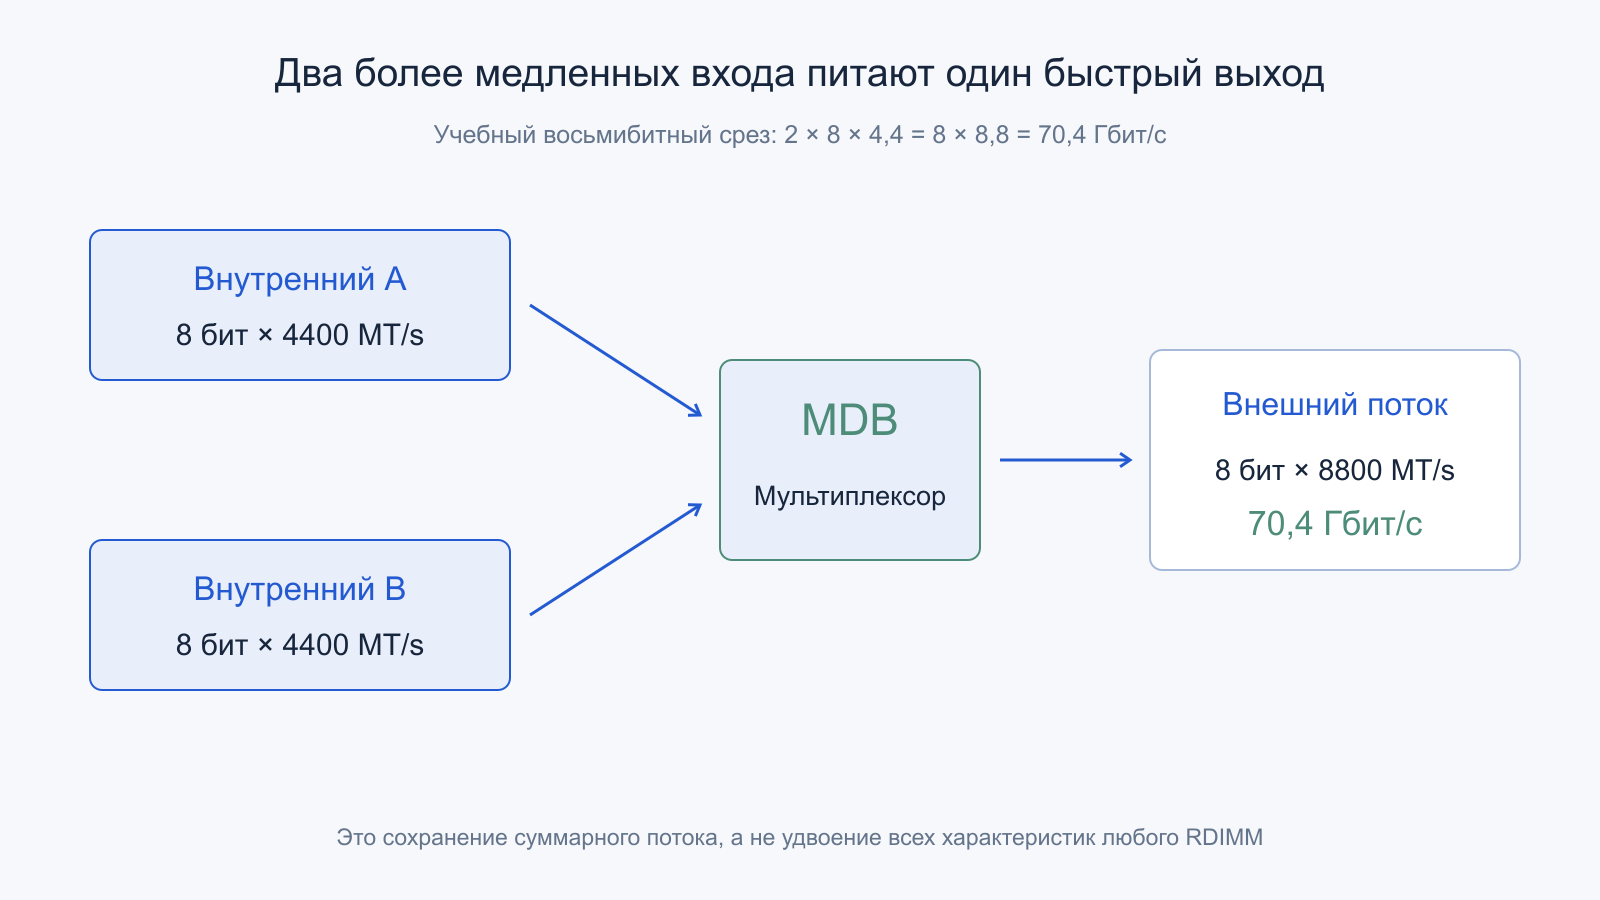
Упрощённо пару рангов можно представить двумя источниками, каждый из которых отдаёт данные с некоторой скоростью. Буфер принимает их параллельно, а на сторону хоста выдаёт чередующимися порциями вдвое быстрее. При записи направление преобразования обратное: быстрый поток распределяется между внутренними получателями.
Для режима первого поколения 8800 MT/s удобно рассматривать внутренние потоки по 4400 MT/s. На уровне условного восьмибитного среза получаем два входа по 8 × 4,4 миллиарда бит в секунду и один выход 8 × 8,8 миллиарда. Суммарная скорость одинакова: 70,4 Гбит/с. Преобразование меняет организацию пути и временной график, но не создаёт информацию из ничего.
Это не означает, что две любые независимые программы получают по отдельному физическому каналу. Контроллер по-прежнему планирует обращения в рамках архитектуры платформы. Детали распределения адресов и размер обслуживаемых порций определяются протоколом конкретного поколения. Схема из двух стрелок объясняет сохранение потока, но не заменяет описание команд и разрешённых последовательностей.
MRCD управляет командной стороной
Multiplexed Registering Clock Driver обслуживает тактовые, адресные, командные и управляющие сигналы. Он помогает распределять операции между внутренними рангами в соответствии с тем, как буферы будут собирать или разделять данные. Несогласованность этих путей дала бы правильные биты от неправильного обращения, поэтому управление является частью основного механизма.
На обычном RDIMM регистр тоже снижает нагрузку командных линий, однако наличие регистра ещё не делает модуль MRDIMM. Здесь требуется поддержка особой организации рангов и взаимодействия с буферами данных. Нельзя заменить единственную микросхему на плате и рассчитывать получить другой класс памяти.
На практике важны начальная настройка, режимы работы, обработка ошибок командного пути и согласование задержек. Увеличение внешней частоты сужает временные окна. Если команды приходят с неправильным фазовым отношением к данным, запас самих линий DQ не спасает обмен. Поэтому комплект интерфейсных компонентов и разводку рассматривают совместно с контроллером процессора и процедурами запуска BIOS.
MDB разделяет электрические нагрузки и скорость
Multiplexed Data Buffer расположен на пути данных между контроллером и DRAM. Он принимает, согласует и перенаправляет порции в соответствии с выбранным рангом. Изоляция внутренней нагрузки помогает быстрому внешнему интерфейсу видеть более управляемые электрические условия.
В опубликованной архитектуре Rambus для MRDIMM 12800 используется один MRCD и десять MDB. Число связано с организацией модуля, включая контрольные разряды, поэтому его нельзя превращать в десять дополнительных независимых каналов CPU. У каждого буфера есть своя часть общего пути; полезная ширина данных при подсчёте пользовательской полосы остаётся отдельной величиной.
Буфер имеет задержку, потребляет энергию и требует корректного обучения. Его присутствие не отменяет ограничений DRAM на активации и восстановление. Если внутренние банки не успевают подготовить достаточно данных, быстрый внешний интерфейс простаивает. Поэтому наблюдаемая скорость зависит от сочетания внутреннего параллелизма, характера адресов и эффективности расписания. Параллельная архитектура помогает только там, где есть работа для её параллельных частей.
Сколько полосы даёт 8800 MT/s
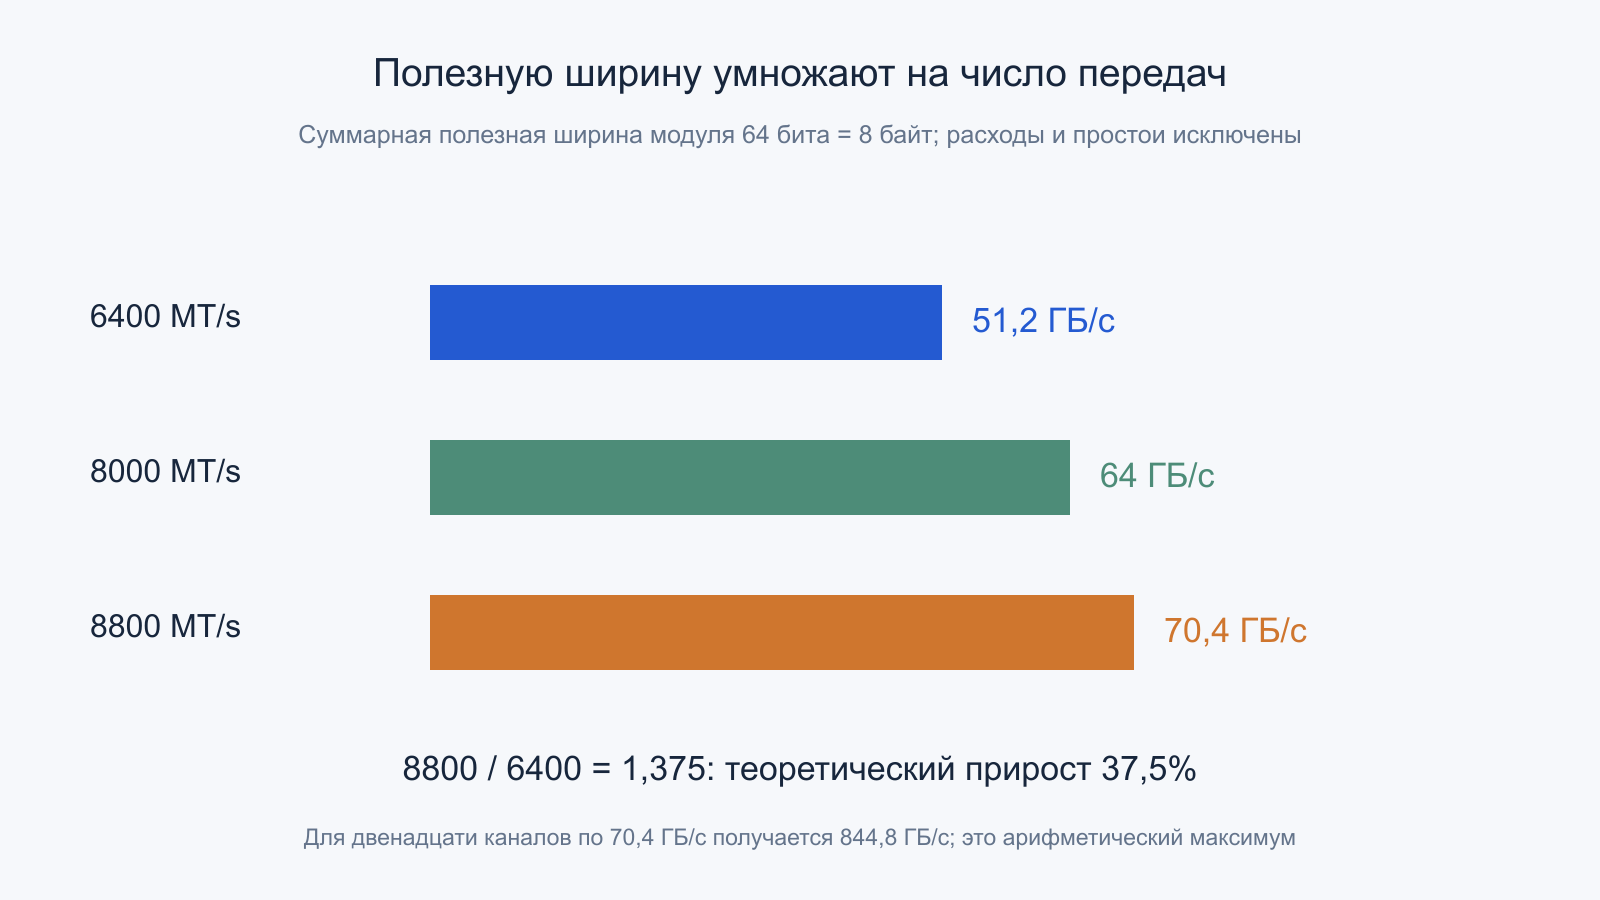
Для модуля с суммарной полезной шириной 64 бита, то есть 8 байт, теоретическая полоса при 8800 MT/s равна 70,4 ГБ/с. При 6400 MT/s получается 51,2 ГБ/с. Отношение равно 1,375: прирост составляет 37,5%, а не сто процентов. Удвоение внутри MRDIMM сравнивает внешний интерфейс с выбранной внутренней скоростью рангов, а не обязательно с самым быстрым сравниваемым RDIMM.
При двенадцати одинаковых каналах арифметический максимум составит 844,8 ГБ/с для 8800 и 614,4 ГБ/с для 6400. Для 8000 получается 64 ГБ/с на канал. Значения десятичные, без вычета простоев, обновления ячеек и разворотов направления. Контрольные разряды ECC в полезные восемь байт здесь не включены.
Число каналов берут из конкретной платформы, а не из максимума всего семейства процессоров. Аналогично нельзя умножать предельную скорость одного артикула памяти на количество разъёмов другой платы. Верхняя оценка полезна для поиска узкого места, но честное сравнение сохраняет одинаковые ёмкость, число каналов, режим доступа и границы измерения.
Почему контроллер должен знать о таком модуле
Механическая совместимость разъёма не равна поддержке протокола. Контроллеру и прошивке платформы нужны процедуры настройки MRDIMM, допустимые режимы команд и соответствующая работа с буферами. Заявление о замене модуля без изменения прикладной программы относится к поддерживаемому серверу, а не ко всем системам с DDR5.
Intel указывает для Xeon 6900P скорость MRDIMM до 8800 MT/s, а для Xeon 6500P и 6700P — до 8000 MT/s. Эти строки нельзя переносить на E-core варианты семейства только из-за общего названия Xeon 6. Micron отдельно предупреждает о несовместимости первого поколения с прежними Xeon.
AMD в своей странице поддержки различает ранние продукты для отдельных Intel Xeon и стандартизируемую технологию MRDIMM. Это полезное напоминание: рыночное имя не является универсальным паспортом совместимости. При выборе проверяют процессор, системную плату, BIOS и точный модуль по списку изготовителя сервера. Наличие одинакового ключа разъёма является только одним из необходимых условий.
Первая реализация и развитие стандартов
Термины MCR DIMM и MRDIMM встречаются в материалах производителей рядом, но история конкретных реализаций важна. Первая платформа с доступной ранговой мультиплексацией и последующая межпроизводительная стандартизация не обязаны иметь одинаковые подробности интерфейса. Поэтому нельзя считать все поколения взаимозаменяемыми по сокращению на наклейке.
В официальном сообщении JEDEC от 30 апреля 2026 года опубликованным назван JESD82-552 для DDR5MDB02, отдельно описаны продвижение MRCD и работа над модульной архитектурой Gen2. Это датированный этап развития, а не утверждение, что все остальные документы навсегда остались проектами. Состояние конкретного стандарта проверяют по его номеру и редакции; стандарт буфера также не тождественен полному стандарту готового модуля.
Для инженера важны одновременно три уровня: правила DRAM, интерфейсная логика и модуль с поддерживающей платформой. Выпуск документа на одном уровне не доказывает готовность каждого изделия на остальных. Такой разбор позволяет обсуждать передовую технологию без смешения утверждённой логики, инженерных образцов и доступного сервера.
12800 и 16000 требуют раздельных статусов
Комплекты MRCD и MDB для 12800 MT/s объявлялись Rambus, Renesas и Montage. Montage в январе 2025 года прямо называла второе поколение инженерными образцами, одновременно указывая объёмные закупки компонентов первого поколения. Это свидетельство разных стадий в конкретную дату, а не основание автоматически сохранить статус образца навсегда.
В июле 2026 года Innodisk объявила MRDIMM 12800 с планом доступности в четвёртом квартале 2026 года. На дату этой статьи квартал уже начался, однако наступление календарного периода само по себе не подтверждает фактическую отгрузку нужного артикула. Для проекта требуется подтверждение поставщика и валидация платформы.
Renesas в июле 2026 года представила третье поколение интерфейсных компонентов до 16000 MT/s: в сообщении указаны образцы для выбранных заказчиков и ожидаемая производственная доступность во второй половине 2027 года. Это план, а не нынешняя серийная скорость любого сервера. Быстрое развитие хорошо видно именно тогда, когда стадии названы явно.
Обучение разделяет несколько временных границ
В модуле с буферами существуют внешняя граница контроллер–MDB и внутренние границы MDB–DRAM. Каждая имеет собственные задержки проводников, разброс выводов и условия выборки. Поэтому настройка одного идеального строба для всей схемы не описывает реальную процедуру запуска. Требуется согласовать несколько путей так, чтобы порции от разных рангов собирались в правильной последовательности.
Для учебного примера два внутренних фрагмента готовы через 12 и 14 условных тактов. Если начать внешний вывод сразу после двенадцатого такта, данные второго фрагмента ещё не существуют. Буфер должен удержать ранний результат и дождаться согласованного момента либо использовать предусмотренный протоколом график. Эта иллюстрация не задаёт реальные тайминги DRAM, а показывает разницу между высокой установившейся скоростью и первой готовностью результата.
Обучение определяет подходящие фазовые положения и опорные уровни при заданных электрических условиях. Слишком узкое окно может позволить успешно стартовать одному экземпляру и сделать соседний нестабильным. Поэтому производственная проверка включает допустимый разброс, а прошивка должна правильно обрабатывать случаи, когда требуемый режим недостижим. Повторные попытки запуска не должны маскировать отсутствие устойчивого запаса.
После изменения числа модулей или версии BIOS время и результат обучения могут поменяться. Для администратора полезно сохранять журнал установленной конфигурации и фактических режимов, а для разработчика — отдельные результаты по границам. Это сокращает поиск причины, когда общая ошибка памяти вызвана внешним трактом, внутренним рангом или неверным расписанием, а не дефектной ячейкой.
Широкий поток не гарантирует короткое чтение
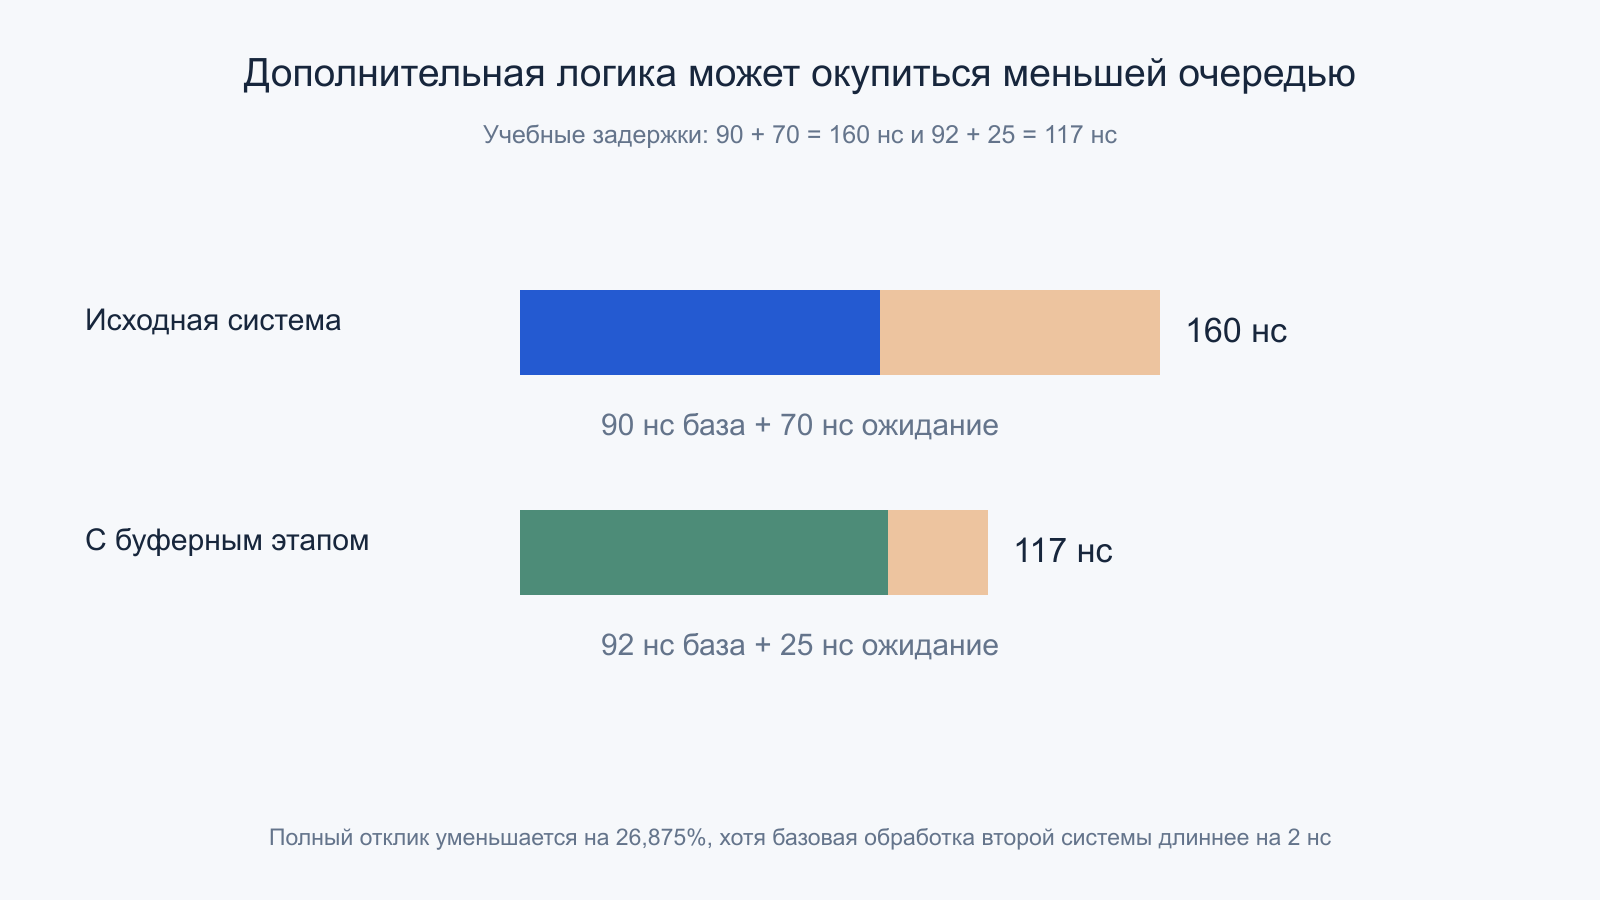
Время одиночного обращения включает путь через контроллер, команды DRAM, подготовку данных и возврат. MRDIMM добавляет интерфейсную логику, но способен уменьшать ожидание на загруженной шине. Поэтому задержку без нагрузки и задержку при большом числе запросов следует измерять отдельно.
Представим учебный случай. Исходная обработка без очереди занимает 90 нс, с дополнительным буферным этапом — 92 нс. Под нагрузкой первая система ждёт ещё 70 нс, вторая — 25 нс. Полный отклик равен 160 и 117 нс; улучшение составляет 26,875%, хотя базовое время второй системы на 2 нс больше. Числа выбраны для объяснения и не описывают конкретный модуль.
Именно поэтому обещание меньшей задержки требует указания нагрузки и методики. Pointer chasing с одним зависимым чтением исследует другую границу, чем параллельный поток со множества ядер. Система способна проиграть немного в первом опыте и выиграть существенно во втором. Обе оценки могут быть правильными при честно описанных условиях.
Необходимое число запросов можно оценить
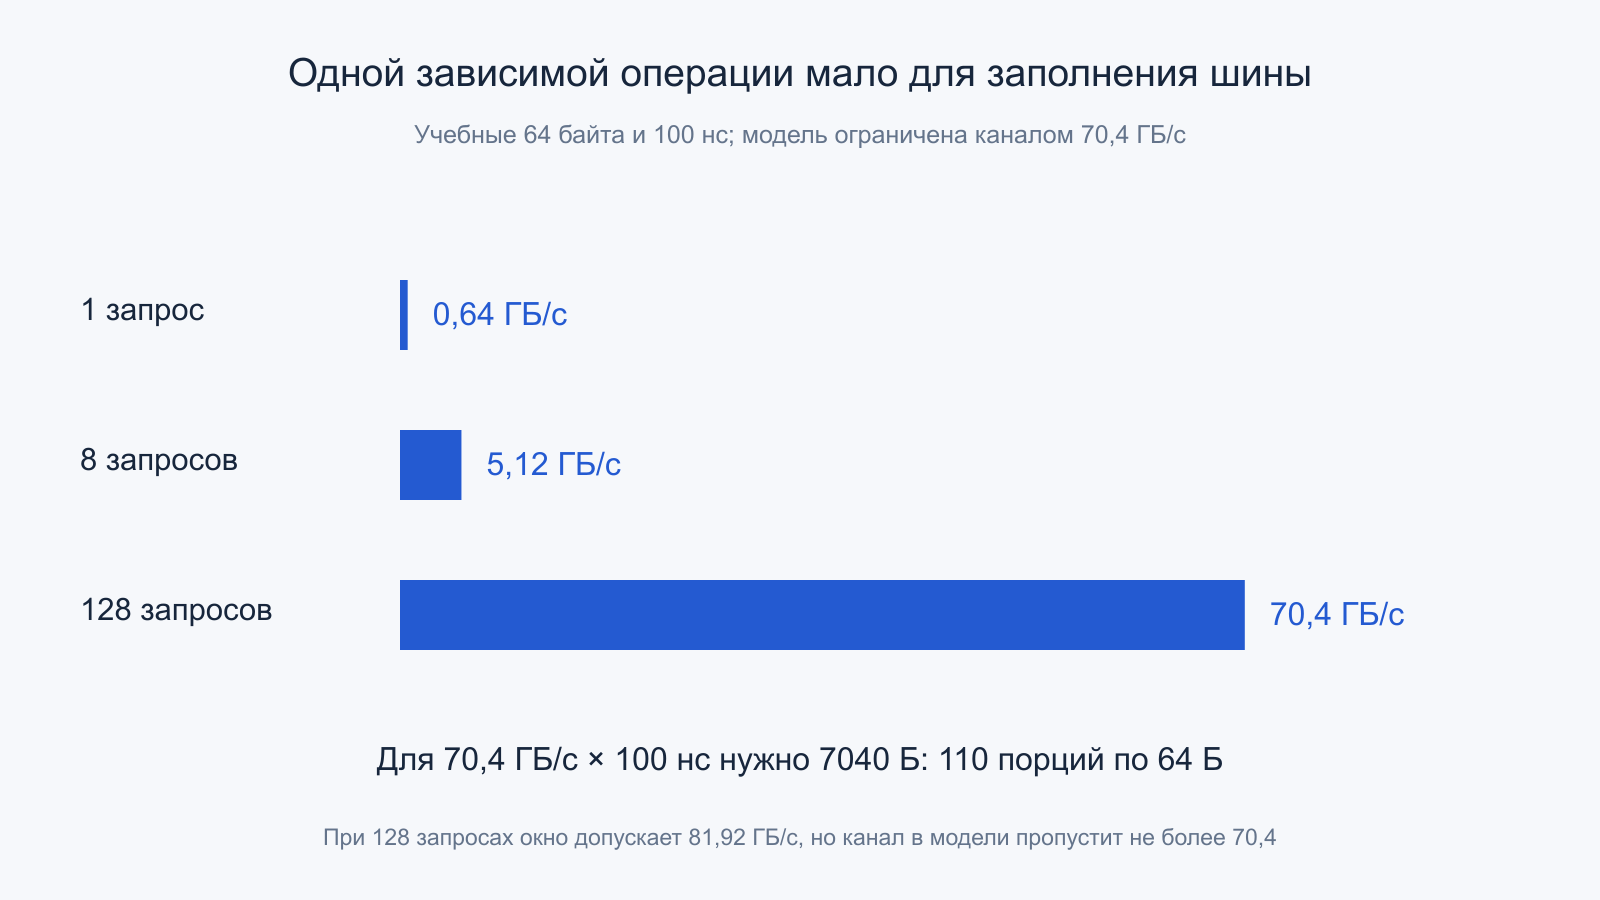
Чтобы заполнять быструю шину, должны существовать достаточно многочисленные независимые обращения. Для учебного канала 70,4 ГБ/с и полного времени обслуживания 100 нс объём данных в пути равен 7040 байт. Если считать порциями по 64 байта, нужно около 110 одновременно обслуживаемых порций.
При одном зависимом запросе каждые 100 нс доступная полоса составит только 0,64 ГБ/с. Восемь независимых запросов дают верхнюю оценку 5,12 ГБ/с, а 128 — 81,92 ГБ/с, которую выбранный канал ограничит своими 70,4 ГБ/с. Это модель окна обращений без детализации команд DRAM; она не назначает реальный размер очередей контроллера.
Загрузка зависит от аппаратной предвыборки, числа потоков, структуры данных и способности процессора держать промахи в обработке. Ускорение внешней памяти не исправляет последовательную цепочку указателей, где адрес следующего чтения неизвестен до возврата предыдущего. Для таких алгоритмов важны локальность, кэширование и изменение представления данных. MRDIMM расширяет ресурс, но программа должна уметь его использовать.
Полезная загрузка отличается от занятости проводников
Рассмотрим условные блоки работы: 32 интервала передачи данных, восемь интервалов ожидания и четыре интервала разворота или служебных операций. Полезная доля составляет 32/44, то есть примерно 72,73%. Для номинальных 70,4 ГБ/с получится 51,2 ГБ/с. Увеличение скорости выводов не исключает такой разрыв.
Если оптимизировать расписание до четырёх интервалов ожидания при прежних остальных расходах, полезная доля станет 32/40, или 80%, а поток — 56,32 ГБ/с. Здесь выигрыш создан организацией обмена, а не изменением частоты. Пример использует одинаковые условные интервалы и не воспроизводит тайминги MRDIMM.
При чтении результатов теста полезно выяснять, что именно считалось байтами. Копирование включает чтение источника и запись результата, а некоторые политики записи добавляют дополнительный трафик. Пропускная способность программы и физический поток памяти могут иметь разные числители. Без этой проверки легко получить кажущееся превышение потолка или ошибочно обвинить память в неэффективности.
Равномерный общий поток тоже способен скрывать локальную перегрузку. Если половина обращений попадает в один канал, а остальные распределены по одиннадцати, увеличение общей теоретической суммы не устраняет очередь в первом. Поэтому полезно наблюдать нагрузку отдельных контроллеров и банков. Изменение раскладки данных иногда даёт больший эффект, чем переход к следующему скоростному классу модуля.
Чтение и запись конкурируют за направление
Шина данных памяти не является двумя постоянно независимыми встречными магистралями. Переход от чтения к записи требует соблюдения временных ограничений и предотвращения конфликта выходных драйверов. Буферизация позволяет планировать операции эффективнее, но не отменяет физические развороты.
Контроллер может группировать записи, чтобы реже менять направление. Это увеличивает эффективность потока, одновременно меняя задержки отдельных чтений. Поэтому одинаковый средний объём чтения и записи не означает одинаковую производительность при разной последовательности запросов. Равномерное чередование и крупные группы создают разные условия.
В MRDIMM дополнительно согласуют внешнее направление с внутренними операциями рангов. Избыток одного вида запросов способен заполнить соответствующие буферы, а пустые места противоположного направления не обязательно помогают. Для сервера с несколькими виртуальными машинами важны не только максимальные гигабайты в секунду, но и задержки чувствительной нагрузки рядом с массивным потоком другого пользователя.
Особенно показателен сценарий очереди: небольшое число срочных чтений приходит на фоне большого накопленного пакета записей. Измерение только общего объёма данных может выглядеть отличным, хотя отдельные операции ждут неприемлемо долго. Для сервиса с ограничением времени ответа полезно задавать одновременно минимальную производительность и допустимый хвост задержек, затем проверять обе величины при одной нагрузке.
Обновление ячеек остаётся обязательным
DRAM хранит заряд ограниченное время и нуждается в refresh. Часть банков периодически недоступна для обычных обращений. Более быстрый внешний интерфейс не устраняет этот физический процесс. Если плотность кристалла или температура требуют другого режима обновления, эффективность может измениться при той же надписи MT/s.
Мультиплексация и дополнительные банки дают возможности скрывать некоторые простои, переключаясь на готовую работу. Но степень перекрытия ограничена структурой адресов и временными правилами. Когда нагрузка концентрируется в небольшой области, остальная доступная параллельность может оставаться бесполезной.
Для сравнения модулей разной ёмкости поэтому фиксируют плотность DRAM, организацию x4 или x8, число рангов и режим refresh. Иначе изменение результата ошибочно объясняется одной частотой, хотя одновременно изменились несколько параметров. Особенно полезен длительный прогон после тепловой стабилизации: короткий холодный опыт может не показать режим, в котором сервер проведёт большую часть рабочего времени.
Ёмкость и число рангов связаны через организацию
При выборе модуля нельзя считать количество корпусов единственной мерой ёмкости. Один корпус может содержать несколько кристаллов, а разные микросхемы имеют разную плотность и ширину интерфейса. Организация рангов определяет, как эти ресурсы представлены контроллеру.
Высокий форм-фактор позволяет разместить больше компонентов и изменить их тепловую плотность, но требует подходящего пространства и воздушного потока. Низкопрофильная конструкция удобнее механически, однако другая упаковка DRAM может иметь свои ограничения. Преимущество конкретного варианта устанавливают для заданного сервера, а не по высоте платы отдельно.
Учебный пример ёмкости: двенадцать модулей по 128 ГиБ дают 1536 ГиБ, то есть 1,5 ТиБ. Если активные данные занимают 1,2 ТиБ, резерв составляет 0,3 ТиБ до учёта служебной памяти. Установка вдвое большего модуля не ускорит задачу, уже полностью помещающуюся в RAM, если её ограничивает вычисление. Зато предотвращение подкачки может дать несопоставимо больший эффект, чем рост частоты.
При оценке надёжности различают внутреннюю защиту кристалла, контроль передачи и функции контроллера системы. Наличие ECC внутри DRAM не означает, что любой сбой на контактах модуля будет исправлен тем же механизмом. Важны границы покрытия: где контрольные разряды формируются, где проверяются и как ошибка сообщается платформе. Полный набор возможностей подтверждают документацией конкретного сервера.
Питание буферов нужно считать на уровне задачи
Дополнительные интерфейсные микросхемы расходуют энергию, поэтому сравнивать только мощность одного модуля недостаточно. Более быстрая память способна сократить длительность работы процессора и всей системы. Вопрос заключается в энергии завершённой задачи при требуемом качестве обслуживания.
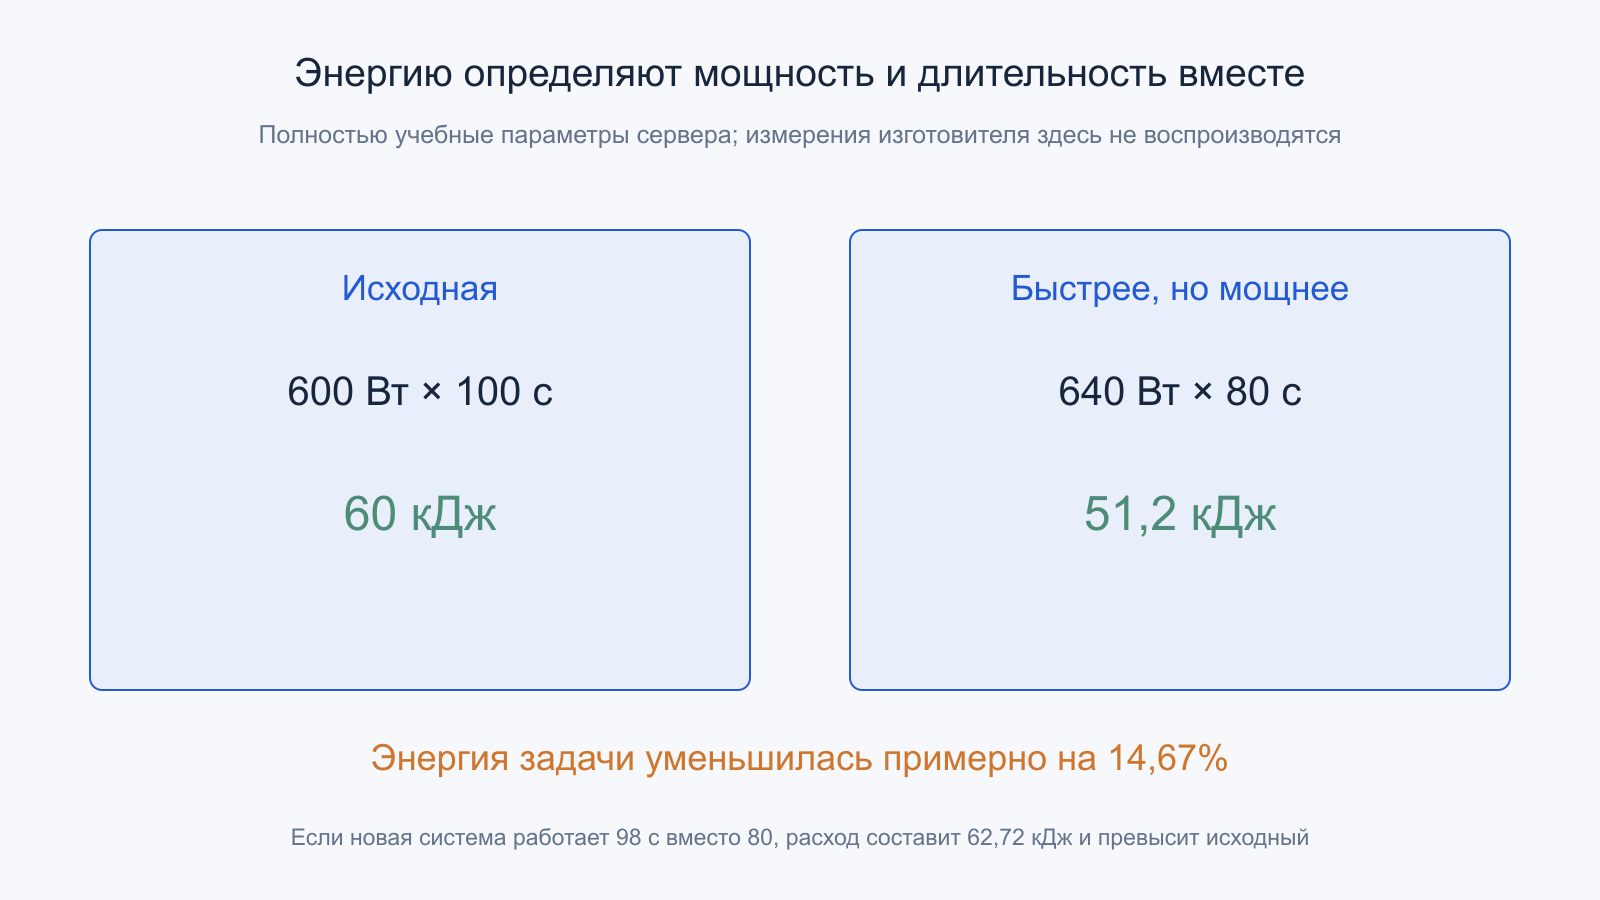
В учебном сценарии исходный сервер потребляет 600 Вт и выполняет задачу за 100 секунд: энергия равна 60 кДж. Новая конфигурация потребляет 640 Вт, но заканчивает за 80 секунд: 51,2 кДж. Экономия — примерно 14,67%. Если время сократилось лишь до 98 секунд, получится 62,72 кДж, то есть расход вырастет. Повышение мгновенной мощности не предопределяет результат в любую сторону.
Также учитывают простой, загрузку остальных узлов, эффективность преобразователей и вентиляторы. Для круглосуточного сервиса важна реальная доля времени в каждом режиме. Синтетический поток на максимальной нагрузке полезен для исследования предела, но его энергетический выигрыш нельзя без поправок умножать на все часы эксплуатации.
Тепловая конструкция влияет на устойчивую скорость
MRCD, MDB, PMIC и DRAM распределены по одной плате и нагревают окружающий воздух. Одинаковая средняя температура модуля может скрывать горячий небольшой компонент. Воздушный поток зависит от соседних DIMM, радиаторов процессора, кабелей и заглушек в корпусе.
В простой модели 18 Вт рассеиваются при эффективном тепловом сопротивлении 2 К/Вт, что даёт перегрев 36 К. Если температура входящего воздуха выросла с 30 до 40 °C, расчётная температура узла поднимется с 66 до 76 °C без изменения потребления. Эти условные числа не являются допустимыми температурами конкретной микросхемы.
Проверка должна учитывать максимальную конфигурацию и длительную нагрузку, включая горячий воздух после других узлов. После изменения высоты модуля, расположения памяти или режима вентиляторов повторяют затронутые испытания. Успех открытого стенда с одним модулем не гарантирует стабильную работу заполненной стойки. Устойчивая полоса интереснее короткого пика до теплового ограничения.
Сбалансированные каналы важнее красивой суммы ёмкостей
Равномерное заполнение поддерживаемых каналов даёт контроллеру больше независимых путей. Если большую ёмкость набрать в малом числе каналов, остальные вычислительные ресурсы будут конкурировать за узкую часть системы. Конкретные правила заполнения берут из руководства сервера: они зависят от числа процессоров и организации слотов.
В многосокетной машине физическое расположение страниц тоже важно. Поток на одном CPU, обращающийся к памяти другого, использует межсокетное соединение. Сумма паспортных полос модулей всех сокетов не является гарантированной скоростью такого доступа. Нужны правильное размещение потоков и политика NUMA.
Полезно разделять тест локальной памяти, удалённой памяти и общей прикладной задачи. Затем анализировать, не изменилась ли раскладка страниц между опытами. MRDIMM ускоряет соответствующий локальный путь, но не расширяет автоматически межпроцессорные каналы. Без контроля размещения случайный первый запуск способен показать гораздо больший разброс, чем ожидаемый выигрыш новой памяти.
Как проверить конкретную конфигурацию
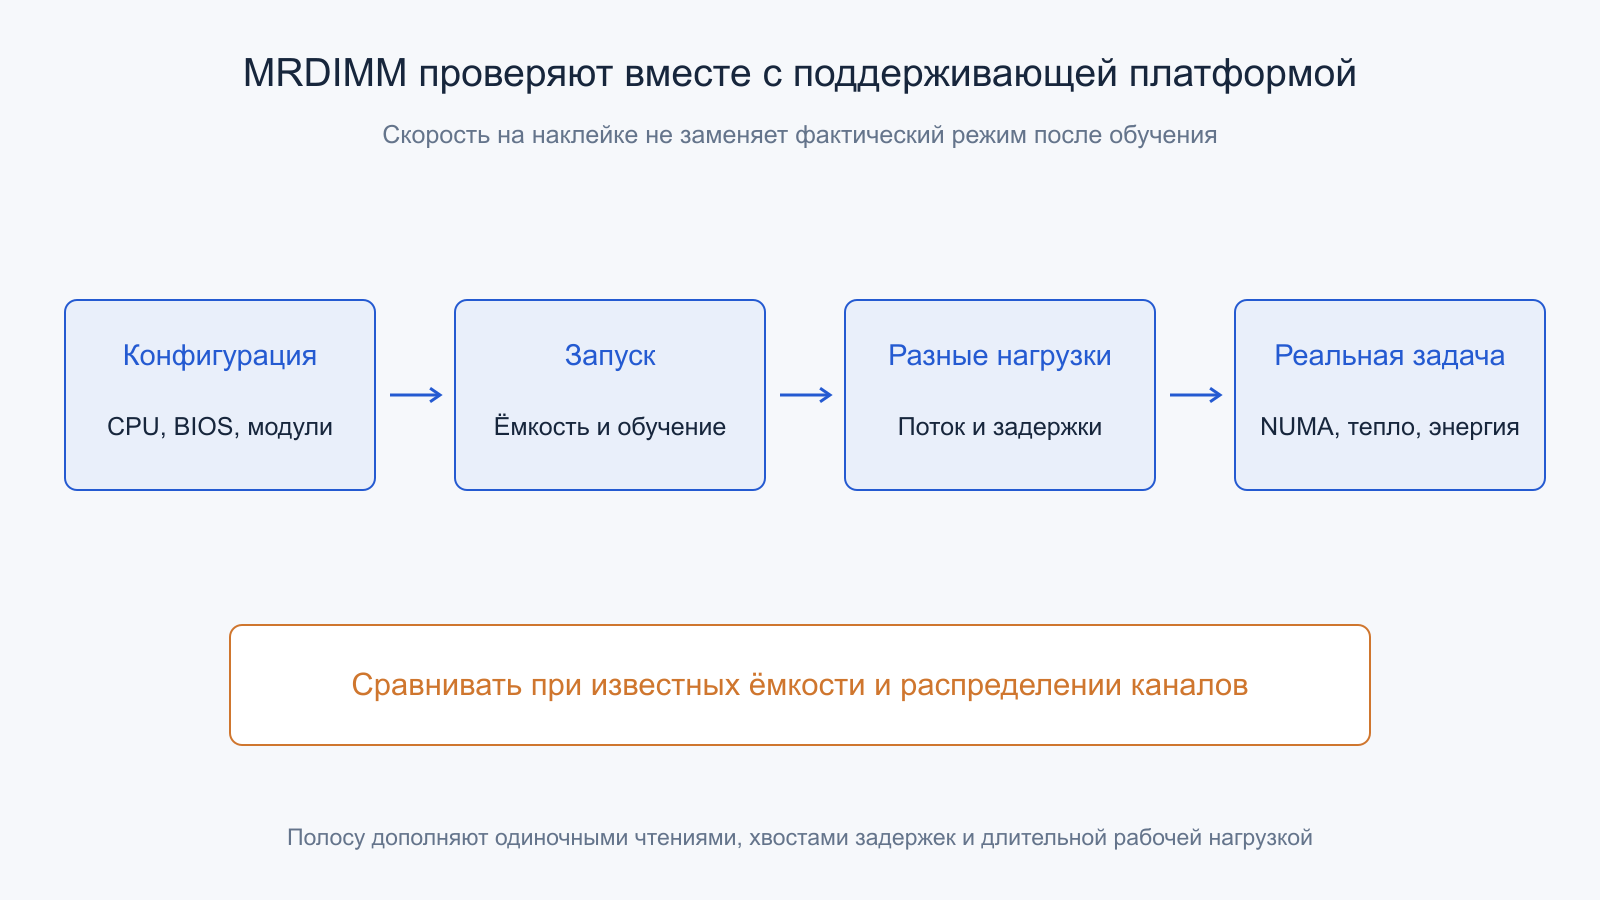
Сначала сохраняют точные артикулы CPU, модулей и платы, версию BIOS, фактическую скорость и распределение каналов. Затем проверяют распознавание ёмкости, обучение, доступные события RAS и отсутствие неожиданных понижений режима. После этого переходят к нагрузкам, которые разделяют разные ограничения.
Нужны последовательные чтения, смешанный поток, зависимые обращения и реальная задача пользователя. Для каждой фиксируют число потоков, размер данных и политику размещения. Средняя задержка дополняется хвостами распределения, а полоса — проверкой длительного устойчивого режима. Сравнение при разной ёмкости допустимо, если это прямо названо отдельным сценарием.
Результат формулируют в границах опыта: какая конфигурация быстрее на какой работе и при каких условиях. MRDIMM интересна способностью дать серверу больше полезного потока через знакомую модульную конструкцию. Её смысл раскрывается вместе с контроллером, внутренними рангами и расписанием запросов. Удачный выбор начинается с определения узкого места, а заканчивается воспроизводимым преимуществом в нужной задаче.
Отдельный полезный результат проверки — отрицательный: если задача ограничена вычислительными блоками и почти не обращается к большой памяти, более дорогой модуль может не дать заметного ускорения. Это не опровергает устройство MRDIMM, а показывает границу применения. Решение принимают по стоимости завершённой работы, нужной ёмкости и требованиям к обслуживанию; максимальная частота остаётся одним из параметров этой оценки.
Первичные источники и дата сверки
Официальные объявления ниже содержат разные даты и стадии готовности. Старые планы не представлены как подтверждённые поставки на 26 октября 2026 года; числа наших моделей не следует приписывать изготовителям.
- Micron: MRDIMM и ограничения совместимости
- Intel: MCR DIMM на Xeon 6, обновление февраля 2026
- Intel: таблица памяти платформ Xeon 6
- Kingston: режимы и правила памяти Birch Stream
- Rambus: архитектура MRCD и десяти MDB
- Montage: инженерные образцы второго поколения
- Renesas: объявление второго поколения интерфейсных компонентов
- Renesas: Gen3 16000, образцы и производственный план
- Innodisk: MRDIMM 12800 и план четвёртого квартала 2026
- AMD: различие ранних MRDIMM и стандартной технологии
- JEDEC: официальное сообщение о развитии MRDIMM от 30 апреля 2026