NVLink и UALink: как ускорители обмениваются данными
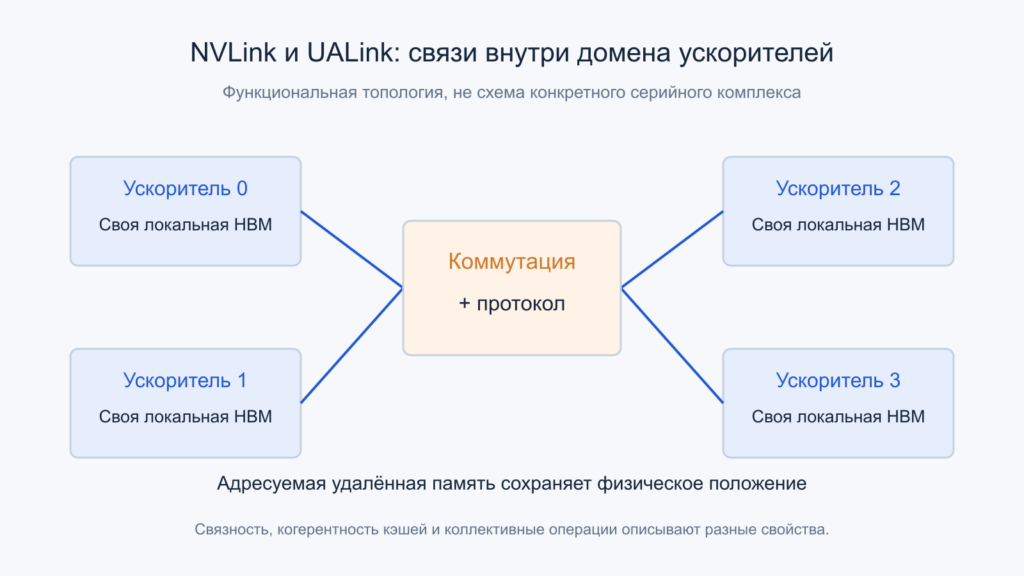
Условный scale-up домен. Возможность обращения к удалённой памяти не делает её локальной и не описывает автоматически когерентность кэшей. Открыть иллюстрацию в полном размере.
Когда модель распределена по нескольким ускорителям, недостаточно сложить их вычислительную мощность. Промежуточные результаты, части тензоров и запросы к удалённой памяти должны перемещаться между устройствами. Если обмен не успевает за вычислениями, дорогие арифметические блоки ждут. Поэтому NVLink и UALink стоит рассматривать как архитектуру доступа и взаимодействия, а не как очередную быструю разновидность внешнего кабеля.
Разберём уровни соединения, направления полосы, коммутаторы, семантику памяти и коллективные операции. Отдельно обозначим версии стандартов и разницу между опубликованной спецификацией, поставкой компонента и готовой вычислительной системой. Сведения проверены по первичным источникам на 26 октября 2026 года. Все примеры времени, нагрузки и топологии являются учебными моделями, а не испытаниями оборудования владельца сайта.
Содержание статьи
- 1. Scale-up соединяет тесно взаимодействующую группу
- 2. Линия, порт, коммутатор и домен — разные масштабы
- 3. Поколения NVLink нужно связывать с конкретными платформами
- 4. Двунаправленная сумма не является скоростью одной отправки
- 5. Коммутируемая связность не отменяет ограничение получателя
- 6. Срез сети помогает увидеть скрытое переподписывание
- 7. UALink 200G 1.0 и семейство Common 2.0
- 8. Как считать линию и станцию UALink
- 9. UALink использует часть Ethernet PHY, но имеет свой протокол
- 10. Memory semantics не означают одинаковую локальную и удалённую память
- 11. Копирование, доступ по указателю и атомики требуют разных проверок
- 12. NVLink-C2C — отдельная связь с когерентными возможностями
- 13. Коллективная операция — алгоритм над группой участников
- 14. Вычисления внутри коммутатора сокращают лишнее движение
- 15. Маленькие запросы упираются в задержку и число обращений
- 16. Повторы, кредиты и изоляция нужны даже внутри стойки
- 17. Стандарт, поставленный коммутатор и работающий комплекс
- 18. Система выигрывает только от сокращения критического пути
- 19. Первичные источники и версии сведений
- Читайте также
1. Scale-up соединяет тесно взаимодействующую группу
Scale-up fabric объединяет ускорители в домен, где требуется интенсивный обмен с небольшой задержкой. Такой домен может охватывать несколько плат, вычислительных узлов или стойку. Scale-out соединяет более крупные группы и серверы через сеть центра обработки данных. Это функциональное различие: граница не всегда совпадает с дверцей одного корпуса, а слово «сеть» применимо к обоим случаям.
При распараллеливании модели разные части одного вычисления могут многократно обмениваться данными внутри слоя. Для mixture-of-experts добавляется пересылка входов к выбранным экспертам и обратный сбор результатов. Здесь имеют значение не только средний объём, но и всплески, неравномерность адресатов и частота синхронизаций. NVLink является семейством технологий NVIDIA, развиваемым вместе с ускорителями, коммутаторами и программным стеком. UALink — семейство открытых отраслевых спецификаций для взаимодействия ускорителей и коммутаторов. Ни одно из названий само по себе не определяет алгоритм распределения модели.
2. Линия, порт, коммутатор и домен — разные масштабы
Физическая линия передаёт сигнал между двумя концами. Несколько линий объединяются в соединение, а устройство может иметь несколько таких соединений. Коммутатор направляет транзакции к получателям и позволяет построить топологию, где число доступных партнёров не ограничено количеством прямых разъёмов на одном ускорителе. Домен включает ещё маршрутизацию, управление, права доступа и правила отказоустойчивости.
Полезная документация поэтому содержит несколько чисел: скорость линии, полосу порта, суммарную полосу ввода-вывода ускорителя и ёмкость коммутационной структуры. Их нельзя складывать без определения границы. Количество линий на кристалле не гарантирует, что все они выведены и задействованы в любой системе. А достижимость любого получателя не означает отдельного физического провода к каждой паре. Схема соединений должна показывать общие ресурсы и направления движения, иначе она скрывает конкуренцию за порты и создаёт впечатление неограниченного обмена.
На другом конце соединения тоже должны быть свободные ресурсы. Чтение удалённой HBM конкурирует с вычислительными ядрами её владельца, а запись результата может упираться в его контроллер памяти. Поэтому независимый сетевой тест с почти пустым GPU и тот же обмен во время насыщенной матричной работы дадут разные условия. Пиковая полоса fabric не является дополнительной независимой памятью, которая появляется вне общего бюджета чтения и записи кристалла.
3. Поколения NVLink нужно связывать с конкретными платформами
В официальной сравнительной таблице NVIDIA четвёртое поколение для Hopper указано с полосой 900 ГБ/с на GPU, пятое для Blackwell — 1800 ГБ/с. В обоих случаях речь о сумме направлений. Указаны до восемнадцати соединений на GPU. Эти числа характеризуют соответствующие возможности платформы и не являются показателями любой видеокарты с архитектурой того же семейства.
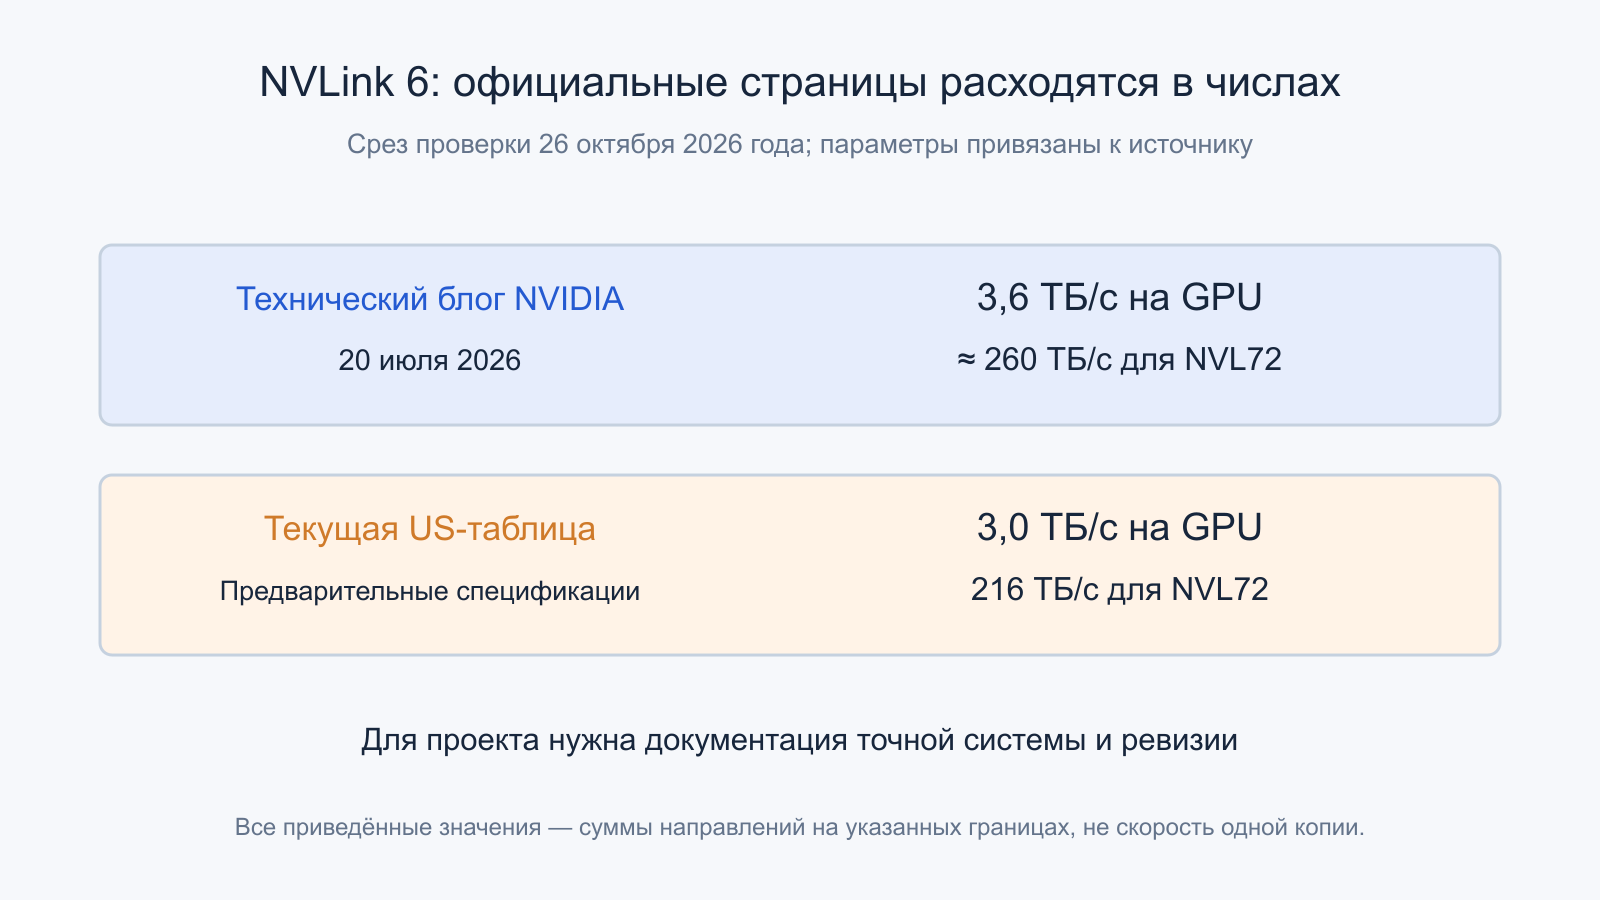
Для шестого поколения обнаруживается важная граница актуальности. Технический блог NVIDIA от 20 июля 2026 года приводит 3,6 ТБ/с на GPU и около 260 ТБ/с для NVL72. При проверке текущая американская страница NVLink показывает 3,0 ТБ/с и 216 ТБ/с, помечая спецификации как предварительные. Здесь эти сведения сохраняются с указанием источника; раннее значение не объявляется универсальным гарантированным паспортом. Для проектирования следует брать документацию точной системы и её ревизии. Название поколения не заменяет согласованную таблицу электрических и системных характеристик.
4. Двунаправленная сумма не является скоростью одной отправки
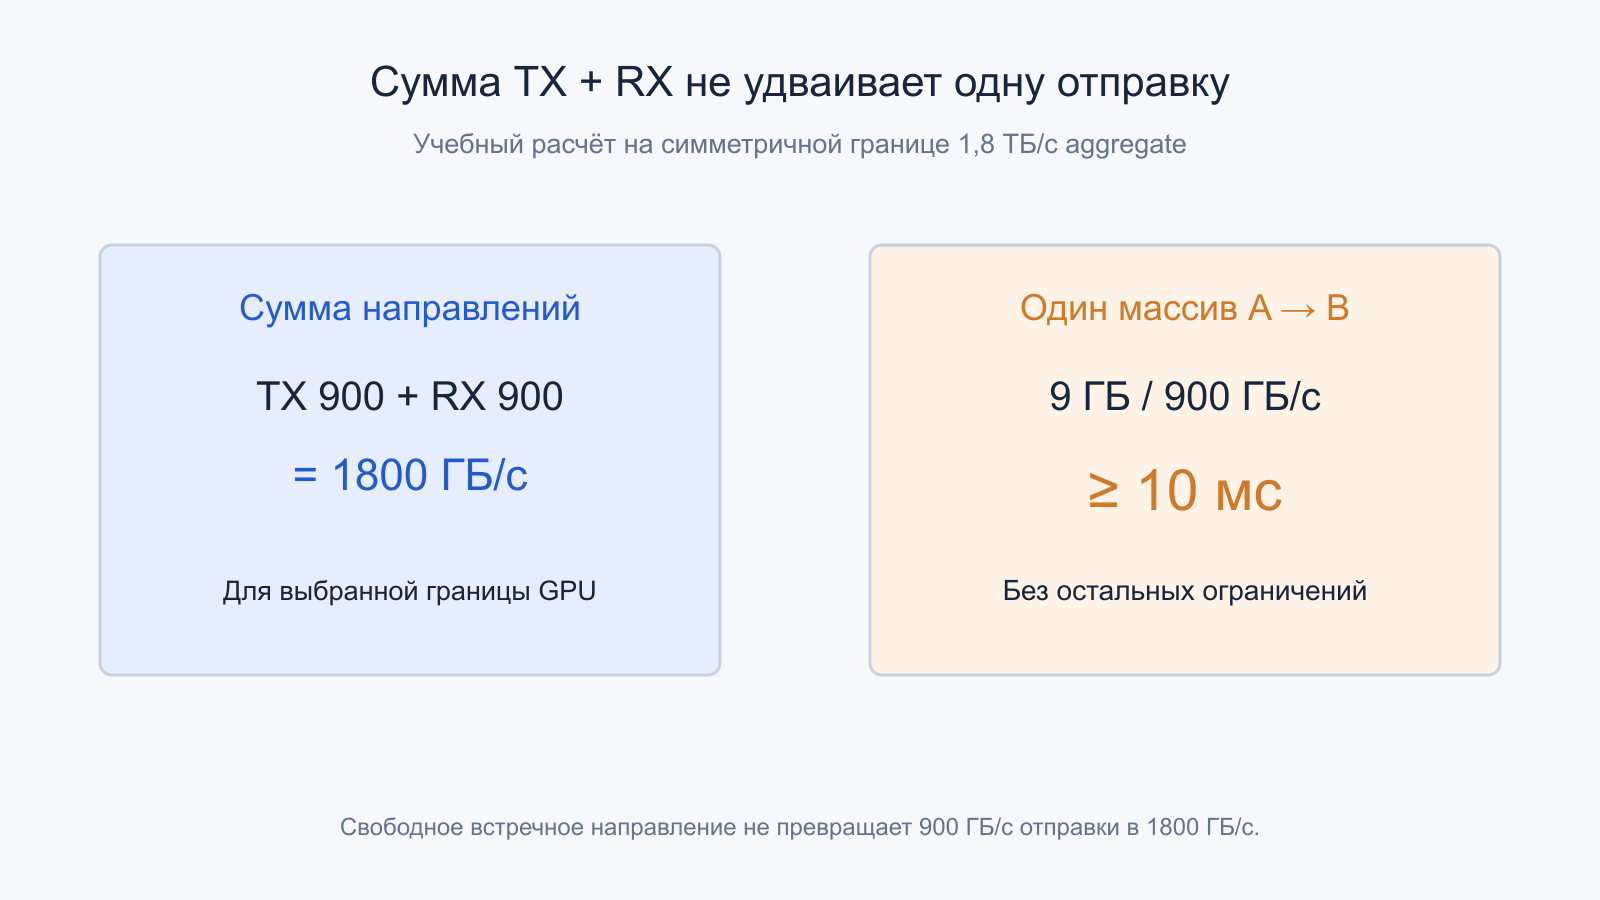
Если симметричный интерфейс имеет суммарную полосу 1,8 ТБ/с, составленную из передачи и приёма, каждому направлению соответствует до 0,9 ТБ/с на этой границе. Передача одного большого массива из A в B не получает все 1,8 ТБ/с только потому, что обратный путь свободен. Дополнительные соединения могут работать параллельно, но это уже учтено в суммарном показателе выбранного GPU.
Учебный пример: 9 ГБ данных при идеальных 900 ГБ/с в одном направлении потребуют минимум 10 мс. Подстановка двунаправленных 1800 ГБ/с дала бы ошибочные 5 мс. И правильные 10 мс ещё не результат приложения: остаются служебные поля, ограничения чтения исходной памяти, записи целевой памяти и запуск операции. Если одновременно идут независимые потоки в обе стороны, суммарный счётчик действительно может приблизиться к сумме направлений. Поэтому рядом с каждой полосой нужно писать, что именно складывается и относится ли число к одному получателю или всему устройству.
5. Коммутируемая связность не отменяет ограничение получателя
NVLink Switch позволяет многим ускорителям общаться через коммутационную структуру. Однако характеристика all-to-all говорит о возможности организовать обмен между всеми участниками при заданной системе ресурсов. Она не означает, что каждый GPU одновременно получит полную свою полосу от каждого другого GPU. Входная полоса конечного устройства остаётся ограниченной.
Учебная модель: восемь ускорителей имеют по 100 ГБ/с приёма. Если семь из них одновременно передают одному получателю, этот получатель всё равно может принять суммарно лишь 100 ГБ/с на выбранной границе. При равном распределении каждому достанется около 14,29 ГБ/с. Коммутатор без внутреннего переподписывания не устраняет такой incast. В другом шаблоне, где адресаты распределены равномерно, та же система может показать гораздо большую общую производительность. Поэтому тест одной пары и агрегированный тест равномерного обмена описывают разные рабочие режимы и не заменяют анализ нагрузки конкретного алгоритма.
Неравномерность бывает и временной. Все участники могут одновременно завершить вычислительный этап и направить короткие всплески одному узлу. Средняя загрузка за секунду при этом останется небольшой, но очереди на критическом этапе задержат весь шаг. Для такой задачи полезны расписание, распределение адресатов и ограничение числа одновременно работающих операций. Увеличение центральной коммутационной полосы не всегда заменяет эти изменения, если узкое место находится на конечном порте.
6. Срез сети помогает увидеть скрытое переподписывание
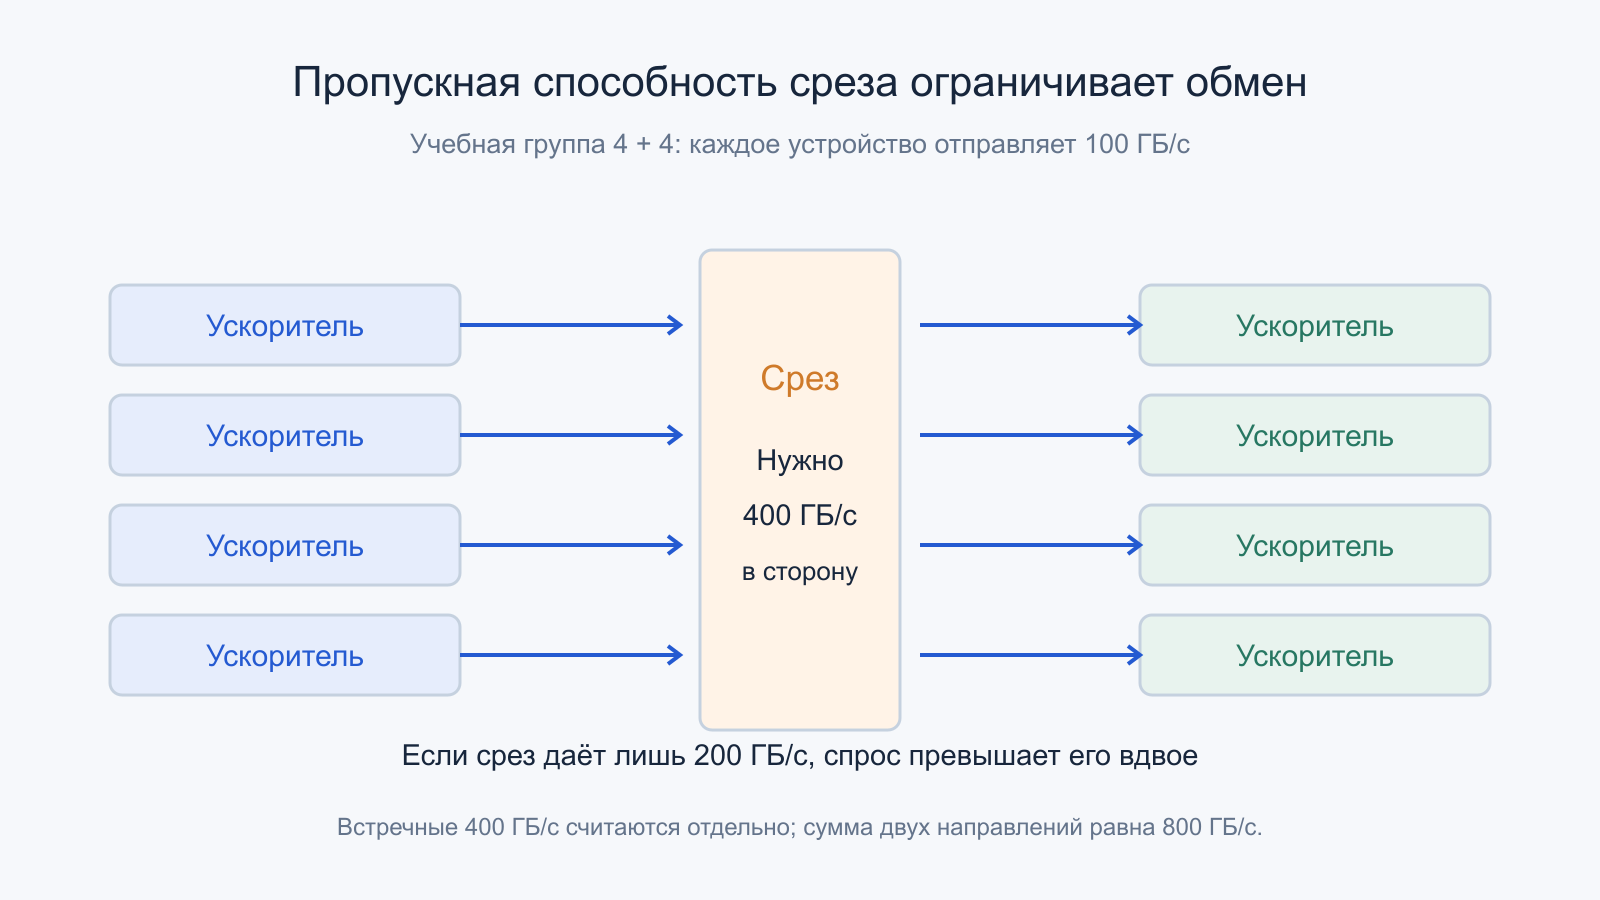
Для оценки топологии полезно мысленно разделить участников на две равные группы и посчитать связи между ними. Пропускная способность этого среза ограничивает обмен, которому необходимо пересечь границу. Большая сумма полос всех портов может выглядеть внушительно, хотя центральный участок существенно уже. Это особенно важно при многоступенчатой коммутации и частичном заполнении системы.
В учебной системе из восьми устройств разделим участников по четыре. Если каждое из первых четырёх направляет 100 ГБ/с во вторую группу, через срез требуется 400 ГБ/с в одном направлении. Для одновременной встречной нагрузки нужны ещё 400 ГБ/с обратного направления. Это 800 ГБ/с двунаправленной суммы, а не 800 ГБ/с для первого потока. Если между группами оставлено только 200 ГБ/с в одну сторону, даже идеальное расписание не пропустит исходные 400. Такая проверка часто информативнее максимальной скорости отдельного SerDes.
7. UALink 200G 1.0 и семейство Common 2.0
Начальная опубликованная спецификация UALink 200G 1.0 определяет соединение ускорителей и коммутаторов с номинальной границей 200G на линию и доменом до 1024 ускорителей. Это предусмотренный стандартом масштаб, а не доказательство существования серийной системы из 1024 любых устройств. Конкретный проект выбирает число портов, топологию, поддерживаемые операции и программный стек.
В апреле 2026 года консорциум объявил Common Specification 2.0 с вычислениями внутри сети, отдельную спецификацию 200G Data Link and Physical Layers 2.0, документы управления и интеграции чиплетов. В текущем каталоге также присутствуют 128G DL/PL 1.0 и Chiplet 1.01. Следовательно, «UALink 2.0» нельзя трактовать просто как удвоенную скорость первой версии или как один монолитный документ. Функциональный протокол, физическая передача, управление системой и внутрипакетная интеграция развиваются отдельными частями. Возможности нового документа не следует задним числом приписывать любой реализации UALink 1.0.
Разделение документов позволяет использовать общую семантику поверх разных физических вариантов. Но одинаковая версия Common не доказывает совместимость двух портов с различными PHY. Им нужны совпадающие поддерживаемые режимы, подходящая среда и корректные процедуры установления связи. При составлении спецификации системы полезно перечислять функциональную версию, DL/PL и обязательные опции отдельно. Запись только одного крупного номера оставляет слишком много неопределённости для выбора компонентов и программы проверки совместимости.
8. Как считать линию и станцию UALink
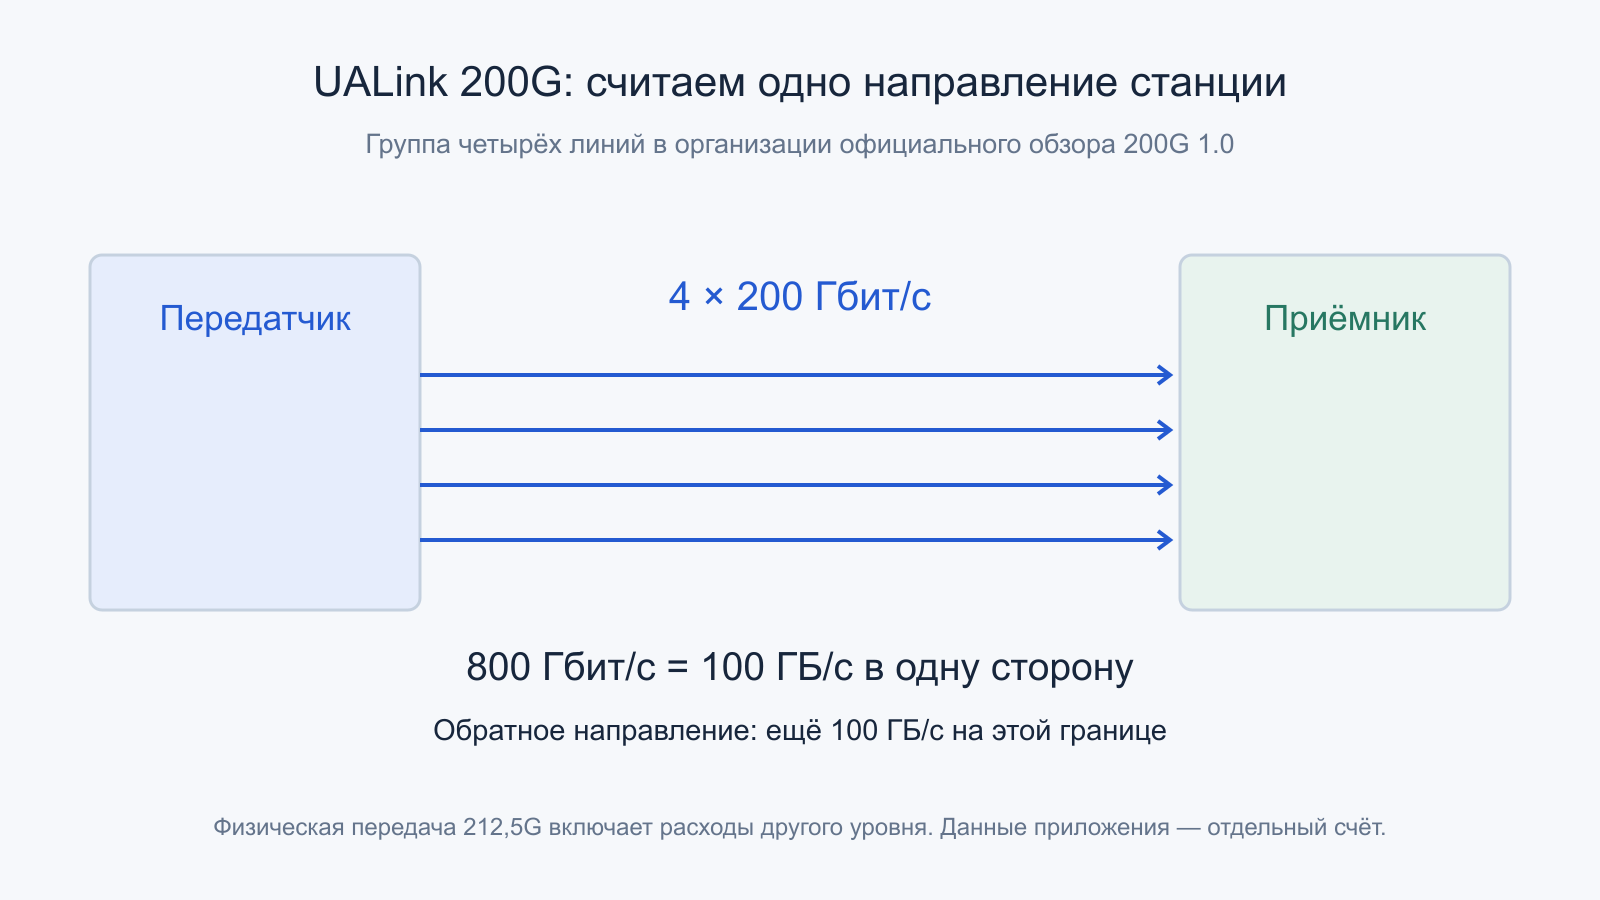
В официальном обзоре 200G 1.0 описаны конфигурации x1, x2 и x4. Группа четырёх линий образует station с границей 800 Гбит/с передачи и столько же приёма. Перевод в байты даёт 100 ГБ/с в одном направлении и 200 ГБ/с при сложении направлений. Это расчёт заявленной интерфейсной границы, а не измеренная скорость копирования пользовательского массива.
Физическая последовательная передача имеет более высокую битовую скорость — 212,5G на линию в описанном режиме, поскольку в неё входят кодирование и FEC. Нельзя взять 200G, ещё раз вычесть расходы, уже учтённые при переходе к этой границе, и назвать результат точной полезной полосой приложения. Но и все 200G не гарантированно превращаются в данные задачи: остаются поля транзакций, запросы, ответы и неполное заполнение. Также битовая скорость многопозиционного сигнала не равна частоте символов. Эти уровни должны быть явно разделены до сравнения с цифрами NVLink.
9. UALink использует часть Ethernet PHY, но имеет свой протокол
Повторное использование физической технологии Ethernet помогает опереться на существующие кабели, соединители и SerDes-решения. Однако протокол транзакций и канальный уровень UALink собственные. Обычный Ethernet-коммутатор не становится UALink-коммутатором только из-за совместимой скорости электрических линий. Так же нельзя произвольно подключить два ускорителя и ожидать понимания удалённых операций памяти.
В опубликованном обзоре показаны транзакционные единицы 64 байта, канальные единицы 640 байт и физическое представление с FEC. Эти числа относятся к разным слоям упаковки, а не к трём независимым размерам пользовательского сообщения. Канальный уровень добавляет обнаружение ошибок и механизм повтора. Физический уровень исправляет часть ошибок до передачи выше. Совпадение электрической среды облегчает интеграцию, но не устраняет требования обучения канала, протокольной совместимости и управления. При оценке оборудования нужно проверять поддерживаемый режим всего соединения, включая оба конца и промежуточные элементы.
10. Memory semantics не означают одинаковую локальную и удалённую память
UALink предусматривает операции чтения, записи и атомарного изменения удалённых данных. NVLink также поддерживает пути прямого доступа между GPU в соответствующей системе. Это позволяет не оформлять каждую мелкую операцию как копирование через память хоста. Но адресуемость удалённого участка не превращает его в локальную HBM с той же задержкой, полосой и поведением кэша.
Удалённый доступ проходит через интерфейс, маршрутизацию и память другого устройства. Для чтения требуется вернуть данные; для записей важны подтверждения и правила завершения. Несколько потоков могут конкурировать за один контроллер памяти. Поэтому «общая память» в описании системы нуждается в уточнении: речь может идти об общем виртуальном адресном пространстве, возможности прямых транзакций, согласовании кэшей или библиотечном интерфейсе. Это разные свойства. Поддержка load/store сама по себе не доказывает глобальную когерентность всех кэшей и автоматическую корректность программы с произвольными гонками.
Локальность сохраняет ценность даже при хорошем удалённом доступе. Если одни данные многократно используются одним GPU, их размещение рядом с этим GPU уменьшает повторный сетевой трафик. Если данные постоянно меняют владельца, цена миграции и синхронизации может превысить выигрыш от распределения. Общая адресуемость помогает выразить алгоритм, но не делает размещение несущественным. Это особенно заметно для структур, в которых адрес следующего обращения зависит от только что полученного значения.
11. Копирование, доступ по указателю и атомики требуют разных проверок
В CUDA возможность peer-to-peer доступа определяется свойствами устройств, топологией и программной конфигурацией. Её запрашивают через API возможностей и включают для нужного направления. Копирование между двумя областями памяти и разыменование удалённого указателя из ядра — разные способы движения данных. Одна успешно завершившаяся копия ещё не доказывает одинаковую поддержку всех операций прямого доступа.
Для совместной работы нескольких GPU необходима синхронизация с подходящей областью действия. Атомарность удалённой операции имеет собственные требования: документация CUDA выделяет, в частности, проверку native atomic support между устройствами. Атомик защищает конкретную операцию над конкретным объектом; он не заменяет весь протокол публикации связанных данных. Нельзя записать полезную нагрузку, выставить флаг и считать получателя автоматически синхронизированным без корректного порядка и семантики памяти. Название быстрого интерфейса не отменяет эти правила языка и платформы.
12. NVLink-C2C — отдельная связь с когерентными возможностями
NVLink-C2C предназначена для интеграции процессоров и других кристаллов и поддерживает когерентный обмен в предусмотренной архитектуре. Она применяется, например, в связках CPU и GPU семейства Grace Blackwell и Vera Rubin. Это другой уровень организации по сравнению с суммарной GPU-to-GPU полосой коммутируемого NVLink-домена. Даже похожие названия не дают права подставлять одну характеристику вместо другой.
Когерентность означает определённые правила согласования наблюдаемых копий данных, а не отсутствие задержек или бесконечную полосу. Удалённая память процессора сохраняет физическое положение, а обращение может потребовать дополнительных транзакций. Для системного проектирования нужно отдельно учитывать CPU–GPU путь, GPU–GPU путь и сеть между доменами. Возможности C2C нельзя распространить на любые две платы с NVLink, а наличие UALink Chiplet specification не означает взаимную электрическую или протокольную совместимость с NVLink-C2C. Документы интеграции определяют конкретную границу взаимодействия.
Библиотека может дополнительно предлагать распределённое адресное пространство. Например, NVSHMEM предоставляет односторонние операции и возможность инициировать обмен из GPU-кода. Это программная модель с собственными правилами завершения и видимости. Она способна использовать разные транспорты, поэтому наличие такого API не доказывает физический NVLink-путь для каждой пары участников. И наоборот, установленный NVLink не означает, что произвольная программа автоматически начнёт пользоваться мелкими операциями этой библиотеки без изменения своей модели взаимодействия.
13. Коллективная операция — алгоритм над группой участников
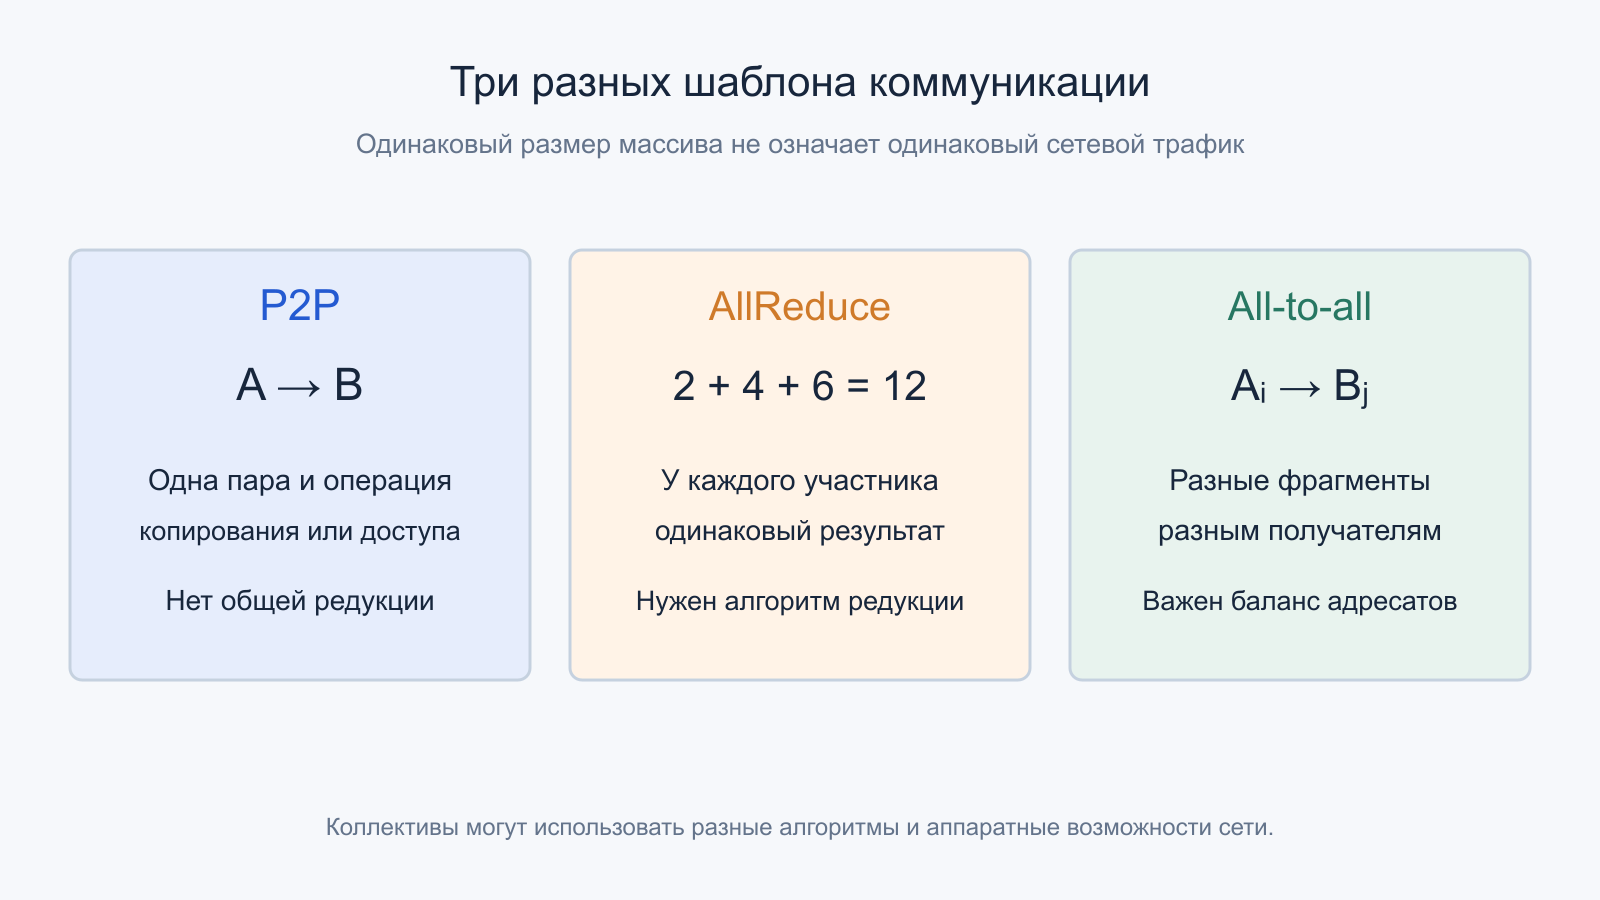
AllReduce объединяет соответствующие элементы входных массивов и возвращает результат каждому участнику. AllGather собирает части массивов без такой арифметической редукции. ReduceScatter распределяет части уже редуцированного результата. All-to-all пересылает разные фрагменты разным адресатам. Эти шаблоны создают разный трафик даже при одинаковом размере входного тензора, поэтому одной скорости P2P недостаточно для их оценки.
Учебная модель кольцевого AllReduce для восьми участников и массива 1 ГБ на каждом даёт примерно 2(n−1)S/n = 1,75 ГБ отправленных данных на участника. При идеальных 100 ГБ/с это 17,5 мс только объёмной составляющей; добавляются этапы, задержки и вычисления редукции. Это оценка выбранного алгоритма, а не универсальный объём любого AllReduce. Дерево, аппаратная редукция и иерархическая схема меняют структуру работы. Библиотека выбирает транспорт и алгоритм с учётом топологии, типа операции и размера сообщения.
14. Вычисления внутри коммутатора сокращают лишнее движение
Если коммутатор умеет выполнять поддерживаемую редукцию или размножать запись нескольким адресатам, часть работы не нужно повторять на инициаторе. NVLink Switch использует соответствующие возможности SHARP. В UALink Common 2.0 описаны коллективные примитивы и блочные коллективные операции. Их наличие в стандарте необходимо отличать от поддержки точного набора функций конкретным кремнием.
Коллективный примитив может, например, организовать чтение с редукцией либо multicast-запись. Блочная операция дополнительно переносит в коммутатор обход массива и участников. Но это не универсальный вычислительный GPU внутри каждого сетевого порта. Ограничены типы данных, операции, форматы и ресурсы одновременных коллективов. Для чисел с плавающей точкой порядок суммирования также влияет на округление: одинаковая математическая сумма не всегда означает побитовое совпадение разных алгоритмов. Ускорение коммуникации должно сохранять требуемую численную и программную корректность.
Одновременно сеть должна хранить контекст выполняемых операций. Число поддерживаемых групп, очередей и активных коллективов не бесконечно. Даже когда арифметическая функция поддержана, слишком большое количество мелких независимых групп может упереться в управление, а не в передачу байтов. При сравнении аппаратного offload полезно поэтому указывать размер группы, тип данных и количество одновременных операций. Одна выигрышная большая редукция не описывает все возможные сценарии приложения.
15. Маленькие запросы упираются в задержку и число обращений
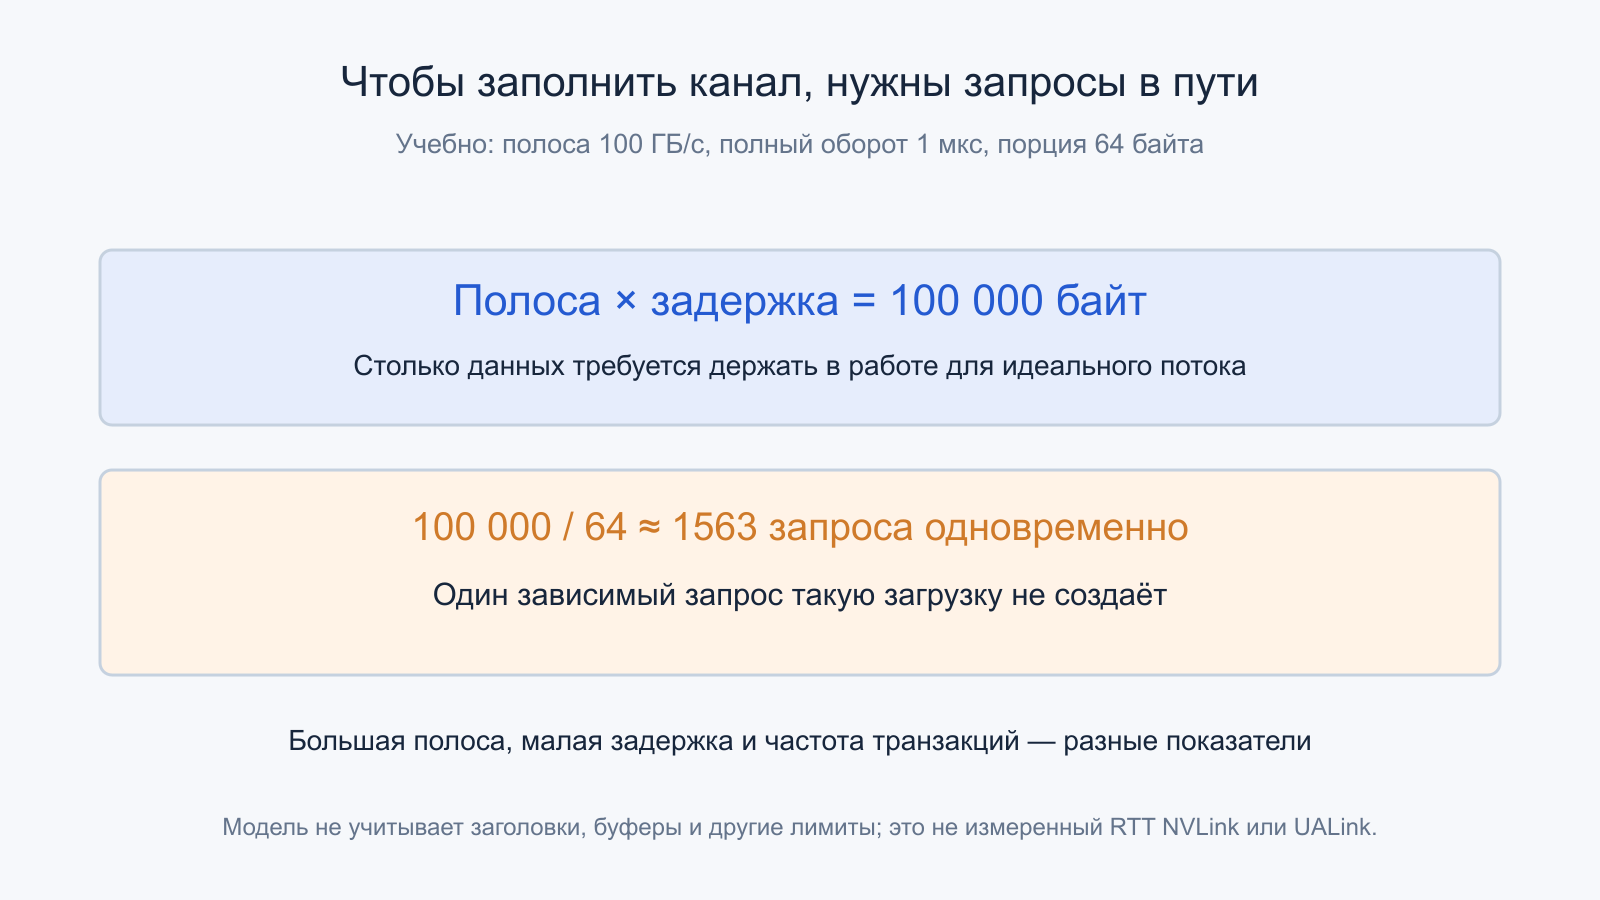
Большая полоса реализуется, когда в пути достаточно независимых данных. Учебный пример: при 100 ГБ/с и полном времени оборота запроса 1 мкс произведение полосы на задержку равно 100000 байт. Чтобы скрыть эту задержку запросами по 64 байта, потребуется примерно 1563 запроса в работе одновременно, если не учитывать служебные ограничения. Один зависимый запрос, ожидающий предыдущего, такой поток не создаёт.
Для массива 1 МиБ сама сериализация при 100 ГБ/с займёт около 10,486 мкс; вместе с выбранной постоянной задержкой получится минимум около 11,486 мкс. Для 64 байт объёмная часть составляет всего 0,64 нс, и почти всё время определяет задержка. Значения искусственные, они не являются обещанным RTT UALink или NVLink. Пример показывает, почему низкая задержка, высокая частота транзакций и пиковая полоса являются отдельными характеристиками. Результат последовательного обхода указателей может резко отличаться от потокового копирования на том же соединении.
16. Повторы, кредиты и изоляция нужны даже внутри стойки
Физическая коррекция ошибок, контроль целостности и повтор канальной единицы решают разные задачи. FEC исправляет допустимые ошибки сигнала, CRC помогает обнаружить оставшееся повреждение, а повтор восстанавливает передачу на соответствующем уровне. Срабатывание этих механизмов может увеличить задержку и её разброс без немедленного отказа всего соединения. Поэтому рабочий линк ещё не означает одинаковое поведение при любой электрической нагрузке.
Кредитное управление потоком не позволяет отправителю переполнить приёмные буферы, но ожидание кредитов само становится источником задержки. Виртуальные каналы и правила маршрутизации разделяют классы транзакций и помогают предотвращать нежелательные зависимости. В больших доменах добавляются разделение доступа, управление участниками и обработка отказов. Возможность перестроить маршрут или продолжить работу с уменьшенной полосой зависит от реализации и согласованных режимов обоих концов. Наличие такой опции в стандарте не делает её обязательной характеристикой каждого изделия.
Электрическая среда также влияет на энергетическую цену. Более длинный путь может потребовать кабеля и промежуточного восстановления сигнала; дополнительные соединения занимают выводы, площадь и мощность. Однако из одного числа пДж/бит для SerDes нельзя вычислить расход всей системы. В неё входят коммутаторы, буферы и память, а простои ускорителей могут оказаться дороже самого переноса. Оптимизация энергии требует фиксировать границу измерения и завершённый полезный объём работы.
17. Стандарт, поставленный коммутатор и работающий комплекс
У NVLink есть несколько поколений промышленных платформ и собственный программный стек. UALink прошла от первой опубликованной спецификации к набору документов 2026 года и развивающейся компонентной экосистеме. В майском сообщении Astera Labs 2026 года описаны начальные поставки Scorpio X-Series 320-lane и план наращивания производства во второй половине года. Это сведения о компоненте и заявленной стадии, а не подтверждение доступности произвольной полностью совместимой системы.
Соответствие протоколу, электрическая совместимость, поддержка прошивки и готовность библиотек проверяются отдельно. Открытый стандарт облегчает создание экосистемы с несколькими производителями, но не гарантирует, что любой ускоритель разных компаний можно смешать в одном задании без адаптации. Важны поддерживаемые операции, адресация, безопасность, коллективные алгоритмы и численные форматы. Так же NVLink Fusion расширяет варианты интеграции с инфраструктурой NVIDIA, но не превращает NVLink в электрический синоним UALink. Обещание будущего продукта должно оставаться привязанным к его анонсу и документации.
18. Система выигрывает только от сокращения критического пути
Учебный шаг вычисления содержит 30 мс арифметики и 20 мс обмена без перекрытия: всего 50 мс. Если удвоить эффективную скорость обмена, его время уменьшится до 10 мс, а весь шаг — до 40 мс. Ускорение получится 1,25 раза, а не два. Даже бесконечно быстрый обмен в этой модели ограничит ускорение величиной 50/30 ≈ 1,67. Если же обмен удаётся полностью перекрыть вычислениями, структура критического пути изменится.
Поэтому сравнение соединений начинается с профиля задачи: размера операций, шаблона адресатов, зависимостей и доступного параллелизма. Затем рассматривают одностороннюю полосу, срез топологии, память получателей, количество транзакций и программную семантику. Такой разбор показывает, почему NVLink и UALink нельзя оценить одной строкой «терабайт в секунду». Нужны согласованные аппаратные границы и алгоритм, который способен ими воспользоваться. Только измерение законченной задачи в точной конфигурации может подтвердить системный результат; спецификация предоставляет условия для этого результата.
Наконец, граница scale-up и scale-out может проходить внутри одного приложения. Часть редукции выполняется в тесном домене, затем результаты обмениваются между доменами и распространяются обратно. Скорость локального этапа не устраняет внешнюю сеть. Если меняется размер домена, меняются и количество внешних сообщений, и требования к локальной памяти. Поэтому результаты разных систем следует сравнивать при одинаковом разделении задачи, а не только при одинаковом общем числе ускорителей.
19. Первичные источники и версии сведений
Поколения и предварительные параметры приведены по официальной странице NVLink; более ранние числа шестого поколения — по техническому блогу от 20 июля 2026. Граница когерентной интеграции раскрыта на странице NVLink-C2C. Прямой доступ и синхронизация описаны в CUDA Programming Guide и модели памяти libcu++. Распределённую программную модель раскрывает NVSHMEM. Смысл коллективов объясняет документация NCCL, кольцевую оценку — AMD Primus 26.7.
UALink рассматривается по каталогу спецификаций, официальному обзору 200G 1.0, сообщению о Common 2.0 и техническим слайдам 2026 года. FAQ консорциума используется для общих свойств; его старые формулировки планов не заменяют актуальный каталог версий. Стадия поставок компонента взята из отчёта Astera Labs от 5 мая 2026 года.