UCIe: как чиплеты обмениваются данными внутри корпуса
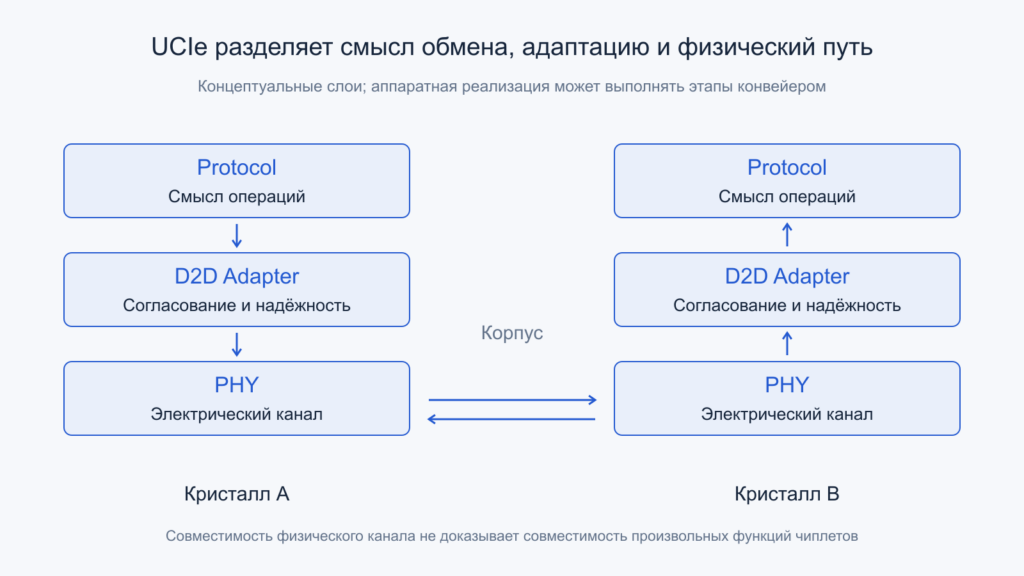
Слои отвечают за разные свойства: физическую передачу, согласование линка и смысл операций. Это концептуальное разделение, а не обязательный последовательный бюджет задержки. Открыть иллюстрацию в полном размере.
Разделить большой процессор на несколько кристаллов недостаточно: им нужен канал, который не съест выигрыш по площади, энергии и времени разработки. UCIe задаёт общий язык соединения чиплетов внутри корпуса. Его задача шире набора контактов, но уже готового стандарта совместимости любых вычислительных блоков. Два совместимых передатчика ещё не означают, что незнакомые CPU и ускоритель можно просто объединить в работающее изделие.
Ниже рассмотрены физический канал, адаптер, протоколы, упаковка, проверка и управление. Статус публичных документов сверяется на 26 октября 2026 года. Опубликованная UCIe 3.0, демонстрации в кремнии и предложения IP описаны раздельно. Численные сценарии заданы для обучения и не являются измерениями оборудования владельца сайта или универсальными параметрами стандарта.
Содержание статьи
- Граница между кристаллами меняет архитектурную цену обмена
- Три слоя отвечают за разные виды совместимости
- Что опубликовано в UCIe 3.0 и чего это не обещает изделию
- Standard и Advanced привязаны к разным условиям корпуса
- Однонаправленная полоса не равна сумме двух направлений
- Переданный такт упрощает приём, но требует контроля относительного времени
- Sideband обеспечивает жизнь линка вне основного потока
- Адаптер отделяет надёжную передачу от электрической ошибки
- Совместный транспорт не отменяет различий верхних протоколов
- Редкая битовая ошибка при большом потоке перестаёт быть редким событием
- Ремонт линий и уменьшение ширины решают разные производственные задачи
- Внутренние порты чиплетов могут ограничить быстрый PHY
- Задержка короткой операции складывается не только из сериализации
- Энергия на бит требует назвать границу измерения
- UCIe-3D расширяет область соединения, сохраняя ограничения технологии
- Управление и DFx нужны на всём жизненном цикле корпуса
- Настройка во время работы отвечает на дрейф условий
- Плотность полосы нужно относить к выбранной геометрической границе
- Совместимость доказывается последовательностью разных проверок
- Официальные первичные источники
- Читайте также
Граница между кристаллами меняет архитектурную цену обмена
В монолитной схеме данные идут через внутренние соединения и сети кристалла. При разделении появляется пара интерфейсов, дополнительные контакты, трассы корпуса и координация двух независимо изготовленных частей. Это позволяет выбирать подходящий техпроцесс для каждой функции и повторно использовать блоки, но требует оплатить переход границы. Слишком мелкое разбиение может сделать обмен дороже сохранённой логики.
Поэтому разделяют функции с учётом интенсивности связи. Контроллер ввода-вывода на зрелом процессе и вычислительный чиплет на новом узле имеют иную мотивацию, чем разделение двух тесно связанных стадий одного конвейера. Значимы не только средние гигабайты, но и зависимые короткие запросы, допустимое время ответа, общие структуры состояния и число переходов на одну полезную операцию.
UCIe снижает необходимость придумывать весь транспорт заново. Однако он не выбирает за разработчика семантику вычислительного блока, его регистры и программный интерфейс. Общий стандарт соединения полезен как фундамент согласования между поставщиками, а готовая система всё равно требует архитектурного контракта. Именно на этой границе следует отделять доказанную совместимость линка от обещания легко менять любой чиплет на любой другой.
Три слоя отвечают за разные виды совместимости
Технический разбор Synopsys показывает Physical Layer, Die-to-Die Adapter и Protocol Layer. PHY связывает цифровую логику с электрическим каналом и участвует в его подготовке. Адаптер согласует возможности, состояние линка и предусмотренные механизмы надёжной передачи. Протокольный слой задаёт смысл переносимого обмена, например PCIe, CXL или согласованный потоковый протокол.
Успешная работа каждого уровня проверяет своё свойство. Хорошее электрическое окно не доказывает правильного согласования формата, а корректно переданный пакет не подтверждает правильной обработки адреса ускорителем. Для локализации проблемы полезно наблюдать границы между уровнями. Ошибка внутреннего интерфейса может выглядеть как повреждение данных, хотя аналоговый канал передаёт выбранные биты без нарушений.
В учебной схеме отправитель сначала формирует операцию, затем адаптер готовит допустимую единицу передачи, PHY переносит её, а принимающая сторона проходит обратную последовательность. Часть действий перекрывается конвейером. Это логическое разделение не означает шесть обязательных последовательных больших задержек: физическая реализация и выбранный режим определяют, сколько работы действительно добавлено к критическому пути.
Что опубликовано в UCIe 3.0 и чего это не обещает изделию
Консорциум объявил UCIe 3.0 5 августа 2025 года. Среди изменений названы 48 и 64 GT/s для UCIe-S и UCIe-A, настройка во время работы и расширение возможностей управления. Это выпуск стандарта. Он не подтверждает серийный выпуск каждого компонента экосистемы и не делает обязательной реализацию всех необязательных функций в любом чиплете.
Совместимость с прежними версиями требует подходящих физических вариантов и согласованного режима. Старый партнёр не получает максимальную новую скорость только из-за подключения к новому PHY. Также версия протокола не заменяет сведения о напряжениях, карте контактов, допустимом корпусе и поддержанном верхнем протоколе. Таблица совместимости должна описывать конкретную пару, а не только два одинаковых логотипа.
Список нововведений помогает сформулировать требования к проекту, но не является результатом испытаний. Заявленная возможность снизить энергию или повысить отзывчивость относится к определённым механизмам и условиям. Для системного вывода нужны измерения законченной полезной работы с известными частотой, нагрузкой и температурой. Иначе улучшение максимального интерфейсного показателя ошибочно превращается в обещание такого же ускорения приложения.
Standard и Advanced привязаны к разным условиям корпуса
В исходной архитектуре различались стандартная органическая подложка и более плотные варианты упаковки. Короткое плотное соединение позволяет использовать другие электрические и геометрические компромиссы, чем более длинная трасса. Первый white paper консорциума показывает для описанной версии модули с 16 линиями данных в Standard и 64 в Advanced на направление, а также сопутствующие сигналы.
Эти числа не означают четыре одинаковых по площади интерфейса, отличающихся только настройкой регистра. Различаются шаг контактов, среда трассировки и требования к каналу. Для расчёта готового проекта нужно брать конкретную карту соединений и допускаемую организацию выбранной версии. Линии такта, управления, резервирования, питания и земли нельзя считать дополнительными полезными линиями данных.
Даже при одинаковой суммарной полосе два корпуса могут предъявлять разные требования к границе кристалла и числу слоёв разводки. Более плотная упаковка имеет собственные производственные ограничения. Поэтому корректное сравнение включает площадь PHY, занимаемую длину края, стоимость сборки, выход годных и проверку. Одно слово Advanced не доказывает, что конструкция оптимальна по цене или подходит для каждой геометрии чиплетов.
Однонаправленная полоса не равна сумме двух направлений
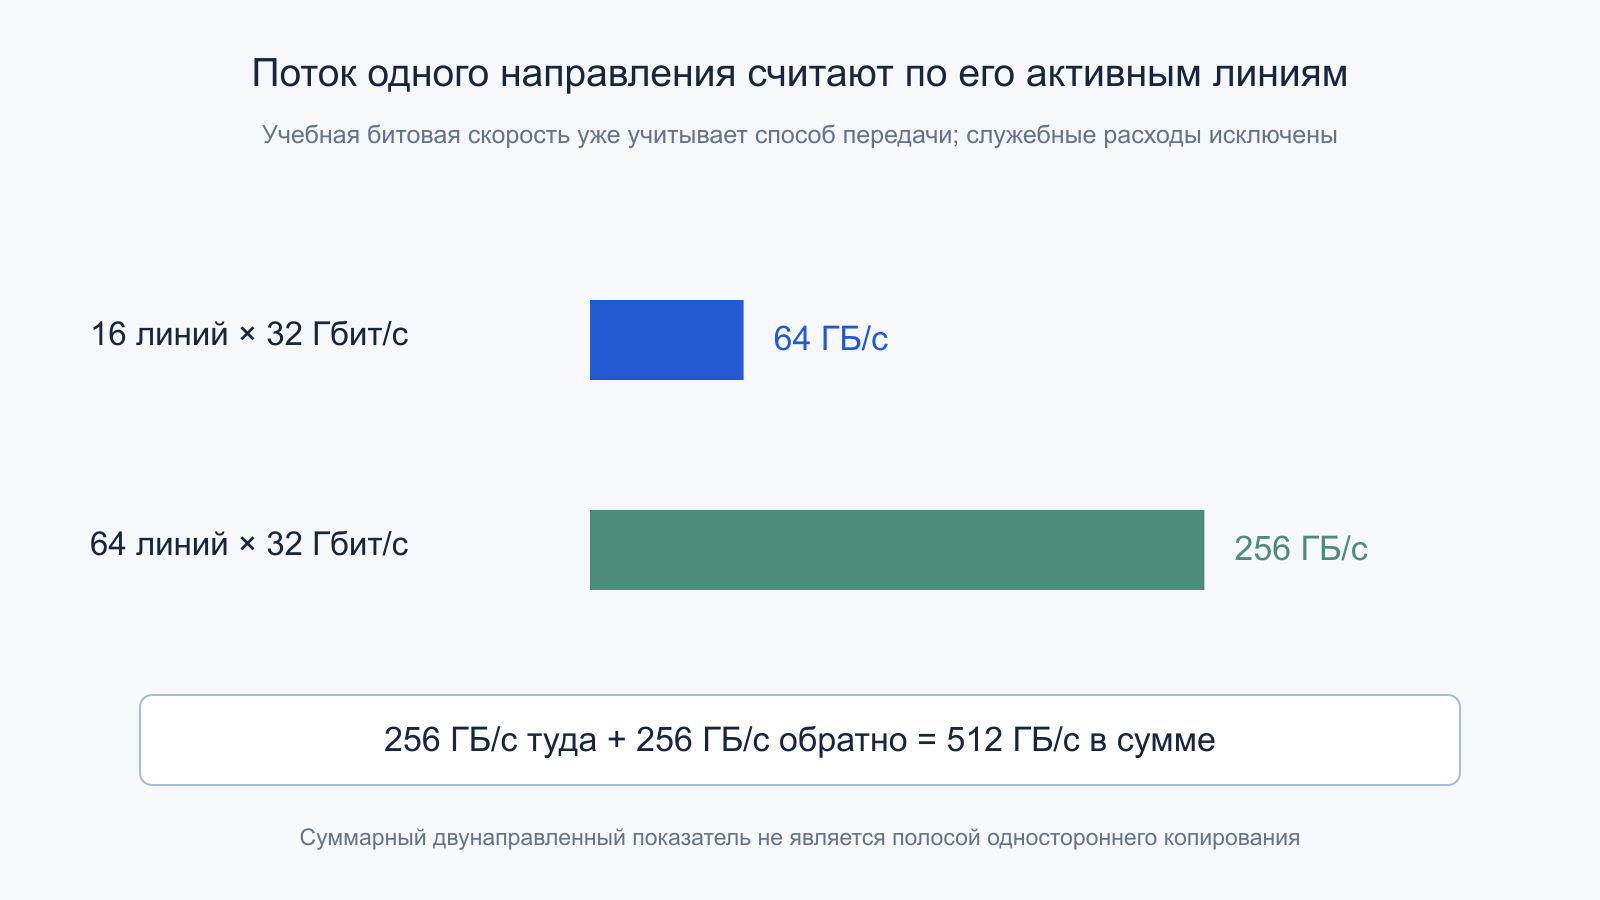
В учебной модели каждая из 16 активных линий переносит 32 Гбит/с уже определённой битовой скорости данных. Деление на восемь даёт 64 ГБ/с в одном направлении. Для 64 таких линий получается 256 ГБ/с. Если столько же доступно обратно, суммарная двунаправленная величина будет 512 ГБ/с, но отдельное одностороннее копирование не получает весь этот ресурс.
Дополнительный множитель DDR применять нельзя: скорость линии уже задана как итоговый поток битов. При сравнении с таблицей стандарта нужно проверить её определения скорости, состава линий и направления, а не смешивать битовую скорость с частотой или символами. Здесь числа являются арифметическим сценарием и не устанавливают полезную полосу любого режима UCIe 3.0.
Служебное оформление, паузы и готовность принимающего блока уменьшают поток полезного содержимого. Кроме того, протокольный запрос и ответ могут занимать разные направления несимметрично. Для чтения небольшого регистра важнее полный цикл ответа, для большого массива — установившаяся полоса. Поэтому один двунаправленный пик не годится как универсальная характеристика архитектурной границы.
Переданный такт упрощает приём, но требует контроля относительного времени
Вместе с данными передаётся тактовая информация, помогающая приёмнику выбрать момент выборки. Короткий канал внутри корпуса позволяет использовать иную организацию, чем дальний последовательный интерфейс с восстановлением такта из потока. Но преимущество не устраняет задержку трассы, перекос между линиями, шум питания и чувствительность к условиям. Значение имеет относительное положение данных и выборки.
Разброс длин, геометрия проводников и работа передатчика способны по-разному сдвигать линии. Настройка и обучение выбирают рабочие параметры для пары. Запас, достаточный в одном температурном состоянии, нельзя без проверки считать достаточным при другом. Важна область допустимых условий, включая одновременно переключающиеся соседние сигналы, а не только красивое окно одного канала в спокойном стенде.
В учебном временном бюджете единичный интервал 31,25 пс соответствует потоку 32 Гбит/с одной двоичной линии. Условные неопределённости 6 и 4 пс оставляют 21,25 пс до учёта остальных эффектов. Это не маска приёмника из спецификации и не способ сертифицировать PHY. Расчёт показывает масштаб: малое абсолютное отклонение становится значительной частью интервала при высокой скорости.
Sideband обеспечивает жизнь линка вне основного потока
Вспомогательный канал нужен для обнаружения, согласования и управления, когда основной обмен ещё не готов или меняет состояние. Поэтому его нельзя считать просто медленной копией полезного потока. Отсутствие данных на mainband может быть штатным этапом запуска, а невозможность обменяться нужными управляющими сведениями способна помешать работе даже исправной высокоскоростной части.
Официальное описание UCIe 3.0 отдельно указывает расширение sideband до 100 мм, раннюю загрузку прошивки и приоритетные сообщения. Эти 100 мм относятся к заявленной возможности вспомогательного канала, а не к универсальной дальности mainband на максимальной скорости. Перенос такого числа в подпись «64 GT/s на 100 мм» без отдельного обоснования был бы неверным.
План запуска должен определить, кто имеет питание и такт первым, откуда берётся прошивка и как фиксируется неуспешная договорённость. Также требуется проверить повторный старт после сбоя и переходы энергосостояний. Управляющий канал особенно ценен в таких ситуациях, но его наличие не гарантирует правильную последовательность: оба партнёра должны поддерживать нужные сообщения и согласованный порядок действий.
Адаптер отделяет надёжную передачу от электрической ошибки
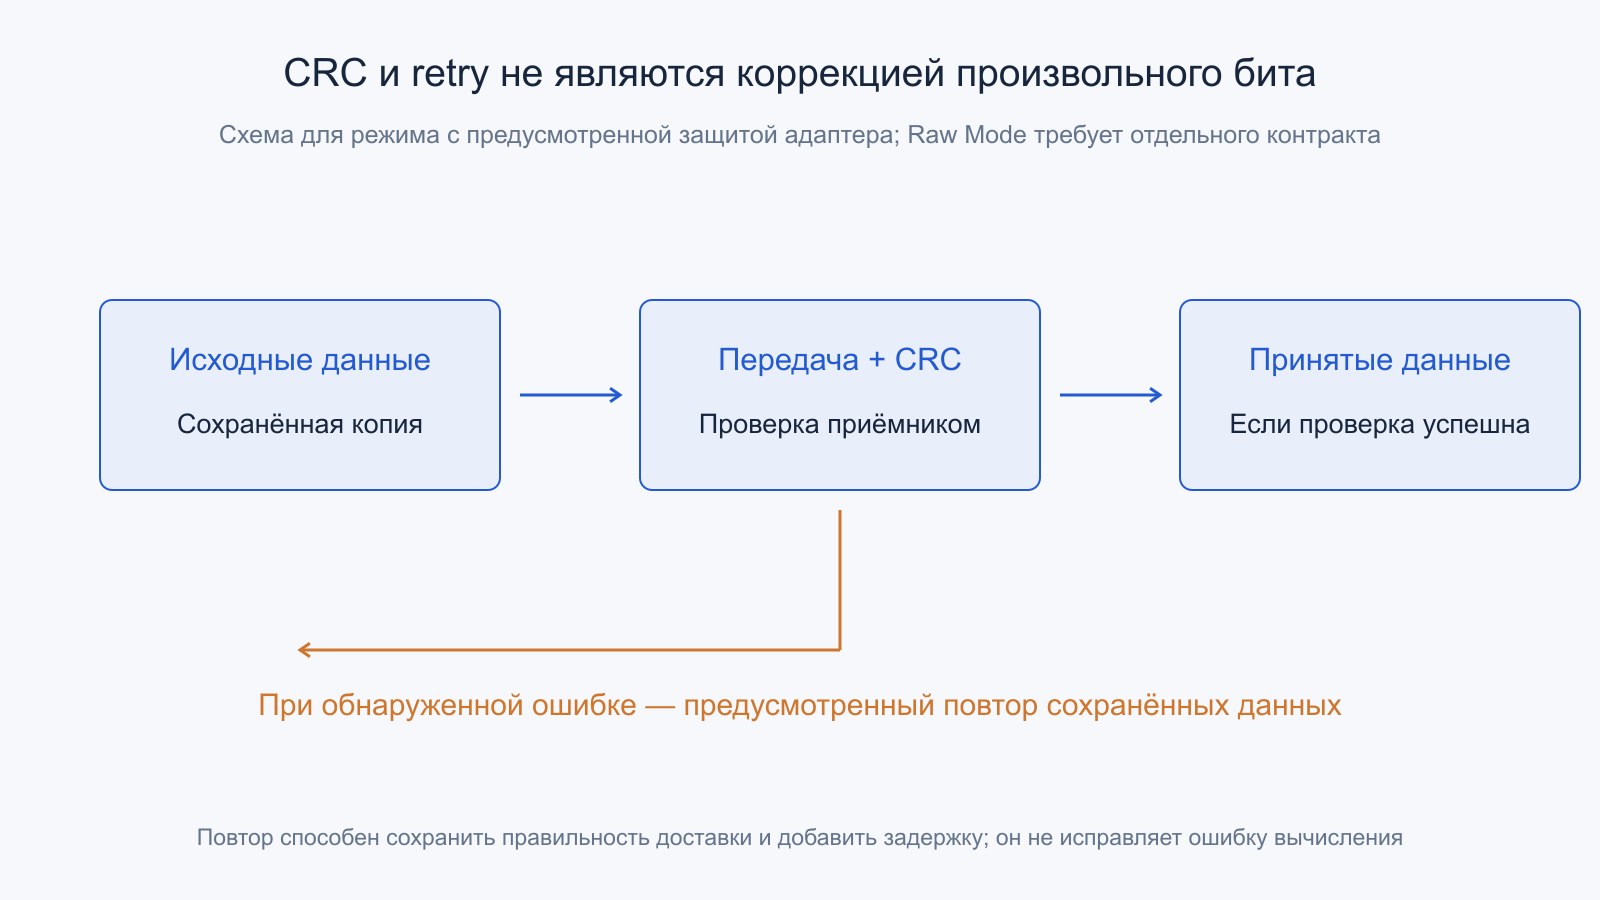
Для предусмотренных режимов CRC и повтор позволяют обнаружить повреждённую передачу и отправить сохранённые данные снова. Это отличается от коррекции отдельного бита непосредственно по избыточному коду FEC. Нельзя переносить механизм защиты внешнего PCIe-линка на UCIe только потому, что сверху переносится PCIe-протокол. Роль каждого уровня и режимы обхода должны быть определены отдельно.
Запас повторной передачи требует буферов и правил освобождения. При редких исправляемых эпизодах приложение может получать правильный результат с дополнительной задержкой. При проблеме, выходящей за пределы механизма восстановления, потребуется другая реакция. Утверждение «CRC есть, значит ошибок не бывает» неверно: конечная проверка имеет область покрытия, а повтор не исправляет логическую ошибку вычислительного блока.
White paper UCIe 1.1 описывает развитие надёжности и потоковых сценариев. Поэтому при сравнении проектов полезно указывать не только верхний протокол, но и включённые механизмы адаптера. Raw Mode и режим с предусмотренной защитой могут перекладывать ответственность на разные части системы. Без такого уточнения одинаковые числа скорости описывают разный контракт передачи.
Совместный транспорт не отменяет различий верхних протоколов
PCIe определяет одни отношения между запросом, адресом и завершением, CXL добавляет свои отношения памяти и когерентности, а потоковый протокол должен иметь согласованный контракт приложения. Выбор общего физического канала не превращает эти модели в одну. Если принимающий блок ожидает поток отсчётов, правильно доставленная транзакция другого формата сама по себе не сообщает ему, какой отсчёт вычислить.
При нескольких поддержанных протоколах нужен арбитраж общей границы. Высокий поток одной категории способен занять ресурс, важный для коротких сообщений другой. Архитектура должна сохранять необходимые условия продвижения и не создавать взаимную блокировку: например, когда ответ ждёт место, занятое запросами, завершение которых зависит от того же ответа. Корректность здесь определяется всей системой очередей.
Поэтому для оценки пары чиплетов фиксируют поддержанные форматы, правила порядка, число незавершённых операций и реакцию на обратное давление. Совместимость PHY является необходимой частью такого соглашения, но не исчерпывает его. Для нестандартного потокового режима особенно важно явно описать потерю, повтор и идентификацию данных: аппаратная доставка не должна незаметно менять смысл единицы работы.
Редкая битовая ошибка при большом потоке перестаёт быть редким событием
Зададим исключительно учебные raw BER 10⁻¹⁵ и непрерывный поток 2×10¹² бит/с. Средняя интенсивность ошибочных битов равна 0,002 в секунду, то есть один на 500 секунд. Это статистическое среднее при принятой модели, а не расписание, по которому неисправность обязана появляться каждые восемь минут. Реальная зависимость ошибок от времени и условий может отличаться.
Расчёт относится к сырым битам до предусмотренной защиты, поэтому не является частотой испорченных файлов или неверных результатов. Часть событий обнаруживается и обрабатывается, часть режимов имеет иные требования. Для конечного вывода нужны вероятность необнаруженного повреждения, реакция на неисправность и границы измерения. Нельзя выдать исходный BER за готовую надёжность приложения.
Он всё же объясняет, зачем короткому соединению внутри корпуса нужны механизмы контроля и наблюдения. Пик битового потока умножает число возможностей ошибки. Проверка при разных температурах и режимах питания важнее одного продолжительного опыта в удобной точке. Отсутствие замеченных событий за ограниченное время задаёт только соответствующее наблюдение, а не доказательство физически нулевого риска.
Ремонт линий и уменьшение ширины решают разные производственные задачи
Если предусмотрены резервные соединения, неисправную линию можно заменить согласованным отображением. Другая стратегия — продолжить работу меньшей шириной, пожертвовав частью полосы. Допустимость зависит от варианта упаковки и конкретного режима; наличие такой возможности нельзя автоматически приписать любому интерфейсу с логотипом UCIe. Физический дефект и ошибка настройки также требуют разной диагностики.
В учебном примере исправная группа из 64 линий при 32 Гбит/с даёт 256 ГБ/с на направление. Продолжение работы на 32 активных линиях уменьшило бы арифметический предел до 128 ГБ/с. Но задача, уже ограниченная внутренним портом 64 ГБ/с, может почти не изменить своё установившееся время. Поэтому число потерянных линий и наблюдаемая потеря производительности не обязаны совпадать по проценту.
Механизм восстановления помогает выходу годных, но не заменяет проверку запасов. Соединение, которое едва выдерживает режим после включения, способно ухудшаться при нагреве. Нужны сведения о том, когда разрешена перенастройка и как она отражается на состоянии верхних уровней. Изменение ширины не должно незаметно нарушать обещанный контракт доступности или задержки сервиса.
Внутренние порты чиплетов могут ограничить быстрый PHY
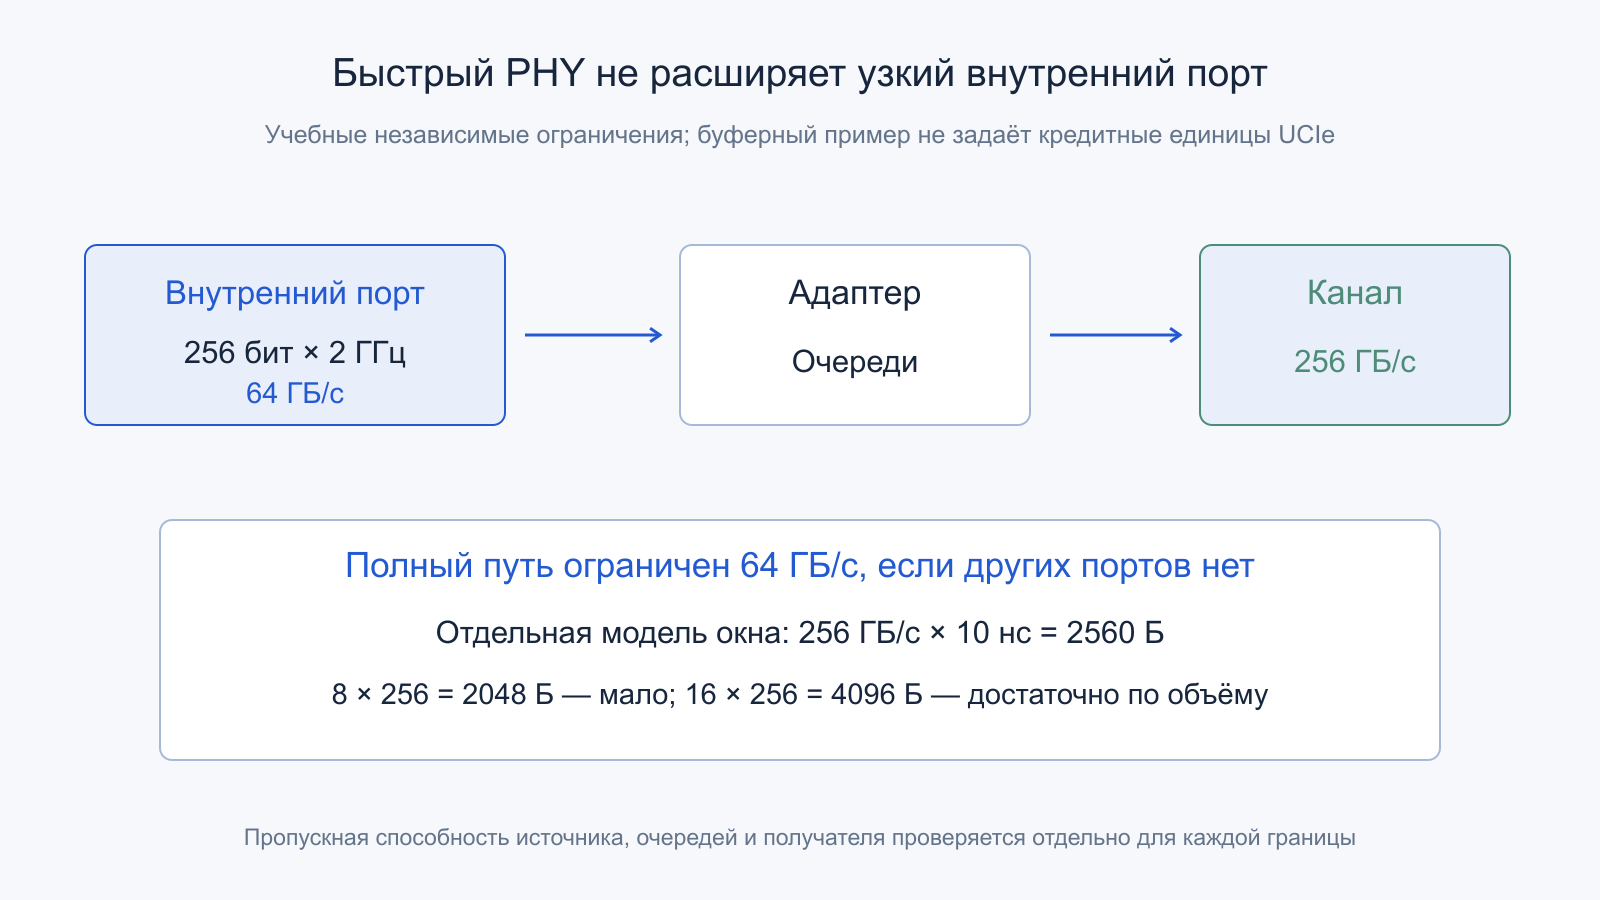
Пусть интерфейс между адаптером и внутренней сетью передаёт 256 бит за цикл при 2 ГГц. Его идеальный поток равен 64 ГБ/с. Даже если внешний участок корпуса допускает 256 ГБ/с, данный внутренний порт становится ограничением, если нет других независимых портов или иного способа подачи. Само наличие широкой трассы не гарантирует, что вычислительный блок умеет её заполнить.
Для полного пути проверяют источник, очереди, преобразование ширины, арбитраж и приёмник. Иногда несколько узких портов действительно работают параллельно, но это должно следовать из архитектуры и нагрузки. Простое умножение частоты PHY на число контактов описывает только одну границу. Изменение максимальной скорости линка может ничего не дать, пока перед ним простаивает недостаточно широкий мост.
В очередях тоже нужна соответствующая ёмкость. Для условного потока 256 ГБ/с и полного цикла освобождения ресурса 10 нс в пути должно находиться 2560 байт. Восемь буферов по 256 байт дают 2048 и недостаточны в этой модели; шестнадцать дают 4096. Это оценка объёма в пути, а не предписание числа буферов UCIe или заявление о кредитных единицах стандарта.
Задержка короткой операции складывается не только из сериализации
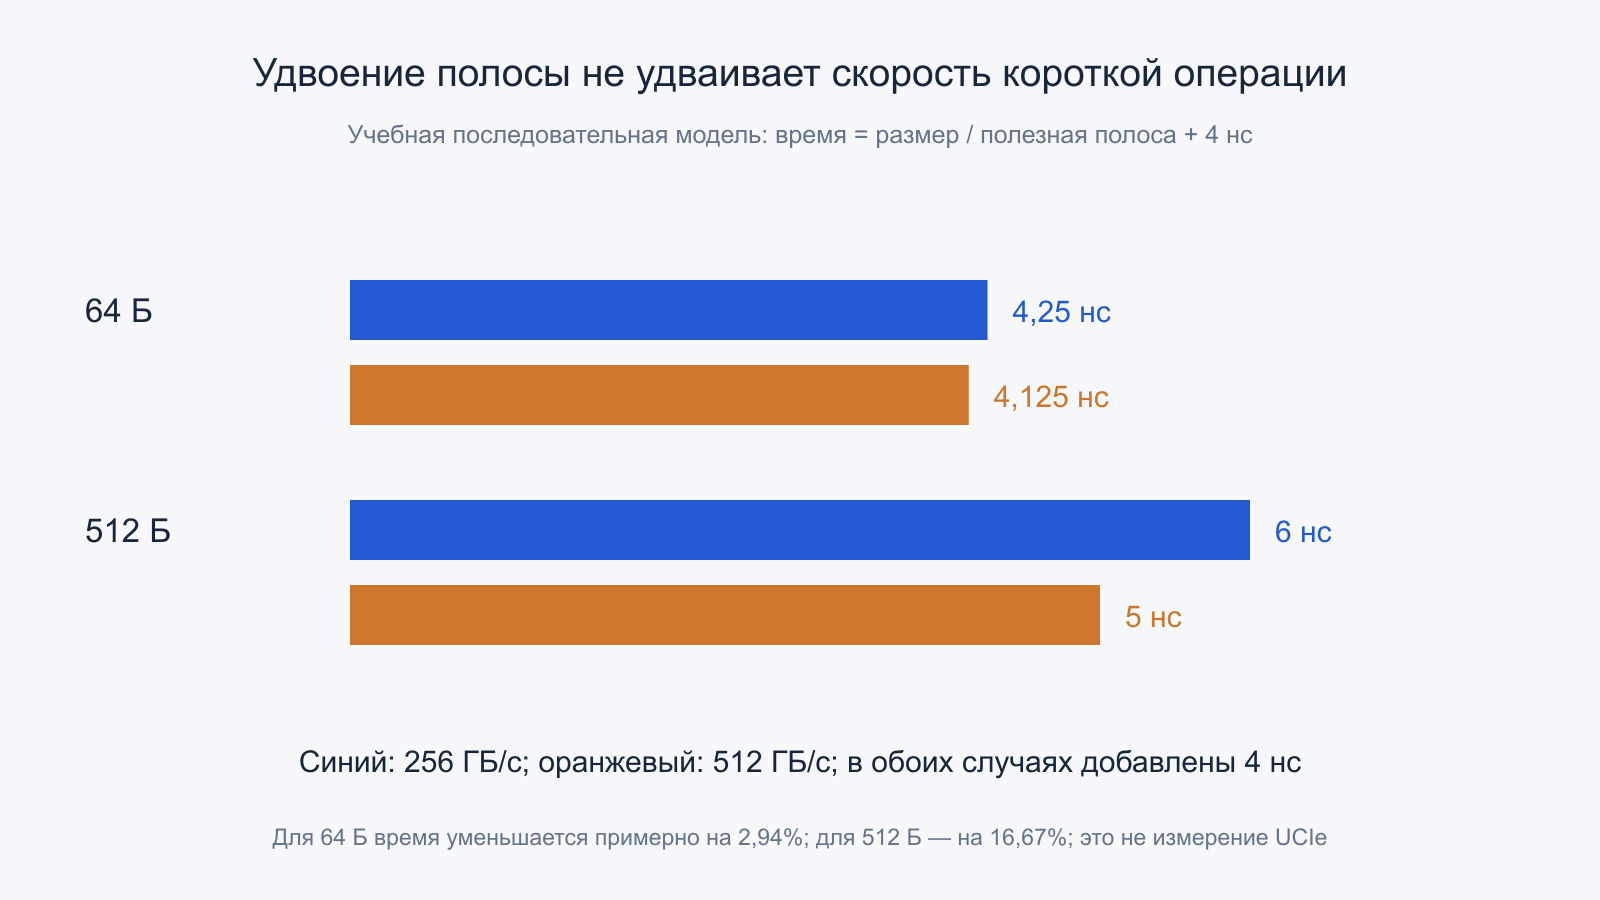
При условной полезной полосе 256 ГБ/с передача 64 байт занимает 0,25 нс, а 512 байт —2 нс. Добавим одинаковые четыре наносекунды обработки интерфейсов и остальных заданных этапов. В простой последовательной модели получаем 4,25 и 6 нс. Это показывает, почему увеличение полосы не обязано пропорционально ускорить короткий зависимый обмен.
Если полоса удвоится до 512 ГБ/с, те же суммы станут 4,125 и 5 нс. Для малого сообщения выигрыш около 2,94%, для большого —16,67%. В реальном конвейере этапы способны перекрываться, фиксированные расходы не всегда постоянны, а запрос-ответ содержит обратный маршрут. Поэтому модель не прогнозирует конкретный чиплет: она лишь отделяет время битового переноса от остальных составляющих.
Архитектурный вывод — считать число пересечений границы на полезную работу. Если каждая арифметическая операция вынуждена ждать удалённого ответа, узкое место способно находиться в зависимостях, а не в контактах. Пакетная обработка и локальное повторное использование уменьшают частоту переходов, однако требуют дополнительных буферов и могут менять задержку отдельного задания. Выбор зависит от цели системы.
Энергия на бит требует назвать границу измерения
В учебной модели передача 256 ГБ/с означает 2,048×10¹² бит/с. Если переменная энергия выбранного тракта равна 0,5 пДж на бит, соответствующая мощность составляет 1,024 Вт; при 1 пДж получится 2,048 Вт. Это не потребление всего корпуса и не паспорт UCIe. Расходы тактирования, управления, фонового состояния и вычислителей здесь отдельно не заданы.
Двунаправленный одновременный поток потребует учитывать оба направления, если модельная энергия применяется к каждому. Но нельзя автоматически удваивать измеренное полное потребление пары PHY, уже включающее приём и передачу. Перед сравнением двух решений выясняют, что входит в числитель и знаменатель. Разные границы способны давать похожие красивые пДж/бит при существенно разной энергии полезной задачи.
При короткой редкой нагрузке значим переход из простоя и фоновая мощность. Более широкий канал может быстро завершить работу и уйти в экономичный режим либо, наоборот, тратить больше при ожидании. Для честного сравнения нужна одна и та же последовательность заданий за одинаковый интервал. Улучшение активной энергии передачи не гарантирует такого же улучшения автономности или температуры законченного устройства.
UCIe-3D расширяет область соединения, сохраняя ограничения технологии
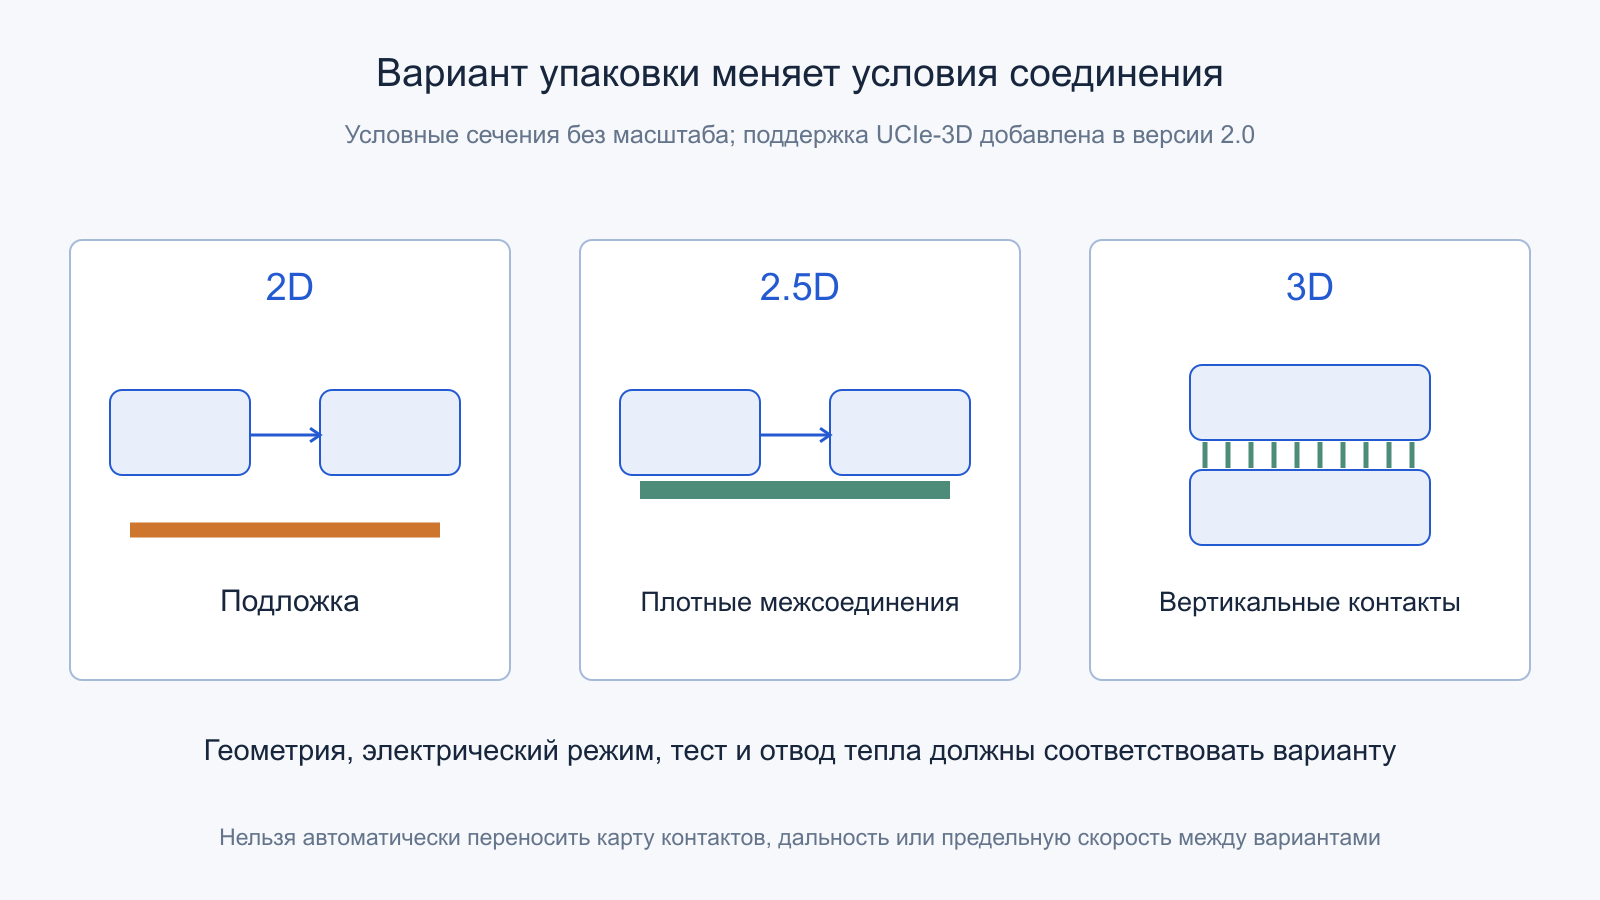
Релиз UCIe 2.0 от 6 августа 2024 года добавил поддержку 3D-упаковки. Вертикальные плотные соединения позволяют иначе использовать площадь и длину пути, чем боковой интерфейс. При этом слово 3D не означает, что прежнюю карту контактов достаточно повернуть на девяносто градусов: геометрия, тактирование и производственные условия требуют подходящего варианта.
Плотность контактов не равна полезной полосе на квадратный миллиметр без дополнительных данных. Часть площади занята питанием и управлением, а частота, энергия и доступность подключённых блоков также ограничены. Даже очень короткая электрическая связь не решает автоматически отвод тепла из нижнего активного кристалла. Параметры интерфейса следует оценивать вместе с конструкцией стека.
Вертикальная интеграция также усиливает значение предварительной проверки: после соединения внутренние поверхности недоступны обычному щупу. Поэтому архитектура теста должна существовать до сборки. Плотное соединение — ресурс для согласованной системы, а не самостоятельная гарантия пропорционального ускорения. Объявленную поддержку стандарта отделяют от освоенного шага соединения конкретной фабрики и подтверждённого выхода годных.
Управление и DFx нужны на всём жизненном цикле корпуса
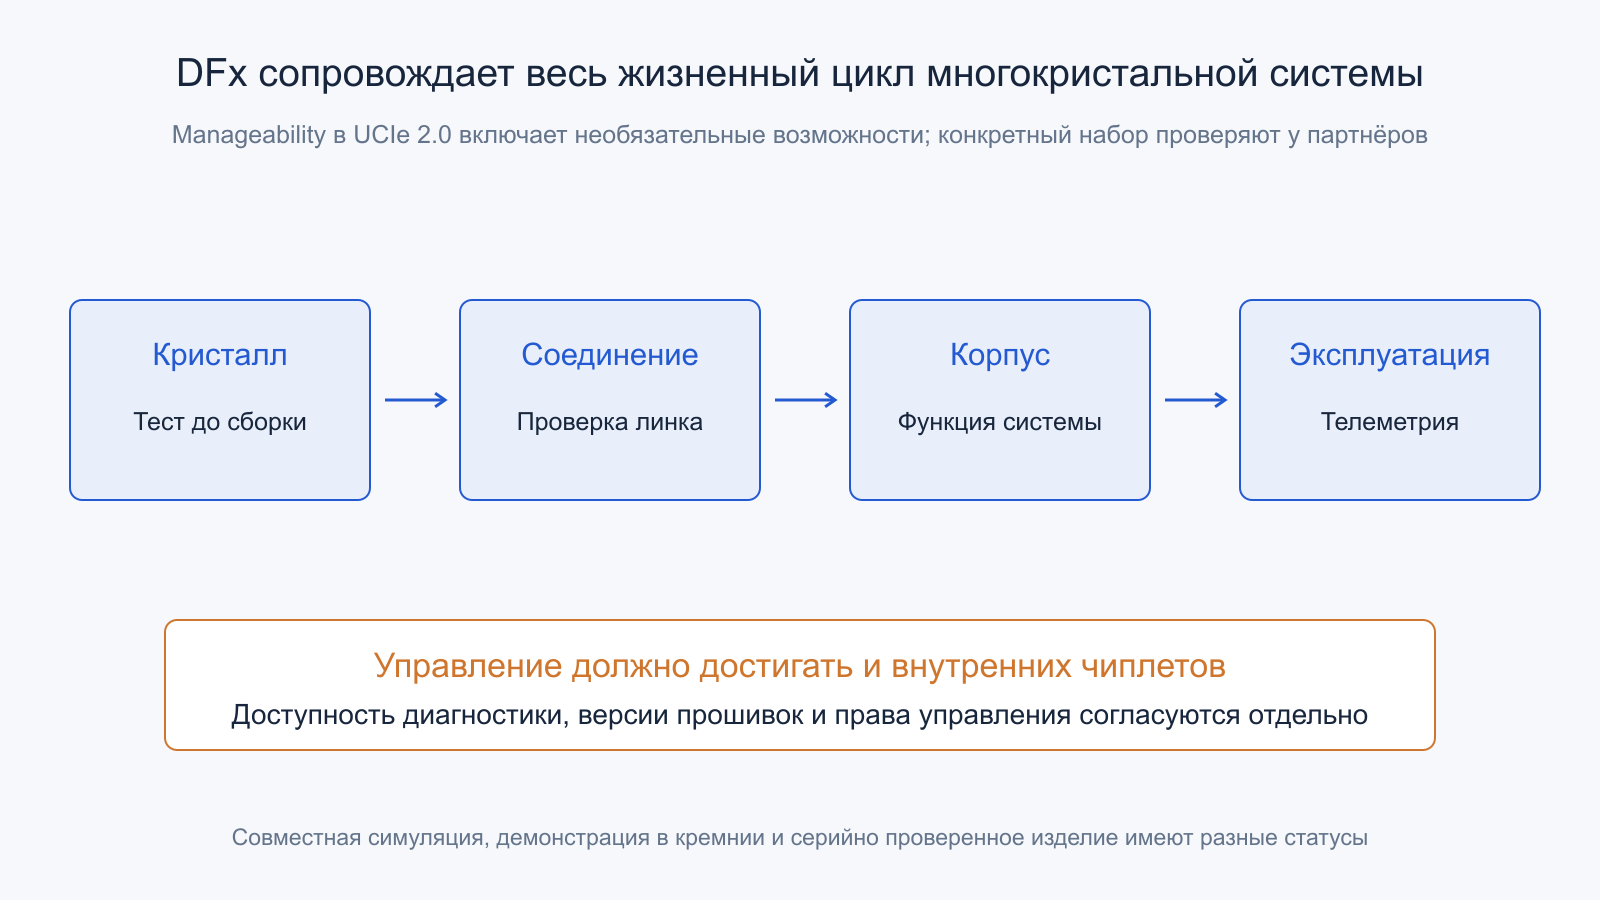
White paper UCIe 2.0 рассматривает тестирование, телеметрию и отладку от проверки кристалла до эксплуатации. Для многокомпонентной системы мало узнать, что общий внешний интерфейс перестал отвечать. Нужен путь к состоянию отдельных участников, включая те, которые не имеют непосредственного выхода на контакты корпуса.
Средства управления являются согласуемой частью реализации, а не доказательством, что любой поставщик открыл все внутренние данные. Для приёмки определяют доступные счётчики, диагностические режимы, обновление прошивки и реакцию на сбой одного чиплета. Проверяют также права доступа: производственный тестовый путь не должен произвольно предоставлять эксплуатационному ПО управление скрытым состоянием другого компонента.
Обновление одного участника способно изменить ожидаемое поведение соседей. Поэтому фиксируют совместимость версий, безопасную последовательность запуска и способ восстановления после неудачного обновления. Наличие MTP как механизма транспорта не означает автоматического совпадения политик доверия и содержимого прошивок. Интеграция должна определить, кто имеет право менять компонент и как остальные убеждаются, что он готов к предусмотренной работе.
Настройка во время работы отвечает на дрейф условий
Нагрев, изменение напряжения и состояние окружающей логики способны сдвигать рабочую точку канала. Описание решений UCIe 3.0 у Synopsys отдельно выделяет runtime recalibration и готовность компонентов IP. Это объясняет назначение механизма: поддерживать подходящую настройку при изменении условий, вместо предположения, что измеренная при запуске точка останется оптимальной всегда.
Но сама перенастройка требует правил взаимодействия с потоком. Проект должен определить, возникают ли паузы и как они отражаются на буферах, предельной задержке и готовности приложения. Если данные непрерывного источника нельзя остановить, недостаточно проверить только среднюю скорость. Нужен запас для допускаемых временных перерывов либо иной согласованный способ принять поток без потери.
В учебном случае вход приносит 20 ГБ/с, а основной канал недоступен 2 мкс. Для сохранения входа на этот интервал нужно минимум 40000 байт свободного буфера, без дополнительных запасов. Буфер 32 КиБ меньше требования, а 64 КиБ покрывает его по объёму. Это общий расчёт очереди, не нормативная длительность перекалибровки UCIe и не обещание конкретного механизма остановки.
Плотность полосы нужно относить к выбранной геометрической границе
Интерфейс расходует не только площадь логики PHY, но и доступное место для выхода соединений. В учебном варианте 64 ГБ/с занимают два миллиметра края кристалла: получается 32 ГБ/с на миллиметр. Другой вариант даёт 256 ГБ/с на четырёх миллиметрах, то есть 64 ГБ/с на миллиметр. Ускорение общей полосы вчетверо сочетается лишь с двукратным улучшением такой плотности.
Это не то же отношение, что гигабайты в секунду на квадратный миллиметр площади PHY или контактной области. Сравнивать эти показатели без указания знаменателя нельзя. Кроме того, часть края может быть занята питанием, другим интерфейсом либо ограничением размещения. Полностью свободную геометрию нельзя предполагать только потому, что сумма площадей блоков помещается в контур.
У плотного соединения также остаются ограничения разводки и подачи данных со стороны внутренней сети. Поэтому интерфейс проектируют вместе с расположением памяти, вычислительных узлов и силовых путей. Хорошее число в отдельном макроблоке не доказывает хорошую компоновку всего чиплета. Полезная метрика привязана к конкретному корпусу и достижимому режиму, а не к абстрактному минимуму шага контактов.
Совместимость доказывается последовательностью разных проверок
Материал Intel и Cadence прямо описывает simulation interoperability. Совместная симуляция помогает найти различия интерпретации протокола до изготовления, но не измеряет электрический запас реального корпуса. Такая проверка имеет важное место в процессе, если её статус сохраняют и не называют результатом серийного аппаратного испытания.
Intel в сентябре 2023 года показала тестовый корпус с чиплетами UCIe IP на Intel 3 и TSMC N3E, соединёнными EMIB. Это уже демонстрация в кремнии, но она тоже не является подтверждением произвольной взаимозаменяемости всех компонентов или поставки UCIe 3.0 в тот момент. Дата события и версия проверенного решения имеют значение.
Для законченного изделия последовательно подтверждают соответствие выбранному режиму, совместимость пары IP, физическую реализацию, работу при предельных условиях и полезную функцию системы. Затем добавляют производственный тест и наблюдение в эксплуатации. Пропуск одного этапа нельзя компенсировать логотипом стандарта. UCIe делает такую цепочку более общей и согласованной, сохраняя необходимость проверять каждый конкретный корпус.
Официальные первичные источники
- UCIe Consortium — выпуск UCIe 3.0, 05.08.2025.
- UCIe Consortium — Specifications: возможности версий.
- UCIe Consortium — Building an Open Chiplet Ecosystem.
- UCIe Consortium — UCIe 1.1 White Paper.
- UCIe Consortium — выпуск UCIe 2.0, 06.08.2024.
- UCIe Consortium — UCIe 2.0 White Paper.
- Synopsys — Unpacking the Rise of Multi-Die SoCs with UCIe.
- Synopsys — UCIe 3.0 Chiplet IP Solutions.
- Cadence — Intel Collaboration: Simulation Interoperability, 2024.
- Intel — Innovation 2023, UCIe test-chip demonstration.