PCI Express без мифов: линии, топология, разделение ресурсов и реальная скорость
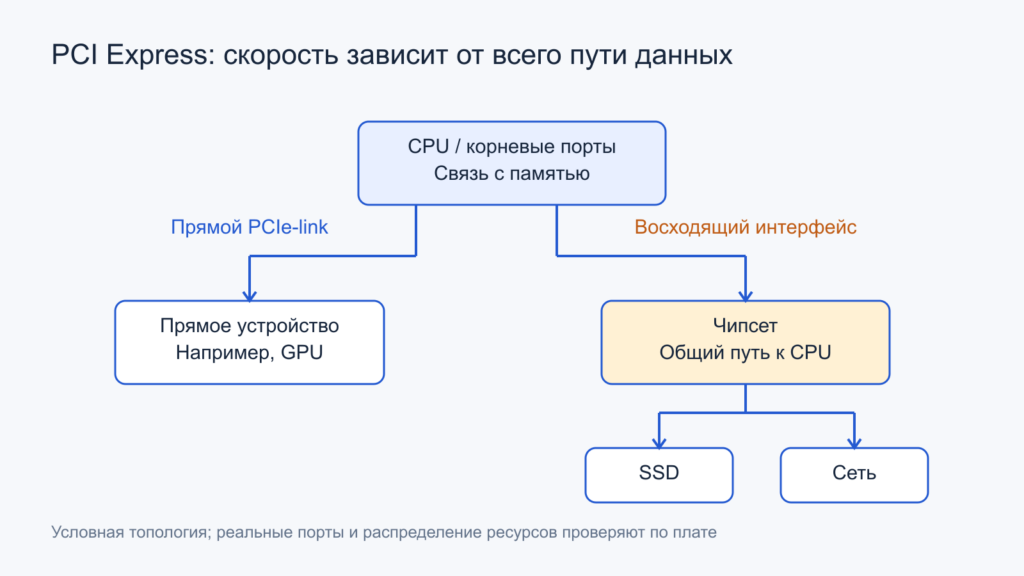
Для скорости важен маршрут целиком. Локальные подключения чипсетных устройств не гарантируют такую же независимую полосу до CPU. Открыть иллюстрацию в полном размере.
Видеокарта установлена в длинный разъём x16, но работает через восемь линий. Два быстрых накопителя показывают хорошие результаты по отдельности, а при одновременной работе замедляются. После установки ещё одного M.2 меняется режим соседнего слота. Такие ситуации объясняются не одним словом «PCIe», а сочетанием физического подключения, согласованного режима и топологии всей платформы.
PCI Express — пакетное соединение с несколькими уровнями протокола. Его поколение задаёт возможности передачи на линии, ширина определяет число линий, а общий путь данных может включать дополнительные узлы. Разобрав эти три уровня отдельно, можно считать реальные ограничения без мифов о «магическом x16» и без ожидания паспортной скорости во всякой задаче.
Содержание статьи
- Линия PCIe — не общий провод всех устройств
- GT/s, гигабиты и гигабайты
- Почему формулу 128/130 нельзя переносить на Gen6
- Пакеты уменьшают долю полезных данных
- Полоса не равна задержке одного обращения
- Root complex, прямое подключение и чипсет
- Разделение линий и общий бюджет — разные ситуации
- Bifurcation: несколько портов вместо одного
- Коммутатор PCIe не является пассивным разветвителем
- Размер слота, возможности карты и согласованный режим
- Управляющие обращения и DMA решают разные задачи
- Почему x8 не означает половину кадров в секунду
- Накопитель и сеть имеют дополнительные пределы
- Как проверить топологию на практике
- Проверочный список для любого утверждения о PCIe
- Официальные источники
- Читайте также
Линия PCIe — не общий провод всех устройств
PCIe строится из соединений между двумя портами. Одна линия содержит отдельные дифференциальные пары для передачи в противоположных направлениях. Поэтому соединение поддерживает одновременный обмен туда и обратно. Четыре линии означают четыре таких набора, а не одну пару, которую по очереди делят четыре устройства.
Линии объединяются в link определённой ширины: например, x1, x4, x8 или x16. Пакеты распределяются по доступным линиям средствами интерфейса. Устройства на разных ветвях топологии имеют отдельные соединения, но их дальнейшие пути способны сходиться на общем участке. Независимые локальные связи ещё не означают независимую полосу до оперативной памяти.
Материал PCI-SIG об эволюции PCI Express показывает переход к соединениям между портами, полнодуплексный обмен и разделение протокола на уровни. Формат разъёма — только один из способов разместить такой интерфейс физически. PCIe может находиться в обычном слоте расширения, M.2 и других конструкциях.
GT/s, гигабиты и гигабайты
GT/s характеризует скорость передач линии в принятом обозначении поколения. Гигабайты в секунду описывают объём данных. Чтобы перейти от характеристик линии к полезным байтам, нужно учесть кодирование, число линий, направление и накладные расходы протокола. Одна цифра GT/s не является скоростью копирования файла.
Для PCIe Gen1 и Gen2 используется кодирование 8b/10b: из десяти передаваемых бит восемь соответствуют исходным данным на этом уровне. Для обычного режима Gen3–Gen5 применяется 128b/130b. После этого всё ещё остаются заголовки и служебные передачи. Коэффициент кодирования убирает только один вид расходов.
Удобная оценка для Gen3–Gen5: B = R × L × (128/130) / 8, где R — GT/s на линию, L — ширина, результат выражен в десятичных ГБ/с для одного направления. В этой модели Gen4 x4 даёт 16 × 4 × 128/130 / 8 ≈ 7,877 ГБ/с. Это предел после кодирования, до дальнейших расходов протокола.
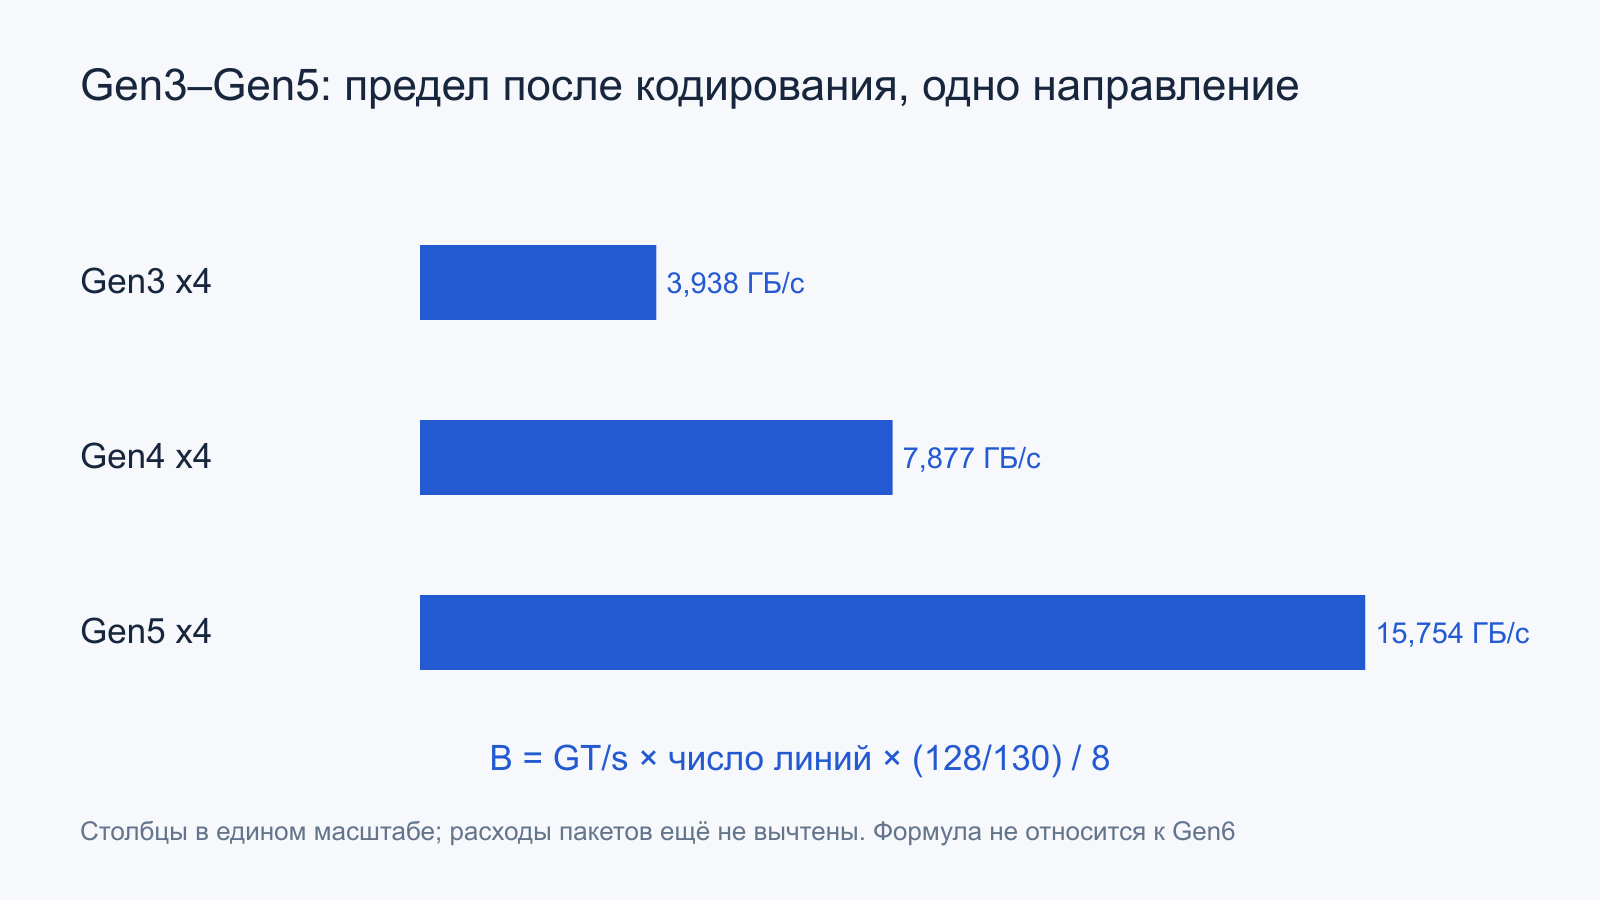
Gen3 x8 даёт примерно такую же величину: 8 × 8 × 128/130 / 8 ≈ 7,877 ГБ/с. У Gen4 x8 и Gen5 x4 соответствующий предел около 15,754 ГБ/с. Равная полоса не делает соединения полностью равнозначными: различаются электрические требования, возможная топология, задержки и поддержка устройств.
Как не получить двукратную ошибку направления
Если Gen4 x4 допускает около 7,877 ГБ/с в одном направлении, оба направления вместе дают около 15,754 ГБ/с в таком же теоретическом учёте. Однако чтение из устройства в память не получает всю сумму автоматически. Для определённой операции сначала рисуют направление основных данных и отдельно — служебных запросов и подтверждений.
Суммарная полнодуплексная цифра полезна при одновременном обмене в обе стороны. Она становится вводящей в заблуждение, когда её сравнивают с однонаправленным результатом SSD или сетевого потока. При сложной нагрузке важен бюджет каждого направления на каждом общем участке, а не одна удвоенная цифра на коробке.
Почему формулу 128/130 нельзя переносить на Gen6
PCIe 6.0 меняет физическую передачу и формат обмена: используются PAM4, коррекция FEC и передача фиксированными блоками FLIT. PAM4 различает четыре уровня сигнала и кодирует больше информации за один символ, чем двухуровневая передача. При этом официальное обозначение скорости Gen6 — 64 GT/s — нельзя ещё раз произвольно удваивать из-за четырёх уровней.
FAQ PCI-SIG объясняет PAM4 и 256-байтную структуру FLIT, а описание PCIe 6.0 указывает 64 GT/s и до 256 ГБ/с для полнодуплексной x16-конфигурации. Для одного направления соответствующая суммарная исходная величина — до 128 ГБ/с; полезная загрузка пакетов определяется новой структурой расходов.
Нельзя взять 64, умножить на 128/130 и назвать результат точной пользовательской скоростью Gen6. Нельзя и сравнить FLIT со старым заголовком, будто поменялся только размер пакета. Новые механизмы связаны с надёжностью передачи при другом электрическом режиме. В статье численные расчёты кодирования относятся к явно указанным поколениям Gen3–Gen5.
Пакеты уменьшают долю полезных данных
Обращение к устройству оформляется транзакцией. Нужны адрес, тип операции, длина и другие служебные сведения. На соседних уровнях добавляются механизмы контроля, подтверждения, управления потоком и при необходимости повторной передачи. Полезные данные занимают только часть обмена; доля зависит от размера и вида транзакций.
Учебная модель: условный пакет содержит 256 байт результата и 24 байта совокупных расходов, которые мы решили учесть. Доля данных равна 256/(256 + 24) ≈ 91,43%. Из исходных 7,877 ГБ/с остаётся около 7,20 ГБ/с в границах этой модели. Число 24 не объявляется универсальным заголовком PCIe: реальные расходы зависят от режима и структуры передачи.
Если в той же упрощённой модели оставить 64 байта данных при прежних 24 байтах расходов, доля снизится до 72,73%, а оценка — до 5,73 ГБ/с. Служебный обмен других видов и паузы здесь не учтены. Пример показывает причину: короткие полезные порции труднее приблизить к пределу линии при фиксированных расходах на каждую порцию.
Параметры максимальной полезной нагрузки и запросов чтения влияют на разбиение работы, но их увеличение не является универсальным способом ускорения. Значение имеют возможности всего пути, буферы и ограничения конкретного устройства. Ручная смена неизвестных настроек ради цифры способна поменять поведение системы без понятной выгоды.
Почему передатчик иногда ждёт при свободной линии
Получатель должен иметь место для принимаемых пакетов. Механизм управления потоком сообщает передатчику доступный ресурс в виде кредитов для соответствующих типов заголовков и данных. Если необходимых кредитов недостаточно, новый пакет ждёт даже при высоком электрическом качестве соединения. Так ограничение буферов превращается в ограничение темпа.
Материал PCI-SIG относит управление потоком на основе кредитов к устройству транзакционного обмена. Для понимания важно, что номинальная полоса линии и возможность непрерывно подавать пакеты — разные условия. Буферы и обслуживание получателя способны ограничить передачу до достижения физического потолка.
Чтение также включает запрос и возвращаемые данные, которые могут приходить несколькими завершениями. Запросы необходимо различать и учитывать до их окончания. Если разрешено мало одновременной работы, ожидание ответа оставляет интерфейс недогруженным. При передаче записи структура обмена другая, поэтому одинаковый link может показывать разные результаты чтения и записи без изменения числа линий.
Полоса не равна задержке одного обращения
Быстрое соединение помогает доставлять много данных, если есть готовые пакеты и получатель успевает их принимать. Небольшой запрос может большую часть времени ждать решения устройства, ответа памяти или программного обслуживания. Сокращение времени передачи нескольких байтов на линии почти не меняет остальную цепочку.
Рассмотрим условную систему, где полный цикл обработки запроса на 4 КиБ занимает 20 мкс и следующий запрос разрешён только после предыдущего. Темп не превысит 4096/20 мкс = 204,8 МБ/с. Это время всей выбранной модели, а не заявленная задержка PCIe, SSD или конкретного контроллера.
Если та же модель позволяет поддерживать 32 независимых запроса в работе и обслуживание перекрывается, оценка вырастает до 32 × 4096/20 мкс = 6,5536 ГБ/с. Затем уже могут проявиться линия, память и возможности устройства. Сама по себе большая очередь не гарантирует такое перекрытие и способна ухудшить задержку отдельного запроса.
Поэтому результаты с большой глубиной очереди и время одной интерактивной операции описывают разные режимы. Высокая пропускная способность под нагрузкой может соседствовать с заметными задержками отдельных обращений. Для практической задачи нужно определить, что важнее: завершать больше работы за секунду или быстро отвечать на один запрос.
Root complex, прямое подключение и чипсет
Со стороны системы PCIe обслуживается корневым комплексом и его портами. Часть устройств может быть подключена непосредственно к портам процессора, другая — через чипсет. На пути от чипсетных устройств к CPU появляется общий восходящий интерфейс. Несколько локальных x4-подключений способны конкурировать именно там.
В реальном примере Intel Z790 указаны DMI 4.0 с максимум восемью линиями и собственные чипсетные PCIe-ресурсы. Это отдельный интерфейс CPU–PCH, который Intel описывает в справке DMI. Его нельзя путать с независимыми слотами и складывать максимумы всех портов как гарантированную полосу до памяти.
Паспорт чипсета также не говорит, что все перечисленные возможности одновременно выведены на любую материнскую плату. Производитель распределяет ресурсы между разъёмами, встроенными контроллерами и другими функциями. Значение имеют разводка, мультиплексоры, выбранный CPU и ограничения совместного использования.
Как считать общий участок
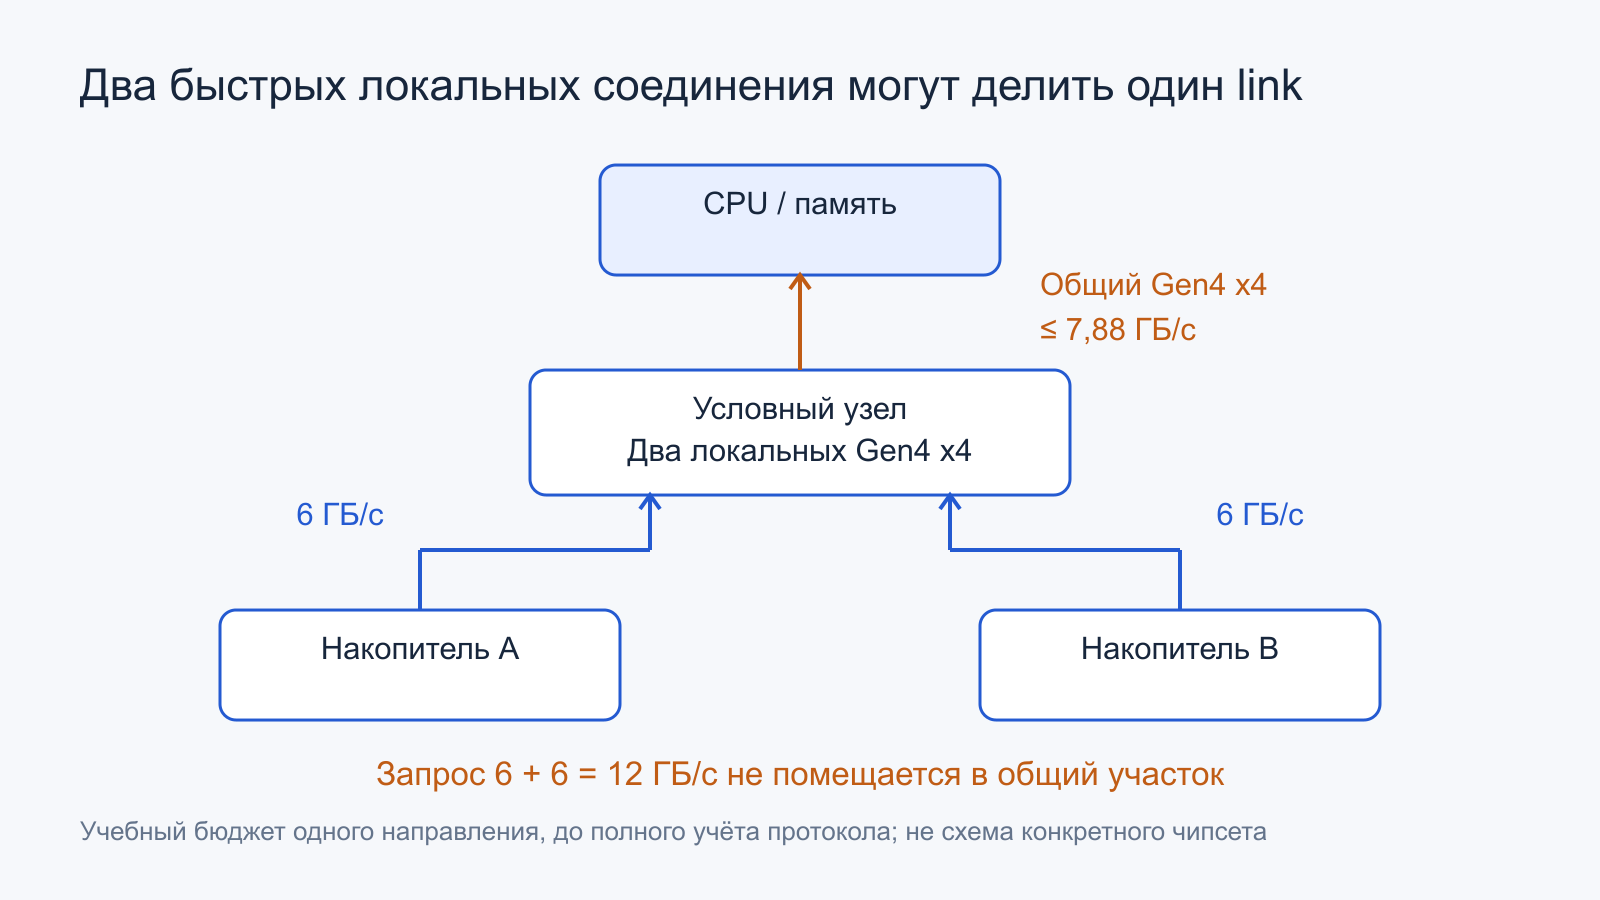
В учебной топологии два накопителя имеют локальные Gen4 x4, но находятся за общим восходящим PCIe Gen4 x4. Каждый локальный link имеет теоретический предел около 7,877 ГБ/с после кодирования. Два потока по 6 ГБ/с в одном направлении требуют 12 ГБ/с и не помещаются в общий участок даже до полного учёта служебных расходов.
Один поток способен работать быстро, пока второй почти бездействует. При одновременной нагрузке доступный ресурс распределяется, и результаты меняются. Сумма не обязана делиться поровну: влияют арбитраж, размеры запросов, другие потребители и поведение устройств. Этот сценарий не является описанием Z790; у него явно задан условный PCIe-восходящий link.
Для копирования между двумя устройствами важно дополнительно установить маршрут. Если данные проходят через системную память, возникают передача к памяти и передача из неё. Если доступен иной маршрут, условия зависят от поддержки платформы и ПО. Наличие двух устройств за одним узлом не доказывает, что приложение использует прямой peer-to-peer обмен.
Разделение линий и общий бюджет — разные ситуации
В первом случае физический набор линий распределяется между портами. Например, предусмотренная платформой группа x16 может работать как два x8. Тогда у каждого порта постоянно своя ширина, даже если соседнее устройство бездействует. Один x8 не превращается обратно в x16 при каждом свободном такте соседа.
Во втором случае оба устройства сохраняют собственные локальные соединения, но делят дальнейший участок тракта. Их текущая конкуренция зависит от нагрузки. Путать эти случаи опасно для объяснения: изменение отображаемой ширины и просадка суммарной скорости при параллельном обмене имеют разные механизмы.
Есть и жёсткое альтернативное использование ресурса. Разъём M.2 может отключать другой порт или менять его режим по правилам конкретной платы. Это не постоянное свойство всех M.2 и не признак, что любой накопитель «забирает линии видеокарты». Ответ находится в таблице совместного использования и блок-схеме данной модели.
Bifurcation: несколько портов вместо одного
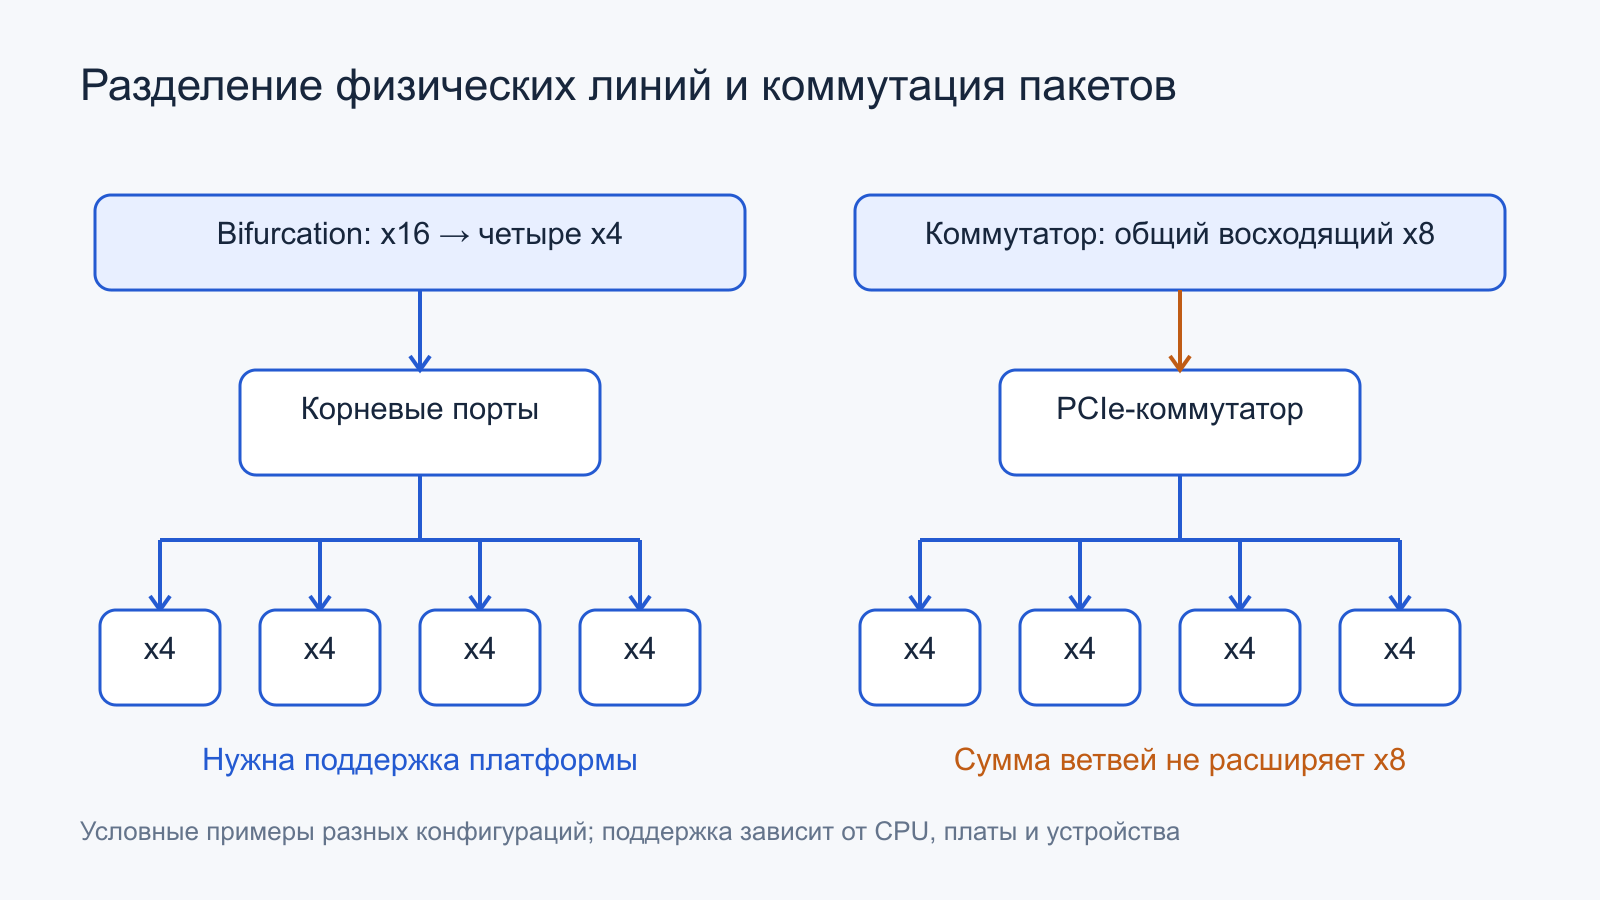
Bifurcation означает предусмотренное разделение группы линий на несколько самостоятельных соединений. Чтобы пассивная плата с несколькими M.2 работала ожидаемым образом, нужны подходящие режимы корневых портов, разводка слота и настройка прошивки. Простая механическая возможность вставить переходник не создаёт эти возможности.
Условный вариант x16 → x4 + x4 + x4 + x4 позволяет подключить четыре устройства по четырём линиям каждое. Но платформа может поддерживать только x8 + x8, другие варианты или не предоставлять нужного разделения в этом слоте. Поддержка определяется одновременно процессором и конкретной реализацией платы.
Таблицы ASUS для Hyper M.2 и bifurcation полезны именно этой конкретностью: число доступных устройств рассматривается вместе с моделью платы, процессором и выбранным разъёмом. Такой документ проверяют для своего сочетания. Универсальное обещание четырёх SSD от любого длинного слота технически необоснованно.
Коммутатор PCIe не является пассивным разветвителем
PCIe-коммутатор принимает и маршрутизирует пакеты между восходящим и нисходящими портами. Он способен дать нескольким устройствам отдельные локальные соединения, даже когда хост предоставляет один link подходящей ширины. У него есть логика, буферы, поддерживаемые режимы и собственные ограничения.
Если суммарная ширина нисходящих портов больше восходящей, появляется переподписка ресурса. Четыре локальных x4 за восходящим x8 не создают полосу x16 до CPU. Для работы устройств по очереди это может быть приемлемо; при одновременной передаче в одном направлении общая граница проявится.
Retimer и redriver решают другую задачу: помогают прохождению сигнала в сложном физическом тракте предусмотренным способом. Они не создают новые независимые корневые порты и не добавляют полосу как ещё один набор линий. Наличие активной микросхемы на адаптере само по себе ещё не означает наличие PCIe-коммутатора.
Размер слота, возможности карты и согласованный режим
Длинный слот x16 может быть электрически подключён как x4. Карта с длинным контактным краем тоже способна использовать меньше линий по проекту. Возможная механическая совместимость, максимальные характеристики обеих сторон и фактически согласованная ширина — три разных записи. Для объяснения скорости нужны все три.
При установлении связи порты выполняют предусмотренные процедуры обнаружения и подготовки. Итог зависит от общего поддерживаемого режима и пригодности физического тракта. Совместимость поколений обычно позволяет работать на доступной меньшей скорости, но это не обещание любой комбинации устройств, переходников и прошивок без ограничений.
В простое некоторые системы уменьшают текущую скорость link для экономии энергии. Поэтому показание утилиты на неподвижном рабочем столе не всегда отражает режим под нагрузкой. При этом нельзя объяснять энергосбережением любое неожиданное x1 вместо x16: ширину проверяют отдельно по возможностям, распределению линий и фактическому состоянию.
Управляющие обращения и DMA решают разные задачи
Для начала работы драйвер настраивает устройство и организует буферы. Небольшие обращения к регистрам управления не похожи на длительную передачу большого массива. Регистры или память устройства могут быть отображены через области BAR, но само наличие такой области не говорит о достигнутой полосе и не означает, что CPU программно копирует каждый байт.
DMA позволяет устройству выполнять предусмотренный обмен с системной памятью без отдельной процессорной команды на каждое слово. Процессор всё равно участвует в подготовке работы, а драйвер обеспечивает правильное владение буферами и порядок действий. Маленькие частые задачи способны упираться в это обслуживание раньше, чем крупные непрерывные передачи.
Документация DMA API ядра Linux различает адреса CPU, адреса DMA и преобразование через IOMMU. Устройство не получает автоматически тот же адрес, который использует обычный процесс приложения. Отображение и разрешённость доступа являются частью работы платформы; они не добавляют физическую ширину PCIe.
Практический вывод относится к методике: низкий результат коротких транзакций может объясняться организацией очередей, уведомлений и памяти. Его нельзя уверенно исправить выбором более высокого поколения интерфейса. Сначала устанавливают, какая часть полного цикла занимает время и действительно ли по линии идёт достаточно данных для её насыщения.
Почему x8 не означает половину кадров в секунду
Графический процессор выполняет большую часть работы с данными в собственной памяти. PCIe участвует в загрузке ресурсов, командах и других обменах, но не обязан передавать каждый промежуточный пиксель между GPU и CPU. Если нужная рабочая область остаётся в видеопамяти, скорость линии может не определять время каждого кадра.
При интенсивном обмене, нехватке видеопамяти или иной организации задачи влияние PCIe способно вырасти. Направление и объём трафика различаются у игры, вычисления, рендеринга и обработки видео. Поэтому уменьшение теоретической полосы вдвое не задаёт постоянного процента потери производительности приложения.
Resizable BAR относится к доступному отображению памяти устройства в адресное пространство системы. Более крупная область отображения может изменить способ работы ПО, но не добавляет физические линии и не удваивает скорость передачи. Объём адресуемой области и полоса интерфейса — разные характеристики, которые легко смешать из-за общего слова «память».
Накопитель и сеть имеют дополнительные пределы
Быстрый PCIe-link не делает SSD равномерно быстрым. Контроллер, NAND, характер обращений, состояние записи, температура и программный путь создают собственные ограничения. Скорость больших последовательных блоков и небольших случайных операций относится к разным режимам. Внешний интерфейс задаёт верхнюю границу пути, но не заменяет устройство внутри накопителя.
Для сетевой карты проверяют направление и единицы. Условный поток 25 Гбит/с соответствует 3,125 ГБ/с до учёта сетевых расходов. Теоретический Gen4 x1 около 1,969 ГБ/с не смог бы переносить такой поток данных целиком в одном направлении. Gen4 x2 даёт около 3,938 ГБ/с после кодирования, но сама карта и порт должны поддерживать нужную конфигурацию.
Поток 100 Гбит/с соответствует 12,5 ГБ/с, поэтому даже Gen4 x4 с пределом 7,877 ГБ/с недостаточен для такого однонаправленного объёма. При этом номер скорости сети не означает, что весь этот объём всегда переносится в пользовательский буфер: влияют пакеты, выгрузка работы на контроллер и система обработки. Сначала определяют реальную задачу, затем проверяют бюджет интерфейса.
Как проверить топологию на практике
Сначала сохраняют модель CPU, платы и версию прошивки, перечисляют слоты и встроенные устройства. В руководстве находят блок-схему, электрическую ширину каждого разъёма, таблицы совместного использования и допустимые режимы разделения. Фраза «поддерживается PCIe 5.0» без указания порта не отвечает на вопрос о конкретной карте.
Затем сопоставляют возможности устройства, порта и текущий режим. Диагностические средства ОС показывают дерево PCIe и параметры link; названия полей зависят от инструмента. Максимальная скорость поддержки отличается от текущей. Данные снимают в понятном состоянии нагрузки, не меняя одновременно несколько параметров.
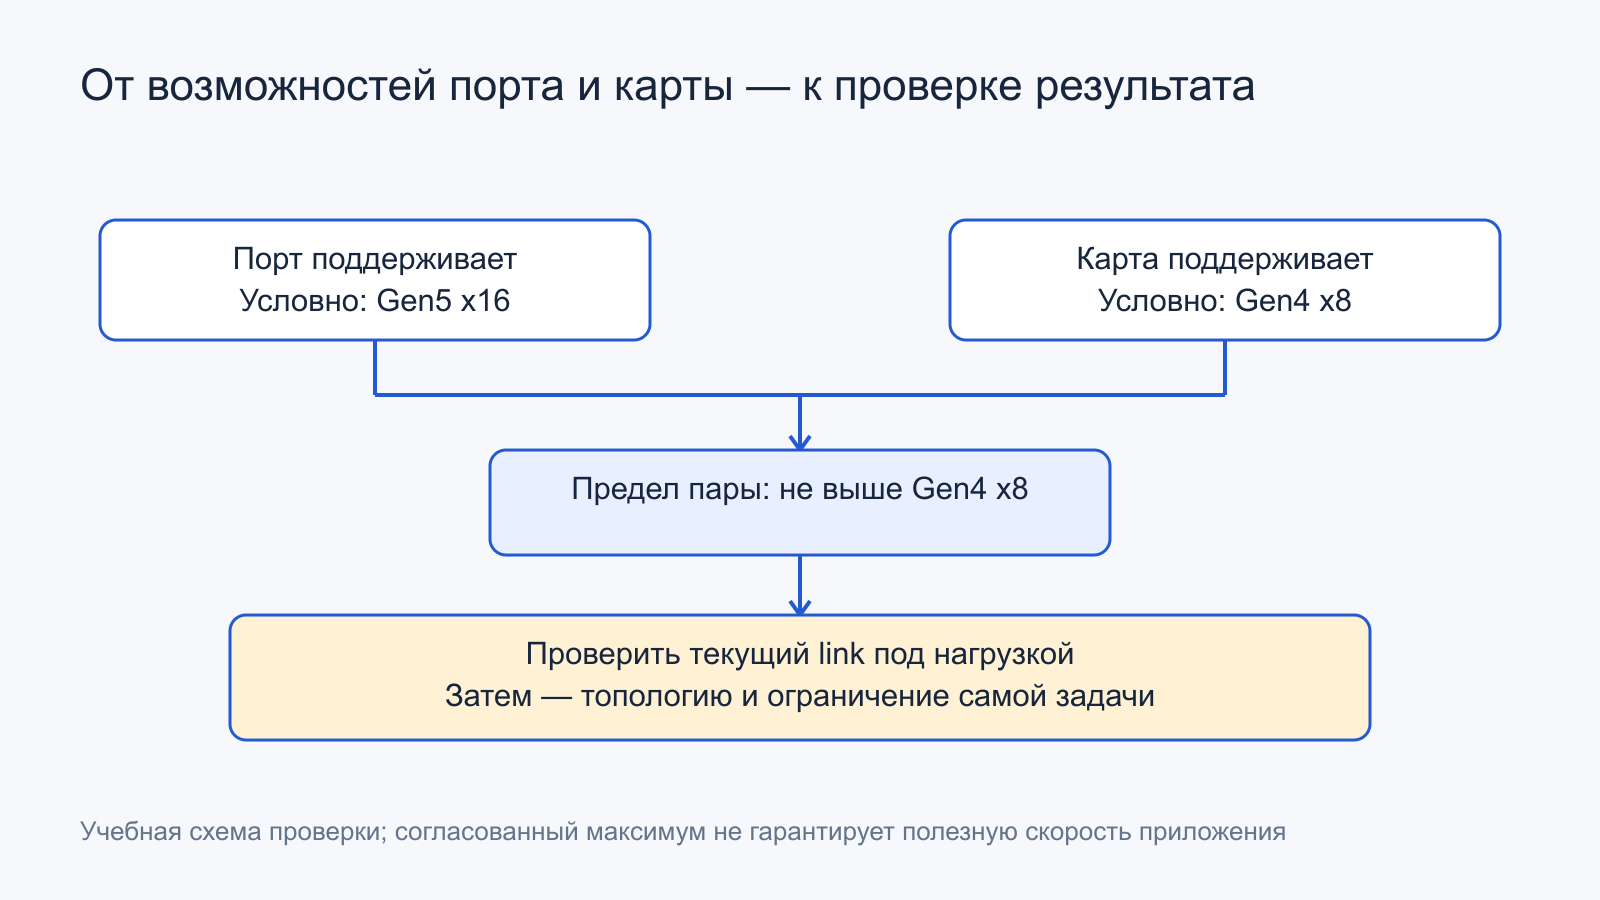
Для поиска общего ограничения сравнивают одинаковые операции по отдельности и одновременно. Если суммарный результат стабильно упирается в один уровень, проверяют общую часть пути и остальные ресурсы: CPU, память, источник данных и программную обработку. Похожая форма графика сама по себе не доказывает насыщение PCIe.
Ошибки link, повторные передачи и переход на меньший режим могут указывать на недостаточный запас соединения, но требуют контекста. Значение имеют разъёмы, райзеры, питание, прошивка и само устройство. Для измерения электрического качества нужны специальная оснастка и подходящие средства; обычная прозвонка не подтверждает передачу на высокой скорости.
Перестановку внутренних карт выполняют при предусмотренном отключении питания; наличие PCIe не означает поддержку горячей замены данной конструкции. Сигнальную скорость нельзя использовать для вывода о допустимой мощности слота или кабеля. Электрическое питание и передача данных имеют отдельные требования.
Проверочный список для любого утверждения о PCIe
- Названы поколение, согласованная ширина и направление обмена.
- GT/s переведены в байты с правильным учётом поколения и кодирования.
- Суммарная полнодуплексная цифра не выдана за скорость одного потока.
- Размер разъёма отделён от электрической ширины и возможностей карты.
- Прослежен путь через CPU, чипсет или коммутатор до нужного ресурса.
- Bifurcation отделён от коммутации пакетов и разделения общей полосы.
- Паспортный предел не подменяет измерение определённой задачи.
Надпись PCIe описывает только часть системы. Надёжное объяснение скорости получается, когда для каждого участка известны его режим, направление и соседние участники. Тогда можно понять как высокий результат отдельной карты, так и ограничение, которое проявляется лишь при совместной работе нескольких устройств.
Официальные источники
- PCI-SIG — 30 Years of PCI-SIG Innovation: топология, уровни и кодирование поколений PCI Express.
- PCI-SIG — PCI Express 6.0 Specification: особенности Gen6 и границы опубликованных значений полосы.
- PCI-SIG — PCI Express 6.0 FAQ: PAM4, FEC, FLIT и полнодуплексное значение x16.
- Intel — Z790 Chipset Specifications: пример ресурсов чипсета и интерфейса DMI.
- Intel — What Is the Direct Media Interface: назначение связи процессора с PCH на определённых платформах.
- ASUS — Compatibility of PCIe Bifurcation Between Hyper M.2 Cards and Add-On Graphics Cards: зависимость разделения от платы, CPU и слота.
- Linux Kernel Documentation — Dynamic DMA Mapping Guide: адреса DMA, BAR и участие IOMMU.
Комментарии