SMT и логические ядра: как два потока делят один процессорный конвейер
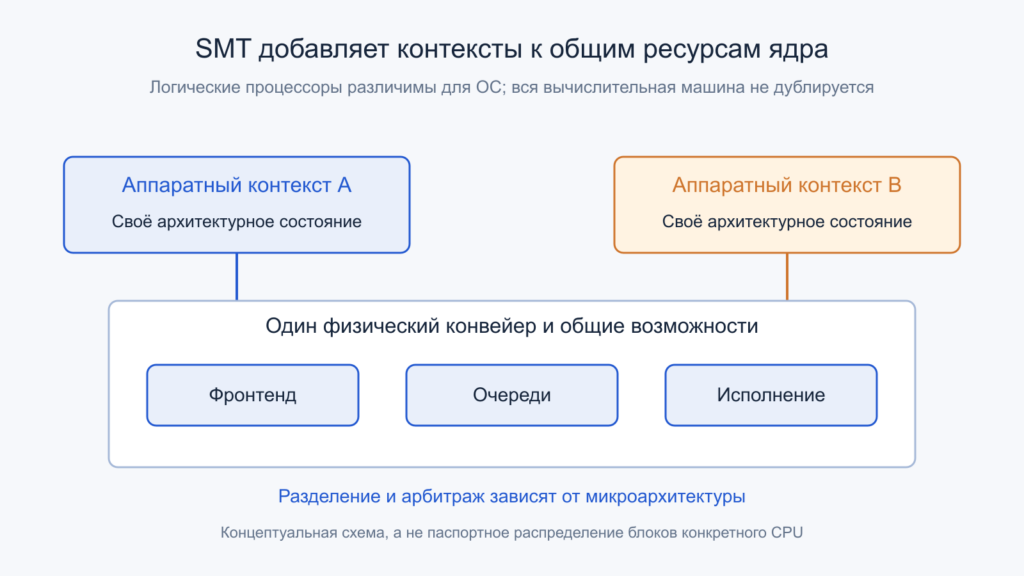
Раздельное архитектурное состояние делает контексты различимыми для ОС. Вычислительные ресурсы физического ядра не дублируются целиком, а политика их использования зависит от реализации. Открыть иллюстрацию в полном размере.
В системе видны шестнадцать логических процессоров, но физических ядер всего восемь. После увеличения числа рабочих потоков задача заканчивается быстрее, хотя каждый отдельный поток выполняет свой участок дольше. В другом приложении те же дополнительные потоки ухудшают результат. Оба наблюдения совместимы с нормальной работой SMT: второй аппаратный контекст помогает использовать общий конвейер, одновременно создавая конкуренцию за его ресурсы.
Разберём, что именно разделяют соседние аппаратные потоки, откуда берётся выигрыш и почему загрузка CPU не показывает занятость всех вычислительных блоков. Численные примеры ниже учебные, с явно заданными условиями; они не являются измерениями компьютера владельца сайта. Конкретные политики разделения буферов и кэшей всегда относятся к определённой микроархитектуре, а не ко всем процессорам с похожим количеством потоков.
Содержание статьи
- Программный поток, аппаратный контекст и физическое ядро
- Раздельное архитектурное состояние не означает два независимых конвейера
- SMT отличается от обычного переключения задач
- Фронтенд остаётся ограниченным источником микроопераций
- Второй поток добавляет независимость, которую не всегда находит первый
- Порты исполнения определяют, насколько задачи дополняют друг друга
- Задержка одного задания и суммарный поток могут изменяться в разные стороны
- Разделённые буферы могут ограничить глубину одного потока
- Общий кэш создаёт и конкуренцию, и полезное переиспользование
- Больше запросов к памяти помогает лишь до насыщения
- Одинаковая загрузка CPU не означает одинаковую занятость железа
- Топология важнее соседства номеров в списке ОС
- Планировщик выбирает между использованием ядер и их соседей
- Активное ожидание тоже занимает общие ресурсы
- Энергия на выполненную работу отличается от мгновенной мощности
- Общие ресурсы имеют границы изоляции
- Как построить сравнение, которое отделяет механизмы
- Решение принимают по полезному результату и его ограничениям
- Официальные первичные источники
- Читайте также
Программный поток, аппаратный контекст и физическое ядро
Программный поток — объект, который планирует ОС: у него есть состояние исполнения, стек, приоритет и другие свойства. Логический процессор — аппаратная цель, на которой этот поток может исполняться. Физическое ядро содержит вычислительную организацию, обеспечивающую исполнение команд. Эти три сущности не совпадают по числу: тысячи программных потоков могут по очереди обслуживаться небольшим набором логических процессоров.
SMT, simultaneous multithreading, позволяет одному ядру поддерживать несколько активных аппаратных контекстов. Каждый контекст выглядит для ОС как отдельный логический процессор, но не получает отдельную полную копию всего ядра. В дальнейшем рассматриваем преимущественно два контекста на ядро. Это распространённый вариант, а не определение SMT: существуют другие количества и другие способы организации аппаратной многопоточности.
Важное практическое следствие: число целей планирования нельзя напрямую умножать на паспортную скорость одного физического ядра. Программа может получить больше независимых потоков команд, но они обращаются к частично общему набору устройств. Чтобы оценить возможности, нужна карта соответствия логических процессоров физическим ядрам и информация о нагрузке. Одного общего числа в диспетчере задач недостаточно.
Раздельное архитектурное состояние не означает два независимых конвейера
Аппаратные контексты должны сохранять различимые архитектурные состояния: видимые программе регистры, положение в потоке команд и необходимые управляющие сведения. Иначе два независимо исполняемых программных потока просто перезаписывали бы состояние друг друга. При этом физические структуры, в которых реализованы регистры после переименования, и внутренние правила их распределения зависят от конструкции CPU.
Ресурсы обычно удобно разделять на реплицированные, выделяемые по долям и совместно используемые. Реплицированная информация существует отдельно для каждого контекста. Разделяемая по долям очередь даёт участникам предусмотренный запас позиций. Конкурентно общий блок обслуживает готовые операции разных потоков согласно своим возможностям. Эти категории описывают разные механизмы, поэтому фраза «всё делится ровно пополам» неверна.
В Optimization Reference Manual Intel, Volume 2 приведены разные политики для конкретных поколений. Например, описание Nehalem различает реплицированное состояние, статически распределённые буферы и конкурентно используемые структуры. Это полезный архитектурный пример, но его список нельзя объявить точной внутренней схемой любого современного ядра Intel или AMD.
SMT отличается от обычного переключения задач
При обычном распределении времени ОС один программный поток сменяет другой на логическом процессоре. Переключение сохраняет и восстанавливает необходимое состояние, а планировщик решает, кто получит следующий интервал. SMT действует на другом уровне: несколько уже активных аппаратных контекстов способны предоставлять операции общей микроархитектуре без отдельного вызова планировщика ОС после каждой команды.
В некоторый такт ядро может продвинуть операции одного потока, другого или обоих, если устройство это допускает и нужные операции готовы. Не следует понимать слово simultaneous как обязательное исполнение одной инструкции каждого потока в каждом такте. Разные стадии конвейера имеют собственные правила выбора, а зависимости и доступность блоков меняются во времени. Полезен именно дополнительный выбор готовой работы.
Поэтому сравнение с чередованием одинаковых коротких квантов объясняет SMT плохо. Второй контекст может использовать свободную возможность раньше, чем ОС вообще заметила бы ожидание первого. С другой стороны, оба контекста продолжают зависеть от одного физического ядра. Когда оба требуют один и тот же насыщенный ресурс, аппаратная близость не создаёт дополнительную пропускную способность этого ресурса.
Фронтенд остаётся ограниченным источником микроопераций
Перед исполнением ядру нужно получить команды, предсказать направление переходов, декодировать инструкции либо воспользоваться подходящим кэшем подготовленного представления. Два потока могут иметь разные участки кода и разные истории ветвлений. Дополнительный контекст не означает удвоения полосы выборки, декодеров и всех связанных кэшей. Суммарная подача работы ограничивается физической организацией фронтенда.
Если первый поток постоянно упирается в зависимость дальнейшего исполнения, другой может использовать часть доступной подачи. Если оба требуют большого объёма разного кода, они способны конкурировать за соответствующие структуры. Точный эффект зависит от алгоритмов выбора и распределения. Из одинакового числа инструкций в двух программах нельзя вывести одинаковую нагрузку на фронтенд: кодирование, переходы и внутренние микрооперации различаются.
Даже у близких поколений политики меняются. В описании Haswell руководство Intel отдельно объясняет выбор между активными логическими процессорами и использование декодеров, когда сосед неактивен. Поэтому график из учебной схемы ниже показывает причинный механизм разделения, а не фиксированное расписание реального CPU. Нельзя по нему предсказывать задержку конкретной последовательности команд.
Второй поток добавляет независимость, которую не всегда находит первый
Исполнение вне очереди ищет готовые операции внутри доступного окна одного потока. Но длинная цепочка зависимостей ограничивает этот поиск: следующая операция может требовать результат предыдущей. Загрузка по неизвестному адресу или плохо предсказанный переход также затрудняют получение полезной работы. Увеличение ширины исполнительных блоков само по себе не создаёт отсутствующую независимость.
SMT добавляет операции другого архитектурного контекста, которые способны не зависеть от первой цепочки. Это ещё один источник параллелизма, отличный от расширения окна или векторизации команды. Если первый поток ждёт данные, второй иногда использует часть освободившихся возможностей. Но ожидание не делает все структуры пустыми: незавершённые запросы, занятые позиции очередей и следы в кэшах могут сохраняться.
Поэтому выражение «SMT бесплатно работает в простоях» слишком сильное. Чтобы добраться до свободного исполнительного блока, второму потоку нужны собственные команды, записи очередей и данные. Его работа также влияет на питание и температуру. Правильнее говорить о повышении использования существующих ресурсов в подходящих условиях, сохраняя цену организации и возможную помеху первому потоку.
Порты исполнения определяют, насколько задачи дополняют друг друга
Две операции, требующие разных блоков, потенциально могут продвигаться параллельно. Если обе обслуживаются одним узким исполнительным устройством, они конкурируют за его пропускную способность. Название инструкции не всегда однозначно определяет этот путь: одна команда может разбиваться на несколько микроопераций, а разные команды использовать общие части. Для точного анализа нужны данные конкретной микроархитектуры.
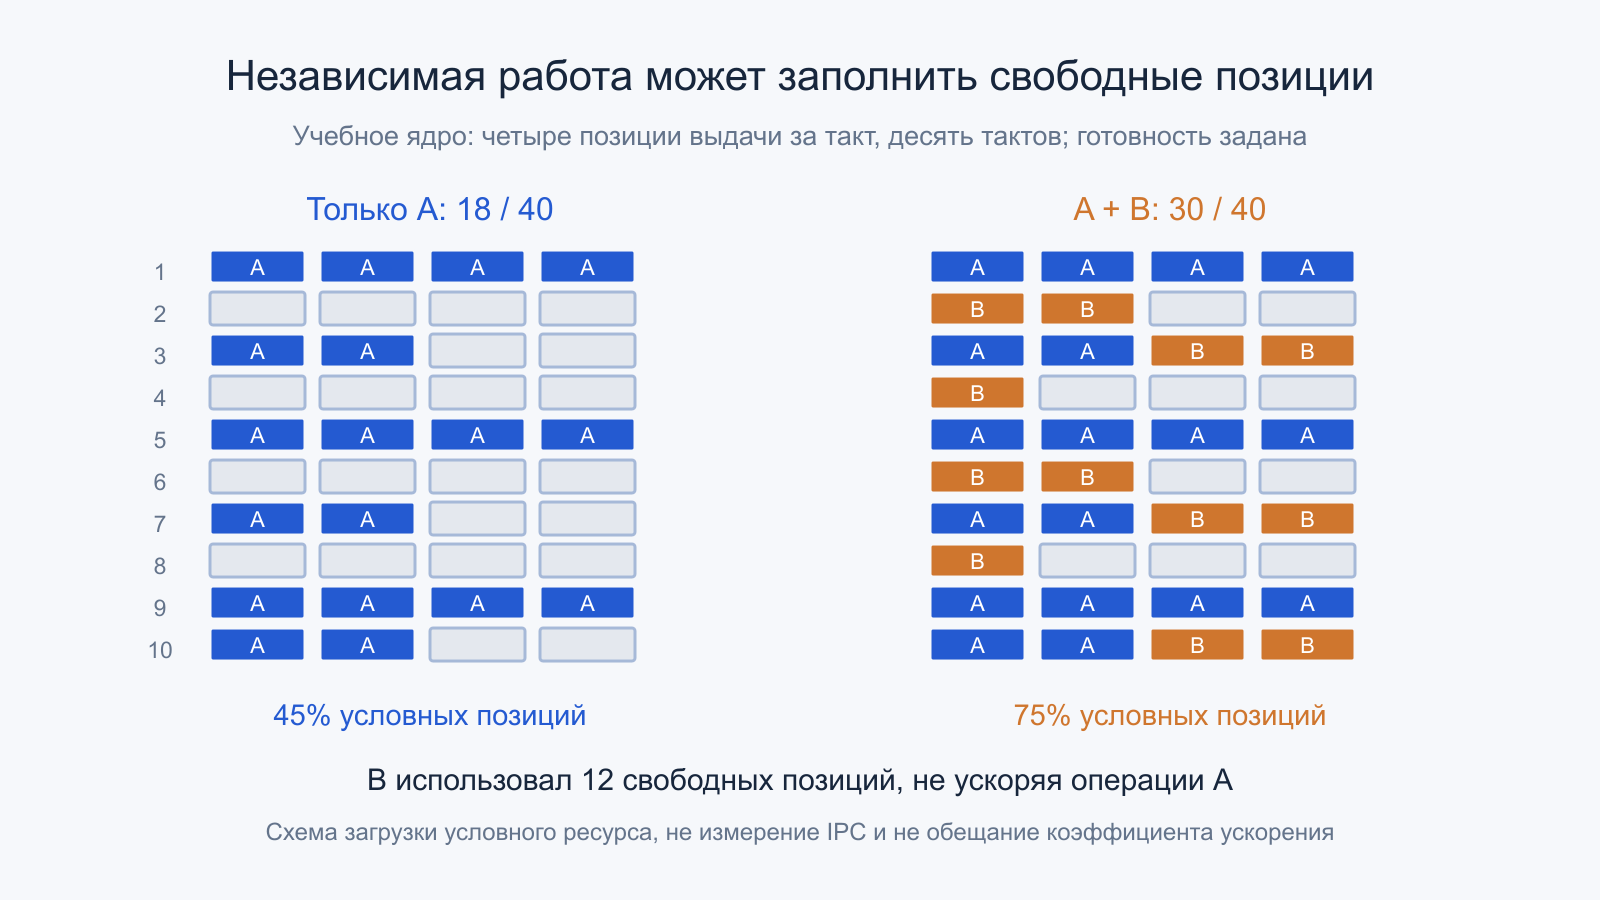
Представим условное ядро с четырьмя позициями выдачи за такт и десятью рассматриваемыми тактами. Первый поток занял 18 из 40 возможных позиций. Допустим, независимый второй поток добавил 12 операций в подходящие свободные позиции, не вытесняя первые. Тогда суммарно заняты 30 из 40, то есть 75 процентов вместо 45. Это заданный благоприятный сценарий, а не измеренный коэффициент SMT.
Он не доказывает ускорение первого потока: количество его операций осталось 18. Также нельзя напрямую сравнивать число разнородных микроопераций с полезной работой приложения. Схема показывает только увеличение использования некоторой условной полосы. В настоящем эксперименте проверяют время одинакового результата, а не объявляют каждый занятый слот одинаково полезным.
Задержка одного задания и суммарный поток могут изменяться в разные стороны
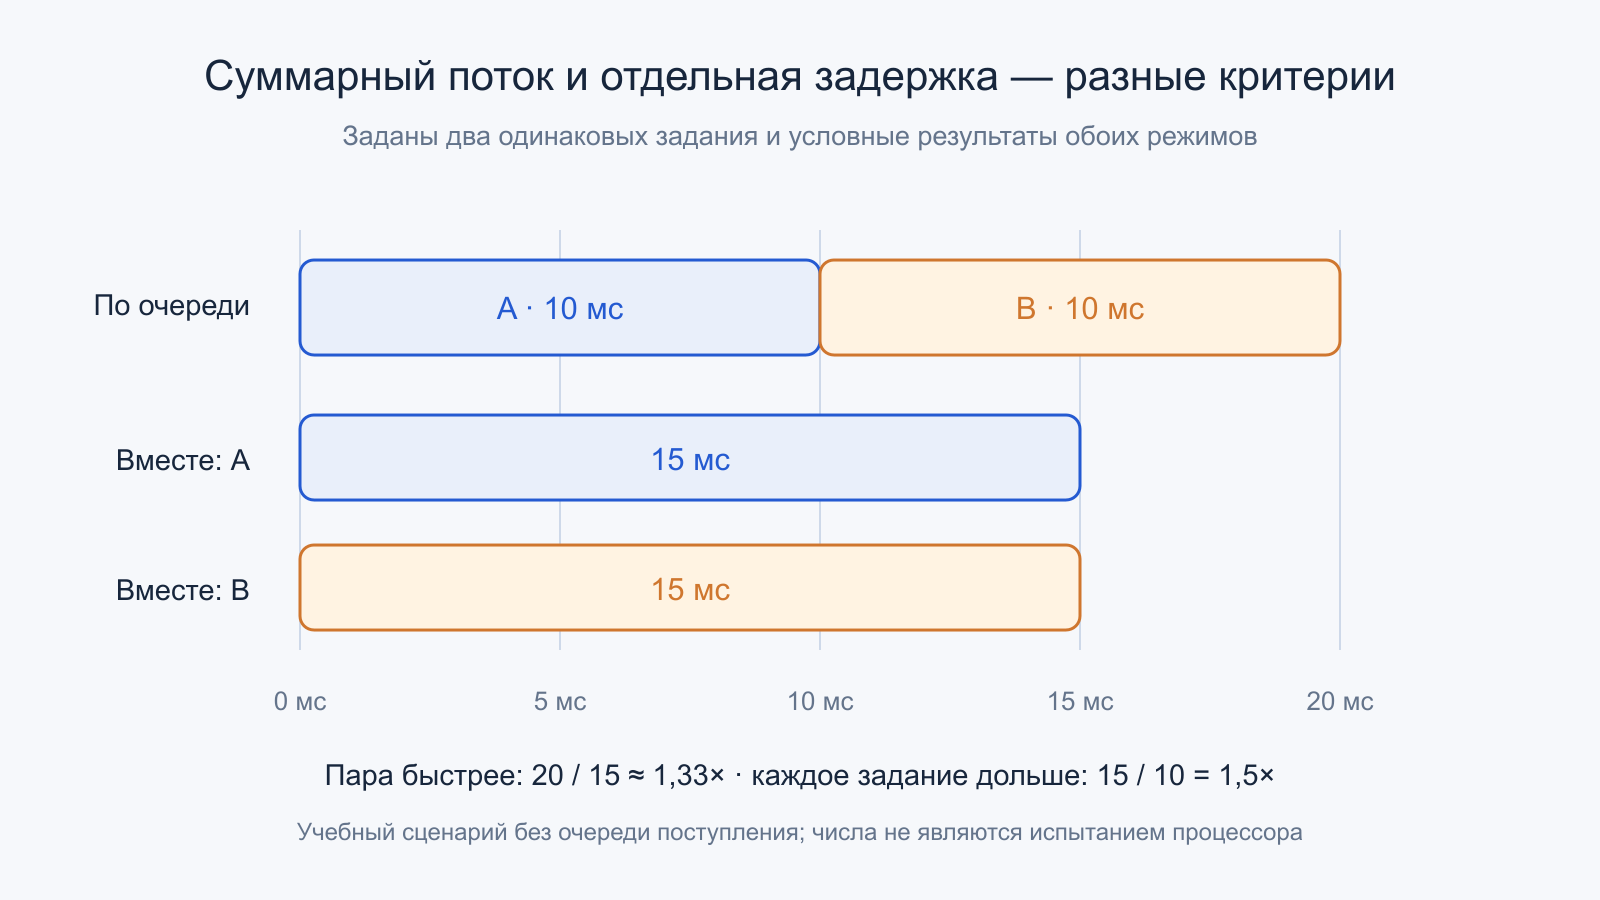
Зададим два одинаковых независимых задания. По одному на ядре каждое занимает 10 мс, поэтому последовательная обработка пары требует 20 мс. В другом условном режиме оба запускаются на соседних SMT-контекстах и заканчиваются через 15 мс. Пара выполнена в 20/15 ≈ 1,33 раза быстрее, но каждое задание обслуживалось в полтора раза дольше, чем при выделенном ядре.
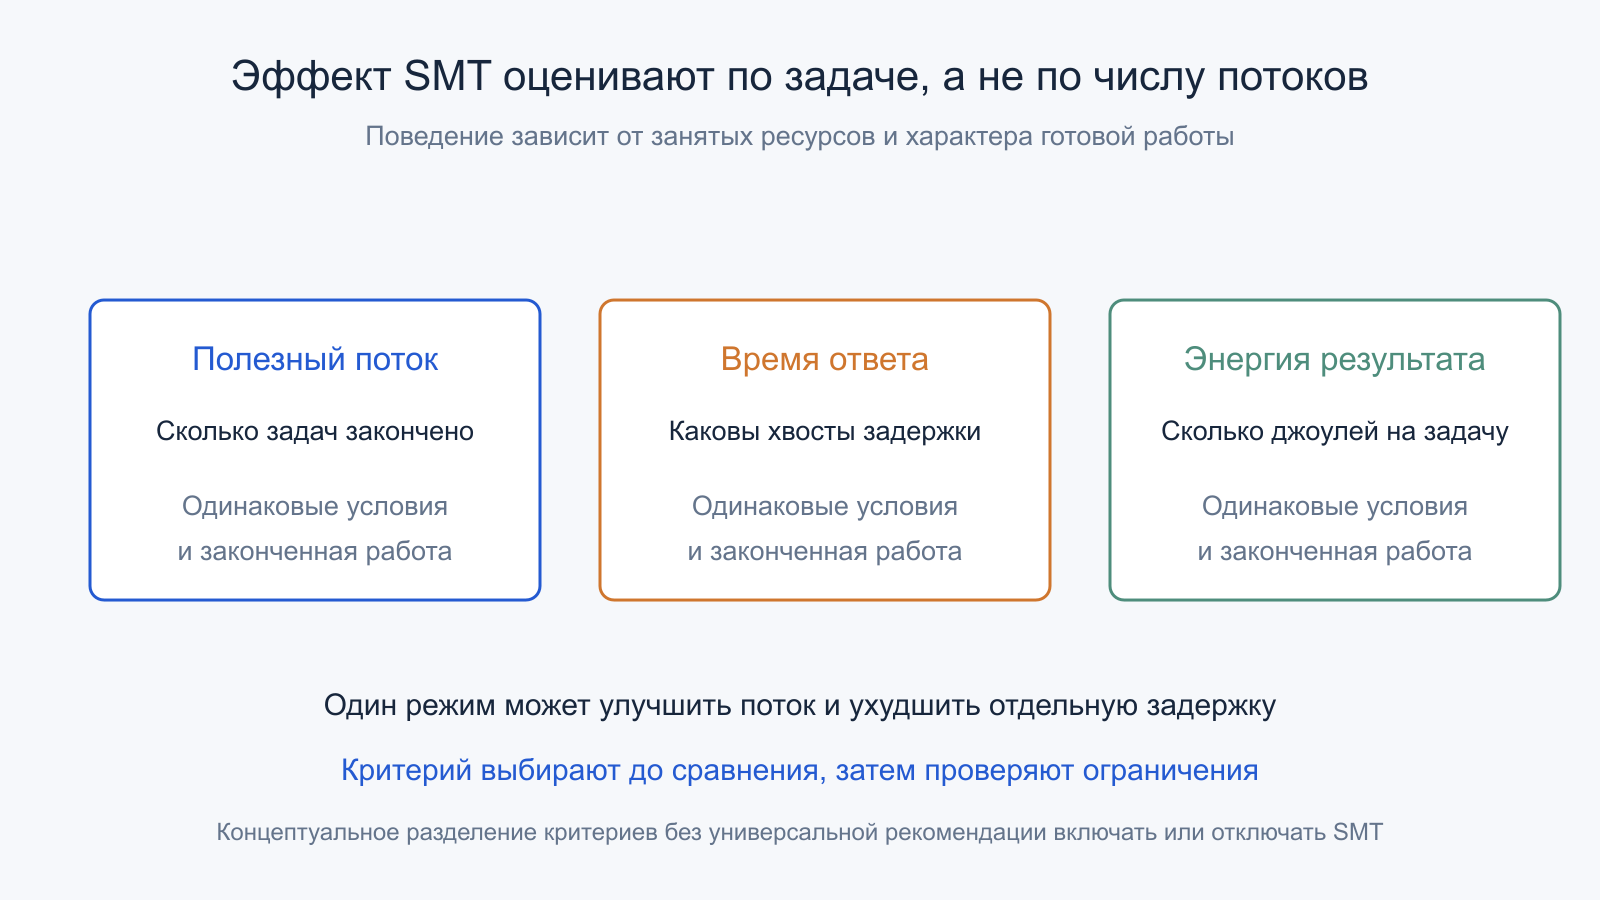
Это принципиальная разница между пропускной способностью и временем обслуживания отдельного запроса. Система пакетной обработки может предпочесть больше законченных заданий за интервал. Интерактивной системе иногда важнее задержка одного запроса или редкие длинные паузы. Одно значение «SMT даёт плюс 33 процента» скрывает вторую половину картины и не отвечает на оба требования.
В реальном сервере добавляется ожидание в очереди. Более высокая суммарная пропускная способность при большой нагрузке способна уменьшить очередь, хотя чистое время исполнения запроса выросло. В другом режиме конкуренция увеличивает хвост задержек. Поэтому сравнивают одинаковую интенсивность поступления, количество законченных задач и распределение времени ответа. Учебные 10 и 15 мс не заменяют эту зависимость.
Разделённые буферы могут ограничить глубину одного потока
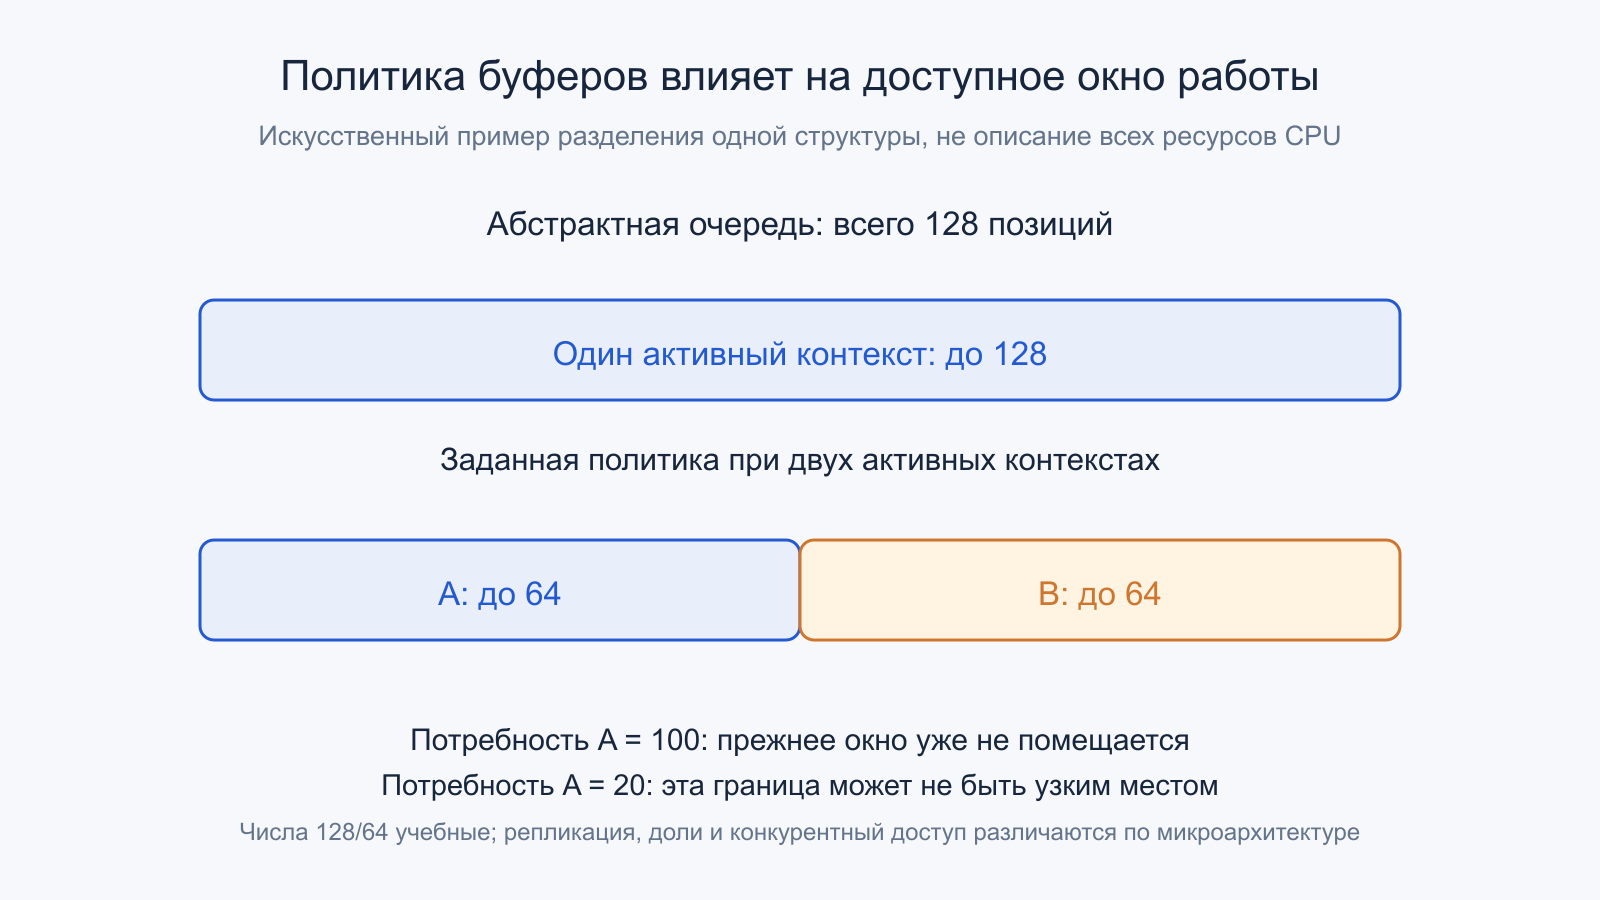
Позиции для незавершённых операций, загрузок и записей конечны. В некоторых конструкциях часть ёмкости резервируется за каждым активным контекстом. Это помогает участникам сохранять возможность продвижения, но способно уменьшить доступное одному потоку окно по сравнению с режимом, когда сосед неактивен. Правило относится к определённой структуре; оно не означает уменьшение всех кэшей и регистров строго вдвое.
Для объяснения зададим абстрактную очередь на 128 позиций. В однопоточном режиме доступны все 128, при двух активных контекстах каждому выделено 64. Поток, который полезно удерживал 100 незавершённых операций, теперь не сможет сохранить прежнее окно только в этой очереди. Но если ему обычно нужны 20 позиций, такое разделение само по себе не обязано стать главным ограничением.
Это также объясняет различие между включённой возможностью SMT и реально активным соседом. Политика может зависеть от аппаратного состояния контекстов и правил реализации. Нельзя считать, что один установленный переключатель всегда отнимает ровно половину каждой структуры у единственного работающего потока. И нельзя переносить наш пример 128/64 на паспорт процессора: числа выбраны для механизма, а не взяты из спецификации.
Общий кэш создаёт и конкуренцию, и полезное переиспользование
Соседние аппаратные потоки часто разделяют часть кэшевой иерархии физического ядра. Если оба работают с разными горячими областями, общий рабочий набор растёт и может вытеснять нужные строки. При этом не обязано существовать false sharing: конкуренция за ёмкость возникает и для полностью независимых адресов без согласования записей между разными ядрами. Эти механизмы следует различать.
Условный кэш вместимостью 96 КиБ не удержит одновременно две непересекающиеся горячие области по 64 КиБ, если весь их объём нужен в рассматриваемом интервале. Если же у каждой задачи есть общие 32 КиБ по тем же физическим адресам и собственные 32 КиБ, объединение составляет 96 КиБ. В идеализированной оценке ёмкости такая структура уже помещается. Ассоциативность и прочие потребители здесь намеренно исключены.
Одинаковое содержимое по разным адресам не становится одной строкой только потому, что байты совпадают. Нужны реальные условия совместного использования памяти. Кроме того, близость кэша не отменяет правил синхронизации программных потоков. SMT не исправляет гонки данных и не является основанием убрать корректные атомарные операции или замки из уже работающего алгоритма.
Больше запросов к памяти помогает лишь до насыщения
Второй поток способен добавить независимые запросы, пока первый ждёт свои. При недостаточном параллелизме обращений это иногда лучше использует существующий контроллер памяти и каналы. Но если они уже насыщены, SMT не создаёт новые каналы DRAM. Тогда дополнительные потоки делят прежний поток данных, увеличивают очередь и могут ухудшать задержку каждого обращения.
Пусть весь рассматриваемый путь устойчиво отдаёт условные 60 ГБ/с, а на один полезный элемент требуется 16 байт внешнего обмена. Идеальная верхняя граница равна 3,75 миллиарда элементов в секунду до прочих расходов. Удвоение числа аппаратных контекстов не изменяет это деление. Если реальный трафик выше из-за записей, вытеснений или повторного чтения, полезный предел окажется ниже.
При анализе отделяют задержку отдельного запроса от суммарной полосы и от количества одновременных обращений. Небольшой рабочий набор в локальном кэше и большой последовательный поток из DRAM способны реагировать на SMT по-разному. Поэтому универсальная рекомендация «память медленная — добавьте потоки» пропускает ключевой вопрос: имеется ли ещё неиспользованный ресурс для новых запросов.
Одинаковая загрузка CPU не означает одинаковую занятость железа
Показатель загрузки логического процессора обычно связан с учётом времени, а не с долей одновременно занятых арифметических устройств. Поток может считаться выполняющимся, пока его команды ждут данные. Два занятых логических процессора поэтому не доказывают удвоение полезной работы физического ядра. Значение зависит также от определения конкретного средства наблюдения.
IPC, число завершённых инструкций за такт, требует ясного знаменателя. Показатель отдельного потока и суммарный показатель ядра отвечают на разные вопросы. Нельзя складывать проценты из разных нормировок или сравнивать инструкции разных программ как равный результат. Один векторный оператор и несколько скалярных команд способны выполнять различный объём полезных вычислений при похожем числе завершений.
Аппаратные события могут помочь увидеть давление на фронтенд, исполнительные ресурсы, кэш или память. Но доступность событий, их область учёта и ограничения совместного измерения определяются CPU и инструментом. Полезно сначала проверить, считаются ли оба контекста вместе или только выбранный поток. Иначе изменение формата отчёта легко принять за изменение производительности.
Топология важнее соседства номеров в списке ОС
Два соседних номера CPU в интерфейсе не обязаны быть SMT-соседями. Нумерация зависит от прошивки, ОС, доступного состава и представления топологии. Документация Linux описывает отдельные идентификаторы и маски для уровней этой структуры. Правильная привязка строится по этим отношениям, а не по универсальному правилу «все чётные номера — физические ядра».
В Windows GetLogicalProcessorInformationEx предоставляет сведения об отношениях логических процессоров, ядрах и других объектах. Возможности API и организация больших систем имеют собственные детали. Важно само разделение: число видимых процессоров, группировка по ядрам и границы общих кэшей — разные сведения, которые следует получать предусмотренным интерфейсом.
Гибридная система добавляет ещё одно ограничение. Если в условном CPU четыре ядра имеют по два контекста, а восемь других — по одному, получаем 12 физических ядер и 16 логических процессоров. Отношение не равно двум для всего устройства. При этом ядра могут различаться по доступным ресурсам и скорости. Число потоков без состава уже не описывает даже одинаковые исполнительные возможности.
Планировщик выбирает между использованием ядер и их соседей
Для небольшой нагрузки может быть выгодно сначала распределить работу по отдельным физическим ядрам, предоставляя каждой задаче больше локальных ресурсов. В другом случае близость данных или требования энергопотребления изменяют предпочтение. Планировщик учитывает доступные сведения, загрузку и политику системы; приложение также способно ограничить допустимое размещение, иногда неудачно.
Документация доменов планирования Linux показывает иерархическую организацию групп балансировки. Это не один плоский список взаимозаменяемых процессоров. Но и принудительная привязка не является автоматической оптимизацией: она может оставить свободные ядра неиспользованными, усилить дисбаланс или ухудшить доступ к памяти. Результат проверяют на законченной задаче.
Если приложение создаёт по рабочему потоку на каждый логический процессор, это лишь начальное предположение. Нужное количество определяется также ожиданием ввода-вывода, размером рабочих областей и внутренними барьерами. Иногда больше программных потоков полезно даже без SMT, потому что часть спит; иногда меньше видимых процессоров лучше для плотной вычислительной нагрузки. Эти случаи нельзя объяснять одной аппаратной цифрой.
Активное ожидание тоже занимает общие ресурсы
Поток, который проверяет условие в коротком цикле, может выглядеть логически ожидающим, но продолжать выполнять команды. Такой цикл использует выборку, обращения к памяти и другие части ядра. Если рядом работает владелец нужного ресурса, лишняя активность ожидания способна конкурировать с полезным продвижением. Поэтому слово «ждёт» в алгоритме не обязательно означает неактивное аппаратное состояние или свободный логический процессор.
Архитектуры предоставляют специальные инструкции и рекомендации для подобных циклов. Например, смысл x86 PAUSE связан с подсказкой для ожидания; его нельзя приравнивать к универсальной команде сна ОС или обещанию определённого числа наносекунд. Реальная реализация и эффект зависят от поколения. Прикладные программы обычно пользуются готовыми примитивами синхронизации, которые учитывают короткое ожидание и возможность передать дальнейшую работу планировщику.
Слишком ранний переход к сну тоже имеет цену: пробуждение и распределение процессорного времени могут занять дольше короткого ожидаемого события. Выбор зависит от длительности критической секции, степени конкуренции и требований к задержке. Для SMT важно не искать одну магическую паузу, а понимать, какую работу выполняет сосед и почему. Если оба потока постоянно проверяют общие управляющие данные, полезный результат может почти не расти при очень высокой загрузке CPU.
В эксперименте фиксируют политику ожидания библиотеки наряду с числом потоков. Изменение этой политики способно поменять и доступное аппаратное состояние, и распределение времени ОС. Это самостоятельный фактор, который нужно отделить от включения второго контекста. Сравнение остаётся осмысленным, когда сохраняет правильность взаимодействия и измеряет время завершения той же работы, а не только длительность искусственного пустого цикла.
Энергия на выполненную работу отличается от мгновенной мощности
Лучшее использование блоков способно увеличить мгновенное потребление ядра. Одновременно работа может закончиться раньше. Чтобы сравнить эффективность, нужна энергия одинакового результата в одинаковой измерительной границе. Мощность процессора, энергопотребление всей системы и расход из розетки — разные границы; смешивать их в одной пропорции нельзя.
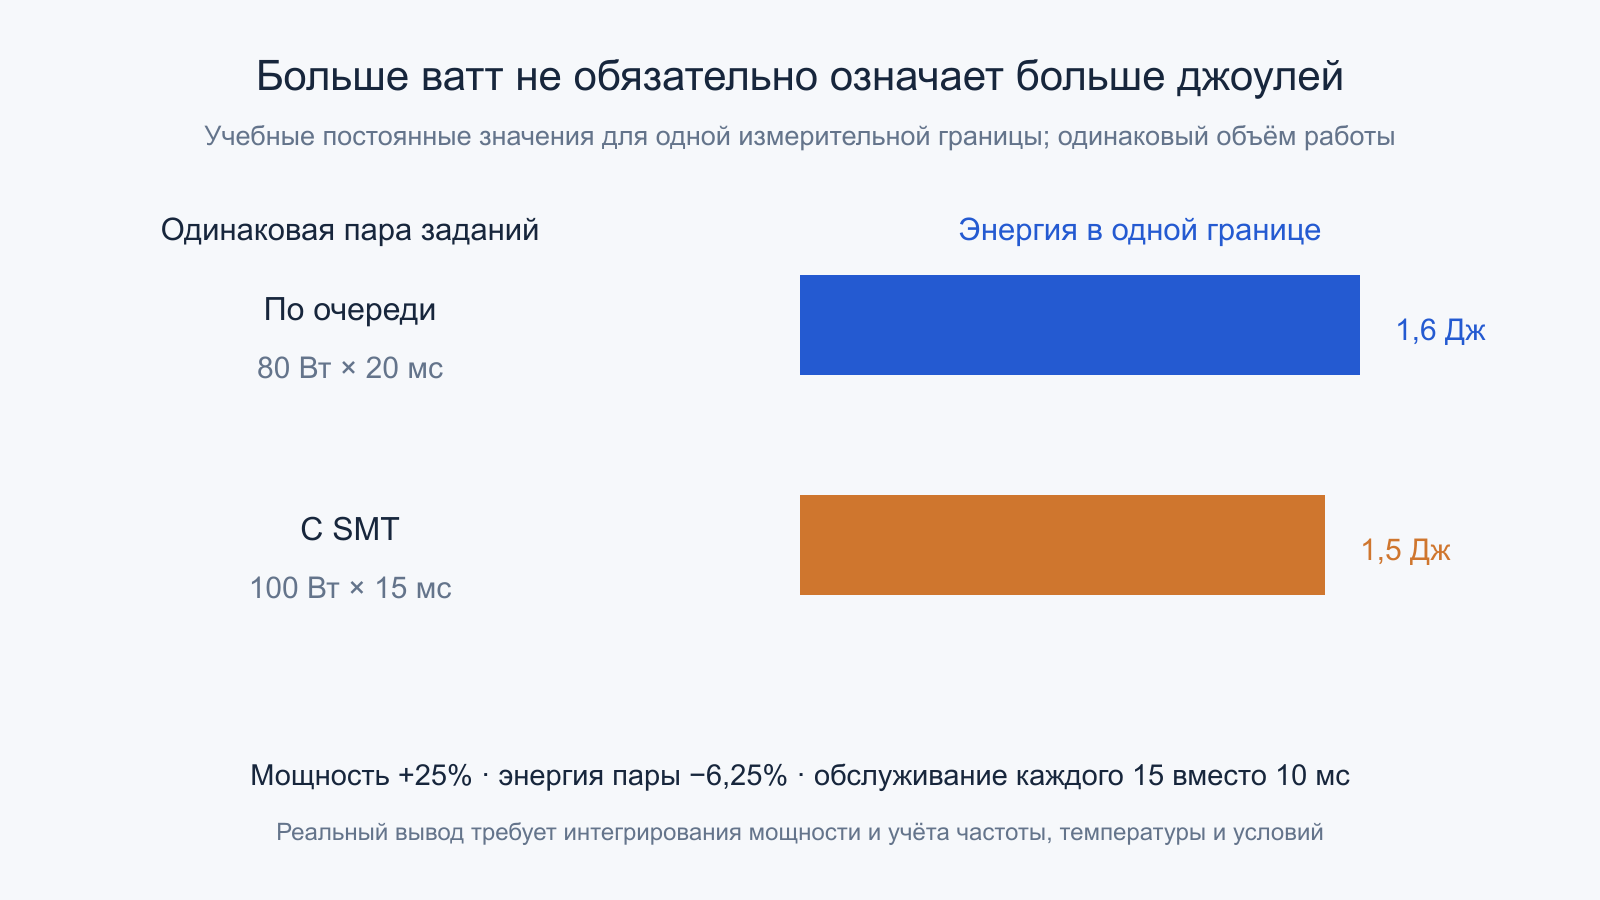
Вернёмся к условной паре заданий. Пусть последовательное исполнение требует 20 мс при постоянных 80 Вт, а совместное — 15 мс при 100 Вт. Тогда энергия составит 1,6 Дж и 1,5 Дж соответственно. Мощность выросла на 25 процентов, энергия пары уменьшилась на 6,25 процента, а отдельное обслуживание всё ещё длится 15 вместо 10 мс. Все три вывода относятся к заданной модели.
Реальный процессор меняет частоту и напряжение в пределах общих ограничений. Поэтому сравнение с SMT и без него может включать не только разделение конвейера, но и другой энергетический режим. Нужны длительность опыта, установившиеся условия и определения датчиков. Один короткий пик мощности не показывает энергию всей обработки, а более высокая частота не доказывает больше полезных результатов за секунду.
Общие ресурсы имеют границы изоляции
Разные аппаратные контексты сохраняют различимые архитектурные состояния, но разделение физических структур важно и для модели доверия. Нельзя считать SMT-соседей эквивалентом полностью независимых компьютеров только потому, что у каждого свой номер процессора. При оценке изоляции учитывают поддерживаемые механизмы CPU, обновления и политику размещения задач.
Linux Core Scheduling описывает совместное планирование доверенных групп и возможность вынужденного простоя соседа, когда подходящей задачи нет. Документ прямо ограничивает область защиты и отмечает дополнительные расходы. Поэтому такой механизм нельзя рекламировать как универсальное устранение всех побочных каналов или как гарантированное ускорение.
Для обычного анализа производительности достаточно зафиксировать действующую конфигурацию защиты и не менять её ради красивого результата без понимания требований системы. Два опыта с разными правилами изоляции измеряют разные условия. Если часть логических процессоров намеренно простаивает, это может быть следствием политики, а не неисправностью CPU. Производительность оценивается вместе с необходимой корректностью и моделью эксплуатации.
Как построить сравнение, которое отделяет механизмы
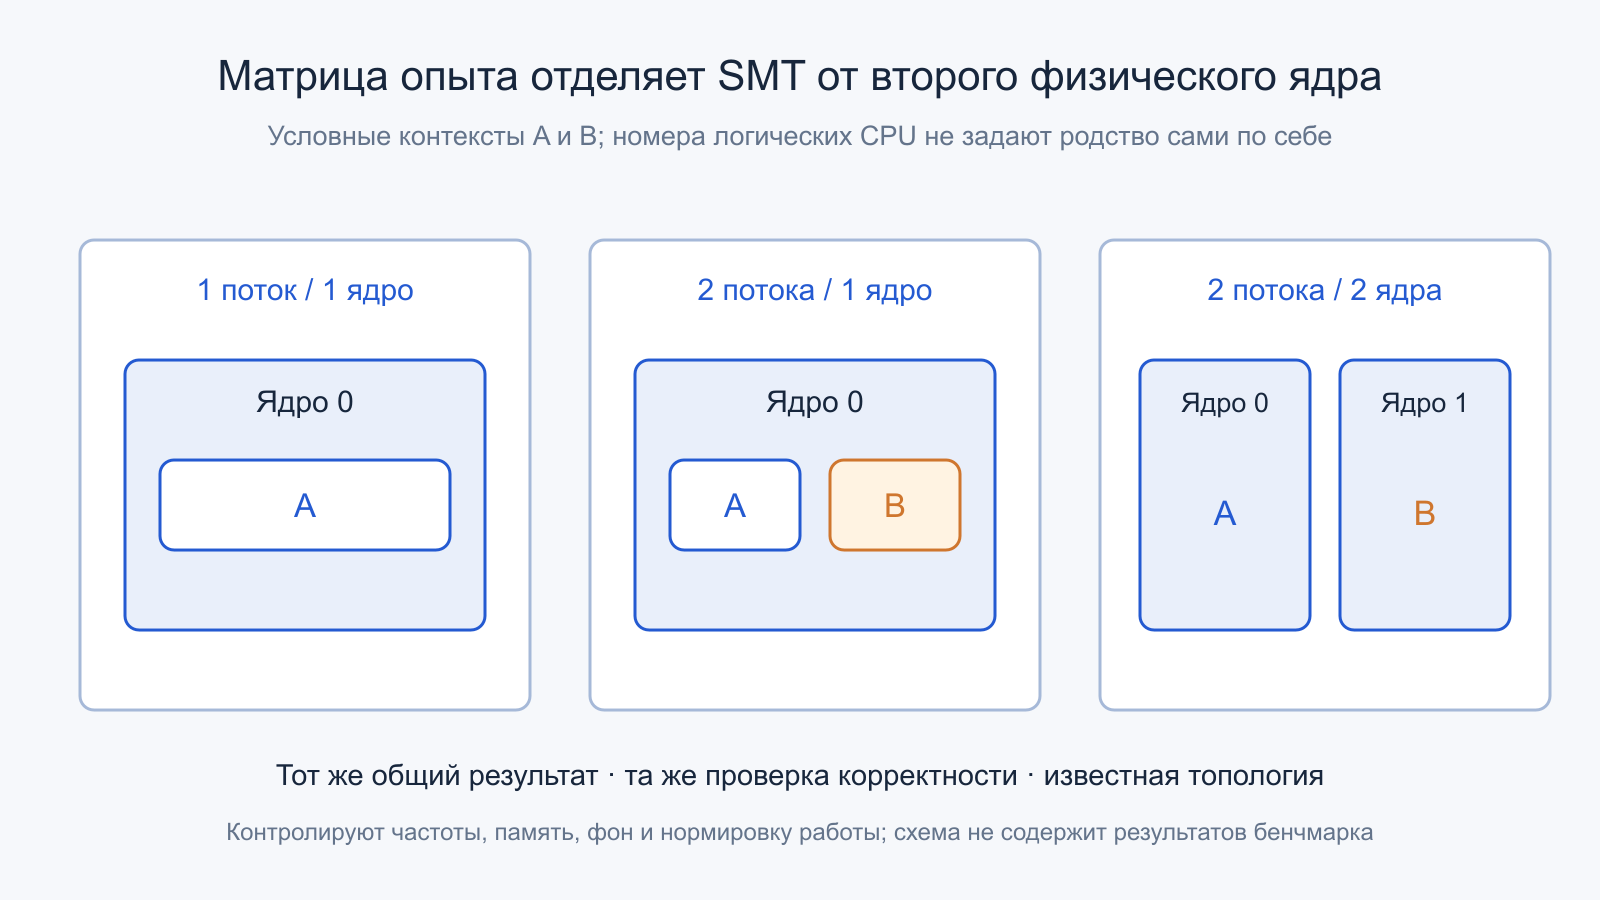
Полезная матрица включает один поток на одном ядре, два потока на двух контекстах одного ядра и те же два потока на двух физических ядрах. Далее проверяют заполнение физических ядер и добавление SMT-соседей. Количество выполненной работы и проверка результата сохраняются одинаковыми. Такая последовательность отделяет пользу второго физического ядра от использования дополнительного контекста первого.
Регистрируют время завершения, суммарный поток, распределение задержек, рабочий набор, частоты и выбранную энергетическую границу. Проверяют повторяемость, фоновые задачи и прогрев. Если сравниваются разные режимы запуска, нельзя приписывать всю разницу SMT: перестановка могла изменить NUMA-доступ, кэши, частоты или поведение самой библиотеки. Контролируемое изменение должно быть как можно уже.
Особенно важно сохранять объём работы при изменении числа потоков. Если каждый новый поток получает дополнительный набор операций, растёт не только параллелизм, но и задача. Такой тест может оценивать пропускную способность, однако время его завершения нельзя напрямую объявлять ускорением прежнего задания. В отчёте явно указывают, фиксирован общий объём или объём на исполнителя.
Решение принимают по полезному результату и его ограничениям
SMT наиболее понятен как способ предоставить физическому ядру больше независимой готовой работы. Он может повышать суммарную отдачу, когда один поток не заполняет доступные возможности, и мешать, когда сосед добавляет конкуренцию за уже насыщенные структуры. Оба эффекта являются нормальными свойствами организации ресурсов, а не противоречием рекламному числу потоков.
Intel Optimization Zone также связывает эффект Hyper-Threading с характером нагрузки и общими ресурсами. Но результат конкретного рецепта относится к его системе и задаче. Для своего компьютера полезнее сформулировать критерий: закончить пакет раньше, обслужить больше запросов, удержать допустимый хвост задержки или снизить энергию заданной работы.
После выбора сохраняют проверенную карту топологии и условия опыта. Если меняются процессор, библиотека, размер данных или распределение задач, старый вывод может перестать действовать. Практическая ценность понимания SMT в том, чтобы объяснить такую перемену: какие возможности освободились, какие стали общими и где возник новый предел. Число логических процессоров — начало разбора, а не готовая мера производительности.
Официальные первичные источники
- Intel — Optimization Reference Manual, Volume 2, August 2023: политики ресурсов описанных микроархитектур, включая Nehalem, Haswell и Knights Landing.
- Intel — Software Developer Manuals: архитектурная организация логических процессоров и сведения о топологии.
- Linux Kernel — How CPU topology info is exported via sysfs.
- Linux Kernel — Scheduler Domains.
- Linux Kernel — Core Scheduling: совместное планирование и его ограничения.
- Microsoft — GetLogicalProcessorInformationEx.
- Intel — Optimization Zone, common system configuration: эффект Hyper-Threading в контексте нагрузки.