Сетевая карта изнутри: MAC, PHY, DMA, очереди, RSS и разгрузка процессора
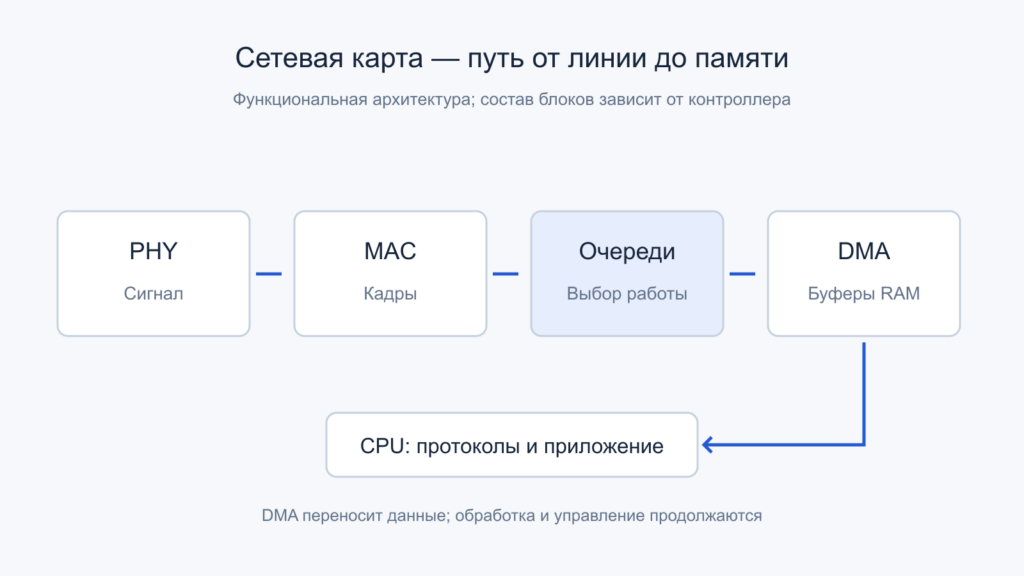
Функциональный путь сетевого адаптера: физический сигнал, кадры MAC, очереди и размещение данных DMA. Открыть иллюстрацию в полном размере.
Сетевая карта принимает электрический или оптический сигнал, превращает его в кадры, размещает данные в памяти и сообщает процессору о готовой работе. Обратный путь начинается с буфера программы и заканчивается передачей символов в линию. Между этими точками находятся очереди, таблицы адресов, механизмы DMA, обработка прерываний и разгрузка протокольных операций. Поэтому одинаковая скорость Ethernet не означает одинаковую нагрузку на CPU и задержку приложения.
Разберём архитектуру обычного сетевого адаптера компьютера. Для конкретных аппаратных примеров используется документация Intel I210, редакция 3.7 января 2021 года; это пример определённого контроллера, а не устройство всех современных карт. Программные механизмы поясняют документы Linux и Microsoft. Численные сценарии ниже учебные: они показывают зависимости, не заменяя измерений выбранной системы.
Содержание статьи
- PHY и MAC выполняют разные части работы
- Что происходит с принятым кадром
- DMA переносит данные, но не отменяет работу процессора
- Очереди дают параллелизм, а не дополнительные гигабиты линии
- RSS сохраняет связь потока с выбранной обработкой
- Почему прерывание не обязано приходить на каждый кадр
- Маленькие кадры создают большую нагрузку на обработку
- MTU, MSS и полезная скорость приложения
- Offload переносит работу и меняет видимую картину
- Большая очередь поглощает всплеск, но не постоянный избыток
- Как читать результаты без смешения уровней
- Проверочный список архитектуры адаптера
- Официальные первичные источники
- Читайте также
PHY и MAC выполняют разные части работы
PHY обслуживает физическое соединение: передаёт и принимает сигналы, восстанавливает необходимые временные отношения, выполняет предусмотренное кодирование и обработку физического канала. Для медного гигабитного Ethernet это сложный сигнальный тракт, а не простой переключатель логического нуля и единицы. Для оптики или другого поколения физический путь имеет другую реализацию.
MAC работает с кадрами Ethernet: адресами, форматом, контролем целостности и правилами передачи на своём уровне. Разделение функциональное: MAC и PHY могут находиться внутри одного корпуса либо соединяться через предусмотренный интерфейс. Например, семейство I210 включает варианты с интегрированным медным PHY и варианты использования другого физического подключения. Внешний разъём не раскрывает внутреннюю организацию.
Состояние link означает, что физические партнёры установили предусмотренный режим связи. Оно ещё не подтверждает правильного IP-адреса, маршрута, DNS или доступности приложения. И наоборот, низкая скорость копирования файла при устойчивом link не доказывает неисправность PHY. Между проводом и файлом остаются программный стек, память, накопитель и удалённая система.
Что происходит с принятым кадром
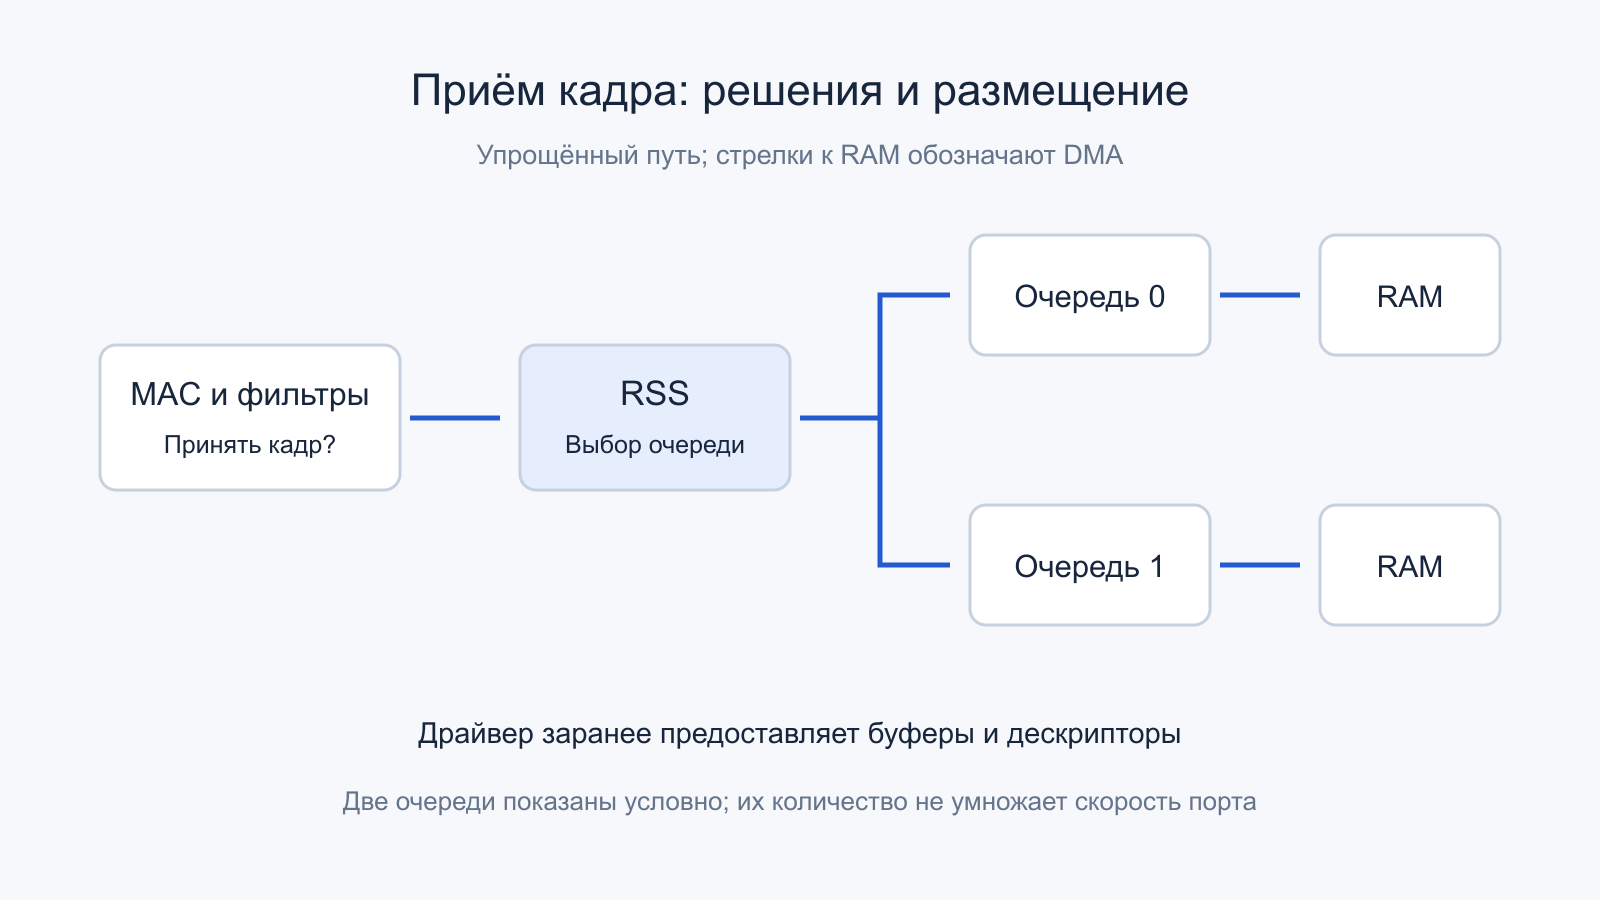
После физического приёма аппаратная логика разбирает кадр, проверяет предусмотренные признаки и решает, следует ли принимать его для хоста. Фильтрация может учитывать MAC-адрес, многоадресные группы, VLAN и другие поддерживаемые условия. Возможности и приоритеты фильтров зависят от контроллера. Нельзя предполагать одинаковую программируемость у встроенного гигабитного адаптера и серверного устройства.
Следующий важный выбор — очередь приёма. Она связывает аппаратный поток кадров с заранее подготовленными ресурсами памяти и дальнейшей обработкой. Ошибка формата кадра, отсутствие свободного буфера и отказ приложения прочитать уже доставленные данные относятся к разным местам. Их счётчики не обязаны увеличиваться одновременно.
Полезно различать и уровни единиц. Ethernet переносит кадры; IP — пакеты своего формата; TCP организует поток байтов через сегменты; приложение может считать завершённые сообщения или файлы. Один вызов чтения программы не обязан соответствовать одному кадру. Промежуточные объединения и разделения делают такое соответствие ещё менее прямым.
DMA переносит данные, но не отменяет работу процессора
ОС и драйвер заранее выделяют память и сообщают устройству, где находятся разрешённые буферы. Адаптер использует DMA, чтобы читать или записывать данные без отдельной процессорной инструкции копирования каждого слова. Приёмник может поместить содержимое кадра в подготовленную область и обновить информацию о завершении. CPU затем обрабатывает результат.
Важная структура — дескриптор: небольшая запись с адресом, длиной и управляющими либо статусными полями. Дескрипторы часто организованы в кольца. Это не обязательно само содержимое пакета: запись описывает, где данные находятся и что с ними сделать. Точные форматы, число колец и правила их обслуживания нужно брать из документации контроллера.
Передающая сторона работает похожим образом: драйвер публикует подготовленное описание буфера, устройство читает данные, выполняет нужные аппаратные действия и сообщает о завершении. Один пакет может занимать несколько фрагментов памяти; соответствующая поддержка позволяет избежать предварительного сведения всего содержимого в один сплошной буфер. Но число доступных фрагментов и затраты остаются ограниченными.
DMA не означает произвольный доступ к памяти любого процесса. Драйвер согласует отображения и владение буферами; IOMMU при поддерживаемой конфигурации участвует в преобразовании и ограничении адресов устройства. Адрес DMA не обязательно равен виртуальному адресу приложения. Правильный порядок публикации данных и получения завершения также является частью протокола между CPU и адаптером.
Завершение передачи не равно подтверждению удалённой программы
У сообщения есть несколько разных «готово». Приложение передало данные сокету; стек принял их в очередь; адаптер закончил пользоваться буфером; кадр отправлен; удалённый TCP подтвердил байты; удалённая программа обработала запрос. Эти события не обязаны совпадать во времени. Точный смысл аппаратного статуса завершения определяется форматом дескриптора и режимом контроллера.
Поэтому возврат передающего буфера драйверу нельзя считать доказательством сохранения файла на другой машине. Устройство подтверждает свой участок ответственности, а не семантику удалённого сервиса. Даже транспортное подтверждение относится к работе транспортного уровня: подтверждение устойчивого хранения или транзакции должно быть предусмотрено самим протоколом приложения.
Это различие важно и для скорости. Короткая программа может быстро заполнить локальную очередь и завершить измерение раньше реальной передачи всех байтов. Для корректного опыта заранее определяют конечное событие и учитывают оставшуюся работу. Иначе измеряется скорость постановки запросов в память, а не достигнутый поток между двумя приложениями.
Почему важна передача владения
Если CPU изменит буфер, пока устройство ещё читает его для отправки, результат зависит от момента обмена и может оказаться неверным. Если устройство начнёт писать в уже возвращённую приложению память, будет нарушена изоляция жизненного цикла данных. Поэтому состояния «свободен», «передан устройству» и «завершён» имеют конкретный смысл. Кольцо — средство учёта этих переходов, а не бесконечный склад пакетов.
В учебной конфигурации подготовлены 1024 приёмных буфера по 2048 байт. Только их полезное пространство занимает 1024 × 2048 = 2 МиБ, без дескрипторов и служебных структур. При полном заполнении кольцо не увеличивается само. Драйвер должен успевать возвращать обработанные буферы или предоставлять новые, иначе появляется отдельная причина потерь.
Шина хоста при этом переносит не только полезное содержимое. Устройство читает описания работы, записывает статусы, а система обслуживает метаданные и кэши. Один гигабайт данных приложения не задаёт ровно один гигабайт суммарного обмена памяти. При мелких пакетах относительная цена служебных действий растёт; объединение нескольких завершений помогает именно этой части пути.
Zero-copy также означает устранение определённого копирования между выбранными слоями, а не отсутствие всех перемещений. Данные всё ещё должны пройти физический интерфейс и оказаться в подходящей памяти. Подготовка страниц, регистрация, владение буферами и синхронизация имеют цену. Поэтому такое название требует уточнения: между какими участниками исключена копия и какая работа осталась.
Очереди дают параллелизм, а не дополнительные гигабиты линии
Несколько очередей позволяют распределять подготовку и обработку между процессорными ресурсами. У I210 в указанной редакции описаны четыре очереди передачи и четыре очереди приёма. Это семейная характеристика данного устройства. Другие адаптеры имеют другое число очередей, правила отображения и ограничения при включении дополнительных функций.
Четыре очереди на одном порту 1 Гбит/с не превращают его в четыре независимых гигабитных порта. Они обслуживают общий физический поток. Выигрыш возникает там, где одна последовательная программная обработка не успевала принимать работу или неудачно взаимодействовала с кэшами. После устранения этого ограничения может проявиться собственно линия или другой участок системы.
Слишком много очередей тоже не гарантирует выгоду. Для них нужны кольца, векторы уведомлений, память и обслуживание. На небольшой нагрузке распределение способно добавить обмен между ядрами и ухудшить локальность. Оптимальное сочетание зависит от числа активных потоков, топологии CPU, драйвера и целей: суммарной скорости, задержки или экономии энергии.
RSS сохраняет связь потока с выбранной обработкой
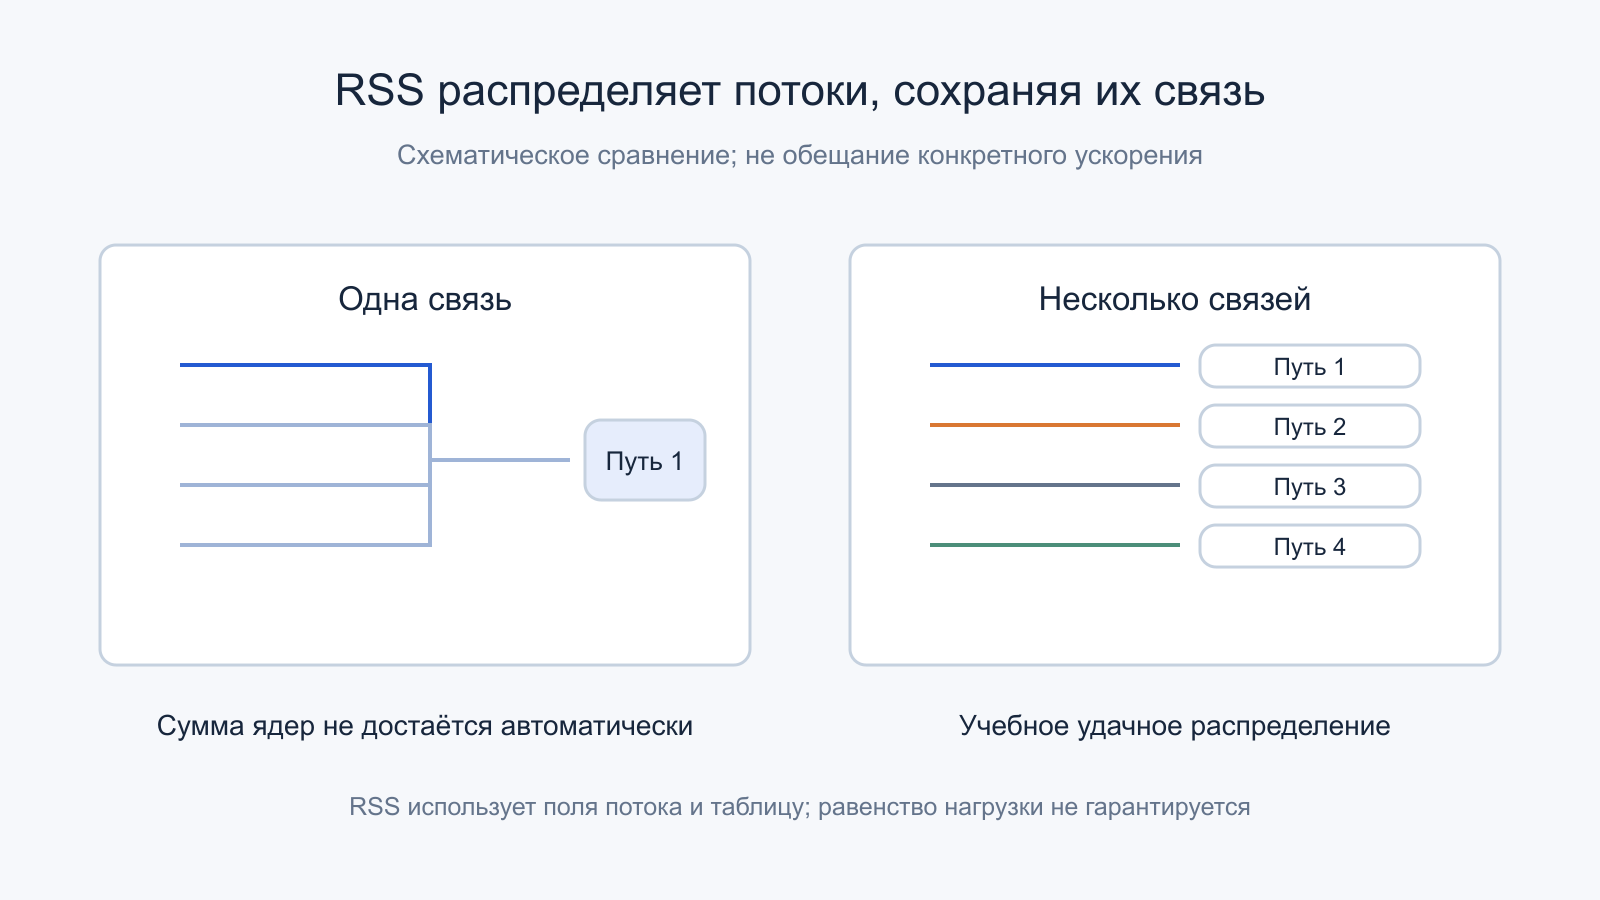
Receive Side Scaling распределяет принимаемый трафик по нескольким путям обработки. Типичная аппаратная схема вычисляет хеш определённых полей заголовков и использует таблицу перенаправления к очереди. Linux описывает, например, хеш IP-адресов и транспортных портов. Какие поля доступны для IPv4, IPv6, туннелей и других случаев, зависит от возможностей устройства и настройки.
Смысл распределения — использовать несколько CPU, сохраняя подходящий порядок обработки кадров одной связи. Поэтому обычное RSS не режет один TCP-поток на произвольные части ради равномерной загрузки всех ядер. Большой одиночный поток может по-прежнему ограничиваться одним путём обработки, хотя несколько независимых потоков загружают систему лучше. Это ожидаемое свойство, а не доказательство неработающего RSS.
Хеш также не обещает идеального равенства байтов. Два тяжёлых потока способны попасть в одну очередь, а десятки лёгких — в другую. Таблица может иметь много элементов, но реальная нагрузка определяется не числом записей, а распределением соединений и их объёмами. «Включено четыре очереди» и «нагрузка равномерна» — разные утверждения.
Учебный пример: одно ядро обслуживает не более 0,8 миллиона пакетов в секунду данного типа, а входящий поток даёт 2 миллиона. Четыре одинаковых независимых пути имели бы суммарный потолок 3,2 миллиона, если бы работа распределилась достаточно удачно и не возник общий предел. Но один поток, закреплённый за одним путём, всё равно не получает этот суммарный ресурс автоматически.
Аппаратное RSS и программное распределение различаются
Linux отдельно описывает RPS, RFS и XPS. Эти механизмы управляют распределением программной обработки и передачей с учётом своих задач; они не являются другими названиями аппаратного RSS. Перенос дальнейшей работы на другое ядро может помочь балансу, но создаёт собственные затраты. Разбираться нужно по фактической цепочке очереди, уведомления и исполнения.
При NUMA-топологии добавляется расположение памяти относительно процессора и PCIe-устройства. Буфер, прерывание и приложение могут обслуживаться разными узлами. Дополнительный межузловой обмен расходует ресурсы, даже если физическая сеть работает без ошибок. Поэтому высокий процент одного ядра или задержка памяти не всегда устраняются простым увеличением числа очередей.
Почему прерывание не обязано приходить на каждый кадр
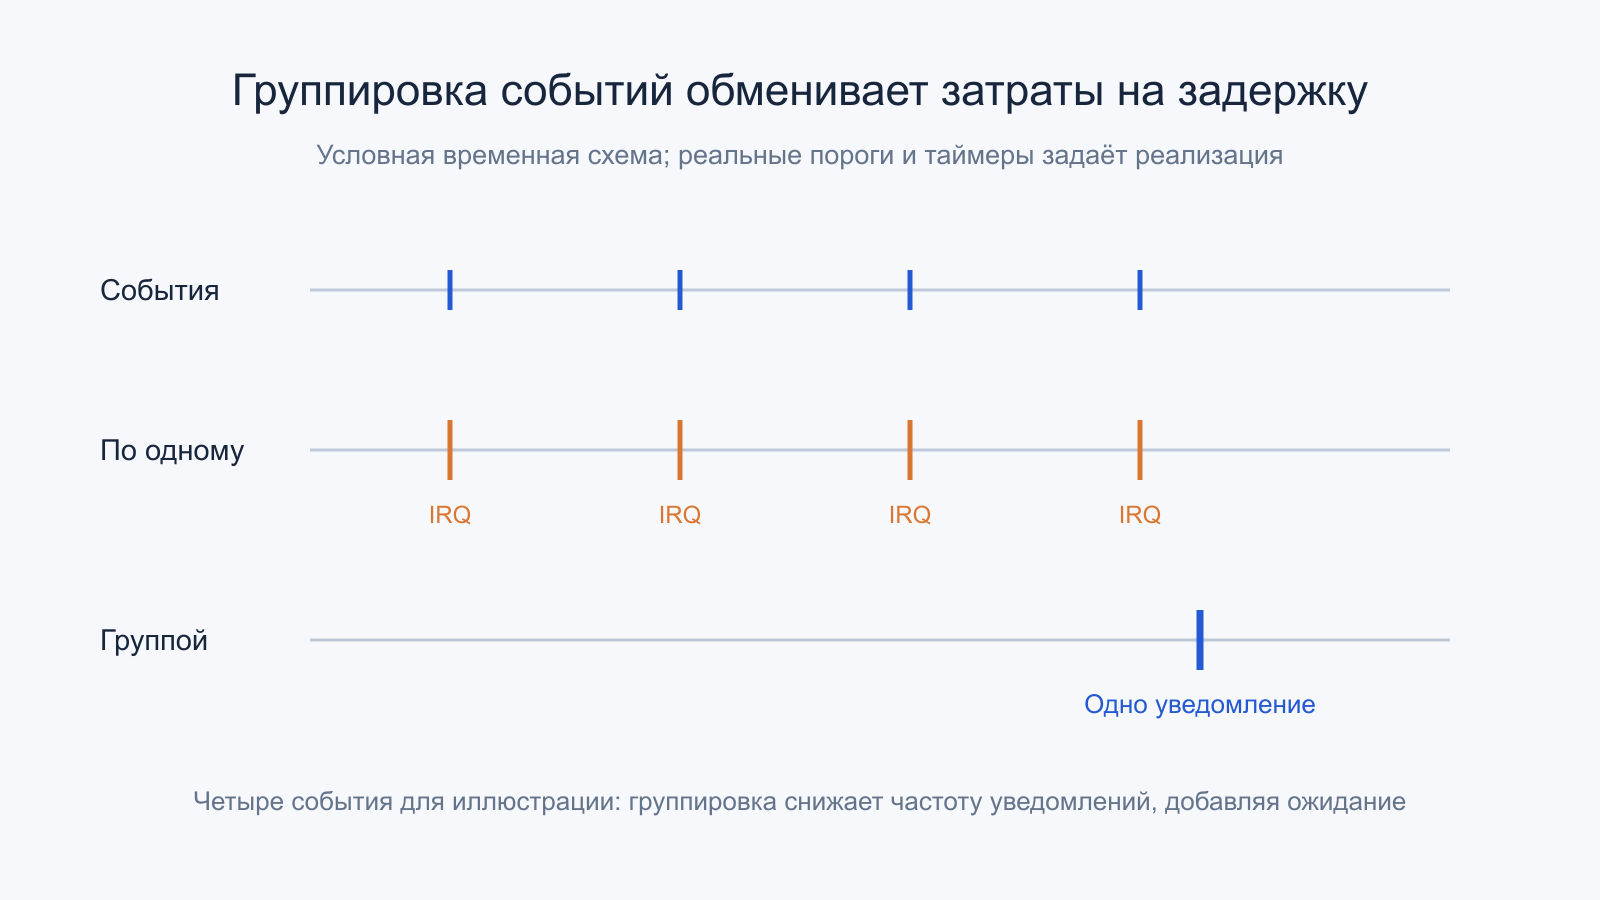
Уведомлять CPU о каждом маленьком кадре дорого. Interrupt moderation позволяет группировать события по поддерживаемым условиям: времени, количеству завершений или адаптивной политике. Процессор реже переключается на обслуживание устройства, но часть готовой работы может ждать уведомления. Это обмен между накладными расходами и задержкой, а не бесплатное ускорение.
В Linux NAPI организует обработку сетевых событий с опросом подготовленной работы и ограничением объёма за проход. Документация подчёркивает взаимодействие с прерываниями и разные контексты выполнения. NAPI не означает, что любая карта постоянно занимает отдельное ядро непрерывным опросом. Конкретное поведение зависит от драйвера и выбранного режима.
В условной модели приходит один миллион кадров в секунду. Если уведомлять по каждому, получится миллион уведомлений; при идеальном объединении по 32 — около 31 250. Однако это не прогноз частоты реальных прерываний: таймер, пустые интервалы и другие события меняют результат. Выигрыш также не означает уменьшения в 32 раза всей работы протокольного стека.
Если простая модель задерживает уведомление ровно на 50 мкс после первого события группы, это время может попасть в путь реакции приложения. При иной политике задержка будет другой. Поэтому измерение только суммарных гигабитов не отвечает на вопрос об интерактивности. Для неё интересны распределение задержек и редкие длинные события, а не один средний показатель.
Маленькие кадры создают большую нагрузку на обработку
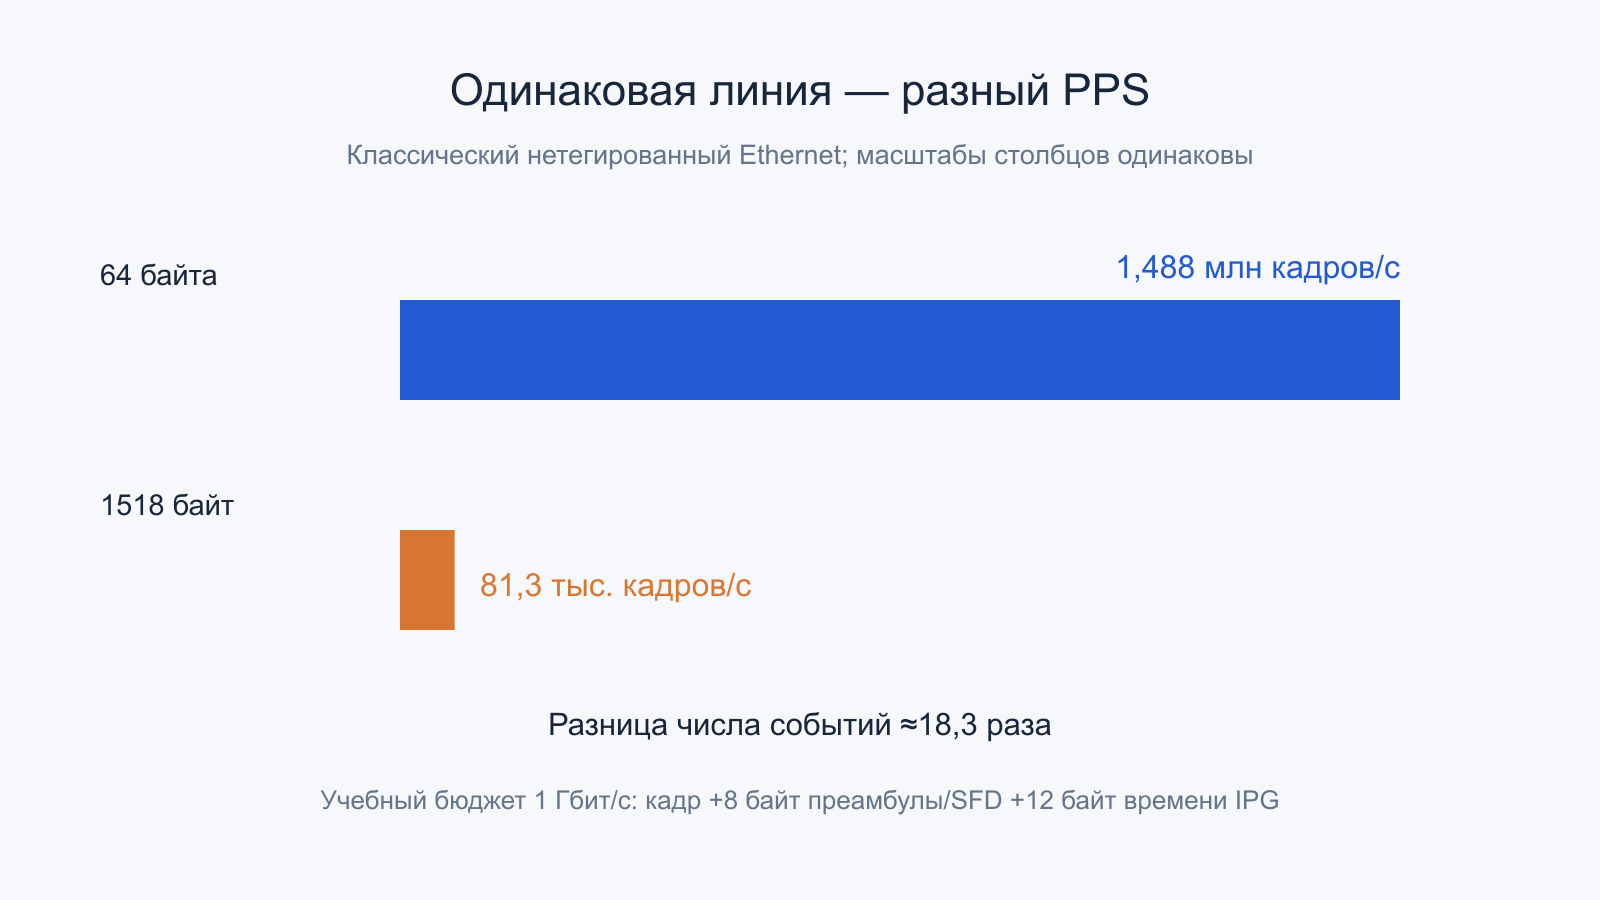
Пропускная способность линии измеряется в битах за секунду, но на каждый кадр приходятся действия: разобрать заголовки, выбрать очередь, обновить дескриптор и обработать протокол. Поэтому миллионы маленьких кадров могут оказаться тяжелее для CPU, чем такой же объём полезных данных крупными порциями. Здесь возникает показатель PPS — пакетов или кадров в секунду с обязательным уточнением уровня.
Для классического нетегированного Ethernet учебный бюджет минимального кадра состоит из 64 байт от адреса назначения до FCS, восьми байт преамбулы с SFD и межкадрового интервала, эквивалентного 12 байтам времени линии. Получается 84 байта времени на кадр. На 1 Гбит/с предельная оценка равна 10⁹ / (84 × 8) ≈ 1,488 млн кадров/с.
Для кадра 1518 байт аналогичный бюджет равен 1538 байтам времени; получится около 81 274 кадров/с. Это примерно в 18,3 раза меньше событий при той же скорости линии. Расчёт относится к явно заданному формату и не учитывает дополнительную специфику других сред и инкапсуляций. Переход к 10 Гбит/с умножил бы оба PPS-предела на десять, но не изменил их отношение.
Время межкадрового интервала не является частью сохранённого содержимого кадра. Поэтому утилита, считающая только байты кадров, может показывать величину ниже физического гигабита даже при полностью занятом передатчике. Для корректного сравнения нужно знать, включены ли FCS, VLAN, преамбула и другие элементы. У разных счётчиков границы различаются.
Бюджет процессорных циклов на пакет
Для условного ядра с частотой 3 ГГц поток один миллион пакетов в секунду оставляет в среднем 3000 тактов на пакет, если всё ядро отдано этой работе. Для десяти миллионов — 300 тактов. Внутри бюджета должны поместиться все назначенные этому ядру действия; часть операций может перекрываться. Это арифметическая оценка доступного времени, а не измеренная стоимость конкретного сетевого стека.
Если полная обработка в учебной модели требует 1000 тактов на пакет, потолок одного такого ядра равен трём миллионам пакетов в секунду. На реальной машине добавляются промахи кэша, зависимости, конкурирующие задачи и переменная частота. Но уже простая модель объясняет, почему полезная аппаратная разгрузка может проявляться именно на небольших пакетах и высоком PPS.
MTU, MSS и полезная скорость приложения
В обычном Ethernet-сценарии MTU 1500 описывает максимальный IP-пакет в соответствующей полезной области, а не полный кадр вместе со всеми внешними расходами. TCP MSS относится к данным TCP. При IPv4 без опций и TCP без опций из 1500 байт остаётся 1460: по 20 байт занимают два заголовка. IPv6, опции и туннели меняют этот расчёт.
В идеализированном однонаправленном потоке полных кадров доля TCP-данных от времени линии равна 1460 / 1538 ≈ 94,93%. Для 1 Гбит/с это около 949 Мбит/с, или 118,7 МБ/с десятичными единицами. Это верхняя оценка выбранной модели, а не обязательная скорость файла: подтверждения, управление перегрузкой, окна, паузы и работа приложения добавляют условия.
Jumbo frames уменьшают относительные расходы в поддерживаемой среде, но требуют согласованного пути и правильного понимания максимального размера. Один большой буфер в ОС ещё не доказывает передачу jumbo по проводу: его могла сформировать функция объединения. Поэтому нельзя выводить фактический MTU линии только из размера записи локального захвата.
Есть и ограничение всего сетевого пути. При условных 10 Гбит/с и времени кругового обмена 10 мс произведение полосы на задержку равно (10 × 10⁹ / 8) × 0,010 = 12,5 МБ. Столько данных соответствует одному периоду обмена на указанном темпе. Если протокол и его окна не позволяют держать достаточный объём незавершённой передачи, быстрый локальный адаптер не заполнит линию.
Этот расчёт не задаёт настройку любого сокета: фактическое управление зависит от TCP, ОС, условий сети и приложения. Он показывает, почему скорость одного удалённого соединения нельзя объяснять только количеством очередей карты. Потери и изменение доступной полосы влияют на транспортную реакцию, хотя MAC и PHY локального компьютера могут продолжать работать в прежнем режиме.
Offload переносит работу и меняет видимую картину
Checksum offload поручает устройству предусмотренные вычисления или проверки IP/TCP/UDP. На передаче программный стек может передать ещё не окончательно заполненное проверочное поле вместе с указанием, что вычислить. На приёме устройство сообщает результат поддерживаемой проверки. Это не то же самое, что FCS Ethernet: уровни и охваченные поля различаются.
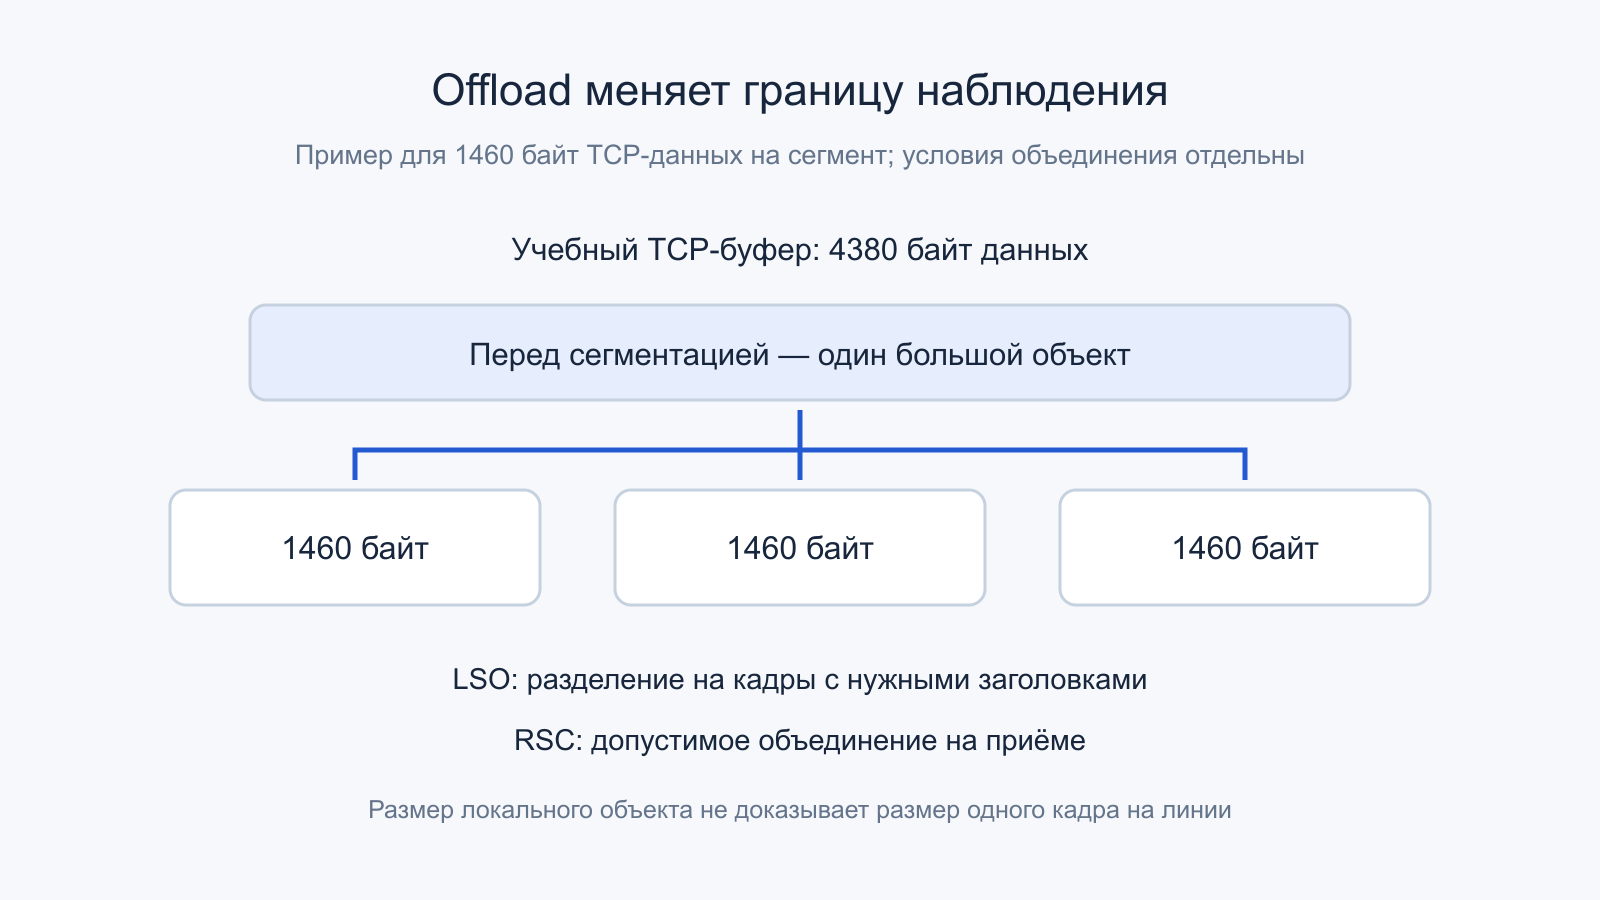
Large Send Offload позволяет передать устройству большой TCP-буфер и метаданные для разделения на подходящие сегменты. Microsoft описывает эту функцию отдельно от MTU среды. По линии затем уходят соответствующие кадры, а не обязательно один гигантский объект, видимый в верхней части стека. Аппаратная поддержка ограничена форматами и возможностями драйвера.
На приёме RSC и родственные механизмы объединяют последовательность сегментов для дальнейшей обработки с меньшими накладными расходами. Это не отменяет протокольную семантику и не означает, что удалённый узел отправлял именно такие крупные блоки. Документация Microsoft задаёт условия объединения и передачи дополнительной информации. Linux имеет свои программные механизмы и терминологию.
Практическое следствие относится к измерению: локальный захват до аппаратного вычисления контрольной суммы способен показывать незавершённое поле; захват до сегментации или после объединения — нетипичный размер объекта. Это повод установить точку наблюдения, а не немедленно объявлять повреждение сети. Сравнение с другой стороной должно учитывать, что там пакет виден на другом участке обработки.
Большая очередь поглощает всплеск, но не постоянный избыток
Буфер полезен, когда короткий входящий всплеск временно превышает доступный темп обработки. Однако при устойчивом превышении накопление заканчивается потерей или воздействием механизма обратного давления. Увеличение кольца откладывает этот момент и иногда увеличивает время ожидания. Оно не создаёт вычислительную мощность или дополнительную полосу памяти.
Пусть условно приходят 1,2 миллиона кадров в секунду, а обрабатываются 1,0 миллиона. Избыток равен 200 тысячам в секунду. Дополнительные 1000 свободных мест заполнятся за 1000 / 200000 = 5 мс. Это приближение считает один кадр на место, постоянные темпы и отсутствие других ограничений. Реальное кольцо может расходовать несколько буферов на один кадр.
Для устойчивой системы действует и связь очереди с задержкой. Если в среднем ожидают 200 элементов, а обслуживаются 100 тысяч в секунду, соответствующее среднее ожидание в выбранных границах составляет около двух миллисекунд. Такой расчёт требует согласованных определений очереди и потока. Нельзя подставлять ёмкость кольца вместо фактической средней заполненности.
Время запаса кольца зависит и от размера кадров. Если все 1024 места свободны и обслуживающая сторона временно остановилась, при приведённом гигабитном потоке минимальных кадров они закончатся примерно за 0,688 мс. При потоке полных кадров по 1518 байт — примерно за 12,6 мс. Здесь сохраняется учебное условие одного кадра на место и прежний учёт времени линии.
Таким образом, одинаковый объём заранее выделенной памяти не означает одинаковую переносимость пауз. При минимальных кадрах значительная часть двухкилобайтных буферов может оставаться неиспользованной, но дескрипторы всё равно расходуются. Система способна исчерпать места раньше, чем полезные байты заполнят всю физически выделенную память. Счётчик свободных дескрипторов и счётчик занятых байтов отвечают на разные вопросы.
Та же логика объясняет, почему короткий всплеск нельзя характеризовать только средней скоростью за секунду. Работа могла приходить плотной группой, превысить мгновенный запас и затем почти отсутствовать. За большой интервал средняя нагрузка выглядит безопасной, хотя потери уже произошли. Для анализа нужны временная структура и соответствующие счётчики, а не только итоговый объём.
Как читать результаты без смешения уровней
Представим учебную систему, где один TCP-поток даёт меньшую скорость, чем четыре независимых, при неизменном link. Это согласуется с ограничением одного пути обработки и RSS, но ещё не доказывает его: меняются окна, удалённая сторона и работа приложения. Следующий содержательный шаг — сопоставить распределение по очередям, загрузку отдельных CPU и счётчики потерь.
Другой сценарий: гигабиты остаются прежними, но CPU тратит меньше времени после поддерживаемого offload. Здесь полезный результат — освобождённый ресурс для приложения, даже без роста скорости линии. Третий: средняя скорость хорошая, а задержка редких запросов выросла. Тогда интересны очереди и группировка событий. Один показатель не должен заменять все три задачи.
Сетевой тест должен фиксировать размер сообщений, число связей, направление, длительность, точку подсчёта байтов и состояние аппаратных функций. Общая загрузка CPU скрывает перегруженное ядро, а скорость файла включает накопитель и файловый протокол. Чем точнее граница опыта, тем легче понять, какое звено действительно изменило результат.
Проверочный список архитектуры адаптера
- PHY, MAC, IP/TCP и приложение рассматриваются как разные уровни.
- Названы скорость link, формат кадров, MTU и количество потоков.
- DMA отделён от отсутствия процессорной работы, а дескриптор — от самих данных.
- Число очередей и работа RSS проверены для конкретного адаптера и драйвера.
- Одиночная связь не получает автоматически сумму ресурсов всех ядер.
- В измерениях учтены уведомления, группировка событий и распределение задержек.
- Offload и точка захвата объясняют видимые размеры и проверочные поля.
- Счётчики байтов, кадров, ошибок и потерь относятся к явно указанным границам.
Официальные первичные источники
- Intel Ethernet Controller I210 Datasheet, Rev 3.7, январь 2021: пример архитектуры MAC/PHY, очередей и DMA.
- Linux Kernel — Scaling in the Linux Networking Stack: RSS, программное распределение и локальность.
- Linux Kernel — NAPI: обработка сетевых событий и взаимодействие с уведомлениями.
- Microsoft Learn — Introduction to Receive Side Scaling: распределение приёма между CPU.
- Microsoft Learn — Checksum offload: границы передачи задач проверки устройству.
- Microsoft Learn — Offload the segmentation of large TCP packets: LSO и размер среды.
- Microsoft Learn — Overview of Receive Segment Coalescing: объединение сегментов на приёме.
Комментарии