Как PCI Express передаёт данные: пакеты, кредиты, подтверждения и повторы
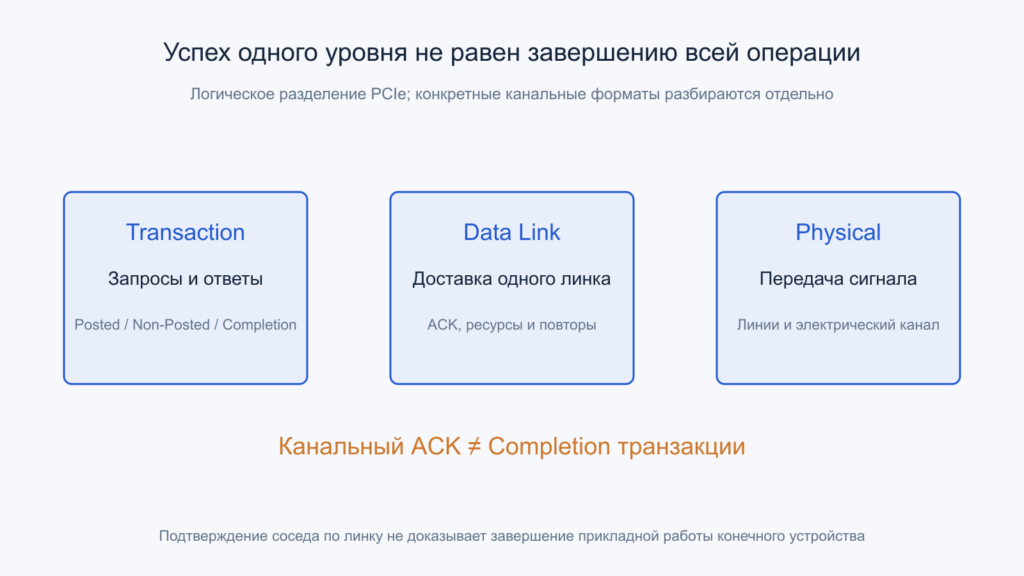
Канальный ACK относится к соседу по линку и не является Completion транзакции или подтверждением всей прикладной работы. Открыть иллюстрацию в полном размере.
Устройство подключено к широкому PCI Express, но множество коротких чтений не приближается к расчётной полосе линии. Большая запись идёт быстрее чтения того же объёма. После ухудшения электрических условий приложение продолжает работать, хотя растут задержки и счётчики исправленных событий. Эти наблюдения связаны с пакетами, подтверждениями, буферами и количеством одновременно незавершённых операций.
Здесь рассматривается внутренняя логика обмена, а не выбор слота и числа линий. Сначала разобран классический non-FLIT-механизм, затем отдельно PCIe 6.0 и FLIT Mode. Это разделение важно: нельзя переносить индивидуальный LCRC старого пакета на структуру FLIT или считать FEC заменой повторной передачи. Все расчётные примеры учебные и не являются измерениями конкретной материнской платы.
Содержание статьи
- Три слоя превращают действие в передачу
- Posted, Non-Posted и Completion — разные классы
- Канальный ACK не является Completion операции
- Заголовок TLP несёт адрес и контекст запроса
- Классический non-FLIT добавляет последовательность и LCRC
- Повтор передачи решает определённый класс ошибок
- Кредиты сообщают о доступном месте у получателя
- Учебный пример: закончились данные, а не заголовки
- Теги чтения и Completion создают ещё одно окно
- Полоса чтения может ограничиваться объёмом данных в пути
- Размер payload меняет долю служебного оформления
- Два направления и несколько звеньев учитываются раздельно
- Порядок операций не сводится к порядку проводных битов
- FLIT Mode нельзя определять только номером скорости
- Внутри 256 байт FLIT находятся разные области
- FEC, CRC и replay выполняют разные функции
- Фиксированная единица меняет компромисс заполнения и задержки
- Как связывать счётчики с реальным поведением
- Официальные первичные источники
- Читайте также
Три слоя превращают действие в передачу
Транзакционный слой формирует смысл обмена: какой запрос отправлен, к какому адресу относится операция и нужен ли ответ. Канальный слой отвечает за правила передачи между соседними участниками линка, включая средства контроля и повторов. Физический слой переносит последовательность через электрические линии. Хотя они работают совместно, успешное событие одного уровня не всегда означает завершение действия на другом.
Документация Microchip о слоях PCIe показывает такое разделение на примере контроллера. В частности, Transaction Layer Packet, TLP, не равен произвольному блоку, который приложение передало своему драйверу. Одна программная операция может породить несколько TLP, а полезные данные разбиваются с учётом типа запроса, границ и согласованных возможностей.
На стороне устройства также существует внутренняя логика, принимающая пакеты и выполняющая действие. Её интерфейс с PCIe-блоком может отличаться от формата на линии. Поэтому картинку шины внутри FPGA нельзя без оговорок считать осциллограммой последовательного канала. В анализе нужно назвать, где именно наблюдается пакет: в приложении устройства, на транзакционной границе или после канального оформления.
Posted, Non-Posted и Completion — разные классы
Memory Write обычно является Posted-запросом: он не требует отдельного Completion TLP, подтверждающего выполнение транзакции. Memory Read относится к Non-Posted: отправитель должен получить соответствующий ответ, содержащий данные либо предусмотренный статус. Completion является собственным классом пакетов. Нельзя превращать эти определения в универсальное правило «любая запись без ответа»: например, у других типов транзакций правила иные.
Для чтения отправитель должен сохранить сведения о незавершённом запросе, чтобы сопоставить пришедший Completion с исходной операцией. При записи без такого ответа взаимодействие с последующим действием определяется правилами порядка и семантикой устройства. Posted не означает «пакет можно выбросить», а Non-Posted не означает «каждый следующий запрос обязан ждать завершения предыдущего».
Разделение классов важно и для буферов. Получатель должен иметь ресурсы под соответствующие заголовки и данные, а механизмы управления потоком учитывают их отдельно. Один переполненный путь не следует автоматически отождествлять с отсутствием места вообще во всём контроллере. Архитектура предусматривает правила, помогающие сохранять продвижение различных типов обмена.
Канальный ACK не является Completion операции
В классическом non-FLIT-линке приёмная сторона подтверждает принятие последовательности пакетов средствами канального слоя. Такой ACK относится к непосредственному соседу по соединению. Если между инициатором и конечным устройством стоит коммутатор, каждое звено обслуживает собственный обмен. Подтверждение на первом линке не означает, что удалённая программа уже обработала все данные и закончила пользовательскую задачу.
Поэтому Memory Write может не иметь транзакционного Completion и одновременно участвовать в канальных подтверждениях и повторах. Здесь нет противоречия: используются разные уровни и разные границы. Аналогично Completion чтения сам является передаваемым TLP и тоже нуждается в надёжной доставке по каждому соответствующему участку, а не существует вне канального протокола.
Для драйвера это означает необходимость соблюдать определённую модель устройства. Запись в регистр, доставка данных DMA и завершение внутренней обработки могут быть разными событиями. Способ узнать о конечном результате задаётся самим устройством и его интерфейсом. Нельзя заменить такую семантику наблюдением, что PCIe-линк когда-то отправил ACK.
Заголовок TLP несёт адрес и контекст запроса
У TLP есть заголовок, определяющий формат, тип операции, длину и нужные идентификаторы. Часть пакетов содержит данные, часть переносит только запрос или состояние. В классических форматах встречаются заголовки из трёх или четырёх DWORD, то есть 12 или 16 байт. Расширения и дополнительные поля требуют отдельного учёта; нельзя назначить один размер заголовка всем современным транзакциям без оговорок.
AMD PG054 показывает пример представления TLP на интерфейсе конкретного IP-блока. Это полезный источник для понимания разделения заголовка и данных, но особенности внутреннего выравнивания относятся именно к этому интерфейсу. Байты, добавленные для удобства внутреннего слова, не обязательно являются дополнительными байтами того же назначения на последовательной линии.
Размер полезной передачи также ограничен согласованными параметрами и правилами адресации. Большой программный буфер не обязан уходить одним TLP. Несколько частей дают несколько заголовков и собственную последовательность обслуживания. Поэтому размер программного запроса, максимальный payload и фактический размер каждого пакета нужно сохранять как отдельные величины.
Классический non-FLIT добавляет последовательность и LCRC
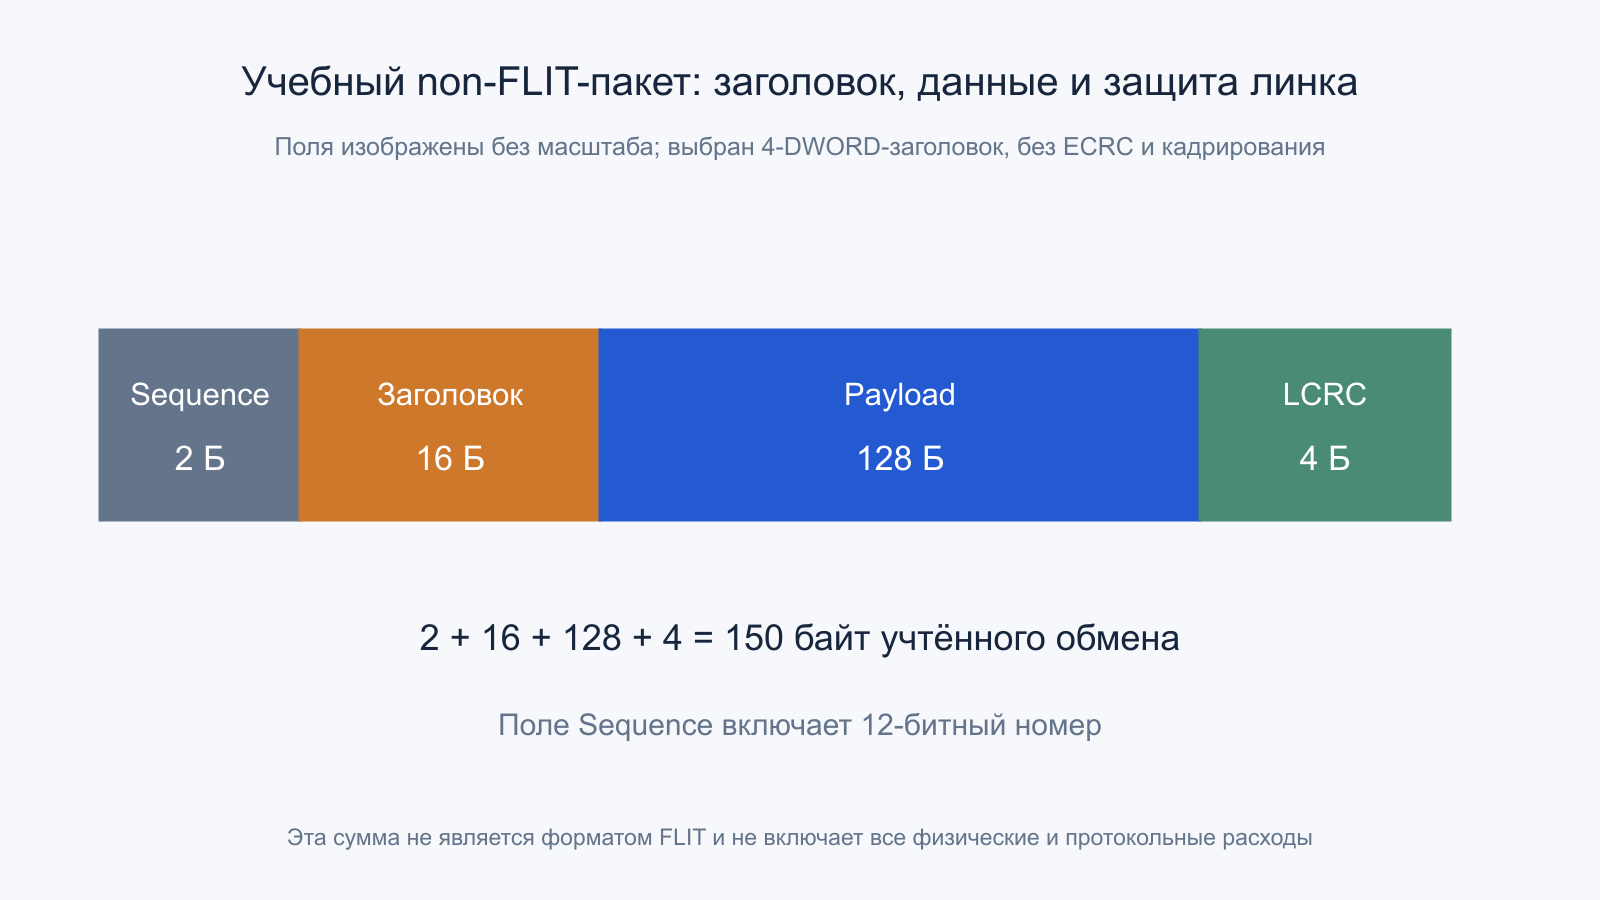
В рассматриваемом классическом механизме канальный слой добавляет номер последовательности и Link CRC, LCRC. Номер позволяет обнаруживать нарушение ожидаемого порядка и связывать подтверждения с переданными пакетами. LCRC проверяет целостность на данном участке. Передатчик хранит копии ещё не подтверждённых TLP в replay buffer, чтобы при необходимости повторить передачу без участия прикладной программы устройства.
Для базового учебного формата далее учитывается двухбайтное поле номера последовательности, включающее 12-битный номер, и четырёхбайтный LCRC. Эта схема не описывает FLIT Mode. Кадрирование физического слоя, возможный ECRC и дополнительные расширения в арифметический пример не включены. Благодаря явным границам можно понять влияние длины данных, не выдавая неполную сумму за полную скорость приложения.
ACK может подтверждать накопившуюся последовательность, а не требовать отдельного полного цикла ожидания после каждого TLP. Иначе длинный канал был бы ограничен одним пакетом в пути. Конкретные размеры буферов, таймеры и реализация определяют фактический запас. Задержка обратного подтверждения поэтому тоже является ресурсным фактором, хотя полезные данные движутся в другом направлении.
Повтор передачи решает определённый класс ошибок
Если проверка или последовательность указывает на проблему, получатель может запросить повтор предусмотренным сообщением NAK. Таймеры также позволяют обнаруживать отсутствие ожидаемого продвижения. Передатчик использует сохранённые копии, а приёмная логика учитывает последовательность, чтобы штатный replay не превращался в повторное выполнение уже принятой прикладной операции. Это часть согласованного протокола конкретного линка.
У этого механизма есть границы. Неисправность, после которой связь теряется полностью, может потребовать другой обработки и восстановления. Повторная передача не исправляет произвольную логическую ошибку внутри устройства и не гарантирует сохранность данных после его внезапного выключения. Правила устройства и более высоких уровней остаются необходимыми, даже когда сам PCIe-канал успешно обнаруживает и повторяет повреждённые передачи.
Нужно различать link CRC и дополнительные средства транзакционного контроля вроде ECRC, если они поддержаны и используются. Они защищают разные границы и не являются просто двумя названиями одной проверки. Ни один конечный CRC не означает математически абсолютного обнаружения любого возможного повреждения. Для инженерного вывода важны предусмотренный механизм, область покрытия и реакция на обнаруженное событие.
Кредиты сообщают о доступном месте у получателя
Управление потоком на основе кредитов не даёт отправителю бесконтрольно переполнить буферы соседнего получателя. Кредиты соответствуют определённым категориям заголовков и данных. В классической модели различаются Posted, Non-Posted и Completion, а внутри каждого класса — соответствующие ресурсы. Наличие свободного места в одной категории не означает автоматической возможности отправить пакет другой категории.
Документация AMD по кредитам определяет один header credit как место для соответствующего заголовка, а один data credit —как 16 байт payload. Поэтому это не одна общая валюта в байтах. Пакет может требовать одновременно заголовочный кредит и некоторое число кредитов данных. Для некоторых возможностей и режимов действуют дополнительные правила, которые нельзя игнорировать.
Ресурс возвращается по мере освобождения приёмного буфера и передачи обновлённой информации управления потоком. Это не то же самое, что ACK целостности и последовательности. Получатель способен уже подтвердить принятие пакета на канальном уровне, но ещё не освободить место под его содержимое. Смешение двух механизмов приводит к неверной модели причины остановки передачи.
Учебный пример: закончились данные, а не заголовки
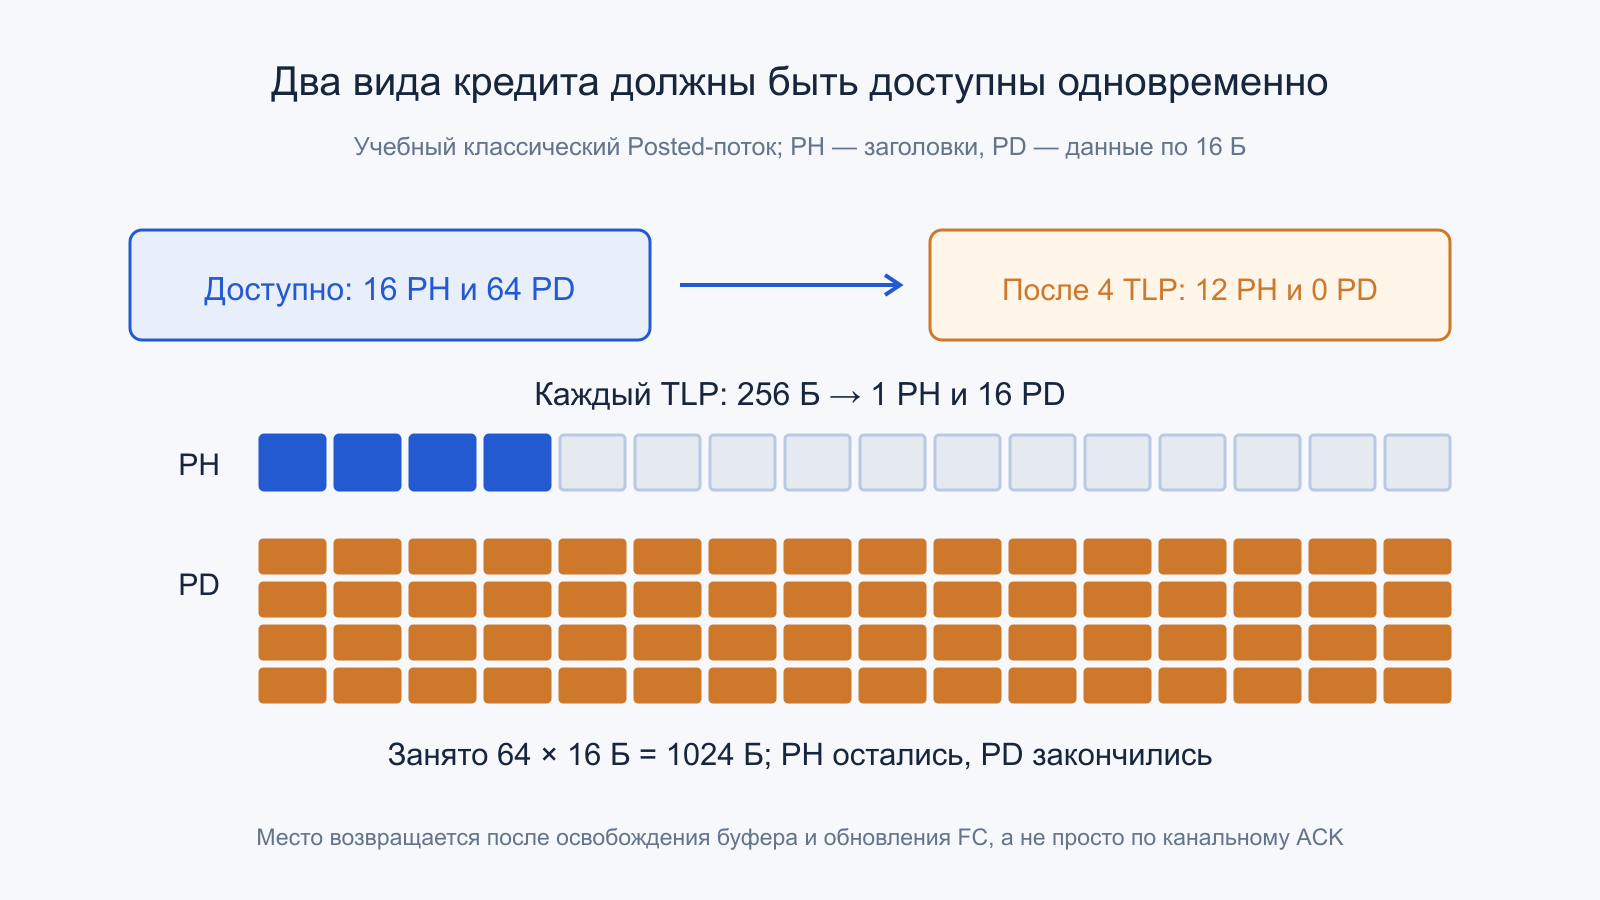
Пусть для выбранного классического Posted-потока доступны 16 header credits и 64 data credits. Размер каждой записи составляет 256 байт payload. Ей нужен один заголовочный кредит и 16 кредитов данных по 16 байт. Если освобождения пока нет, можно отправить четыре таких пакета: они займут 1024 байта данных и все 64 data credits, оставив 12 заголовочных кредитов.
Пятый пакет не получает право на передачу только потому, что заголовочных мест ещё много. Должны одновременно выполняться требования всех нужных ресурсов. После того как получатель обработает часть данных и сообщит об освобождении, движение может продолжиться. Числа в примере условны: они не являются размером буфера определённой видеокарты, SSD или коммутатора.
Пример показывает, почему широкая электрическая линия иногда простаивает при наличии готовой работы. Причиной может быть окно доступных ресурсов, а не недостаточная частота сигнала. Увеличение полосы самого линка не обязательно устраняет такое ожидание. Для локализации нужны сведения о кредитах, обработке получателя и длительности полного пути освобождения буфера.
Теги чтения и Completion создают ещё одно окно
Non-Posted-чтение требует помнить, какой запрос ожидает ответ. Идентификаторы и теги помогают сопоставить Completion с инициатором и операцией. При этом данные одного запроса способны возвращаться несколькими Completion в соответствии с правилами границ и размеров. Нельзя предполагать взаимно однозначное отношение «одна команда программы —один запрос —один ответный пакет».
Maximum Payload Size ограничивает данные соответствующего TLP, а Maximum Read Request Size относится к размеру запроса чтения. Эти параметры не тождественны и не являются прямым размером каждого ответа. Доступное число одновременно ожидающих запросов также ограничено возможностями и политикой реализации. Правильно выбранные значения не гарантируют, что приложение действительно создаёт достаточно независимых чтений.
Если следующий адрес можно вычислить только после получения предыдущего ответа, программа не способна заполнить большое окно простым увеличением лимита. Для независимого потока ситуация другая: несколько запросов перекрывают путь туда и обратно. Поэтому отдельные чтения регистров и большие DMA-передачи дают разную картину даже через один и тот же линк с неизменной скоростью.
Полоса чтения может ограничиваться объёмом данных в пути
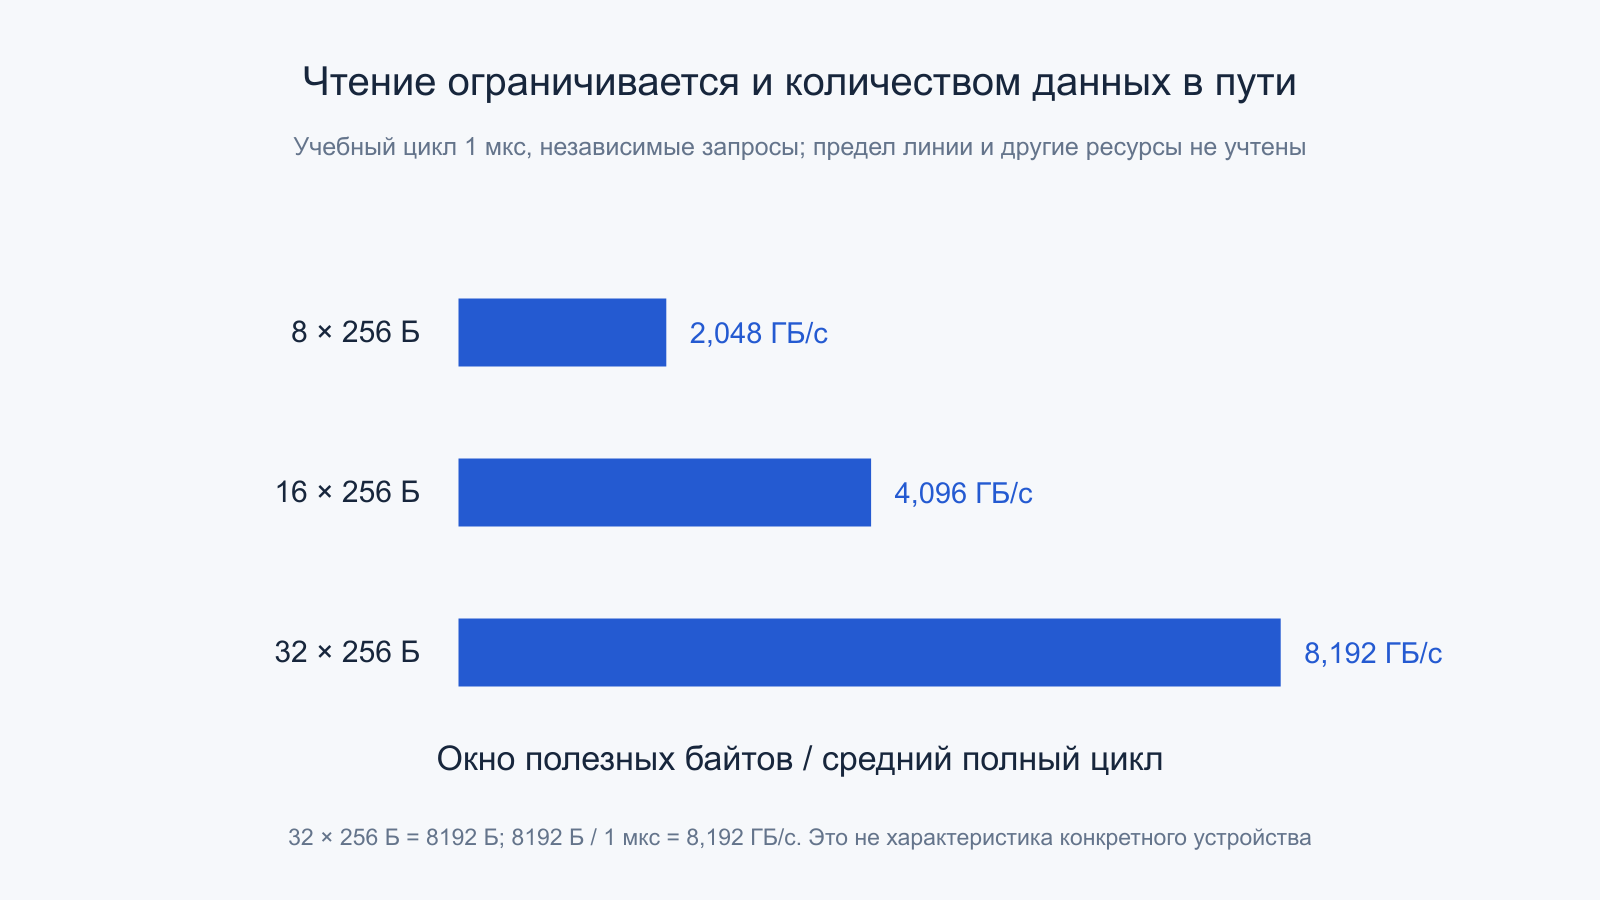
В учебной стационарной модели пусть одновременно ожидаются 32 запроса по 256 байт, а полный средний цикл получения этих данных занимает 1 мкс. Окно составляет 8192 байта. Деление на время даёт предел 8,192 ГБ/с до учёта остальных ограничений. Для 16 таких запросов окно вдвое меньше и аналогичная оценка равна 4,096 ГБ/с. Это не паспортная производительность конкретного PCIe-устройства.
Модель предполагает, что окно постоянно заполнено полезной независимой работой, ответы корректно освобождают ресурс, а среднее время задано согласованно. В неё не включены предел линии, кредиты, размер Completion, работа памяти и программные паузы. Поэтому реальная скорость не обязана достигнуть расчётного значения, но сама оценка объясняет, зачем интерфейсу нужны многие операции в пути.
Увеличение числа тегов может помочь, когда ограничивает именно окно. Если же получатель насыщен или запросы зависимы, дополнительный предел почти ничего не даст. Полезно сопоставлять время ответа, число незавершённых запросов и полезные байты, а не объяснять любую разницу между чтением и записью одним словом «накладные расходы».
Для масштаба условный учтённый пакет размером 150 байт при потоке 16 ГБ/с сериализуется за 9,375 нс. Это значительно меньше выбранной микросекунды полного цикла чтения. В оставшееся время входят распространение, обработка, очереди и получение ответа. Числа не описывают конкретное поколение PCIe: пример лишь показывает, почему время передачи битов одного пакета нельзя считать всей задержкой транзакции.
Размер payload меняет долю служебного оформления
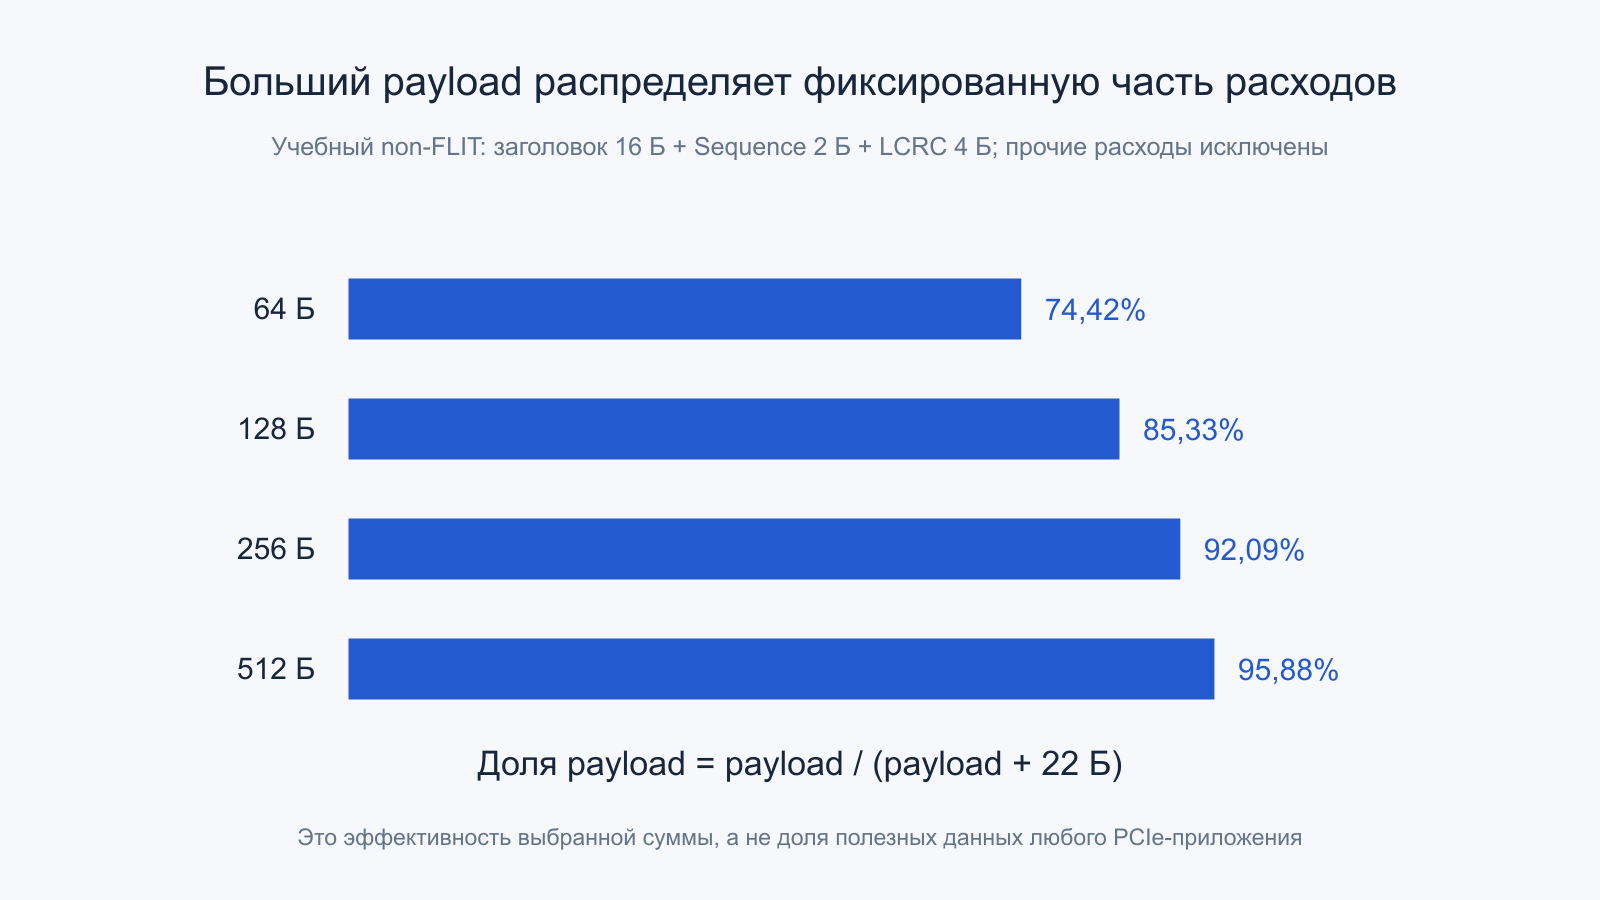
Возьмём исключительно учебный non-FLIT-формат: заголовок 16 байт, поле последовательности 2 байта, LCRC4 байта, без ECRC, дополнительного кадрирования и остальных расходов. При 128 байтах данных учтённая сумма равна 150 байтам, а доля payload —85,33 процента. При 256 байтах получится 278 байт и 92,09 процента; при 512 байтах —534 байта и 95,88 процента.
Рост доли понятен: постоянные 22 байта распределяются на более крупную полезную часть. Но это не означает, что нужно всегда пытаться объединить всю работу в самый большой пакет. Ограничения MPS, границы адресов, время ожидания накопления и характер операций определяют допустимый и полезный размер. Короткая управляющая запись не становится неправильной только потому, что её относительные расходы велики.
В результате эффективность пакета, эффективность физического кодирования и скорость приложения являются разными коэффициентами. Их можно объединять только при согласованных определениях и реальном режиме потока. Нельзя умножить произвольные проценты из разных поколений и объявить точную полосу компьютера. Схема ниже показывает лишь выбранную фиксированную часть классического оформления.
Два направления и несколько звеньев учитываются раздельно
PCIe-линк полнодуплексный, поэтому полезные запросы и ответы способны занимать разные направления одновременно. Для чтения запрос идёт к получателю, а данные возвращаются обратно; канальные сообщения также имеют собственное направление. Складывать весь этот трафик и вычитать его из одного однонаправленного предела без модели неверно. Но и считать обратное направление совершенно бесплатным ресурсом при любой нагрузке нельзя.
Коммутатор обслуживает несколько отдельных линков со своими буферами и контролем. На одном участке может хватать кредитов, а на следующем накапливаться очередь. Подтверждения и повторы относятся к соответствующему звену. Поэтому задержка между конечными устройствами включает не только сериализацию одного TLP, но и очереди, обработку и обратный путь необходимых сообщений.
AMD описывает состояние передающих кредитов на примере своего блока. Конкретные правила его внутренних очередей нельзя без оговорок приписать всем коммутаторам, но общий вывод устойчив: готовность приложения, свободный передающий буфер и место у партнёра являются разными условиями. Одного индикатора «линк поднят» недостаточно для объяснения полосы.
Порядок операций не сводится к порядку проводных битов
Протокол задаёт правила продвижения различных классов транзакций и дополнительные атрибуты. При этом приложение устройства, память хоста и процессор могут иметь собственные правила видимости. Поэтому факт последовательной отправки двух пакетов не всегда является полной программной гарантией, что другой участник наблюдает все связанные данные именно так, как предполагал разработчик.
Драйверы используют предусмотренные операции синхронизации и интерфейс устройства. Нельзя универсально заменить их случайным чтением регистра или предположением, что любое Completion означает завершение всей ранее отправленной прикладной работы. Иногда отдельная операция действительно служит частью согласованного протокола, но её смысл должен быть определён для данного устройства и данного стека.
Атрибуты ослабленного порядка также не являются универсальной настройкой «ускорить PCIe без последствий». Они разрешают определённое изменение требований и должны соответствовать семантике данных. Для информационного анализа достаточно знать, что пропускная способность зависит не только от длины пакетов, но и от допустимого перекрытия операций. Изменение правил без понимания способно нарушить корректность, даже если тест полосы стал быстрее.
FLIT Mode нельзя определять только номером скорости
В PCIe 6.0 появился режим FLIT, Flow Control Unit, с фиксированной единицей обмена 256 байт. Переход связан с новой организацией передачи и FEC. Он не означает, что каждый TLP теперь обязан иметь размер 256 байт: изменяется способ упаковки транзакций в канальные единицы. На 64 GT/s с PAM4 этот режим требуется, но его поддержка не ограничивается только этой скоростью.
PCI-SIG прямо указывает, что FLIT поддерживается на всех скоростях линка и после обучения в этом режиме сохраняется, пока линк остаётся LinkUp. Поэтому фраза «всё ниже 64 GT/s всегда non-FLIT» неверна. Для анализа нужно знать не только поколение возможностей, но и реально согласованный режим.
Работа в FLIT, в том числе на пониженной скорости, требует поддержки и согласования обоими концами данного линка. Возможность одного устройства не делает старого партнёра автоматически совместимым с новым форматом. Режим конкретного звена проверяют отдельно от максимальных возможностей карты или всей платформы.
По этой причине предыдущие примеры LCRC и отдельных TLP-повторов нельзя механически перенести в новый формат. Смысл транзакций и необходимость не переполнять получателя остаются важными, но канальное оформление, единица защиты и сигнализация меняются. Следующие разделы относятся именно к FLIT-режиму PCIe 6.0, а не к универсальной смеси форматов.
Внутри 256 байт FLIT находятся разные области
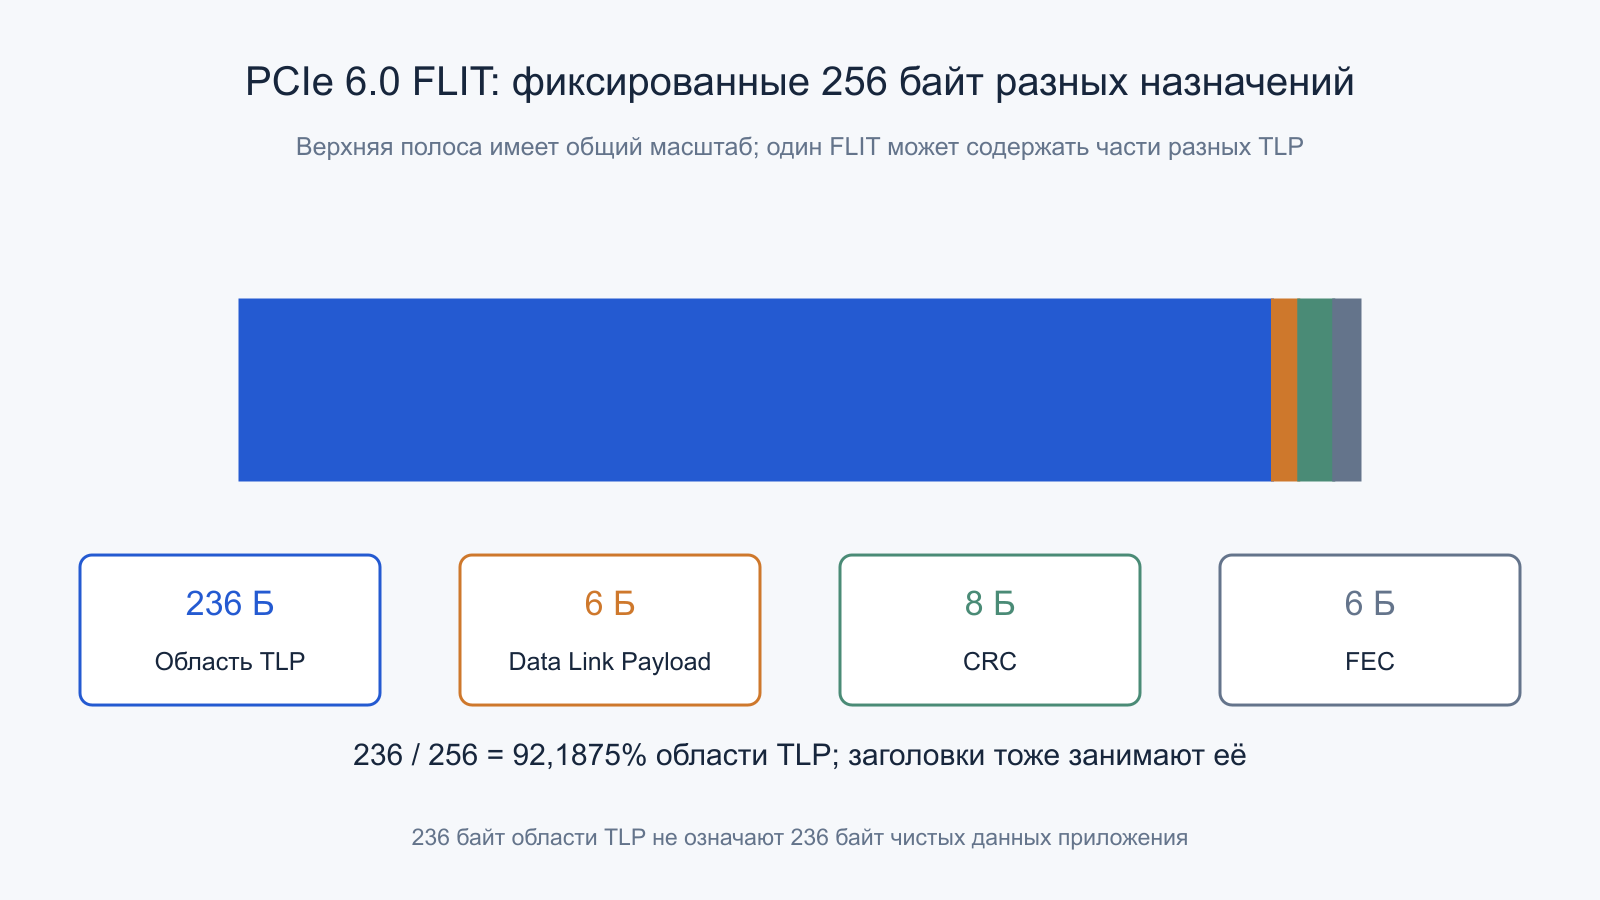
Для рассматриваемой структуры PCIe 6.0 FLIT содержит 236 байт области TLP,6 байт Data Link Payload,8 байт CRC и 6 байт FEC. Сумма равна 256 байтам. Такая схема показана в техническом документе Cadence. Важно:236 байт области TLP не являются 236 байтами чистых данных приложения, поскольку транзакционные заголовки тоже занимают место.
Отношение 236/256 равно 92,1875 процента. Оно характеризует долю области TLP в заполненном FLIT, а не готовую полезную эффективность любого чтения. Дополнительное влияние имеют состав TLP, незанятое пространство, управляющий обмен и поведение потока. Сравнивать это число напрямую с долей payload из предыдущего non-FLIT-примера нельзя: у коэффициентов разные знаменатели и области учёта.
PCI-SIG поясняет, что один TLP может занимать несколько FLIT, а один FLIT —содержать несколько TLP или их части. Поэтому число FLIT не равно числу команд устройства. Правильная модель отдельно считает транзакции, их заголовки и заполнение фиксированных единиц канального обмена.
FEC, CRC и replay выполняют разные функции
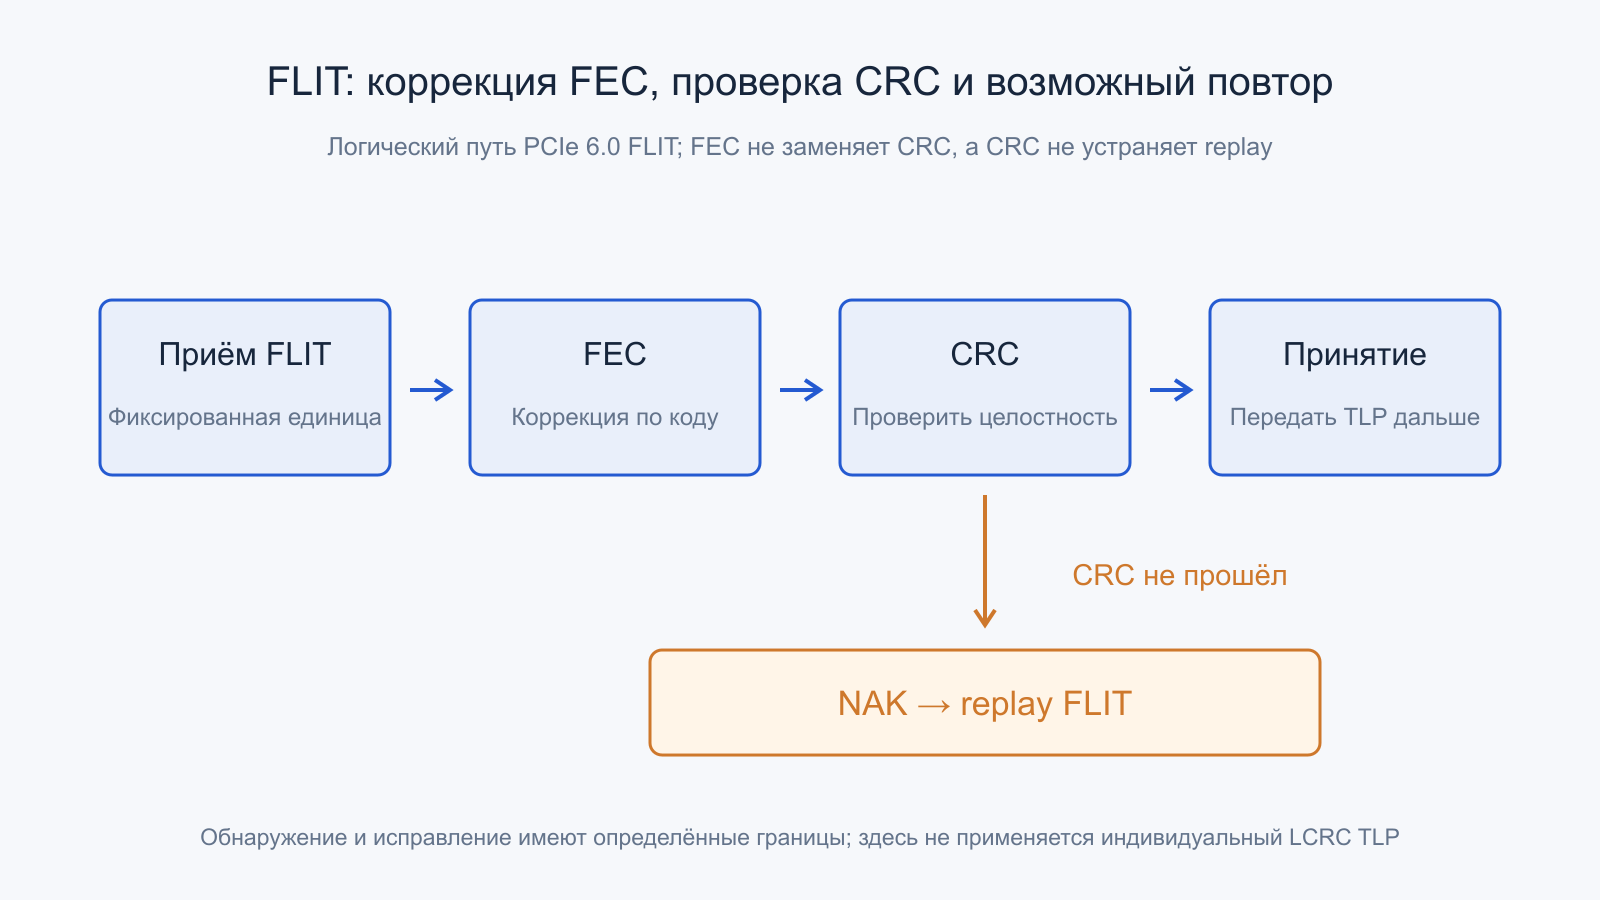
FEC использует избыточность для исправления предусмотренного класса ошибок без обязательной повторной передачи. После соответствующей обработки CRC проверяет оставшуюся целостность защищённого содержимого. Если проверка не проходит, предусмотренный механизм может потребовать replay. Следовательно, FEC не заменяет CRC, а наличие обоих механизмов не устраняет саму возможность повторов при неблагоприятных условиях.
В описании PCI-SIG порядок явно разделён: приём, FEC-декодирование, проверка CRC и при необходимости NAK с последующим повтором FLIT. Это уже не схема «добавить старый LCRC каждому TLP и ещё один FEC рядом». Единица канальной защиты связана с FLIT, внутри которого могут находиться разные транзакции. Смешение этих уровней даёт неправильные размеры и неверное объяснение счётчиков.
Исправление также имеет пределы, а проверка обладает конечной вероятностью необнаруженного повреждения. Надёжность строится на согласованном сочетании механизмов и реакции системы, а не на утверждении «ошибок больше не бывает». При интерпретации событий нужно знать, что именно считал контроллер: исправление, неуспешную проверку, повтор, потерю линка или ошибку уже транзакционного уровня.
Фиксированная единица меняет компромисс заполнения и задержки
Крупный непрерывный поток позволяет упаковывать область TLP иначе, чем редкие короткие управляющие обращения. Для небольшой операции важны не только относительные байты, но и время, когда она станет доступна к передаче и обработке. Нельзя автоматически считать, что контроллер всегда обязан ждать заполнения FLIT исключительно полезными данными приложения: правила упаковки и служебного содержания определены протоколом.
Увеличение фиксированного блока могло бы уменьшить долю постоянных расходов, но увеличить задержку накопления и обработки. PCI-SIG описывает выбор 256 байт как компромисс полосы и латентности. Из этого не следует существование пользовательской настройки, позволяющей произвольно заменить размер FLIT ради конкретной программы. Это параметр формата, а не свободно выбираемый размер сетевого буфера.
Поэтому реальная выгода новой сигнализации и формата зависит от задачи. Длинная передача, зависимая цепочка чтений и обмен малыми уведомлениями нагружают систему по-разному. Сравнение поколений требует одинаковой полезной работы и отдельно установленного режима. Один максимальный показатель полосы не описывает все возможные задержки пакетов.
Как связывать счётчики с реальным поведением
Сначала фиксируют скорость, ширину, режим FLIT или non-FLIT, типы транзакций, размер данных и количество независимых операций. Затем сопоставляют полезную полосу с задержками, доступными кредитами, завершениями и обнаруженными ошибками. Если растёт число повторов, исследуют соответствующий участок и условия, а не сразу объявляют неисправным приложение или конечную память устройства.
Наблюдение на одном звене не заменяет картину полного маршрута. Высокая электрическая активность может включать служебный трафик и повторы, а низкая —ожидание кредитов или зависимой работы. Поэтому процент занятости и гигабайты полезных данных не обязаны двигаться одинаково. Для убедительного вывода нужно сохранять определения счётчиков и повторять согласованный сценарий.
Отдельно различают успешное завершение с повышенной задержкой и ошибку, дошедшую до программного обработчика. Исправленный эпизод способен не испортить данные, но уменьшить полезную полосу за счёт повторной работы. Историческое значение счётчика без динамики также не указывает момент и условия проблемы. Полезны изменения за известный интервал, сопоставленные с режимом нагрузки и состоянием конкретного участка соединения.
При проверке нескольких устройств сначала сохраняют одинаковую топологию и маршрут. Перестановка карты может изменить не только физические контакты, но и коммутатор, доступные ресурсы и конкурирующий трафик. Улучшение результата после такой перестановки локализует группу условий, однако само по себе не доказывает дефект единственного разъёма. Вывод должен соответствовать тому, что действительно изменялось и наблюдалось.
Пакетная модель объясняет, почему posted-запись, non-posted-чтение и исправленный обмен выглядят различно при одинаковом числе линий. Она также показывает границу между классическим LCRC/replay и FLIT с FEC/CRC. Понимание этих различий позволяет оценивать PCIe по полезному результату и реальному состоянию ресурсов, сохраняя точность там, где одна цифра поколения скрывает несколько независимых механизмов.
Официальные первичные источники
- Microchip — Data-link and Transaction Layers: классические слои, подтверждение и replay buffer.
- AMD — PG054, TLP Format: пример транзакционного интерфейса конкретного IP.
- AMD — PG054, Flow Control Credit Information: единицы заголовочных и данных кредитов.
- AMD — PG054, Transmit Credit Flow Control Information: передающие ресурсы и ограничения реализации.
- PCI-SIG — What is Flit Mode: размер, необходимость и работа на пониженных скоростях.
- PCI-SIG — PCIe 6.0 Webinar Q&A: упаковка TLP, порядок FEC/CRC и повторы FLIT.
- Cadence — PCIe 6.0 Electrical Testing for High Data-Bandwidth Applications: структура 256-байтного FLIT и функции защиты.
Комментарии